


Narzędzie do testowania rozkładu służy do porównywania wybranego szeregu danych z kilkoma teoretycznymi rozkładami. Pomaga zidentyfikować, który rozkład najlepiej opisuje pomiary i czy dane nadają się do dalszych analiz statystycznych z założeniem konkretnego rozkładu.
Wynik nie jest ostatecznym "dowodem" na rozkład. Wysoka wartość p oznacza jedynie, że test Andersona-Darlinga nie znajduje statystycznie istotnego odchylenia od wybranego rozkładu. Zawsze należy brać pod uwagę techniczną wiarygodność, odniesienie do procesu i sieć prawdopodobieństwa.

Podczas produkcji sosu pomidorowego regularnie rejestrowane są wartości lepkości. Lepkość opisuje, jak gęsty jest sos. Jest to ważne, aby produkt mógł być równomiernie napełniany i zawsze miał taką samą konsystencję dla klienta.
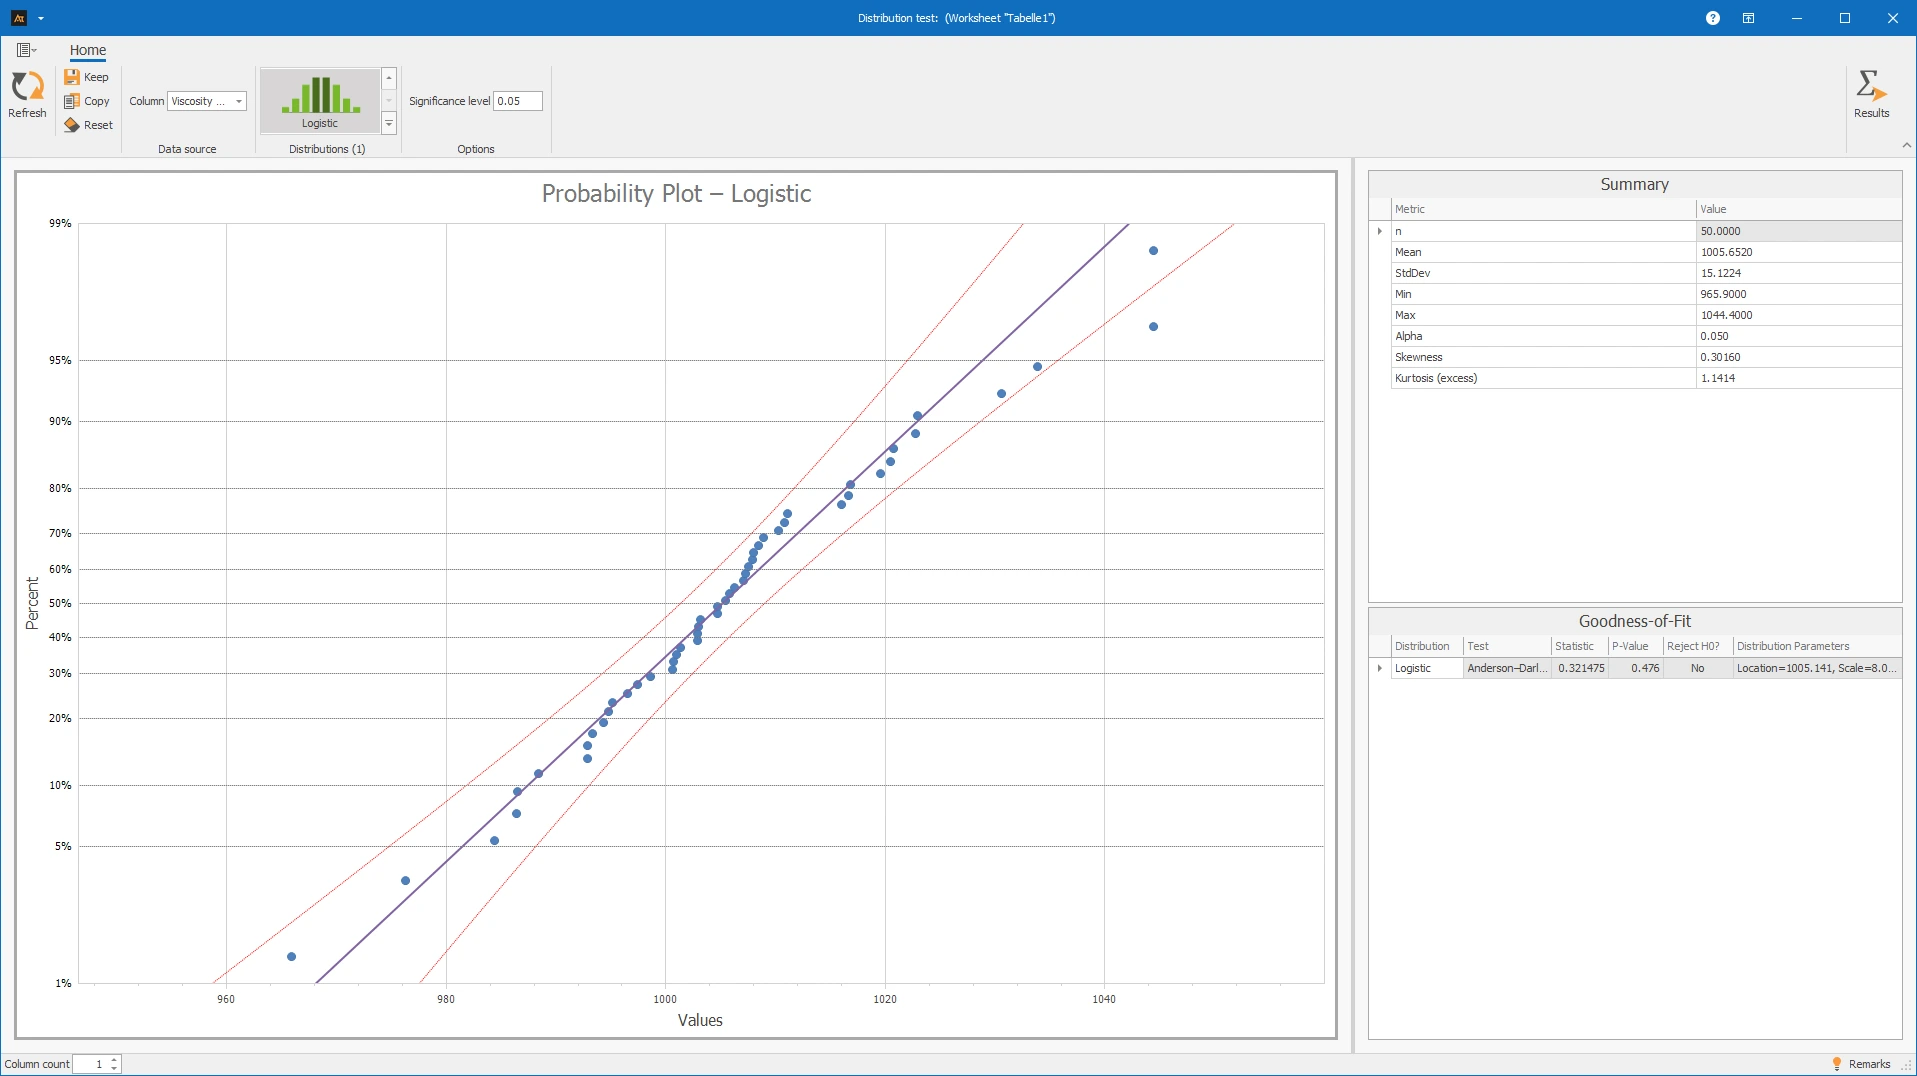
Zanim przeprowadzone zostaną dalsze analizy, należy sprawdzić, które z wybranych rozkładów mogą sensownie opisać zmierzone wartości lepkości. W tym celu dane są porównywane z testami rozkładu dla rozkładów Normalny, Lognormalny, Loglogistyczny i Logistyczny.
Objaśnienia wyników:
Ploty prawdopodobieństwa
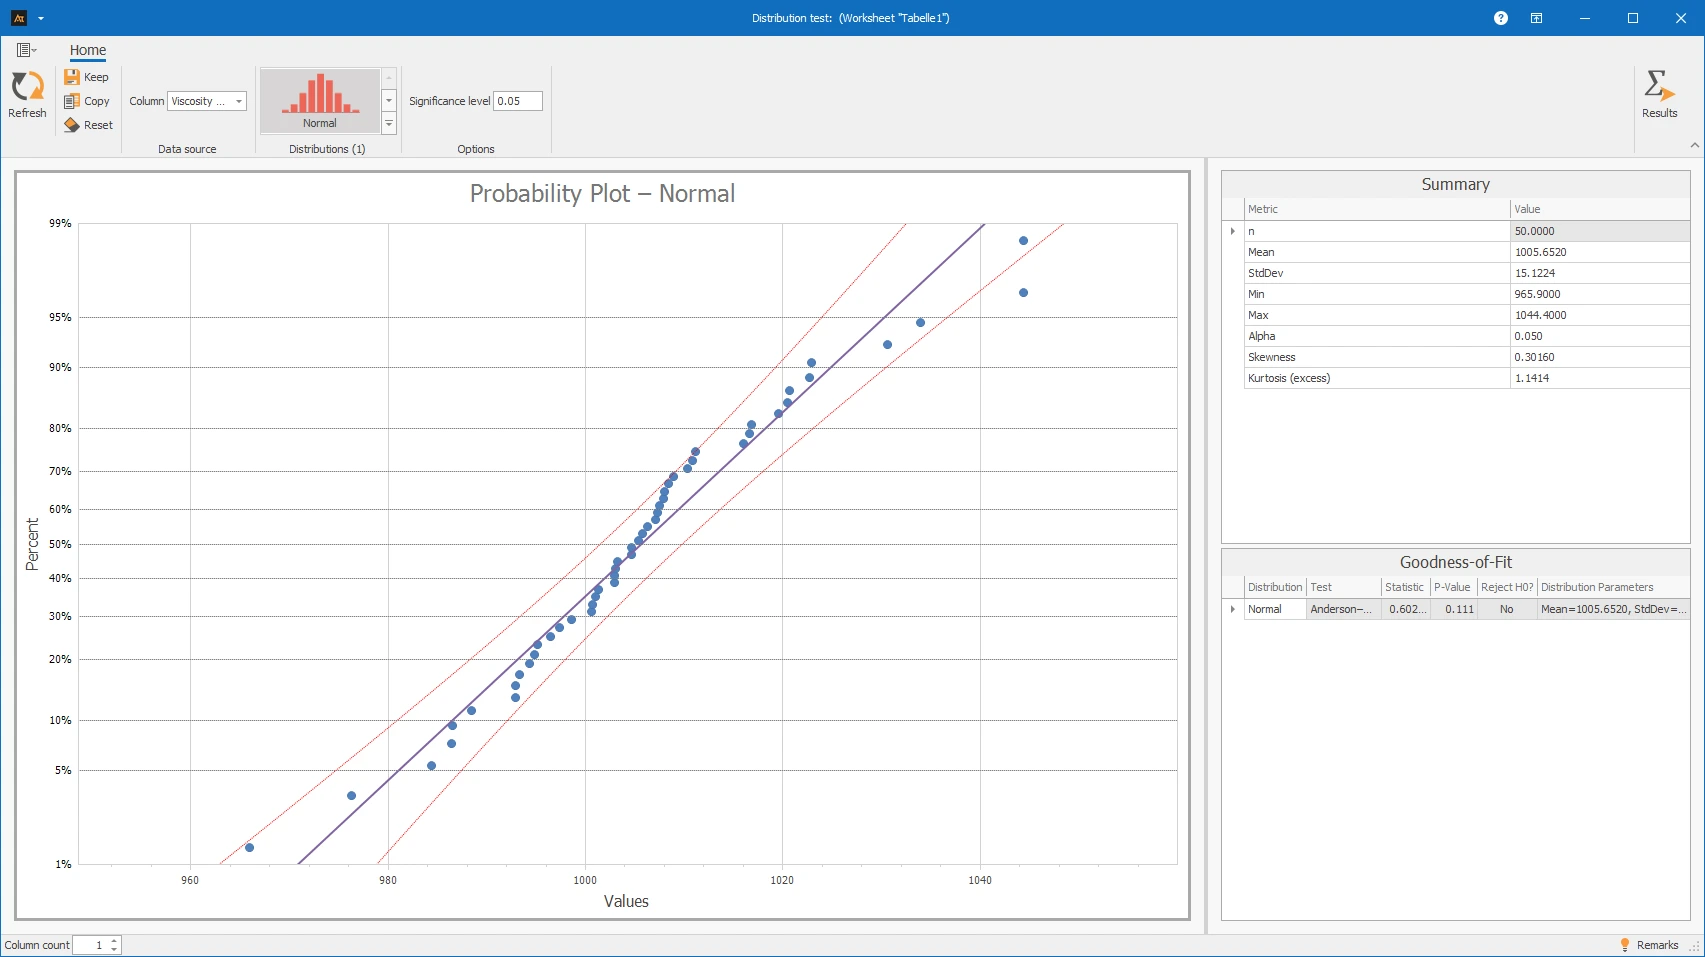
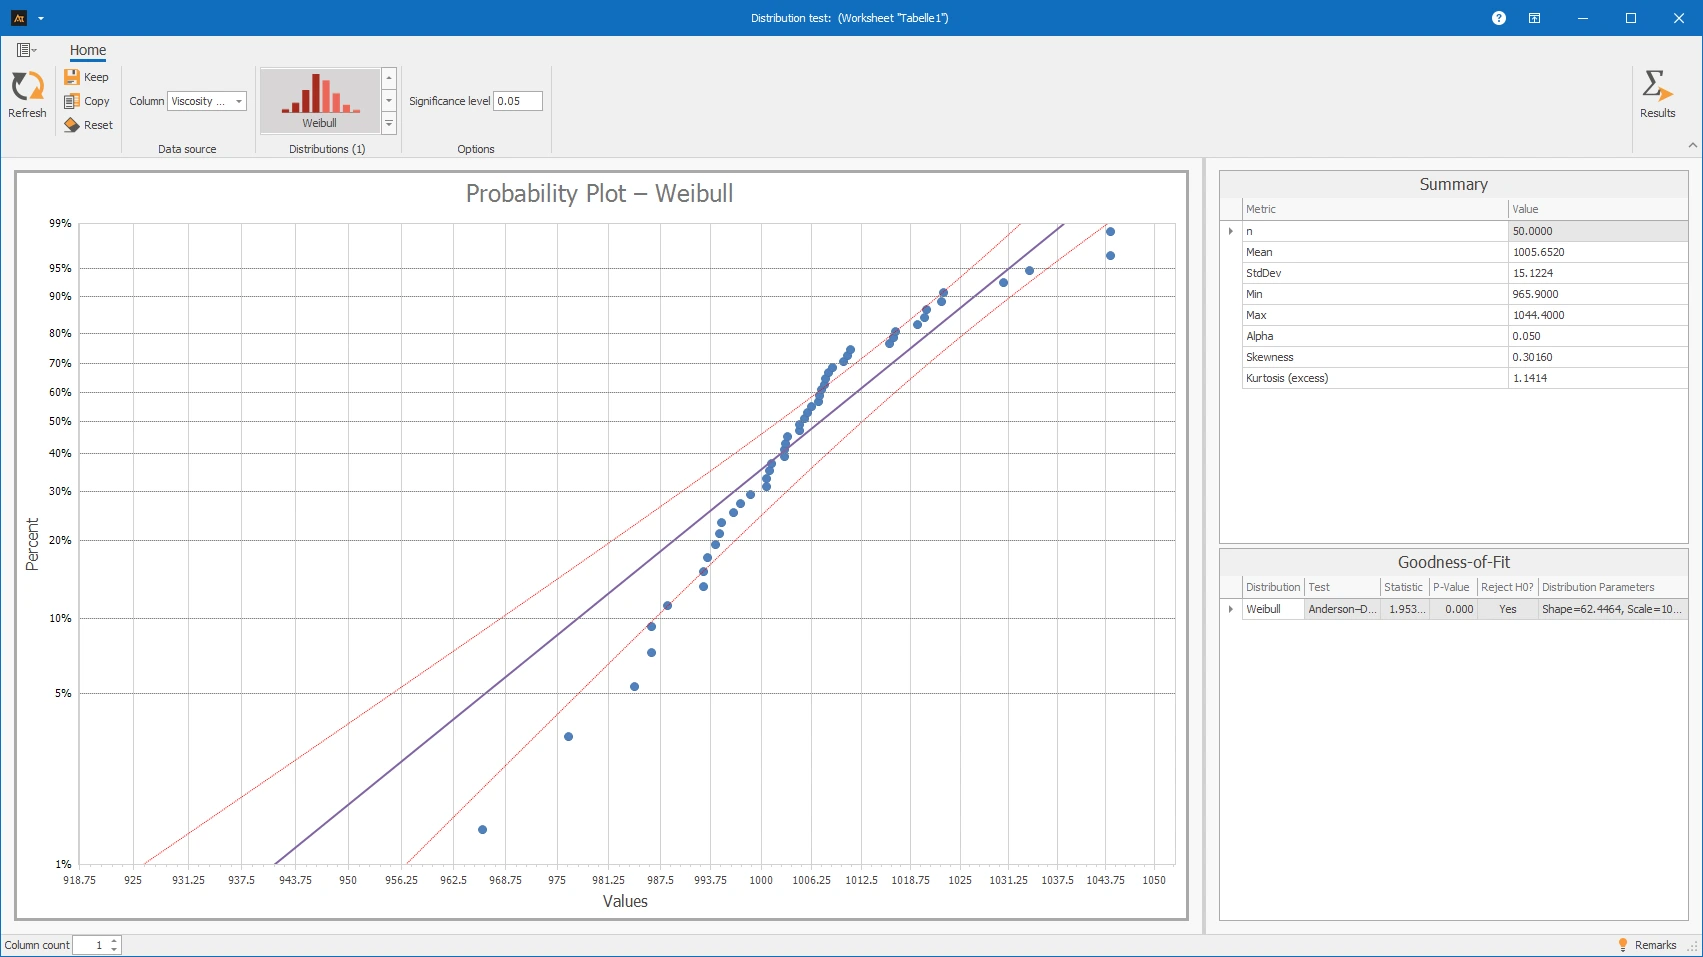
Dla każdego pomyślnie obliczonego rozkładu, test rozkładu generuje własny plot prawdopodobieństwa. W nim posortowane wartości zmierzone są porównywane z wartościami, które byłyby oczekiwane pod danym teoretycznym rozkładem.
- Jeśli punkty są blisko narysowanej linii, wybrany rozkład dobrze pasuje do danych. Im bardziej punkty odbiegają od linii, tym gorzej ten rozkład opisuje dane.
- Zakrzywione wzory, kształty S, znaczące odstające wartości lub odchylenia w obszarach krawędziowych wskazują, że dane nie pasują dobrze do testowanego rozkładu.
- Przy porównywaniu wielu rozkładów nie tylko wartość p powinna być brana pod uwagę. Ważne jest również, czy plot prawdopodobieństwa pokazuje wiarygodny, spokojny wzór i czy rozkład technicznie pasuje do charakterystyki.
Linia może być rozumiana jako szablon: Im lepiej punkty pasują do szablonu rozkładu, tym bardziej odpowiedni jest ten rozkład jako model dla danych.
Test Andersona-Darlinga
Test rozkładu wykorzystuje test Andersona-Darlinga jako obliczeniowy test dopasowania. Test sprawdza, czy zmierzone wartości pasują do wybranego rozkładu. Jest przeprowadzany dla wszystkich obsługiwanych rozkładów, które można obliczyć na podstawie dostępnych danych.
Test generuje statystykę testową i wartość p dla każdego rozkładu:
- Wartość p większa niż alfa: Nie ma statystycznych dowodów na to, że dane odbiegają od tego rozkładu. → Rozkład można uznać za możliwy model.
- Wartość p mniejsza lub równa alfa: Test znajduje znaczące odchylenia. → Hipoteza zerowa jest odrzucona; testowany rozkład nie pasuje statystycznie do danych wystarczająco.
Dlaczego używany jest test Andersona-Darlinga? Jest on szczególnie czuły na odchylenia w obszarach krawędziowych rozkładu. To tutaj często występują odstające wartości lub wartości ekstremalne, które są ważne dla analiz jakości, procesów i trwałości.
Interpretacja wyników:
Wartości lepkości zostały porównane z rozkładami Normalnym, Lognormalnym, Loglogistycznym i Logistycznym. Dla wszystkich czterech rozkładów wartość p jest większa niż 0,05. Dlatego hipoteza zerowa nie jest odrzucona dla żadnego rozkładu. Nie ma statystycznych dowodów na to, że dane znacząco odbiegają od któregokolwiek z testowanych rozkładów.
Ploty prawdopodobieństwa również pokazują, że punkty w większości leżą blisko linii. W związku z tym wartości lepkości można w przybliżeniu opisać za pomocą testowanych rozkładów.
Jednak wynik nie pozwala na ostateczny wniosek, że jeden z tych rozkładów jest wyraźnie najlepszy. Wybór rozkładu powinien zatem również opierać się na technicznej wiarygodności i planowanej dalszej analizie. Ponieważ lepkość jest ciągłym pomiarem, a dane są w przybliżeniu symetrycznie rozłożone wokół średniej, rozkład normalny może być rozsądnym i dobrze uzasadnionym wyborem dla wielu dalszych standardowych ocen.
Następujące rozważania i kroki są niezbędne do przetestowania serii danych względem wielu rozkładów za pomocą Best Fit.
Przygotowanie
- Wybierz odpowiednią miarę numeryczną.
- Zbierz pomiary.
- Wybierz rozkłady, np. Weibull, Gamma, Lognormalny.
 Użyj w AlphadiTab
- Wybierz narzędzie Test Rozkładu w Fazie Pomiaru.
- Wybierz serię danych do przetestowania i aktywuj jeden lub więcej rozkładów w galerii rozkładów.
- Sprawdź lub dostosuj poziom istotności.
- Przeprowadź analizę za pomocą Aktualizuj.
Interpretacja
Następnie sprawdź dla każdego wybranego rozkładu, czy jest on odpowiedni do opisania pomiarów.
- Wartość p: Jeśli wartość p jest większa niż 0,05, nie ma statystycznych dowodów na odchylenie od rozkładu. Dane można zatem uznać za w przybliżeniu dopasowane do rozkładu.
- Wykres prawdopodobieństwa: Jeśli punkty są głównie blisko narysowanej linii, wybrany rozkład jest wiarygodnym modelem dla danych.
Następujące rozkłady są dostępne w narzędziu:
Rozkład normalny
Rozkład normalny to symetryczny, dzwonowaty rozkład. Często występuje w pomiarach wynikających z wielu małych, losowych wpływów. Przykłady obejmują wymiary, masy, ilości napełnienia lub wartości procesów.
Typowo większość wartości jest blisko średniej, a duże odchylenia w górę lub w dół stają się rzadsze. Jeśli dane dobrze pasują do rozkładu normalnego, można użyć wielu klasycznych metod statystycznych.
Rozkład Weibulla
Rozkład Weibulla jest często używany do danych dotyczących żywotności, awarii i niezawodności. Jest szczególnie odpowiedni, gdy występują tylko wartości dodatnie, takie jak czasy pracy do awarii.
W zależności od parametru kształtu, rozkład Weibulla może reprezentować różne przebiegi. Czyni to go bardzo elastycznym i często używanym do opisu żywotności technicznej, zachowania zużycia lub prawdopodobieństw awarii.
Rozkład wykładniczy
Rozkład wykładniczy opisuje czasy oczekiwania lub czasy do następnego zdarzenia. Jest często używany, gdy zdarzenia występują losowo i niezależnie od siebie.
Typowe przykłady to czasy oczekiwania, czasy reakcji lub proste modele przestojów. Rozkład zaczyna się od zera, a następnie stopniowo maleje. Jest odpowiedni tylko dla wartości większych lub równych zero.
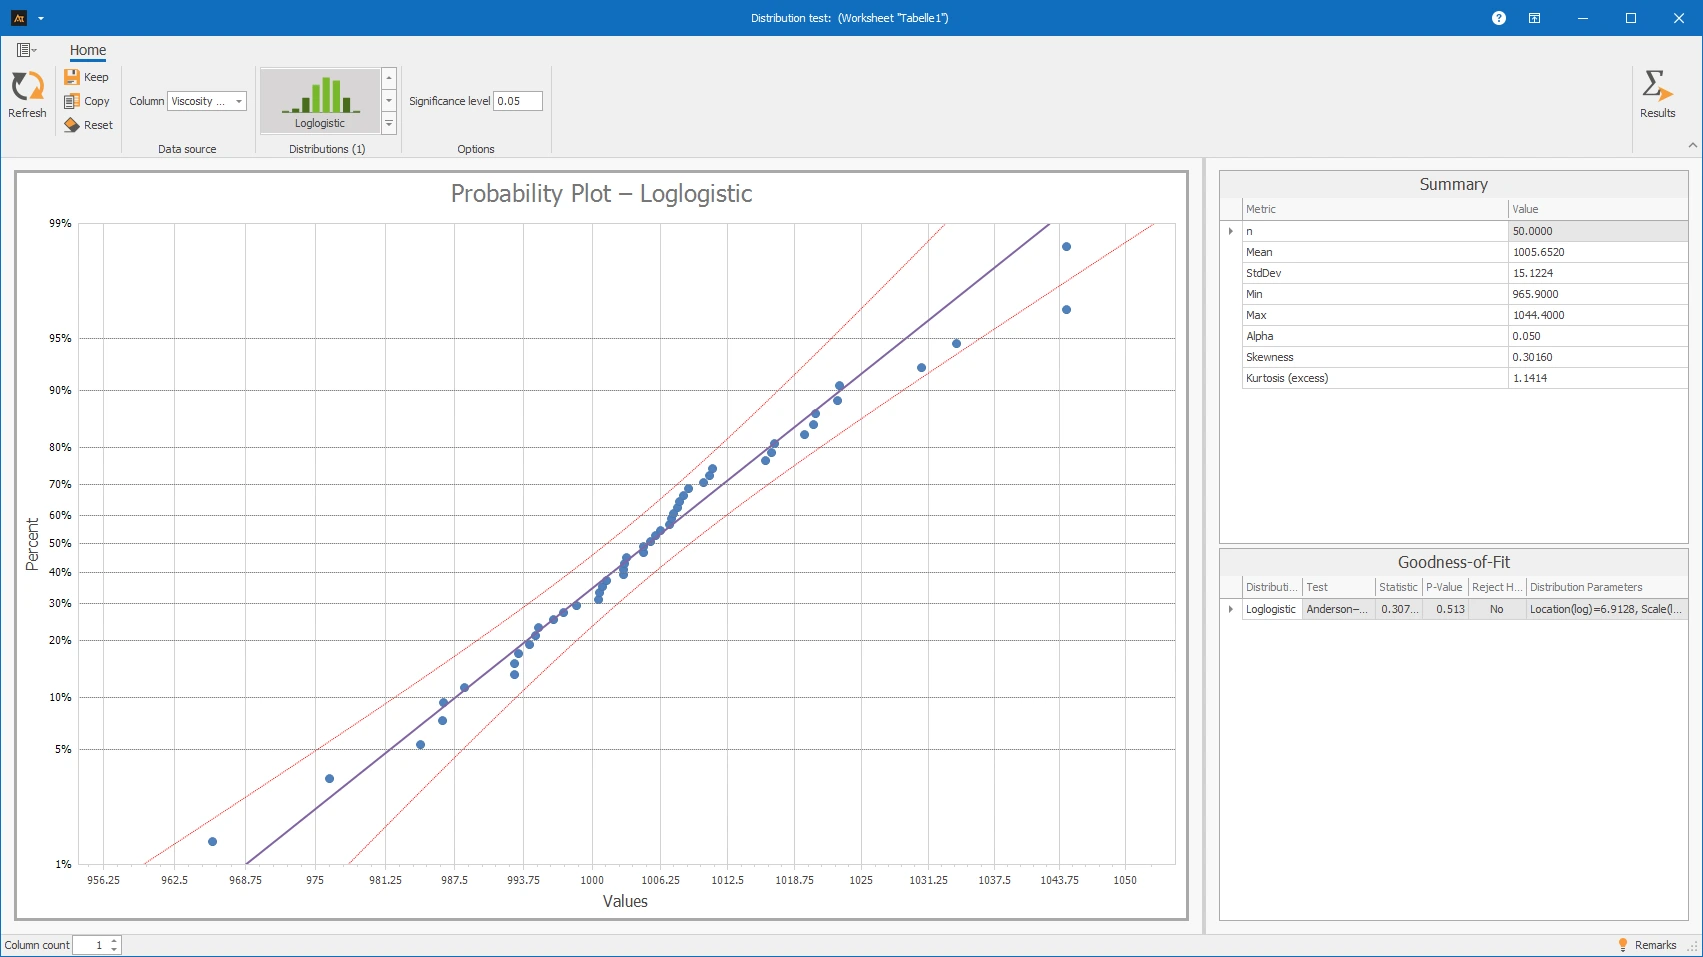
Rozkład log-logistyczny
Rozkład log-logistyczny jest odpowiedni dla dodatnich, prawoskośnych danych. Jest często używany do danych dotyczących żywotności, czasu lub procesów, gdzie występuje wiele mniejszych wartości i kilka znacznie większych wartości.
W niektórych przypadkach przypomina rozkład lognormalny, ale może reprezentować silniejsze wyrażenia w prawym ogonie. Czyni to go użytecznym, gdy długie czasy przetwarzania lub późne awarie mają większe znaczenie.
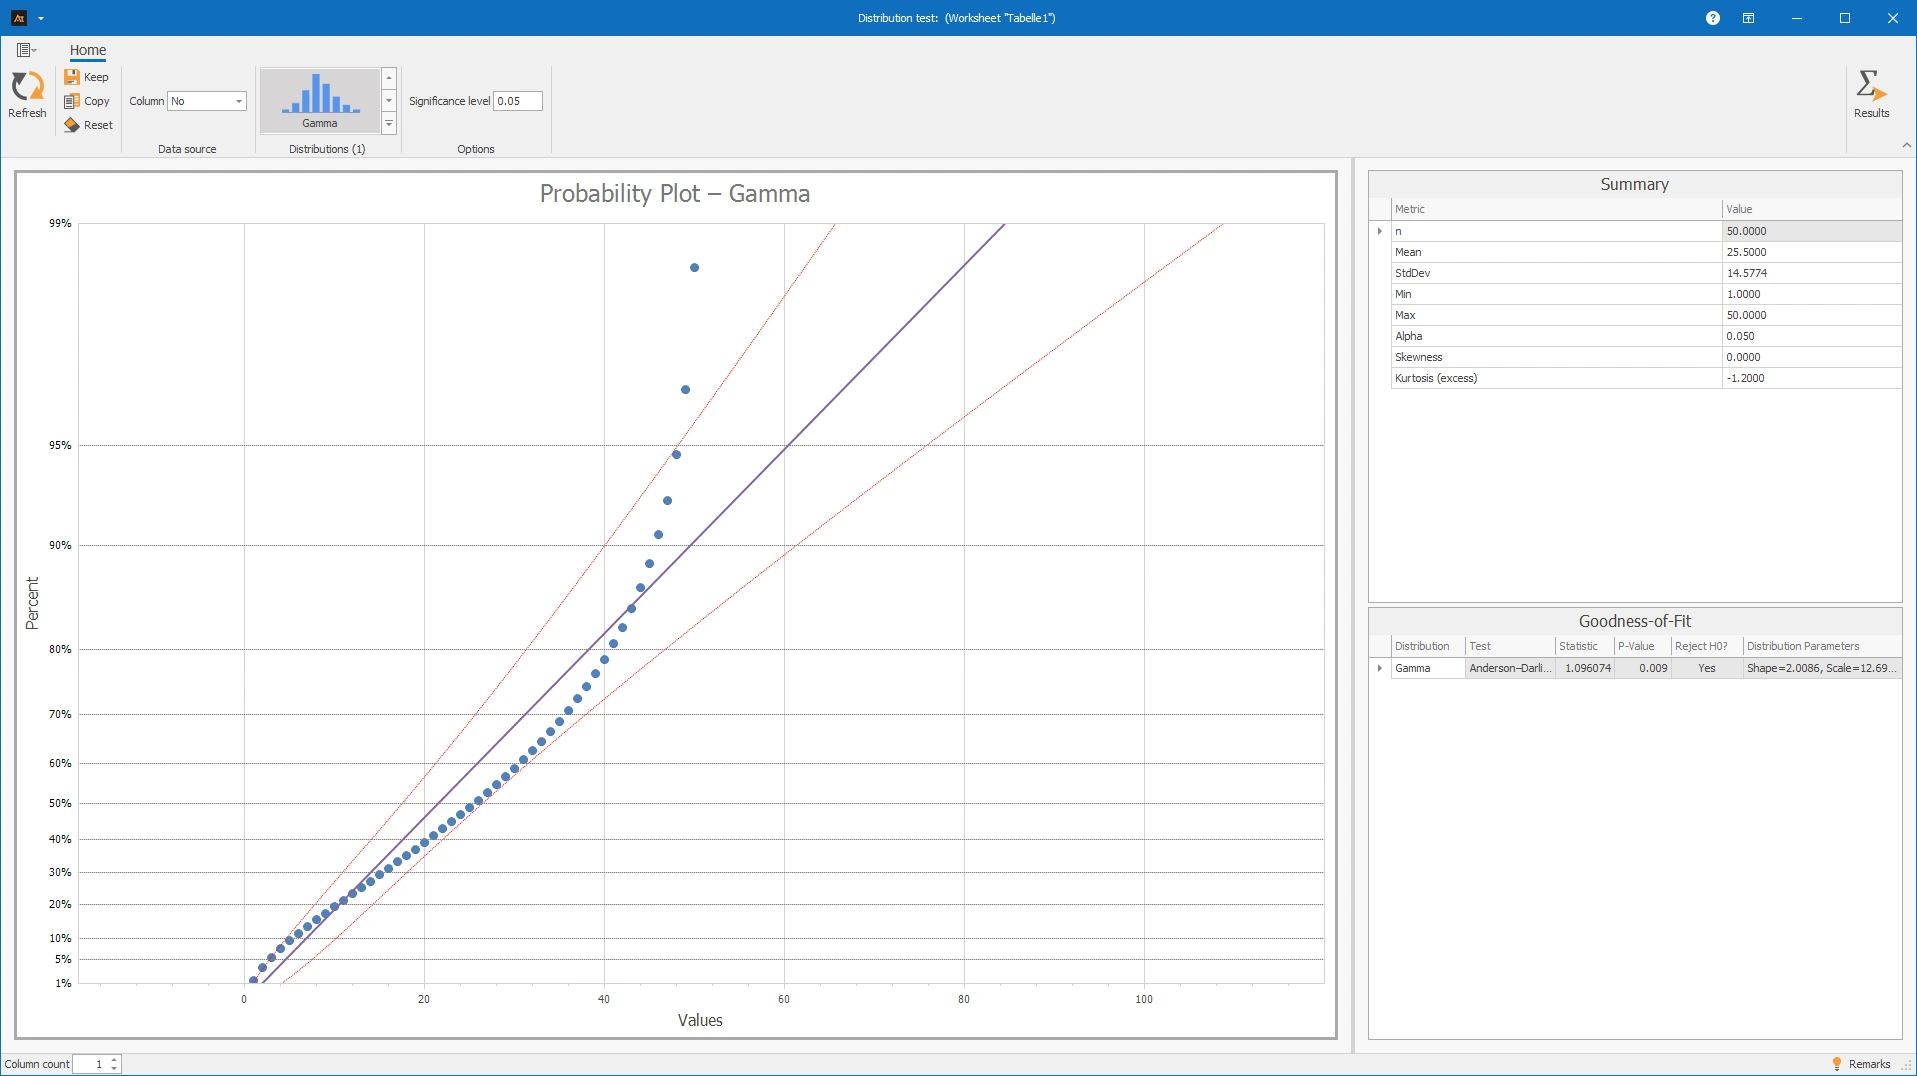
Rozkład gamma
Rozkład gamma jest używany dla dodatnich, prawoskośnych danych. Jest odpowiedni dla pomiarów takich jak czasy oczekiwania, czasy przepustowości, ilości lub obciążenia, pod warunkiem, że nie mogą wystąpić wartości ujemne.
Jest bardziej elastyczny niż rozkład wykładniczy, ponieważ może przyjmować różne formy. Pozwala to na dobre opisanie zarówno silnie skośnych, jak i umiarkowanie skośnych danych.
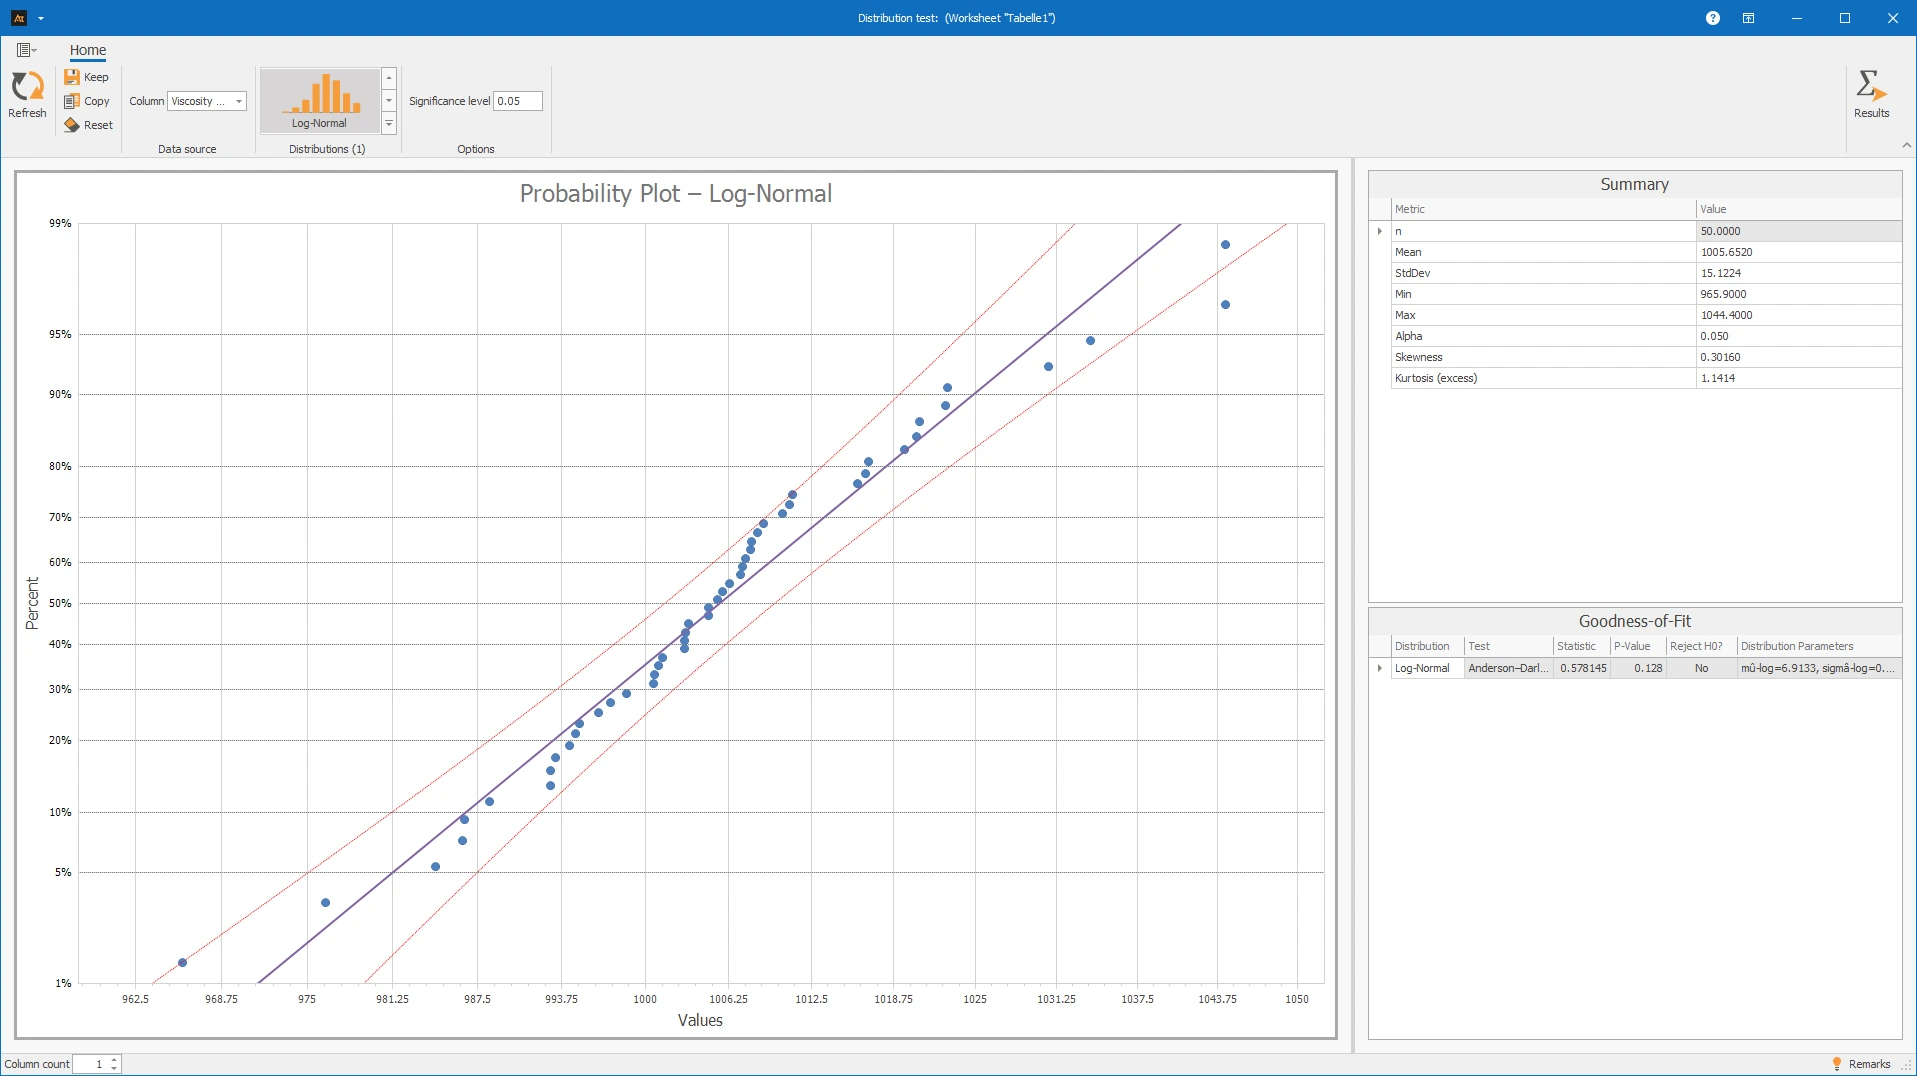
Rozkład lognormalny
Rozkład lognormalny powstaje, gdy wartości logarytmiczne są w przybliżeniu rozkładem normalnym. Jest używany dla dodatnich danych, które są prawoskośne.
Typowe przykłady to czasy, żywotności, stężenia, koszty lub inne ilości, gdzie mogą wystąpić bardzo duże wartości indywidualne. Jeśli dane nie są rozkładem normalnym, rozkład lognormalny może często lepiej pasować.
Rozkład logistyczny
Rozkład logistyczny jest symetryczny i przypomina rozkład normalny. Jednak ma nieco silniejsze ogony, co pozwala na nieco częstsze występowanie wartości ekstremalnych niż w rozkładzie normalnym.
Może być używany, gdy dane są ogólnie symetrycznie rozłożone, ale rozkład normalny nie opisuje wystarczająco dobrze ogonów.
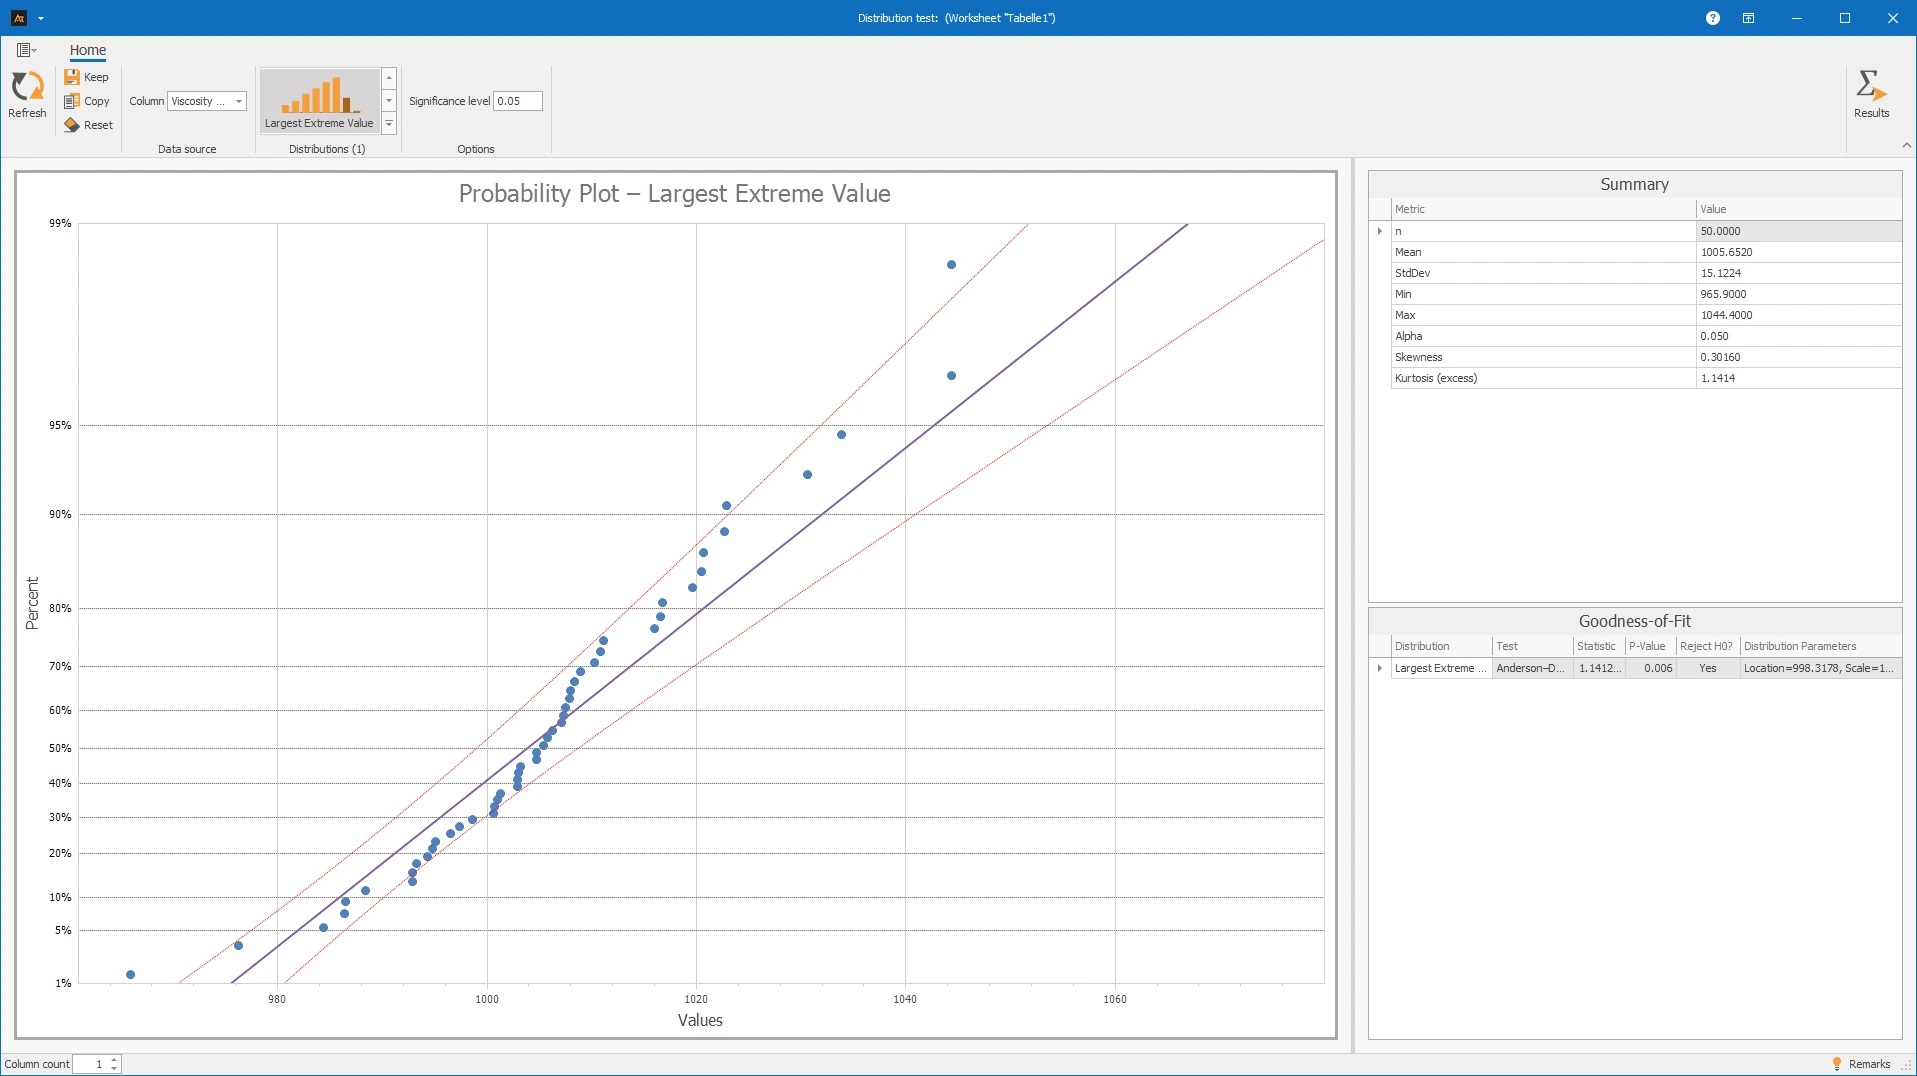
Rozkład Gumbela
Rozkład Gumbela opisuje wartości maksymalne. Jest używany, gdy szczególnie wysokie wartości są w centrum uwagi, takie jak maksymalne obciążenia, szczytowe temperatury, maksymalne czasy oczekiwania lub wartości szczytowe.
Jest odpowiedni, gdy nie typowa wartość średnia, ale zachowanie największych obserwacji jest ważne.
Rozkład wartości ekstremalnych minimalnych
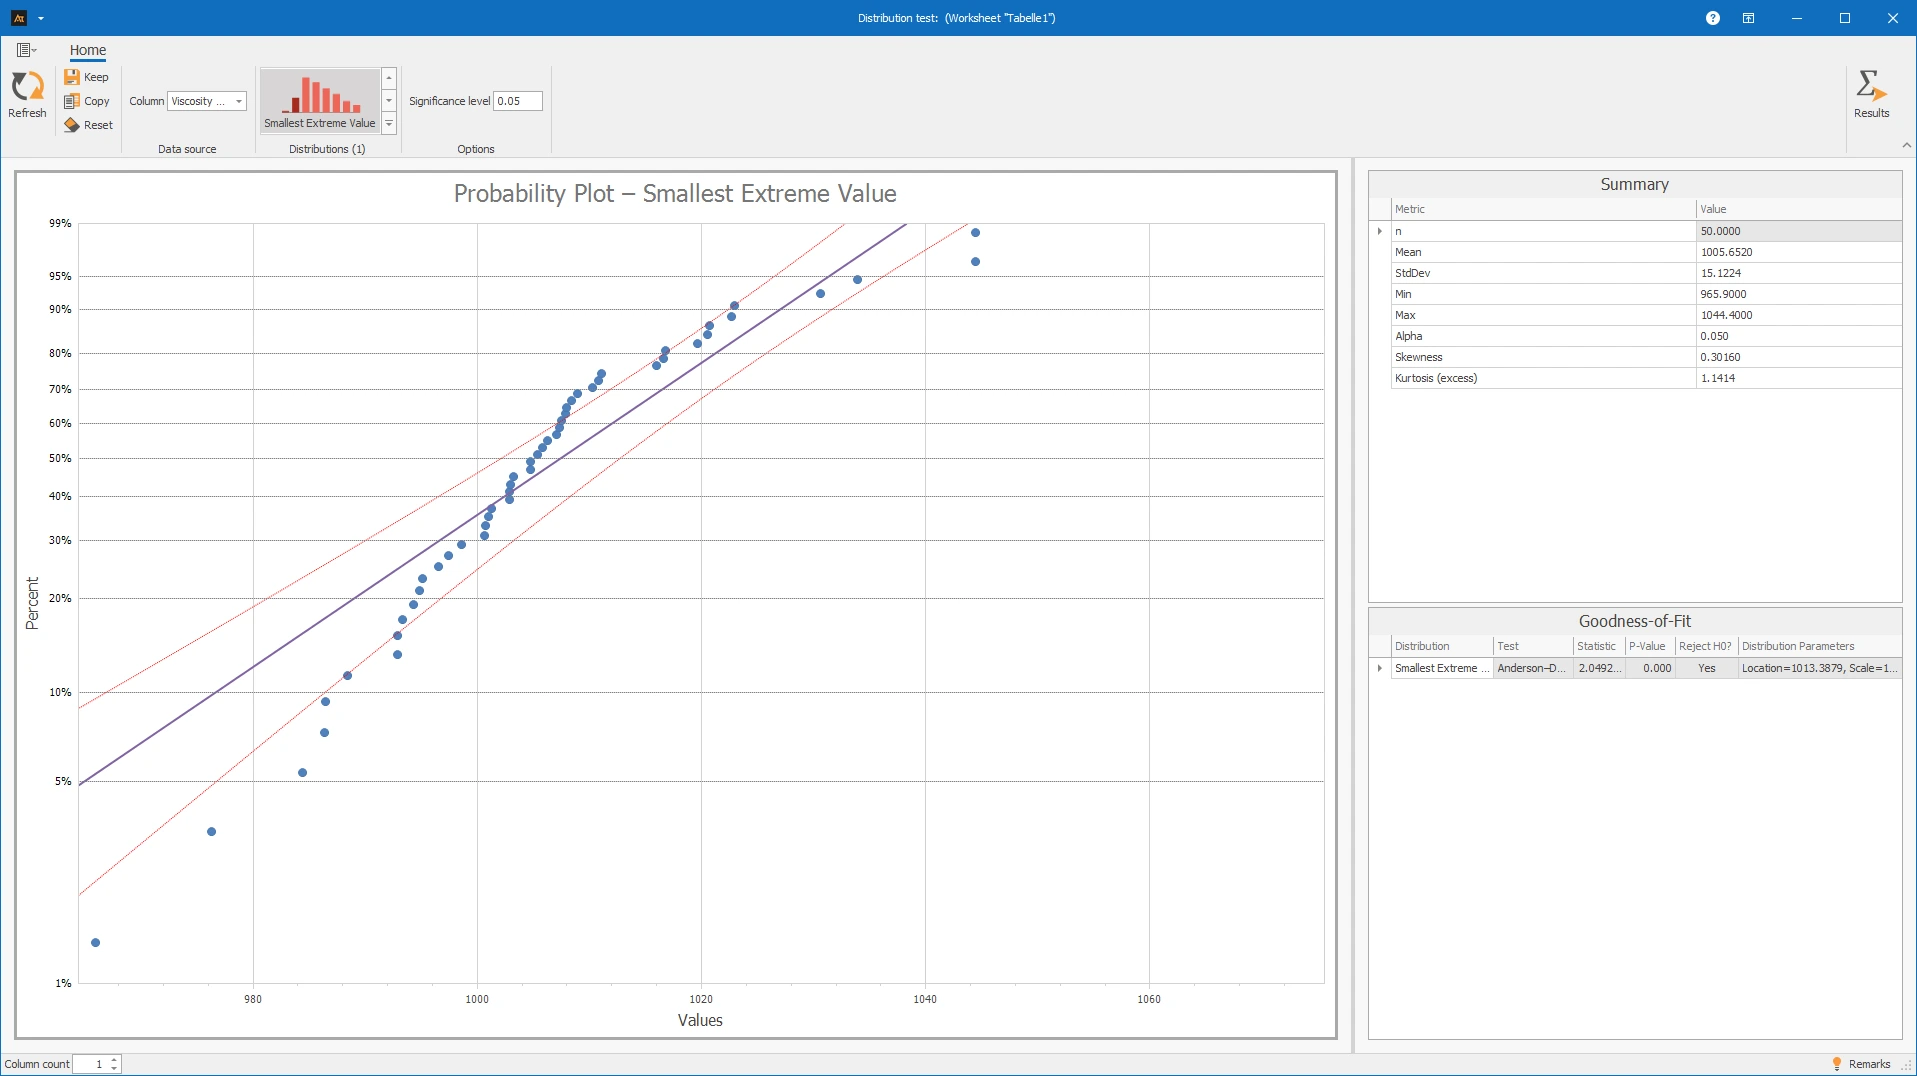
Rozkład wartości ekstremalnych minimalnych opisuje wartości minimalne. Jest używany, gdy szczególnie małe wartości są w centrum uwagi, takie jak minimalne wytrzymałości, najkrótsze żywotności lub najwcześniejsze awarie.
Jest pomocny, gdy trzeba ocenić ryzyko wynikające z bardzo małych pomiarów, na przykład w granicach bezpieczeństwa lub minimalnych wymaganiach.
Dla danych nominalnych lub porządkowych test rozkładu nie ma sensu, ponieważ te typy danych nie mogą być opisane przez rozkłady ciągłe, takie jak normalny, Weibulla czy gamma.
Dla czystych danych liczbowych lub zdarzeń dyskretnych należy sprawdzić, czy konkretna metoda dla rozkładów dyskretnych jest bardziej odpowiednia. Test rozkładu jest zaprojektowany dla rozkładów ciągłych obsługiwanych w narzędziu.
Test rozkładu jest bardziej odpowiedni, gdy kilka możliwych rozkładów ma być porównanych ze sobą.
Ilość napełnienia sosu pomidorowego
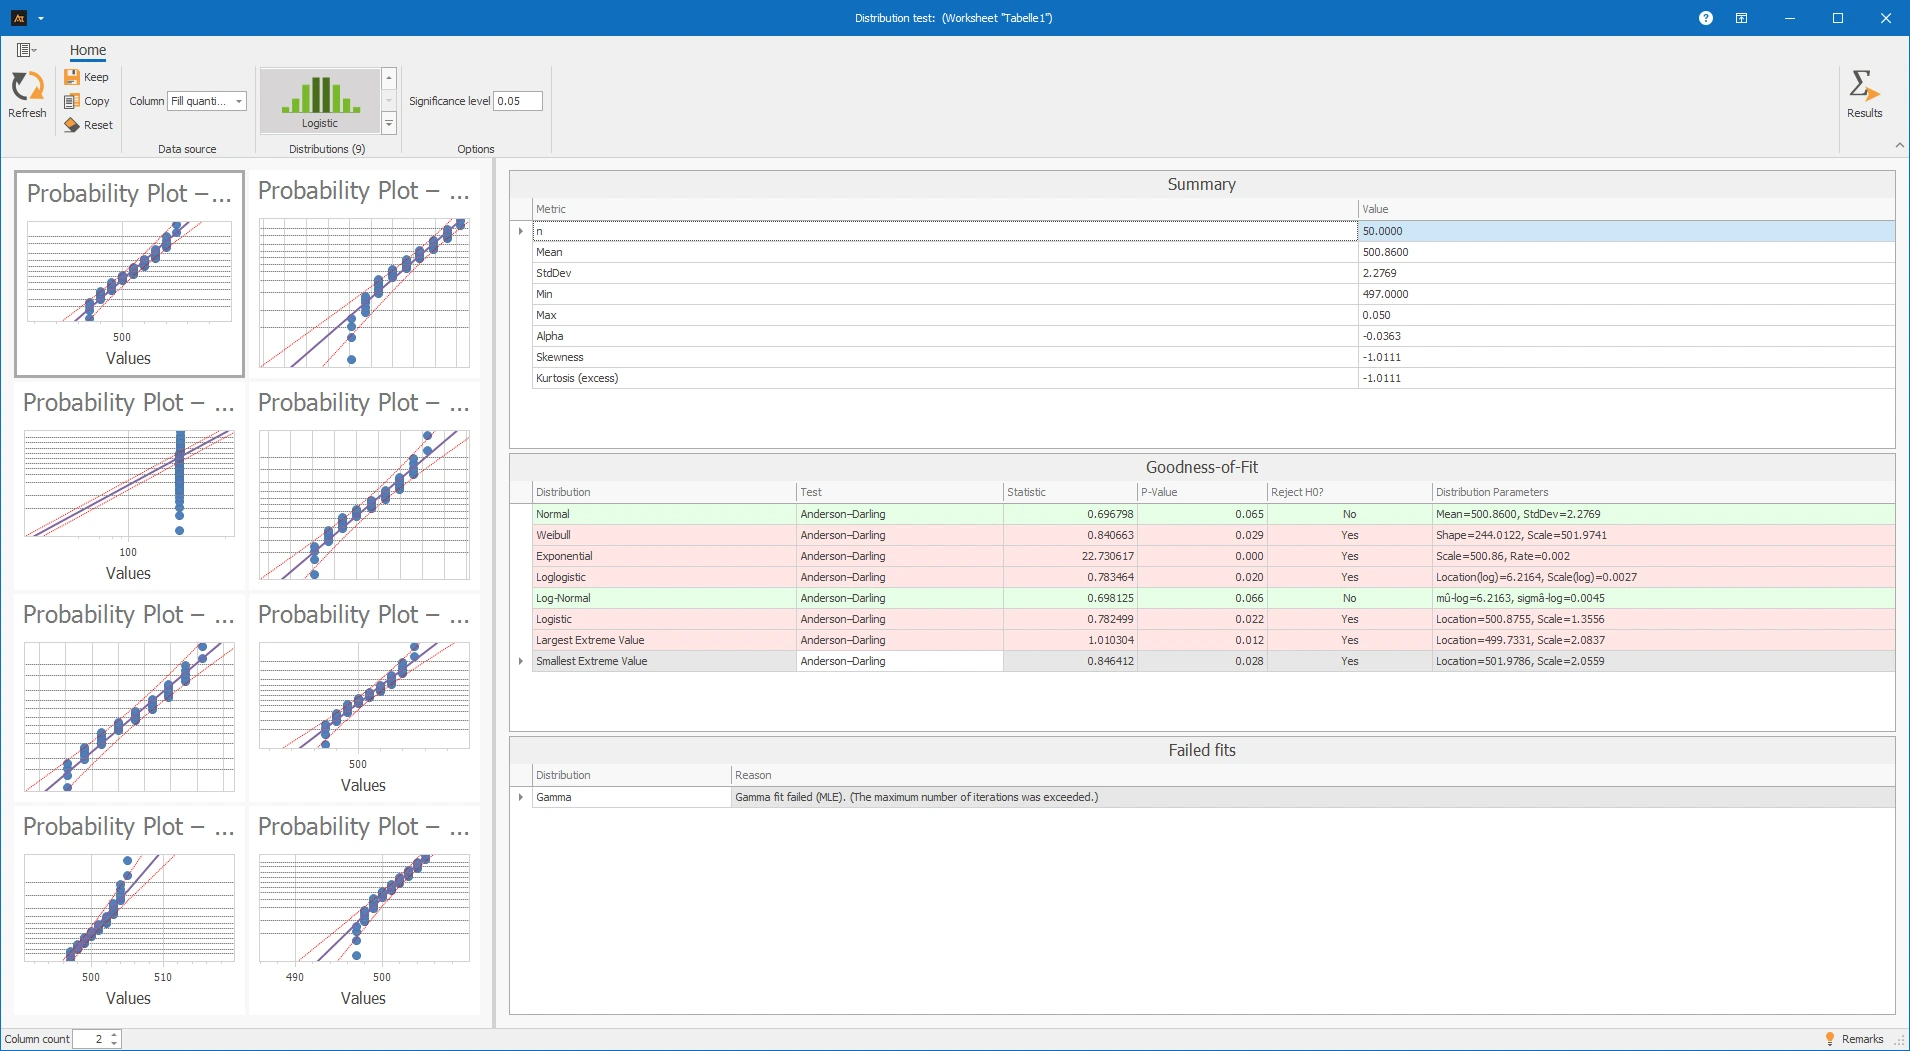
W tym przykładzie badana jest ilość napełnienia sosu pomidorowego. Każde napełnienie powinno zawierać 500 ml. Ze względu na normalne wahania procesu, niektóre ilości napełnienia są nieco poniżej, a inne nieco powyżej wartości docelowej. Ponieważ takie pomiary często rozpraszają się w przybliżeniu symetrycznie wokół wartości docelowej, sprawdzane jest, które rozkłady sensownie opisują dane. W tym celu ilości napełnienia są porównywane z kilkoma rozkładami, w tym z rozkładem normalnym.
Interpretacja
Ilości napełnienia zostały porównane z kilkoma rozkładami. W rezultacie rozkład normalny nie jest odrzucony, ponieważ wartość p 0,065 jest większa niż poziom istotności 0,05. Również na wykresie prawdopodobieństwa punkty w większości leżą blisko linii. Dlatego ilości napełnienia można w przybliżeniu opisać rozkładem normalnym.
Z kolei kilka innych rozkładów jest odrzuconych, ponieważ ich wartości p są mniejsze lub równe 0,05. Należą do nich między innymi Weibull, wykładniczy, log-logistyczny, logistyczny oraz rozkład największej wartości ekstremalnej. Istnieją dowody statystyczne na to, że te rozkłady nie opisują danych odpowiednio.
Rozkład log-normalny również nie jest odrzucony. Jednak w kontekście ilości napełnienia rozkład normalny jest często sensowny, ponieważ jest to pomiar ciągły, który zazwyczaj rozprasza się wokół wartości docelowej.
Rozkład gamma nie mógł zostać obliczony, ponieważ dopasowanie nie powiodło się. Dlatego nie jest używany do interpretacji.
Wniosek:
Do dalszej analizy można użyć rozkładu normalnego, ponieważ nie jest on statystycznie odrzucony i dobrze pasuje do ilości napełnienia.
Czas realizacji zamówienia w Przyjęciu Towarów
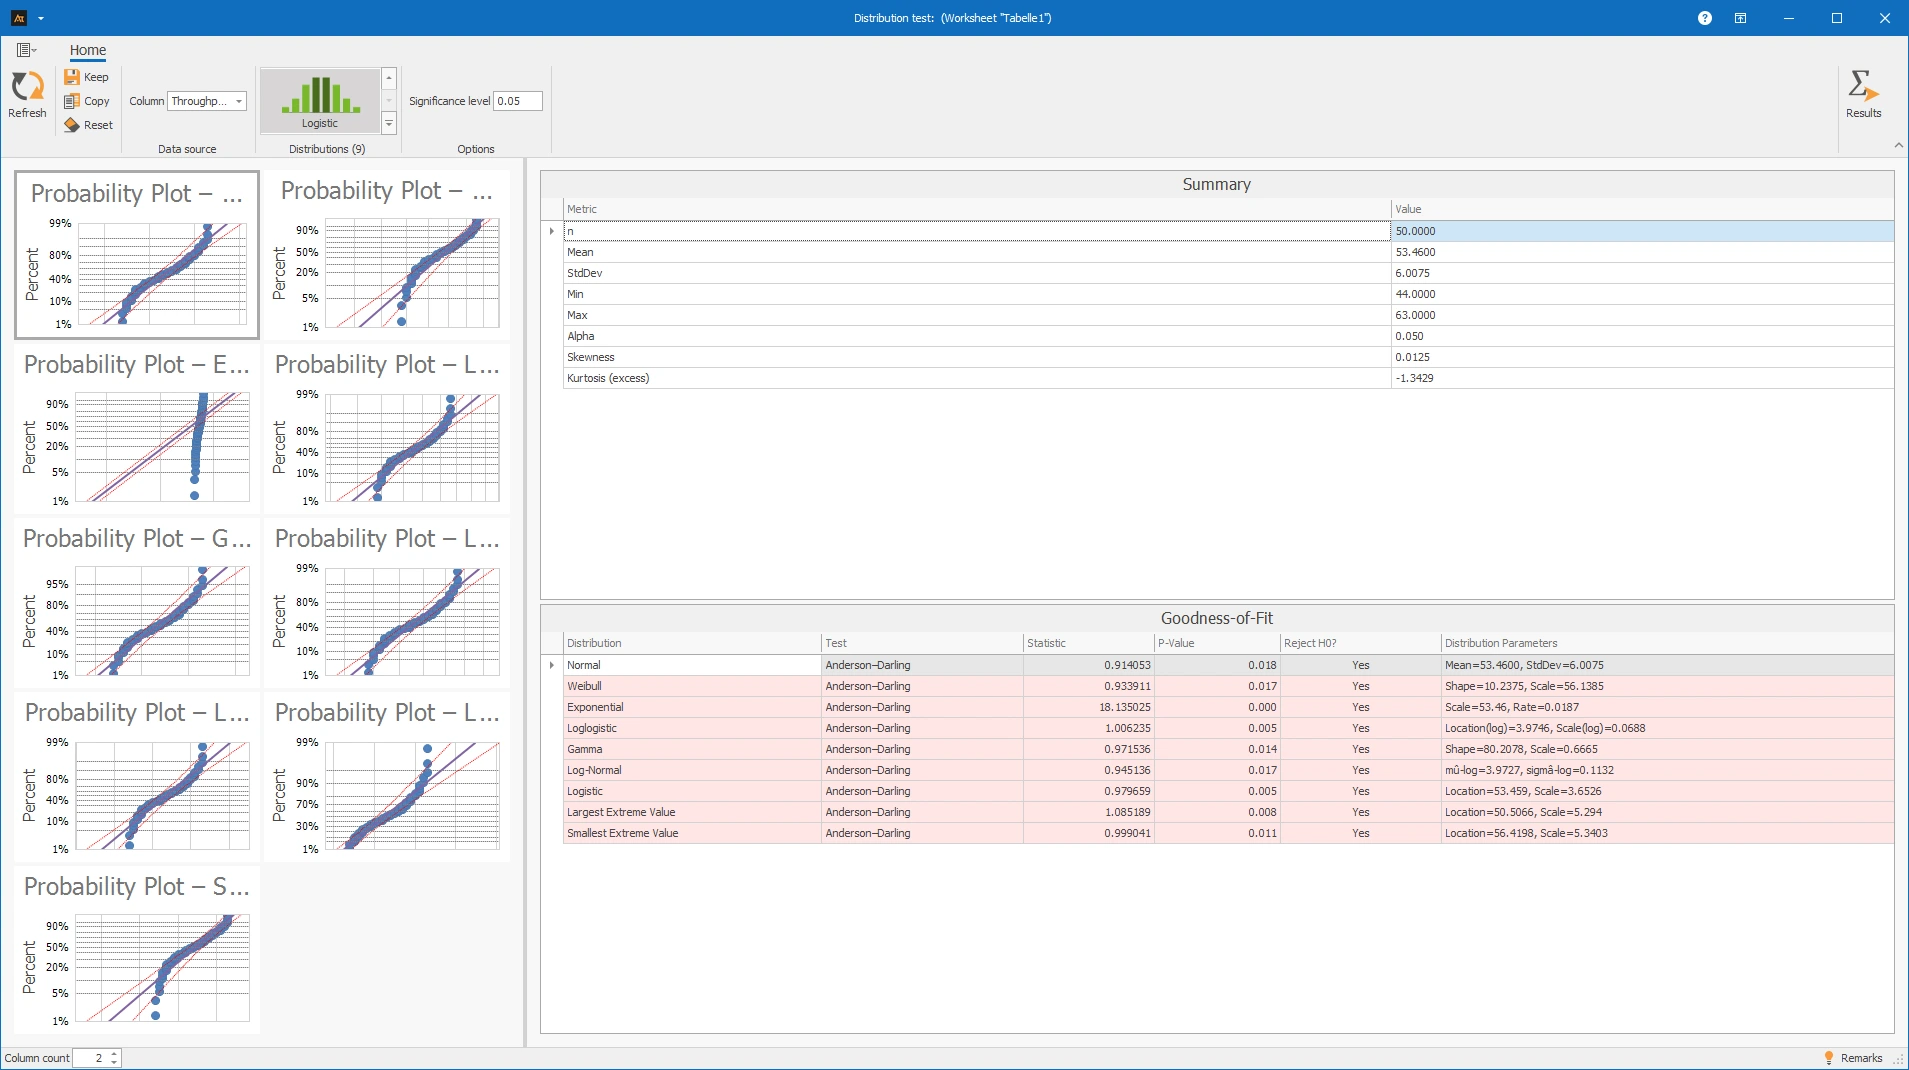
W przyjęciu towarów czasy przetwarzania często mają prawoskośny rozkład: wiele zamówień jest realizowanych szybko, ale niektóre procesy trwają znacznie dłużej. Dlatego rozkład log-normalny, gamma, Weibulla lub wykładniczy może być bardziej prawdopodobny niż rozkład normalny.
Interpretacja
Czasy realizacji porównano z kilkoma rozkładami. Dla wszystkich testowanych rozkładów wartość p jest mniejsza niż 0,05. Dlatego wszystkie rozkłady są odrzucone.
Również na wykresach prawdopodobieństwa punkty nie leżą wystarczająco dobrze na liniach. Dlatego dane nie mogą być odpowiednio opisane przez żaden z testowanych rozkładów.
Wniosek:
Żaden z testowanych rozkładów nie powinien być używany do czasów realizacji. Należy sprawdzić, czy różne stany procesów lub typy zamówień powodują zmienność.
Czas reakcji helpdesku IT (Specyfikacja: maks. 35 minut (OSG))
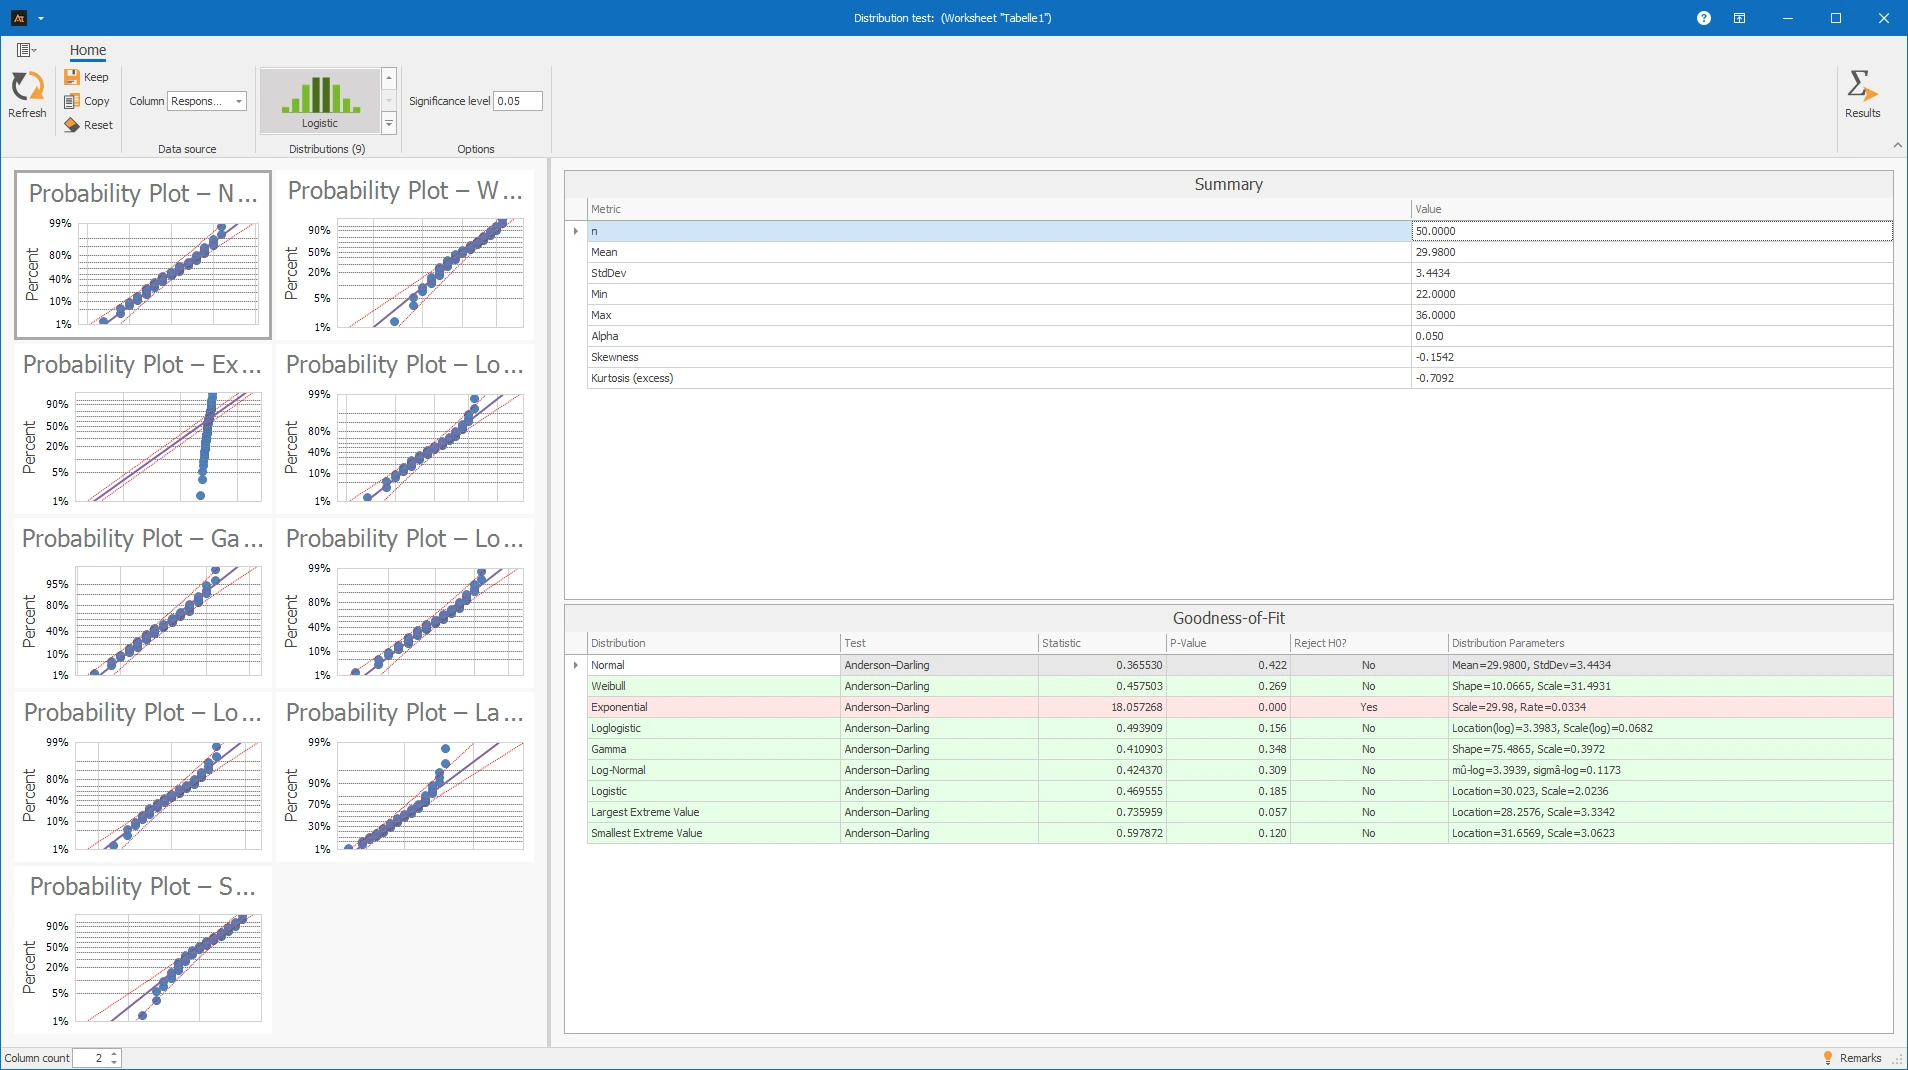
Proste i złożone zapytania są odbierane w serwisie IT. Może to skutkować czasami reakcji, które różnią się wokół typowej wartości, ale mają również długie prawe ogony. Best Fit pomaga sprawdzić, które rozkłady najlepiej opisują to zachowanie.
Interpretacja
Czasy reakcji porównano z kilkoma rozkładami. Większość testowanych rozkładów nie jest odrzucana, ponieważ ich wartości p są większe niż 0,05. Tylko rozkład wykładniczy jest odrzucany, ponieważ wartość p jest mniejsza niż 0,05.
Dla tego rozkładu dane nie pasują wystarczająco dobrze. Wykresy prawdopodobieństwa również pokazują głównie punkty blisko linii dla nieodrzuconych rozkładów.
Wniosek:
Czasy reakcji można w przybliżeniu opisać kilkoma rozkładami. Do dalszej analizy należy wybrać rozkład odpowiedni dla tematu; rozkładu wykładniczego nie należy używać.
Żywotność łożysk kulkowych
Dla nowego typu maszyny, łożyska kulkowe są testowane w trybie ciągłym. Każde łożysko pozostaje na stanowisku testowym, dopóki nie przestanie działać. Takie dane dotyczące żywotności są zazwyczaj pozytywne i często nie są rozkładem normalnym.
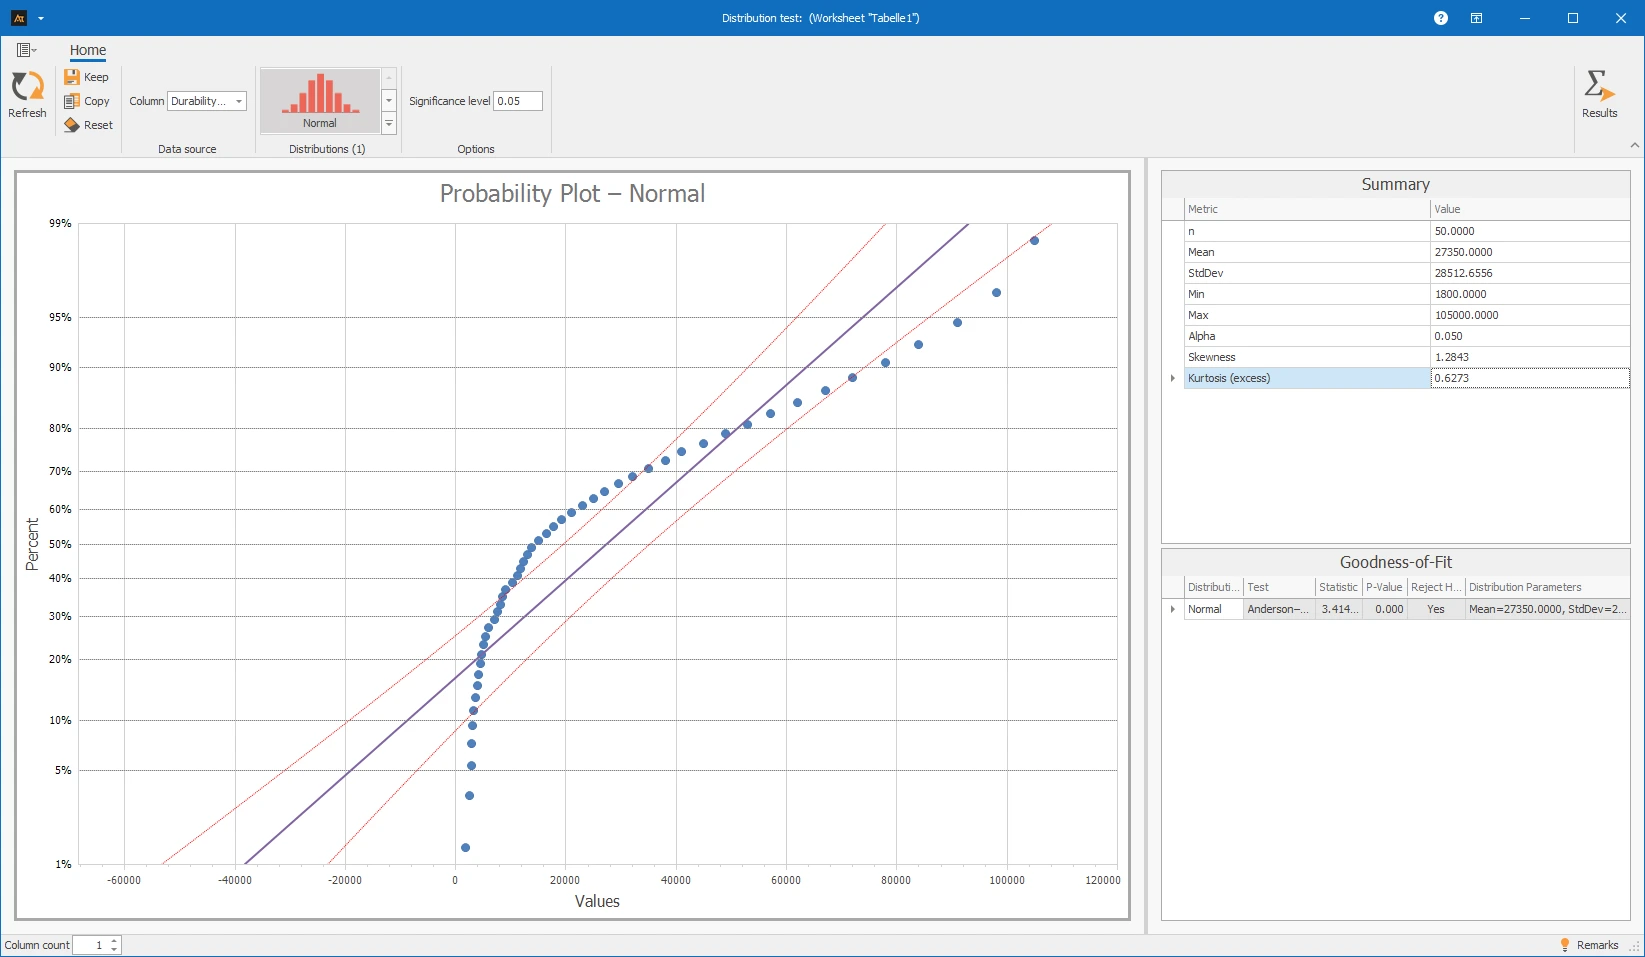
Na wykresie prawdopodobieństwa rozkładu normalnego punkty mogą znacznie odbiegać od linii. To przemawia przeciwko normalnemu rozkładowi żywotności.
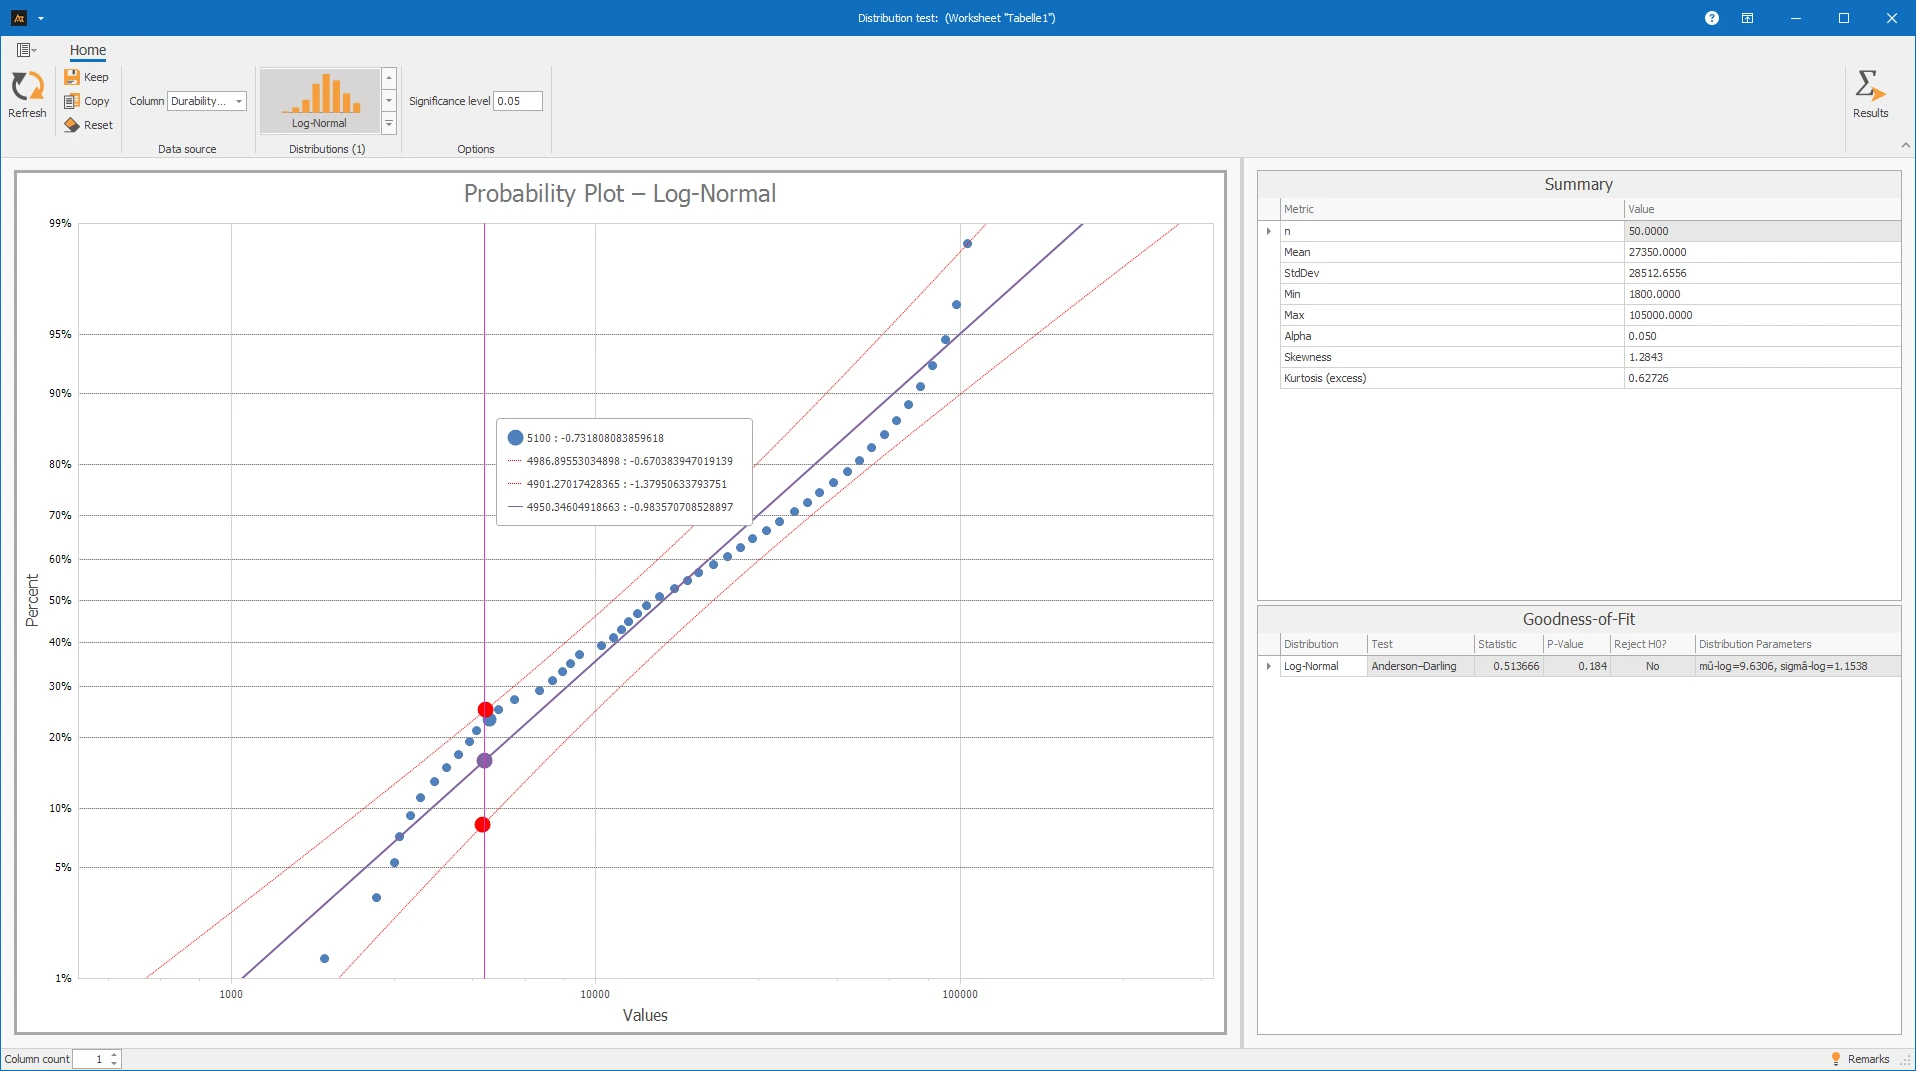
Żywotność łożysk kulkowych została przetestowana z rozkładem lognormalnym. Wartość p wynosi 0,190 i jest zatem większa niż 0,05. Rozkład lognormalny nie jest zatem odrzucony.
Również na wykresie prawdopodobieństwa punkty są w większości blisko linii. Dane dotyczące żywotności można zatem w przybliżeniu opisać rozkładem lognormalnym.
Dane ciągłe: Dane zebrane za pomocą przyrządu pomiarowego, które mogą mieć jednostki i miejsca dziesiętne.
Rozkład: Model matematyczny opisujący, jak pomiary zazwyczaj się rozprzestrzeniają.
Test Andersona-Darlinga: Test statystyczny sprawdzający, czy dane pasują do wybranego rozkładu.
Wartość p: Metryka oceny wyniku testu. Im mniejsza wartość p, tym silniej dane przemawiają przeciwko testowanemu rozkładowi.
Statystyka A²: Miara odchylenia danych od testowanego rozkładu. Mniejsze wartości zazwyczaj wskazują na mniejsze odchylenie od testowanego rozkładu.
H0: Hipoteza zerowa testu. Stwierdza: Dane podążają za testowanym rozkładem.
n = Wielkość próby: Liczba ważnych pomiarów w próbie.
Średnia: Średnia wszystkich pomiarów. Opisuje centralne położenie danych.
Odchylenie standardowe: Miara tego, jak bardzo pomiary rozprzestrzeniają się wokół średniej. Małe odchylenie standardowe oznacza małe rozprzestrzenienie, duże odchylenie standardowe oznacza większe rozprzestrzenienie.
Minimum: Najmniejszy pomiar w rozważanej próbie.
Maksimum: Największy pomiar w rozważanej próbie.
Alfa (α): Ustalony poziom istotności i próg decyzyjny dla wartości p. Często używa się α = 0,05. Jeśli wartość p jest mniejsza niż Alfa, hipoteza zerowa H0 jest odrzucana.
Skośność: Metryka symetrii rozkładu. Wartość bliska 0 wskazuje na rozkład w przybliżeniu symetryczny. Wartości dodatnie lub ujemne wskazują na silniejsze wyrażenie rozkładu w prawo lub w lewo, odpowiednio.
Kurtoza: Metryka opisująca kształt rozkładu, szczególnie jak silnie pomiary koncentrują się w centrum i na ogonach. Może dostarczać wskazówek, czy rozkład jest bardziej szczytowy czy płaski w porównaniu do rozkładu normalnego.
Test rozkładu oblicza odpowiadające parametry, statystykę testową i wartość p dla wybranych rozkładów. Funkcje z biblioteki Numerics.NET są używane do obliczania statystyki testowej.