


Moc wskazuje prawdopodobieństwo, z jakim test statystyczny wykrywa faktycznie istniejący efekt.
Służy do oceny, czy istniejąca baza danych jest wystarczająca do wiarygodnego wykrycia istotnych różnic, wariancji lub zmian w wskaźnikach.
W przeciwieństwie do klasycznego testu hipotez, moc nie koncentruje się na decyzji między hipotezą alternatywną a hipotezą zerową, lecz na tym, jak silny jest test przy założonych warunkach:
- wysoka moc → istotny efekt jest wykrywany z dużym prawdopodobieństwem
- niska moc → istniejący efekt może pozostać niewykryty mimo badania
Ważne: Przy obliczaniu mocy wprowadzane są dane podsumowane w AlphadiTab. Dlatego nie są wymagane surowe dane, ale takie metryki jak wielkość próby, średnia, odchylenie standardowe lub liczba zdarzeń.
W rozwoju produktu testowana jest nowa formulacja sosu pomidorowego. Celem jest ustalenie, czy lepkość nowej formulacji różni się średnio od poprzedniej formulacji.
W tym celu przeprowadzane są pomiary lepkości na próbkach starej formulacji i nowej formulacji.
Używając testu t (2 próby), sprawdzono, czy zaobserwowana różnica średnich jest statystycznie istotna, czy można ją wyjaśnić losową zmiennością.
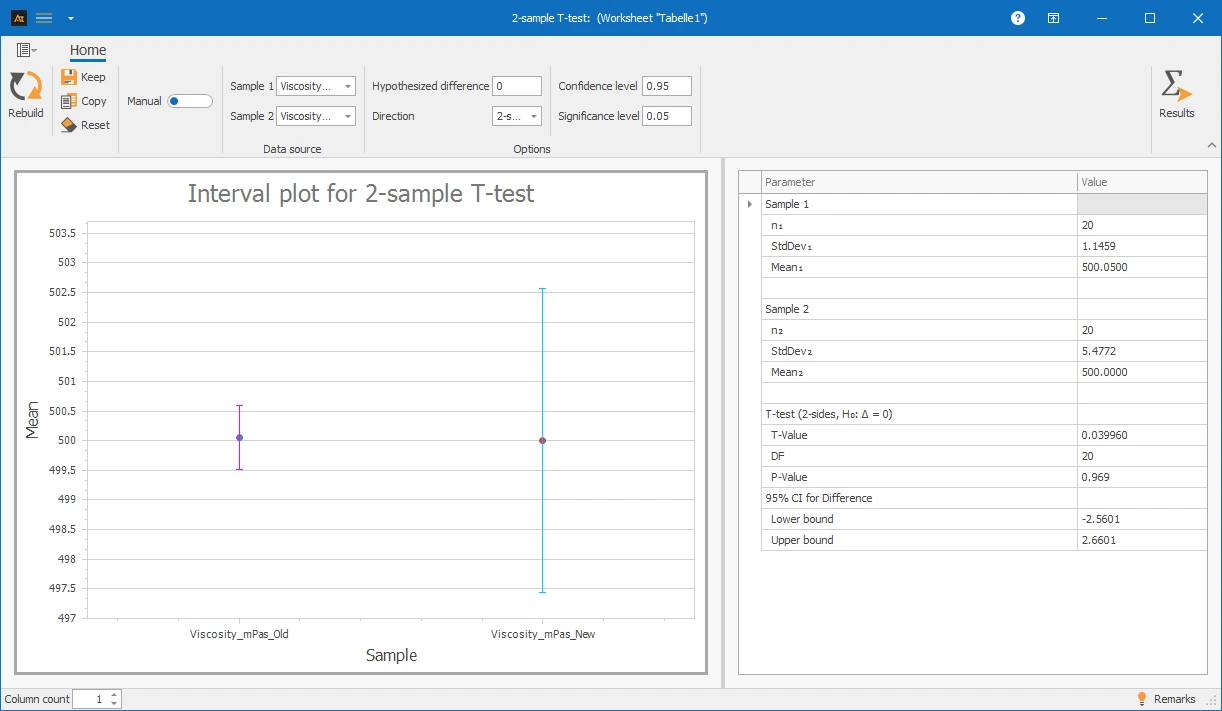
Obliczona wartość p jest znacznie powyżej poziomu istotności 0,05, więc hipoteza zerowa jest utrzymana. Na podstawie tego testu nie stwierdzono istotnej różnicy między średnią lepkością starej i nowej formulacji. Dzięki obliczeniu mocy chcemy teraz ocenić, jak niezawodnie można wykryć rzeczywistą różnicę.
W tym celu musimy określić, którą różnicę w średniej lepkości chcemy wykryć. Kluczowe jest, która różnica jest praktycznie istotna. W tym przykładzie do wykrycia jest różnica średnich wynosząca 0,5 MPa. Ta różnica odpowiada efektowi. Możemy wziąć wielkość próby i odchylenie standardowe z przeprowadzonego testu. Odchylenie standardowe zostało zaokrąglone do 5,5; tutaj używane jest mniej korzystne z dwóch odchyleń standardowych.
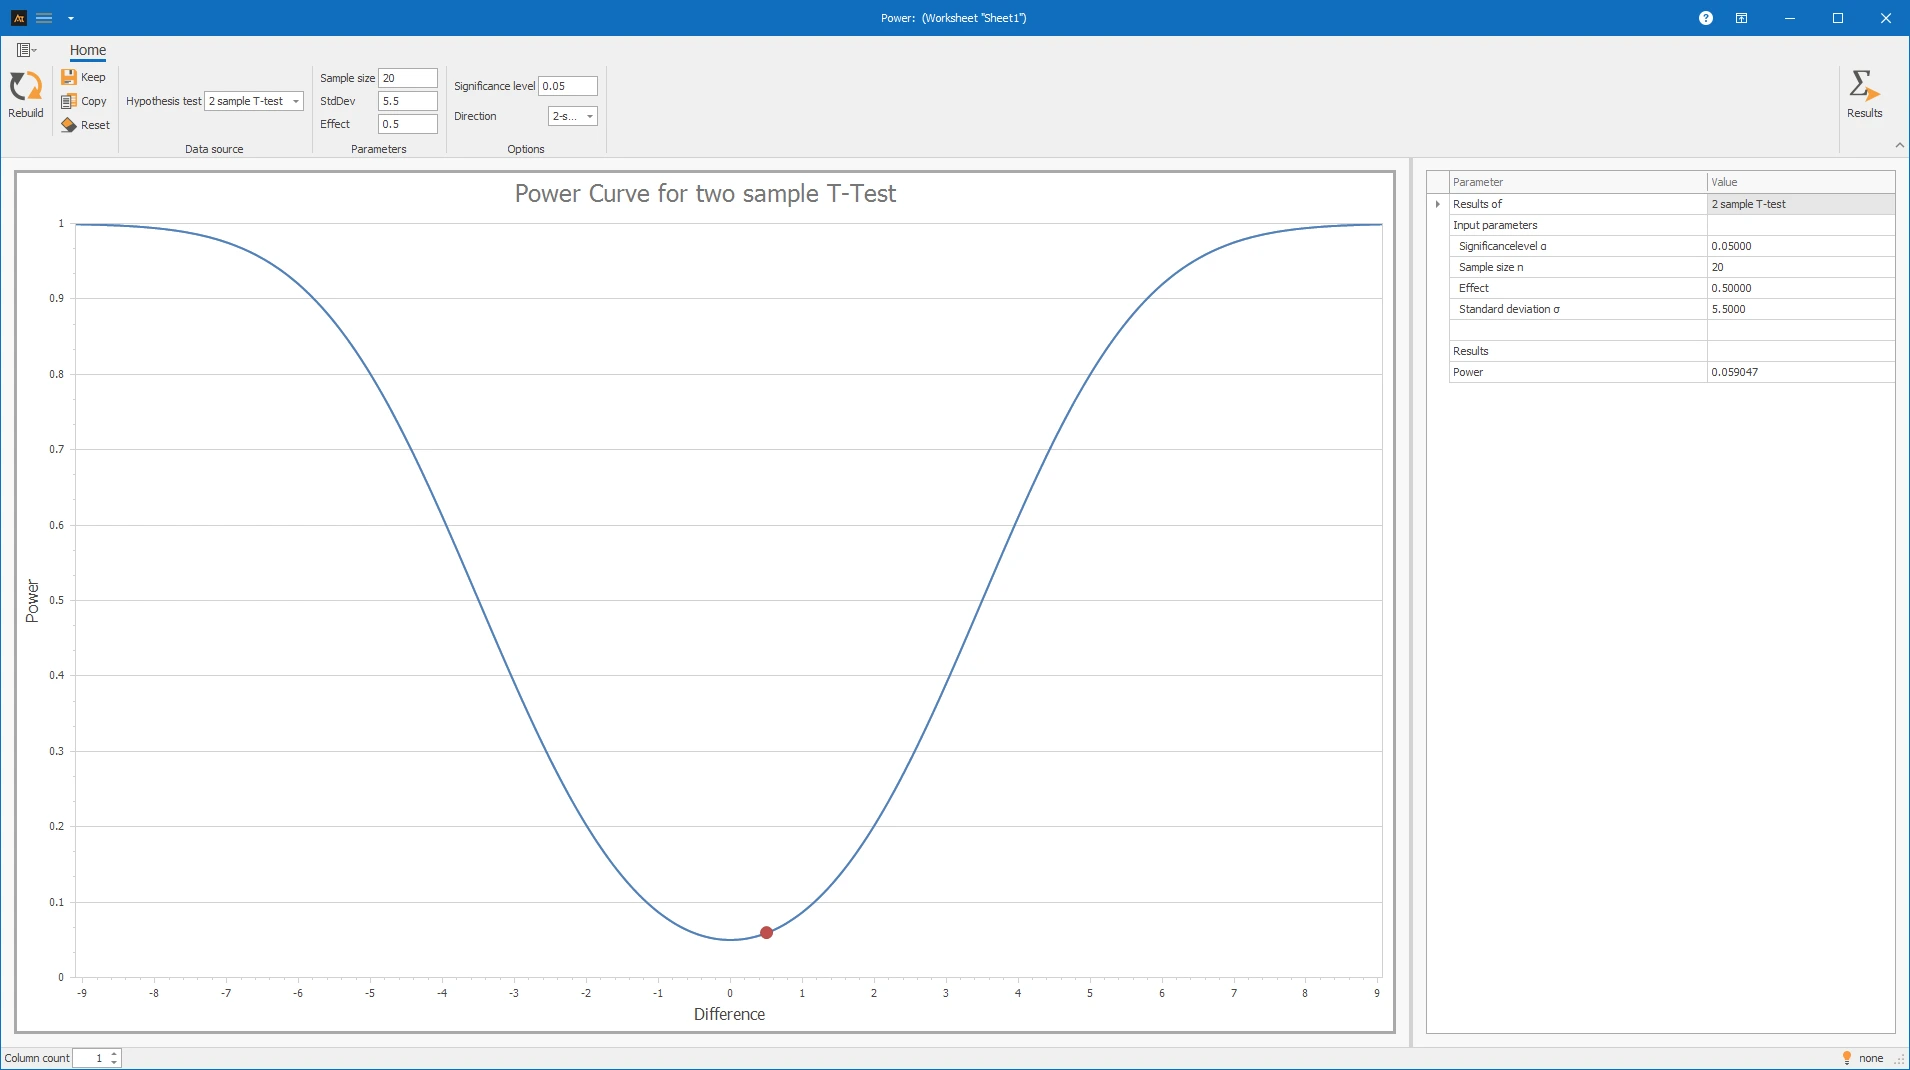
Interpretacja wyników:
Moc wynosi 0,059. To odpowiada błędowi β wynoszącemu 94,1%. W tych warunkach test nie może niezawodnie wykryć rzeczywistej różnicy 0,5 MPa. Z krzywej mocy wynika, że efekt około 5 MPa można wykryć tym testem z mocą około 80%. Błąd β wynosiłby wtedy około 20%.
Objaśnienia grafiki:
- Krzywa pokazuje moc dla różnych efektów (różnic)
- Punkt reprezentuje bieżące dane wejściowe.
Poniżej przedstawiono rozważania i kroki niezbędne do obliczenia mocy dla różnych testów statystycznych.
Przygotowanie
- Wybierz odpowiedni test (np. test t, test F, test proporcji lub ANOVA).
- Określ, która różnica, stosunek wariancji lub zmiana proporcji jest praktycznie istotna.
- Ustaw poziom istotności (zwykle α = 0,05).
- Określ pożądaną moc lub błąd beta.
- Określ kierunek hipotezy (dwustronna, większa lub mniejsza), jeśli metoda to umożliwia.
 Użycie w AlphadiTab
- W fazie Analizy wybierz narzędzie Moc.
- Wybierz odpowiedni rodzaj testu, np. test t, test F, test proporcji lub ANOVA.
- Wprowadź podsumowane metryki do pól wejściowych.
- Przeprowadź analizę, wybierając “Utwórz nowy”.
Interpretacja
- Sprawdź, czy obliczona moc jest wystarczająco wysoka.
- W praktyce często stosuje się moc 80% lub 90% jako wytyczną.
- Jeśli moc jest niska, sprawdź, czy konieczne jest większe rozmiar próby lub bardziej skoncentrowany projekt badania.
Ważne: Moc nie jest retrospektywnym potwierdzeniem wartości p. Opisuje, jak prawdopodobne jest, że test wykryje założony efekt przy wybranych danych wejściowych.
Typy testów
- t-Test: Czułość do porównywania średnich.
- F-Test: Czułość do porównywania wariancji lub rozproszeń.
- Test proporcji: Czułość do porównywania stosunków lub zdarzeń binarnych.
- ANOVA: Czułość do porównywania średnich z dwóch lub więcej grup.
- Test wariancji: Czułość do porównywania wariancji lub rozproszeń dla dwóch lub więcej próbek, opcjonalnie nieparametryczny.
W testach hipotez z 2 próbkami można wybrać kierunek dla hipotezy alternatywnej.
Wybierz dwustronny, jeśli różnica ma być wykryta bez określania konkretnego kierunku.
- To ustawienie jest przydatne, gdy zarówno wyższe, jak i niższe wartości byłyby istotne.
Przykład:
Czy średni czas dostawy różni się między dwoma procesami?
Wybierz większy, jeśli efekt jest istotny tylko w kierunku wyższych wartości.
- To ustawienie jest przydatne, na przykład, jeśli ma być testowane, czy wskaźnik sukcesu wzrasta.
Przykład:
Czy wskaźnik sprzedaży jest wyższy przy nowym podejściu sprzedażowym niż wcześniej?
Wybierz mniejszy, jeśli efekt jest istotny tylko w kierunku niższych wartości.
- To ustawienie jest przydatne, na przykład, jeśli ma być testowane, czy czas przetwarzania lub wskaźnik defektów maleje.
Przykład:
Czy średni czas przetwarzania po optymalizacji jest niższy niż wcześniej?
Objętość napełnienia sosu pomidorowego – Maszyna A vs. Maszyna B
W produkcji używa się kilku maszyn napełniających. Należy ocenić, czy dostępne dane są wystarczające do wiarygodnego wykrycia różnicy między Maszyną A a Maszyną B.
T-Test:
Różnice w średnich: Czy moc jest wystarczająca, aby wykryć różnicę 5 ml w średniej ilości napełnienia?
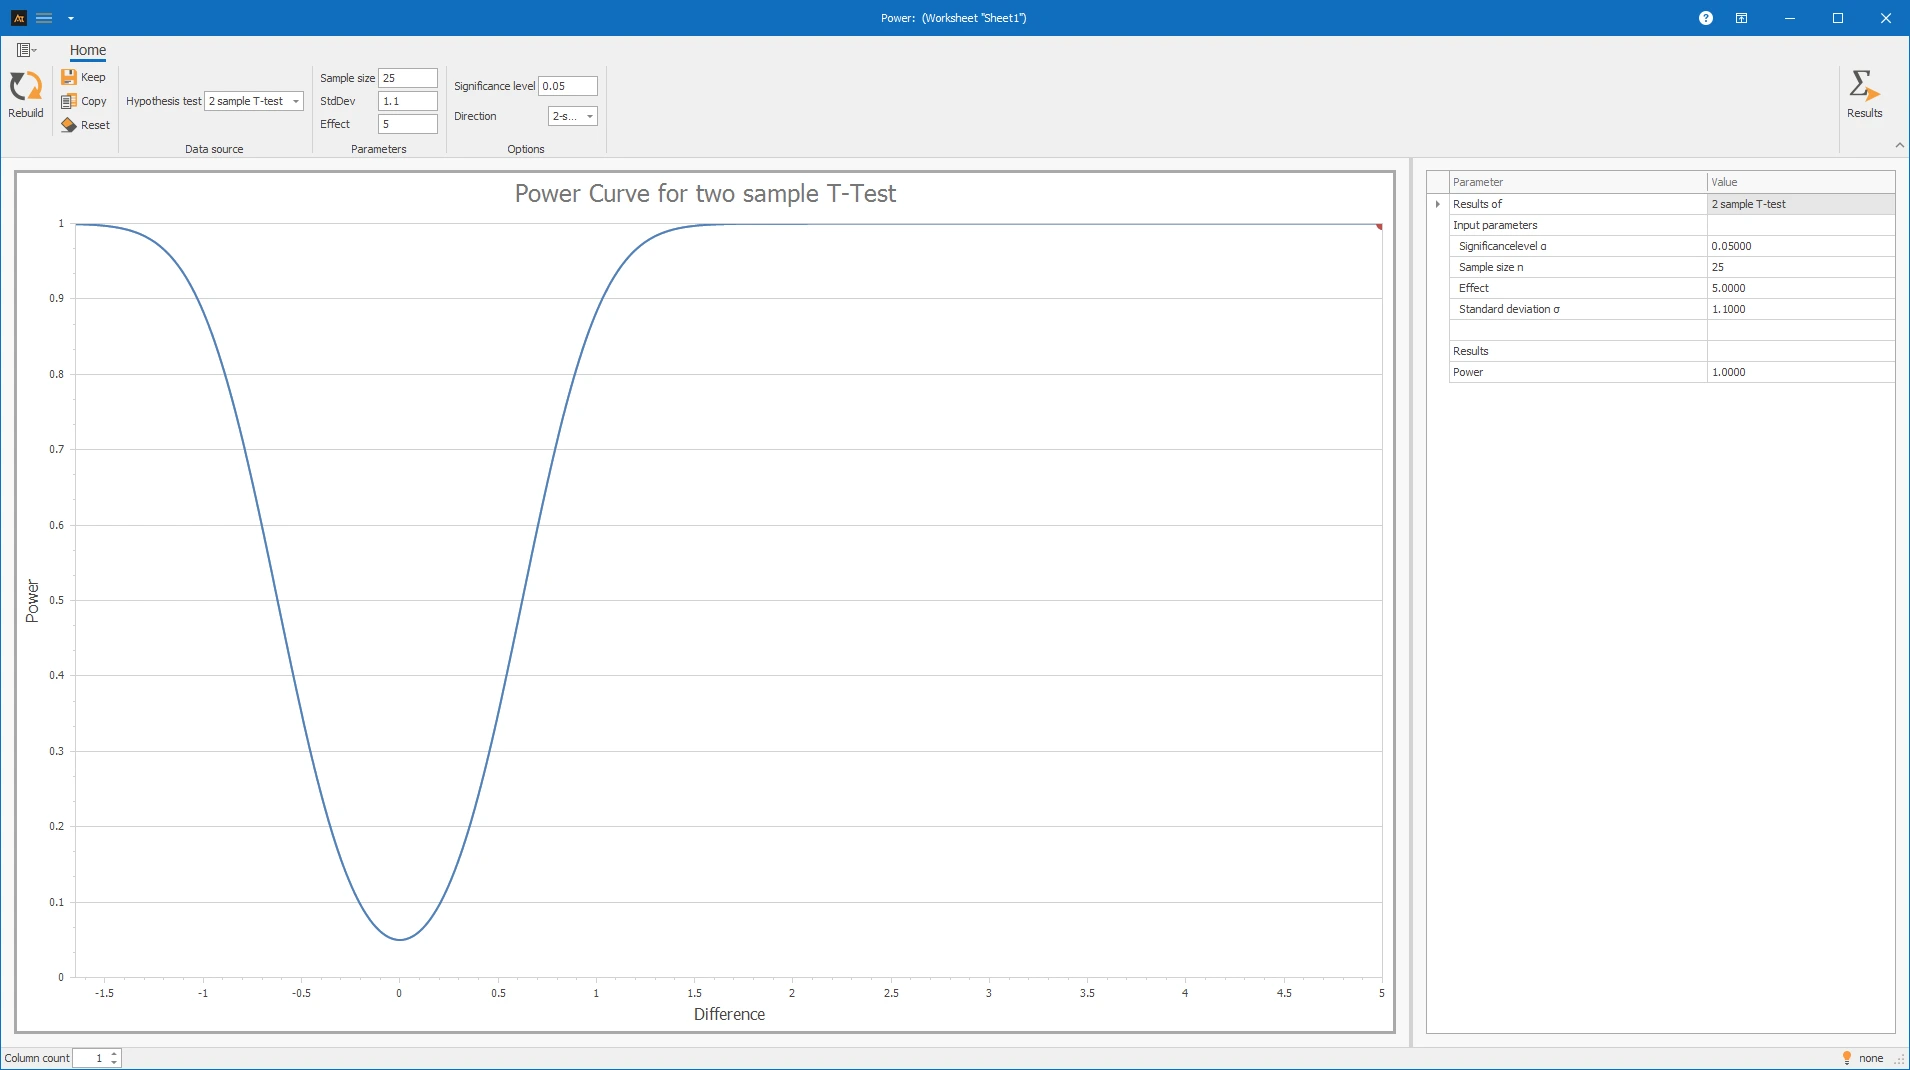
Interpretacja
Dla testu t, moc pokazuje prawdopodobieństwo, z jakim wykrywana jest różnica w średniej ilości napełnienia. Moc wynosi 1.000. Zatem test może wykryć założoną różnicę z bardzo wysokim prawdopodobieństwem przy wybranych danych wejściowych. Błąd β jest odpowiednio bliski 0%.
F-Test:
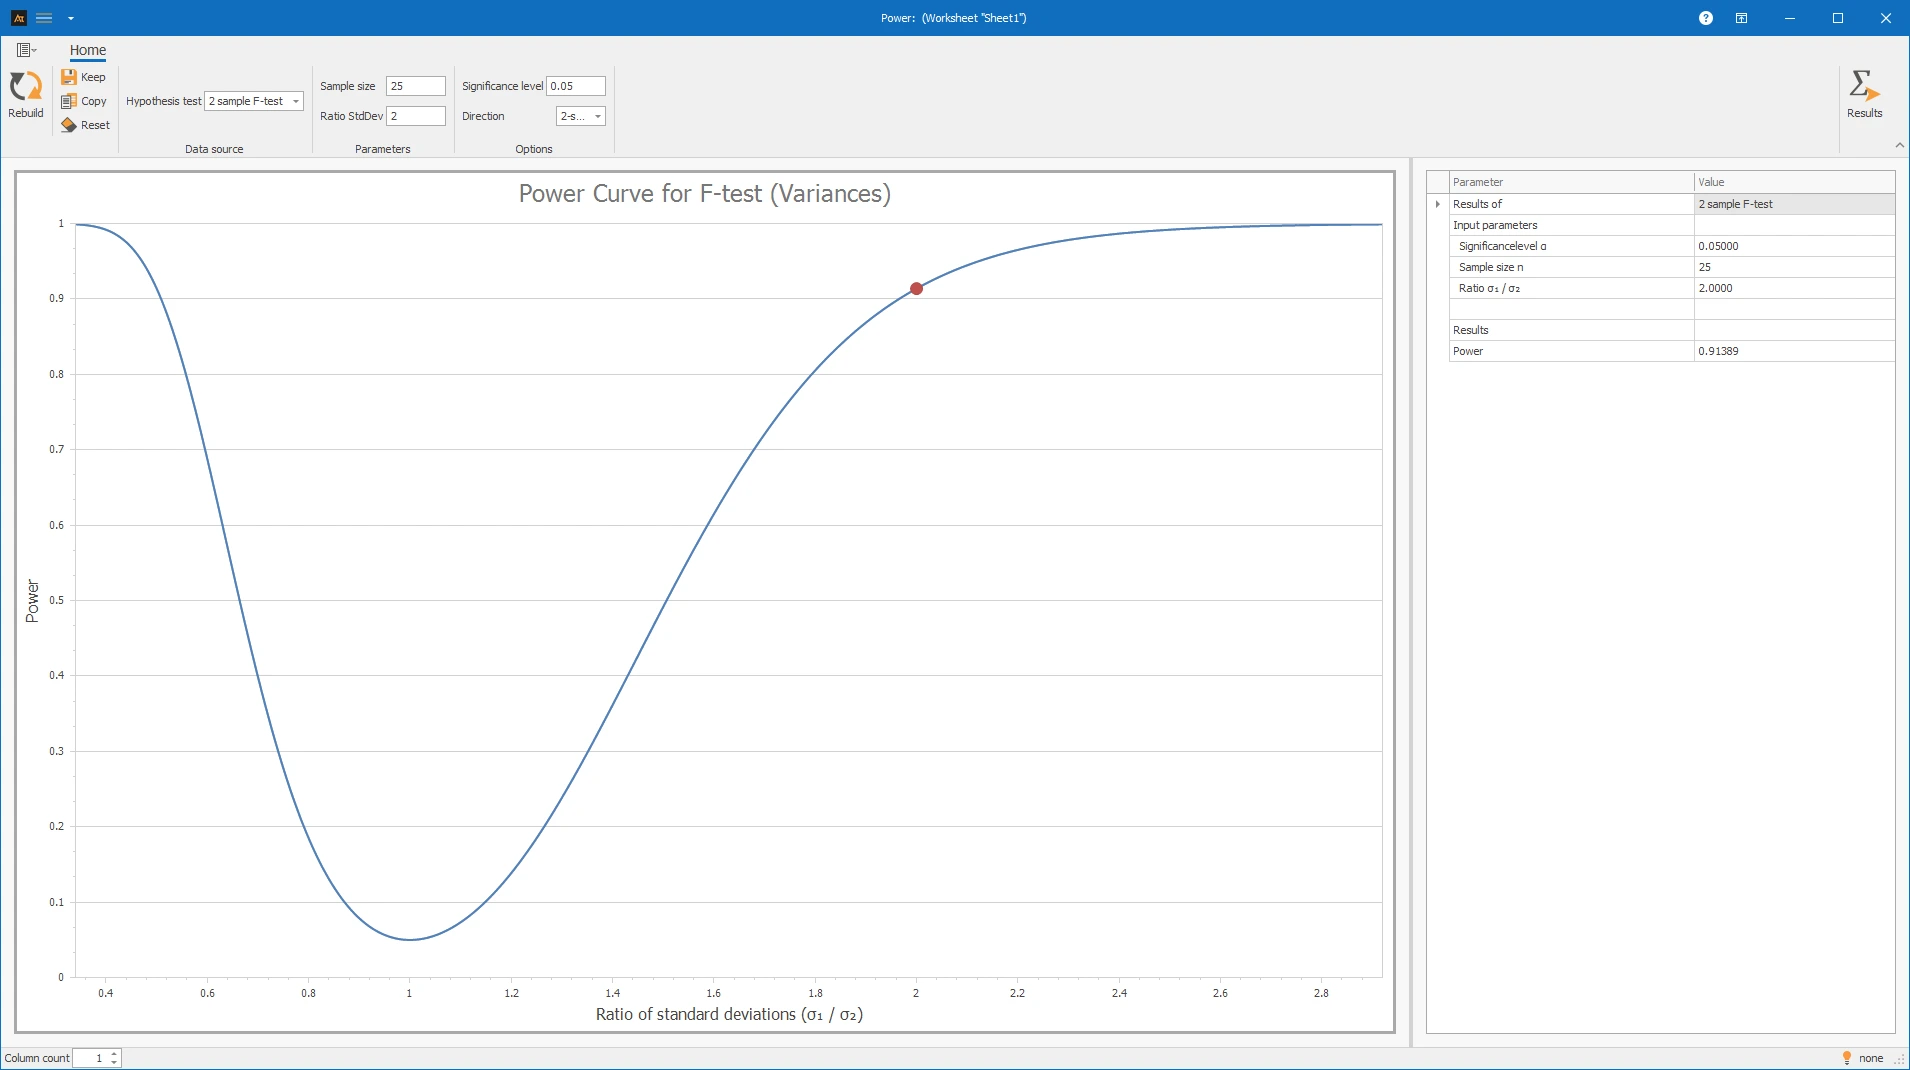
Różnice w wariancjach: Czy moc jest wystarczająca, aby wykryć podwojenie wariancji ilości napełnienia?
Interpretacja
Dla testu F, moc pokazuje prawdopodobieństwo, z jakim wykrywana jest różnica w wariancji. Moc wynosi 0.91389. Podwojenie odchylenia standardowego można zatem wykryć z mocą około 91.4%. Błąd β wynosi około 8.6%.
Czas reakcji działu pomocy IT vs. lokalizacja ANOVA
W dziale obsługi IT, zgłoszenia są przetwarzane w wielu lokalizacjach. Czas reakcji jest regularnie oceniany w celu zidentyfikowania różnic w jakości usług.
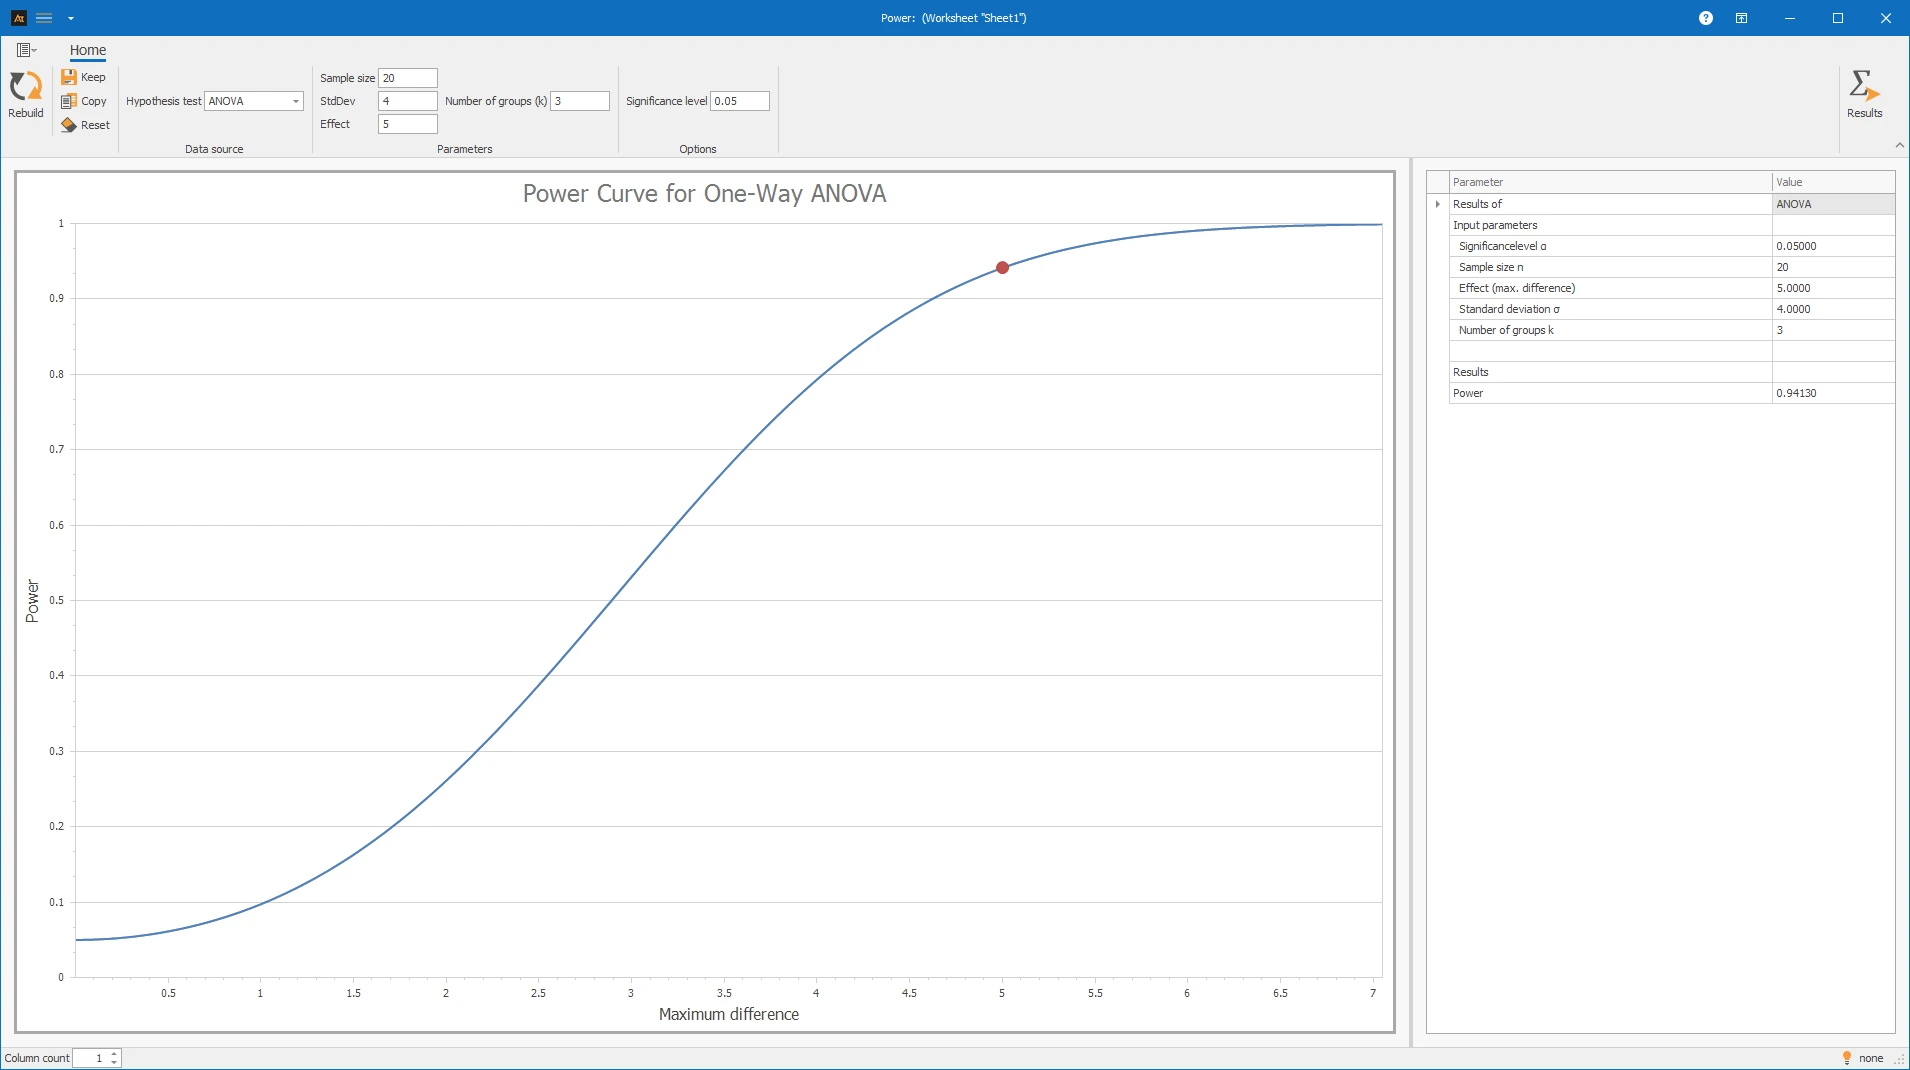
W przykładzie zgłoszeń IT dostępne są dane z trzech lokalizacji. Czułość jest używana do oceny, czy różnica 5 minut w czasie reakcji zostałaby wykryta za pomocą ANOVA.
Interpretacja wyników
Ustawienie testu jest odpowiednie do wykrycia różnicy 5 minut przy trzech poziomach i odchyleniu standardowym wynoszącym 4. Czułość jest wystarczająco wysoka; błąd β jest odpowiednio niski.
Test proporcji - Wskaźnik strat według podejścia sprzedażowego
W sprzedaży porównuje się dwa podejścia sprzedażowe. Należy ocenić, czy istniejące liczby ofert są wystarczające, aby wiarygodnie wykryć istotną zmianę wskaźnika strat. Test proporcji wykazał, że metody sprzedaży nie różnią się znacząco.
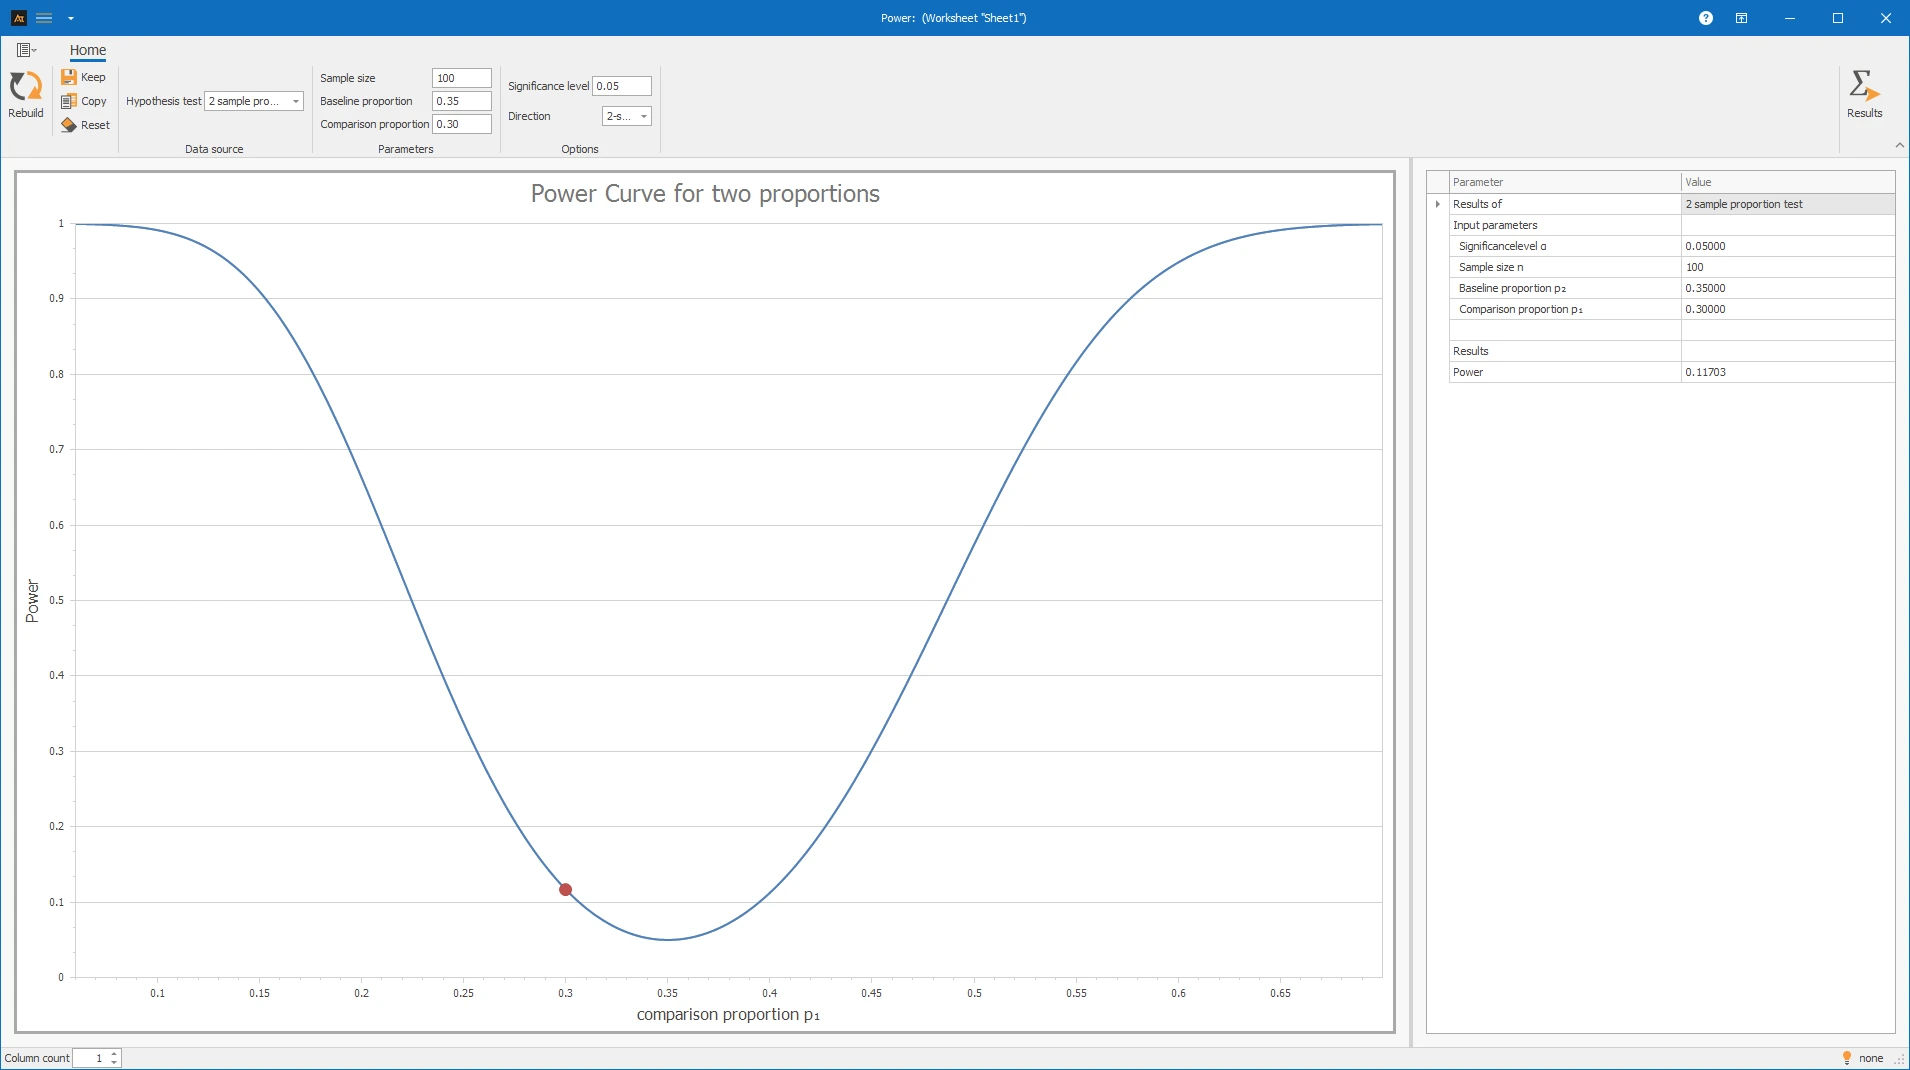
Teraz, korzystając z obliczeń mocy, należy ustalić, czy zmiana z 35% na 30% zostałaby wykryta.
Interpretacja
Moc wskazuje prawdopodobieństwo, z jakim test wykrywa istotną zmianę wskaźnika strat. Moc jest niska i wynosi 0,11703. Odpowiada to błędowi β wynoszącemu około 88,3%. Fakt, że nie wykryto istotnej różnicy za pomocą testu proporcji, może wynikać z tego, że oceniono zbyt mało ofert.
Czas dostawy po centrum logistycznym
W dziale logistyki zamówienia klientów są kompletowane i wysyłane. Aby zwiększyć wydajność, wprowadzono nowe wózki widłowe.
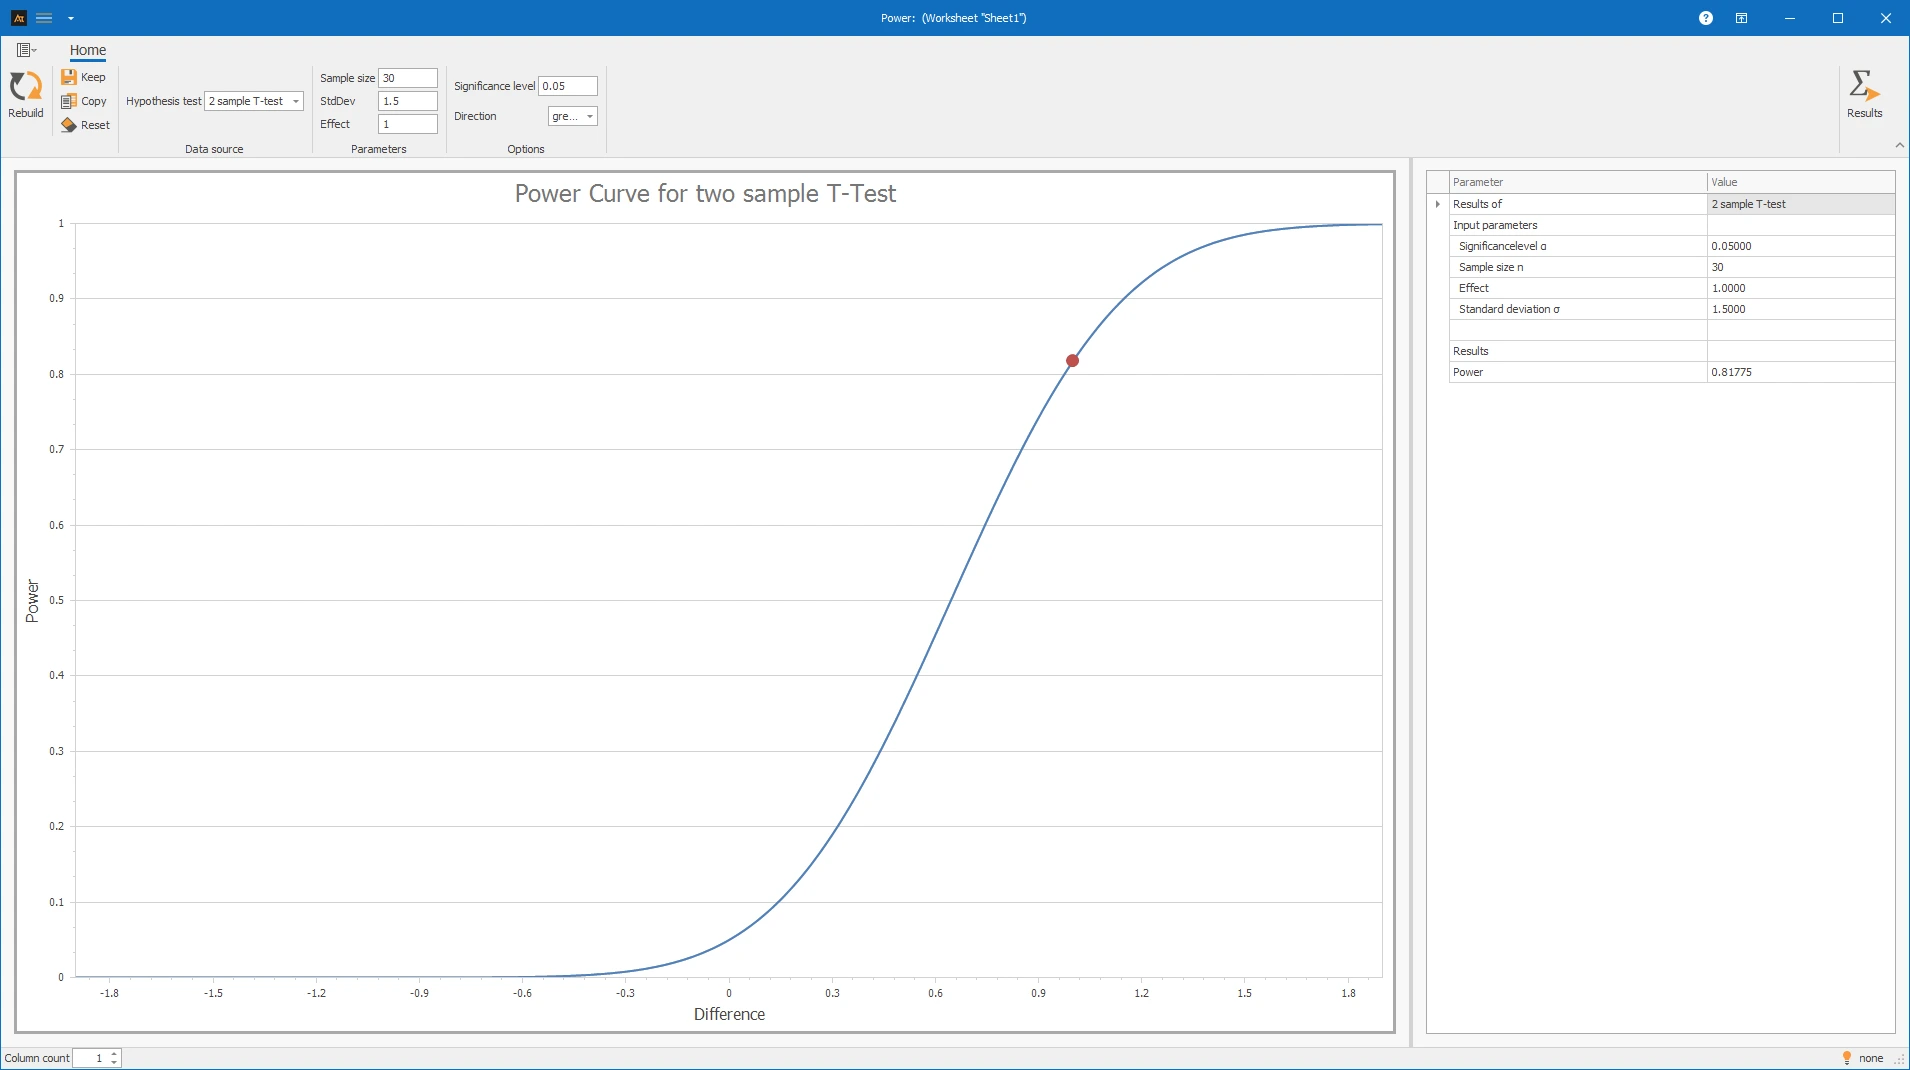
Należy zbadać, czy można wykryć poprawę czasu dostawy o 1 dzień za pomocą jednostronnego testu t. Zmienność czasu dostawy szacuje się na 2,5 dnia. Należy przeprowadzić 30 pomiarów.
Interpretacja
Moc wynosi 81,775%. Zatem różnicę 1 dnia można wykryć z mocą około 81,8%. Błąd β wynosi około 18,2%. Moc co najmniej 80% jest często używana jako wytyczna. Niemniej jednak należy wcześniej określić, jaka minimalna moc powinna zostać osiągnięta.
Porównanie dostawców
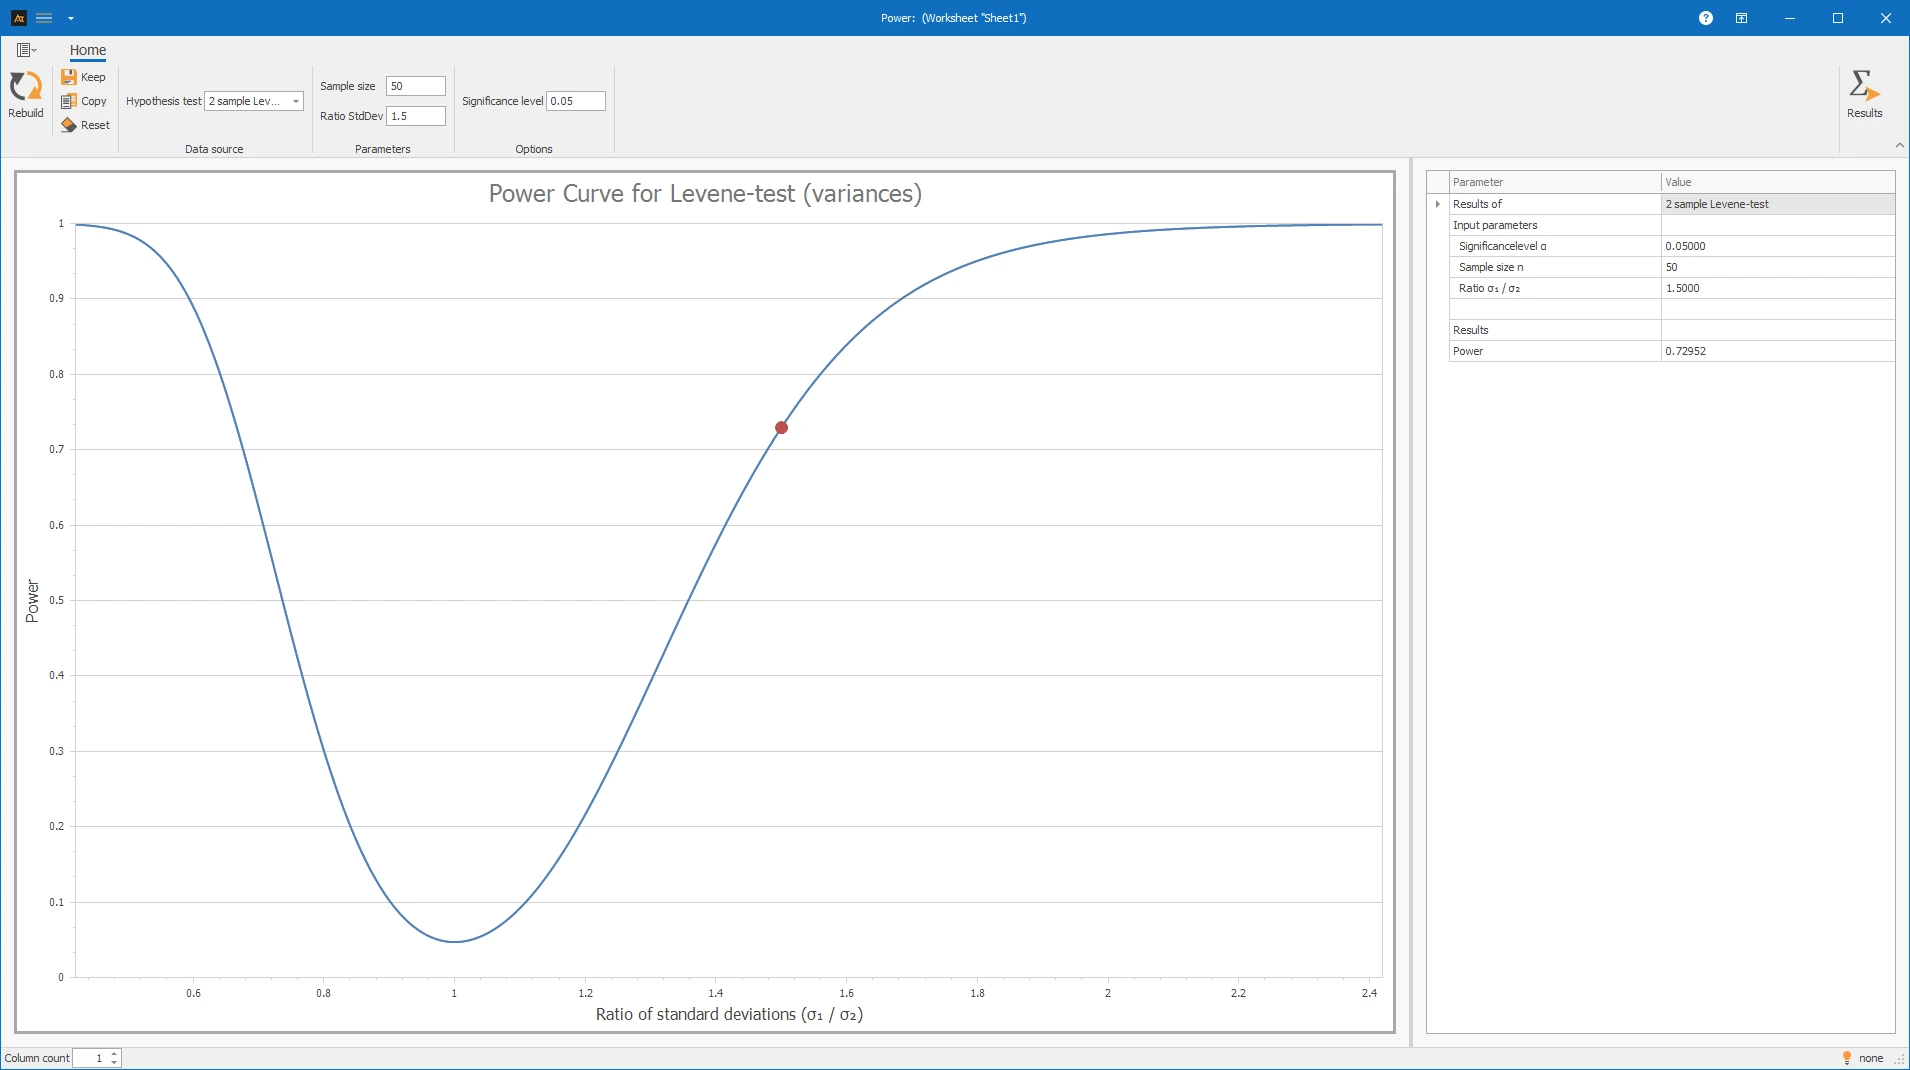
W zakupach komponenty są pozyskiwane od wielu dostawców. Należy ocenić, czy istniejące testy są wystarczające do wykrycia 1,5-krotnej różnicy w odchyleniu standardowym między dostawcami. Istnieje 50 zestawów danych na dostawcę.
Interpretacja
Czułość pomaga ocenić, czy istniejąca liczba dostaw jest wystarczająca do wiarygodnego wykrycia istotnych różnic między dostawcami. Przy niskiej czułości błąd β byłby wysoki; rzeczywiście istniejąca różnica mogłaby wtedy pozostać niewykryta.
Odchylenie prognozy
W planowaniu produkcji tworzone są prognozy popytu dla różnych okresów planowania. Aby ocenić jakość prognozy, oblicza się odchylenie prognozy.
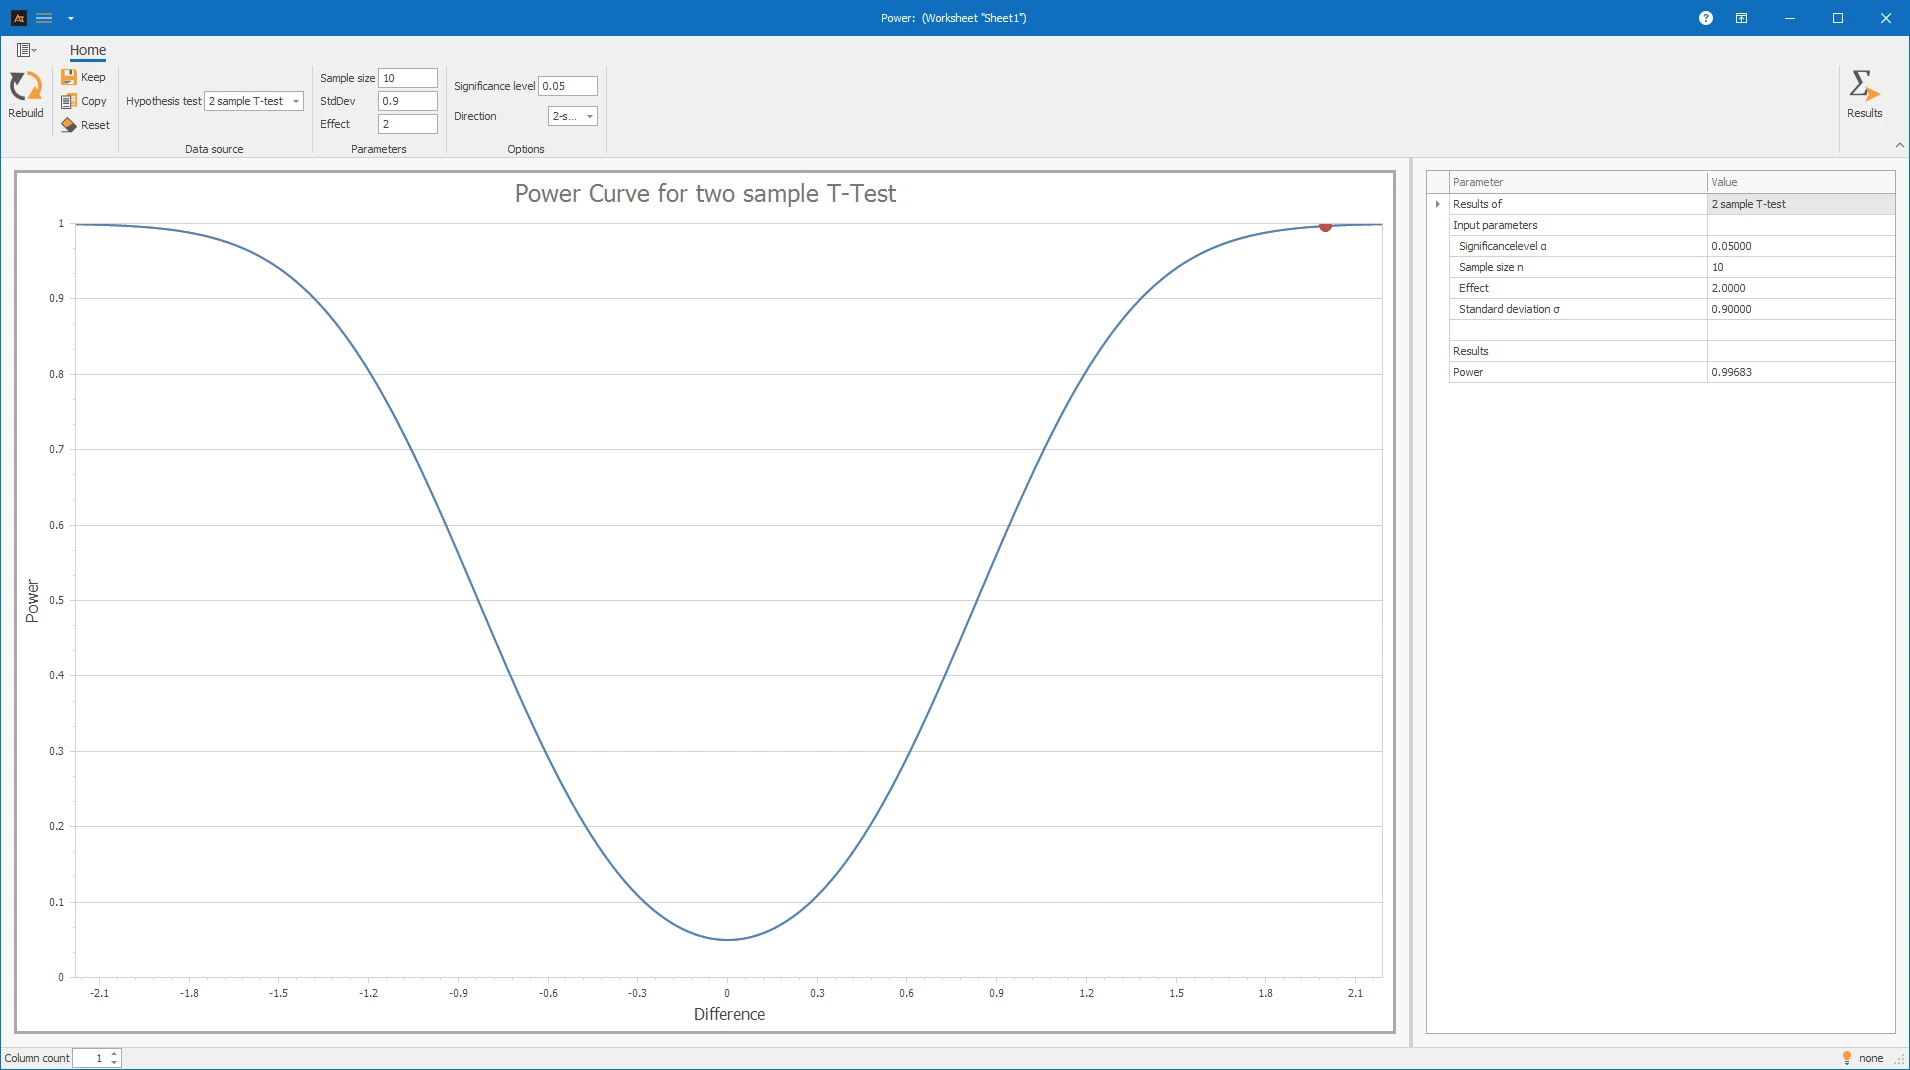
Należy ocenić, czy istniejąca próba jest wystarczająca do wykrycia różnic między krótkoterminowymi a długoterminowymi horyzontami planowania za pomocą testu t. Należy wykryć różnicę 2%. Odchylenie standardowe jest znane z poprzednich analiz i wynosi 0,9%. Dla każdego horyzontu należy stworzyć i porównać 10 prognoz.
Interpretacja
Za pomocą testu t można niezawodnie wykryć różnicę 2%, jeśli odchylenie standardowe wynosi 0,9%. Moc wynosi 99,68%. Błąd β wynosi zatem około 0,32%.
Moc dyskryminacyjna / Moc: Prawdopodobieństwo, z jakim test wykrywa faktycznie istniejący efekt.
Efekt: Praktycznie istotna różnica, np. różnica średnich, stosunek wariancji lub zmiana szans.
n = Wielkość próby: Liczba obserwacji, części, ofert lub prób w grupie.
α = Poziom istotności: Ustalona z góry prawdopodobieństwo błędu, z jakim błędnie odrzuca się hipotezę zerową.
β = Błąd II rodzaju: Prawdopodobieństwo niewykrycia faktycznie istniejącego efektu.
Moc = 1 - β: Przeciwwaga dla błędu II rodzaju.
x̄ = Średnia próby: Średnia wartość zebranych danych pomiarowych.
s = Odchylenie standardowe próby: Miara rozproszenia danych wokół średniej.
p̂ = Proporcja próby: Proporcja zdarzeń w próbie; obliczana jako zdarzenia / liczba prób.
Zdarzenie: Przypadek interesujący w analizie proporcji, np. wyciek, utrata, na czas lub zdany.
Czynnik: Kategoryczna zmienna wpływająca w ANOVA, np. centrum logistyczne, dostawca lub formuła.
Grupy / Poziomy: Przejawy czynnika, np. Centrum A, Centrum B i Centrum C.
Dwustronny: Sprawdza się, czy różnica może być wykryta w obu kierunkach.
Większy: Sprawdza się, czy efekt może być wykryty w kierunku większych wartości.
Mniejszy: Sprawdza się, czy efekt może być wykryty w kierunku mniejszych wartości.
Następujące formuły opisują logikę obliczeń mocy dyskryminacyjnej używanej w narzędziu. Wymagane funkcje rozkładu i kwantylowe nie są implementowane ręcznie, lecz są oceniane przy użyciu bibliotek statystycznych CenterSpace NMath oraz – jak określono – Numerics.NET.
Podstawowa zasada
Moc dyskryminacyjna, zwana także mocą, opisuje prawdopodobieństwo, że test statystyczny wykryje faktycznie istniejący efekt.
Wysoka moc dyskryminacyjna oznacza, że istniejący efekt jest wykrywany z dużym prawdopodobieństwem. Niska moc dyskryminacyjna oznacza, że błąd β jest odpowiednio większy.
T-Test dla dwóch próbek
W teście t dla dwóch próbek oblicza się prawdopodobieństwo wykrycia założonej różnicy między dwiema średnimi. Narzędzie zakłada równe rozmiary próbek.
Parametr niecentralności to:
Liczba stopni swobody to:
Do obliczeń używane są kwantyle centralnego rozkładu t oraz funkcja rozkładu niecentralnego rozkładu t. Funkcje te są oceniane przy użyciu CenterSpace NMath. Ft,v,λ(x) oznacza funkcję rozkładu niecentralnego rozkładu t.
Moc = 1 − Ft,v,λ(t1−α,v)
Moc = Ft,v,λ(tα,v)
Moc = Ft,v,λ(tα/2,v) + 1 − Ft,v,λ(t1−α/2,v)
Test F dla dwóch wariancji
W teście F określa się moc dyskryminacyjną dla założonej różnicy między wariancjami dwóch grup. Narzędzie używa stosunku odchyleń standardowych jako danych wejściowych:
Do obliczeń formuje się stosunek wariancji:
Dla próbek o równych rozmiarach obowiązują następujące stopnie swobody:
Wymagane kwantyle i funkcje rozkładu rozkładu F są oceniane przy użyciu CenterSpace NMath. Fk1,k2(x) oznacza funkcję rozkładu rozkładu F.
Moc = 1 − Fk1,k2 (F1−α,k1,k2 / ρ²)
Moc = Fk1,k2 (Fα,k1,k2 / ρ²)
Moc = Fk1,k2 (Fα/2,k1,k2 / ρ²) + 1 − Fk1,k2 (F1−α/2,k1,k2 / ρ²)
Test Levene'a dla dwóch wariancji
Do obliczeń mocy testu Levene'a narzędzie używa przybliżenia opartego na stosunku odchyleń standardowych.
Liczba stopni swobody używanego rozkładu t to:
Krytyczna wartość t jest określana przy użyciu funkcji kwantylowej rozkładu t:
Dodatkowo, do obliczeń używane są następujące wielkości pomocnicze:
c = √(π/2 − 1)
SE = c·√(ρ²/n₁ + 1/n₂)
Z tego wyznaczane są dwa z-wartości:
z₂ = −tkrit/θ − (ρ−1)/SE
Moc jest następnie określana przy użyciu standardowego rozkładu normalnego. Funkcje rozkładu t i normalnego są oceniane przy użyciu CenterSpace NMath.
Test proporcji dla dwóch próbek
W teście proporcji oblicza się prawdopodobieństwo wykrycia rzeczywistej różnicy między dwiema proporcjami.
Różnica w proporcjach to:
Wspólna proporcja do obliczeń pod hipotezą zerową to:
Błąd standardowy pod hipotezą zerową to:
Błąd standardowy pod hipotezą alternatywną to:
Kwantyle i funkcja rozkładu standardowego rozkładu normalnego są oceniane przy użyciu CenterSpace NMath.
Moc = Φ((d − z1−α·SE₀) / SE₁)
Moc = 1 − Φ((d + z1−α·SE₀) / SE₁)
Moc = 1 − Φ((d + z1−α/2·SE₀) / SE₁) + Φ((d − z1−α/2·SE₀) / SE₁)
Jednoczynnikowa analiza wariancji (ANOVA)
Jednoczynnikowa analiza wariancji (ANOVA) sprawdza, czy średnie kilku grup różnią się.
H₁: Przynajmniej jedna średnia grupy różni się.
W narzędziu jako efekt używana jest maksymalna różnica między średnimi grup:
Do obliczeń parametru niecentralności zakłada się, że dwie grupy tworzą maksymalną odległość Δ. Parametr niecentralności używany w narzędziu to:
Liczba stopni swobody to:
Krytyczny kwantyl F jest określany przy użyciu CenterSpace NMath:
Do oceny niecentralnego rozkładu F używane jest narzędzie Numerics.NET.
Test t dla jednej próby
W teście t dla jednej próby moc jest obliczana dla danego efektu, wielkości próby i zakładanego odchylenia standardowego.
Parametr niecentralności to:
Liczba stopni swobody to:
Wymagane kwantyle rozkładu t i funkcji rozkładu niecentralnego rozkładu t są oceniane przy użyciu CenterSpace NMath.
Moc = 1 − Ft,v,λ (t1−α,v)
Moc = Ft,v,λ (tα,v)
Moc = Ft,v,λ (tα/2,v) + 1 − Ft,v,λ (t1−α/2,v)
Test wariancji dla jednej próby
W teście wariancji dla jednej próby moc jest określana dla zakładanego stosunku między rzeczywistym odchyleniem standardowym a hipotetycznym odchyleniem standardowym.
Do obliczeń używany jest kwadrat stosunku:
Liczba stopni swobody rozkładu chi-kwadrat to:
Wymagane kwantyle i funkcje rozkładu rozkładu chi-kwadrat są oceniane przy użyciu CenterSpace NMath.
Moc = 1 − Fχ²,v (χ²1−α,v / r²)
Moc = Fχ²,v (χ²α,v / r²)
Moc = Fχ²,v (χ²α/2,v / r²) + 1 − Fχ²,v (χ²1−α/2,v / r²)
Test proporcji dla jednej próby
W teście proporcji moc jest obliczana dla rzeczywistej proporcji porównawczej p w porównaniu z hipotetyczną proporcją p₀.
Błąd standardowy pod hipotezą zerową to:
Błąd standardowy pod hipotezą alternatywną to:
Wymagane kwantyle i funkcje rozkładu standardowego rozkładu normalnego są oceniane przy użyciu CenterSpace NMath.
Moc = Φ((d − z1−α·SE₀) / SE₁)
Moc = Φ((−d − z1−α·SE₀) / SE₁)
Moc = Φ((d − z1−α/2·SE₀) / SE₁) + Φ((−d − z1−α/2·SE₀) / SE₁)