


Test wariancji jest używany do sprawdzenia, czy rozproszenia dwóch lub więcej grup różnią się statystycznie istotnie. Nie odpowiada na pytanie, czy średnie się różnią, ale czy wariancje lub odchylenia standardowe są porównywalne.
Narzędzie jest szczególnie pomocne przy ocenie, czy wiele procesów, formulacji, maszyn lub grup działa podobnie stabilnie, czy też jedna grupa różni się znacząco bardziej od pozostałych.
Decyzja jest podejmowana poprzez porównanie wartości p z ustalonym poziomem istotności (zwykle α = 0,05):
- p > α → Zachowaj H₀; nie ma istotnych wskazań na różne wariancje.
- p ≤ α → Odrzuć H₀; istnieje istotna różnica w wariancjach.

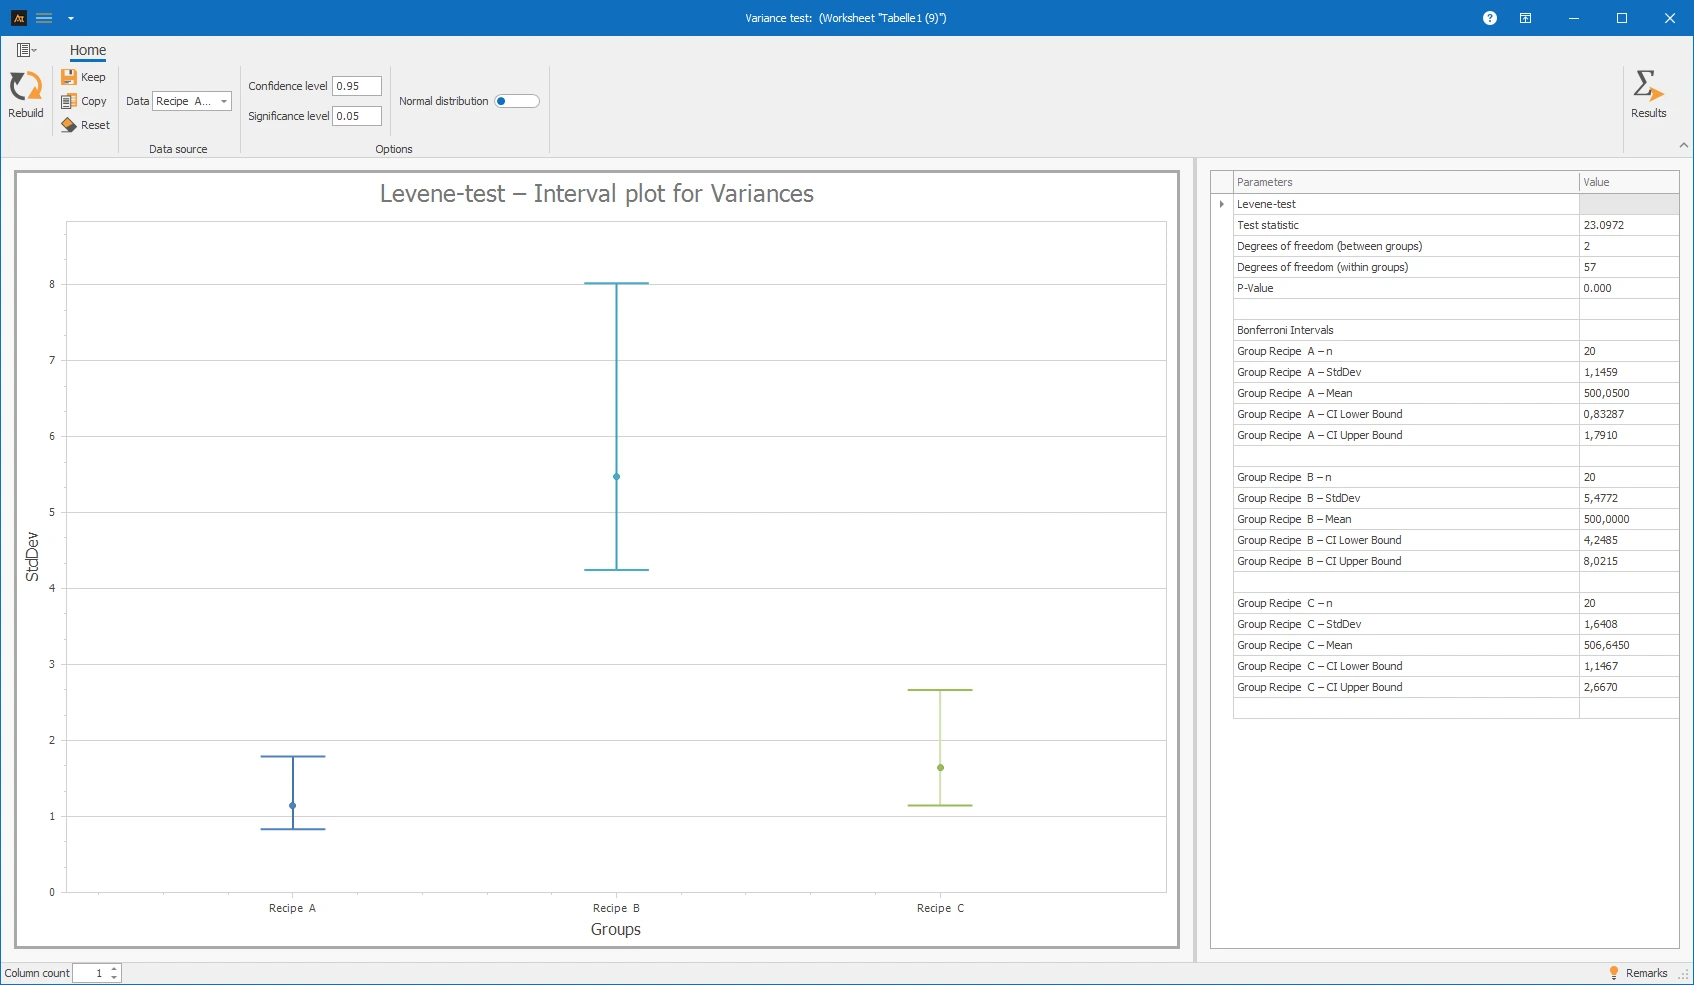
W rozwoju produktu testowane są różne receptury sosu pomidorowego. Dla tych samych danych dotyczących lepkości nie sprawdza się już, czy średnie się różnią, ale czy rozproszenie lepkości między recepturami ma różną wielkość.
W tym celu przeprowadza się pomiary lepkości na próbkach receptury A, receptury B i receptury C. Pomiary grup są zbierane niezależnie i traktowane jako próbki.
Korzystając z testu na wariancje, należy sprawdzić, czy receptury mają porównywalne rozproszenie procesu, czy też przynajmniej jedna receptura jest znacznie bardziej zmienna.
Interpretacja wyników:
Wartość p jest porównywana z poziomem istotności 0,05. Ponieważ wartość p w tym przykładzie wynosi 0,000, jest poniżej 0,05. Hipoteza zerowa o równych wariancjach jest zatem odrzucona.
Oznacza to: Receptury mogą różnić się nie tylko średnią lepkością, ale także rozproszeniem wartości lepkości. Przynajmniej jedna receptura wykazuje znacznie inne rozproszenie niż pozostałe receptury.
Dla rozwoju produktu jest to ważne, ponieważ receptura o wysokim rozproszeniu jest mniej stabilna. Nawet jeśli średnia wartość jest ogólnie w pożądanym zakresie, poszczególne partie mogą okazać się znacznie cieńsze lub grubsze. Z kolei receptura o niższym rozproszeniu jest bardziej zarządzalna i zapewnia bardziej spójne właściwości produktu.
Wykres słupkowy błędów pokazuje odchylenia standardowe receptur z odpowiadającymi im przedziałami ufności Bonferroniego. Receptury z większymi odchyleniami standardowymi wykazują większe wahania lepkości. Jednak ostateczna decyzja statystyczna jest podejmowana na podstawie wartości p.
Objaśnienia do grafiki:
- Punkty oznaczają odchylenia standardowe lepkości dla poszczególnych receptur.
- Słupki błędów reprezentują przedziały ufności odchyleń standardowych. Gdy aktywowana jest normalna dystrybucja, używane są przedziały Bonferroniego; bez aktywowanej normalnej dystrybucji używane są przedziały Bonetta.
- Nakładanie się przedziałów daje początkową wizualną wskazówkę. Ostateczna decyzja jest podejmowana na podstawie wartości p.
Poniżej przedstawiono rozważania i kroki niezbędne do przeprowadzenia testu wariancji dla dwóch lub więcej próbek.
Przygotowanie
- Wybierz zmienną pomiarową ciągłą (np. lepkość).
- Zdefiniuj dwie lub więcej grup, których wariancje mają być porównane (np. formuła A, B i C).
- Ustal poziom istotności (zwykle α = 0,05).
- Ustal poziom ufności (zwykle 95%).
- Sprawdź, czy pomiary były wykonywane niezależnie od siebie.
- Zdecyduj, czy założyć rozkład normalny. Bez aktywowanego rozkładu normalnego narzędzie używa testu Levene'a; z aktywowanym rozkładem normalnym używany jest test F dla dwóch grup i test Bartletta dla więcej niż dwóch grup.
 Użycie w AlphadiTab
- W fazie Analizy wybierz narzędzie Test dla Wariancji.
- Pod Danymi wybierz wszystkie grupy do porównania.
- Ustal poziom ufności i poziom istotności.
- Opcjonalnie aktywuj rozkład normalny, jeśli założenie rozkładu normalnego jest technicznie uzasadnione.
- Przeprowadź analizę, wybierając “Utwórz Nowy”.
Interpretacja
- Sprawdź, który test został zastosowany: test Levene'a, test F lub test Bartletta.
- Sprawdź, czy wartość p jest mniejsza lub równa poziomowi istotności.
- p ≤ α → statystycznie istotna różnica między co najmniej dwiema wariancjami lub odchyleniami standardowymi.
- p > α → brak statystycznie istotnej różnicy między wariancjami lub odchyleniami standardowymi.
Ważne: Test wariancji najpierw sprawdza rozproszenia. Nie stwierdza, czy średnie grup są różne.
Ilość napełnienia sosu pomidorowego – Maszyna A, Maszyna B i Maszyna C
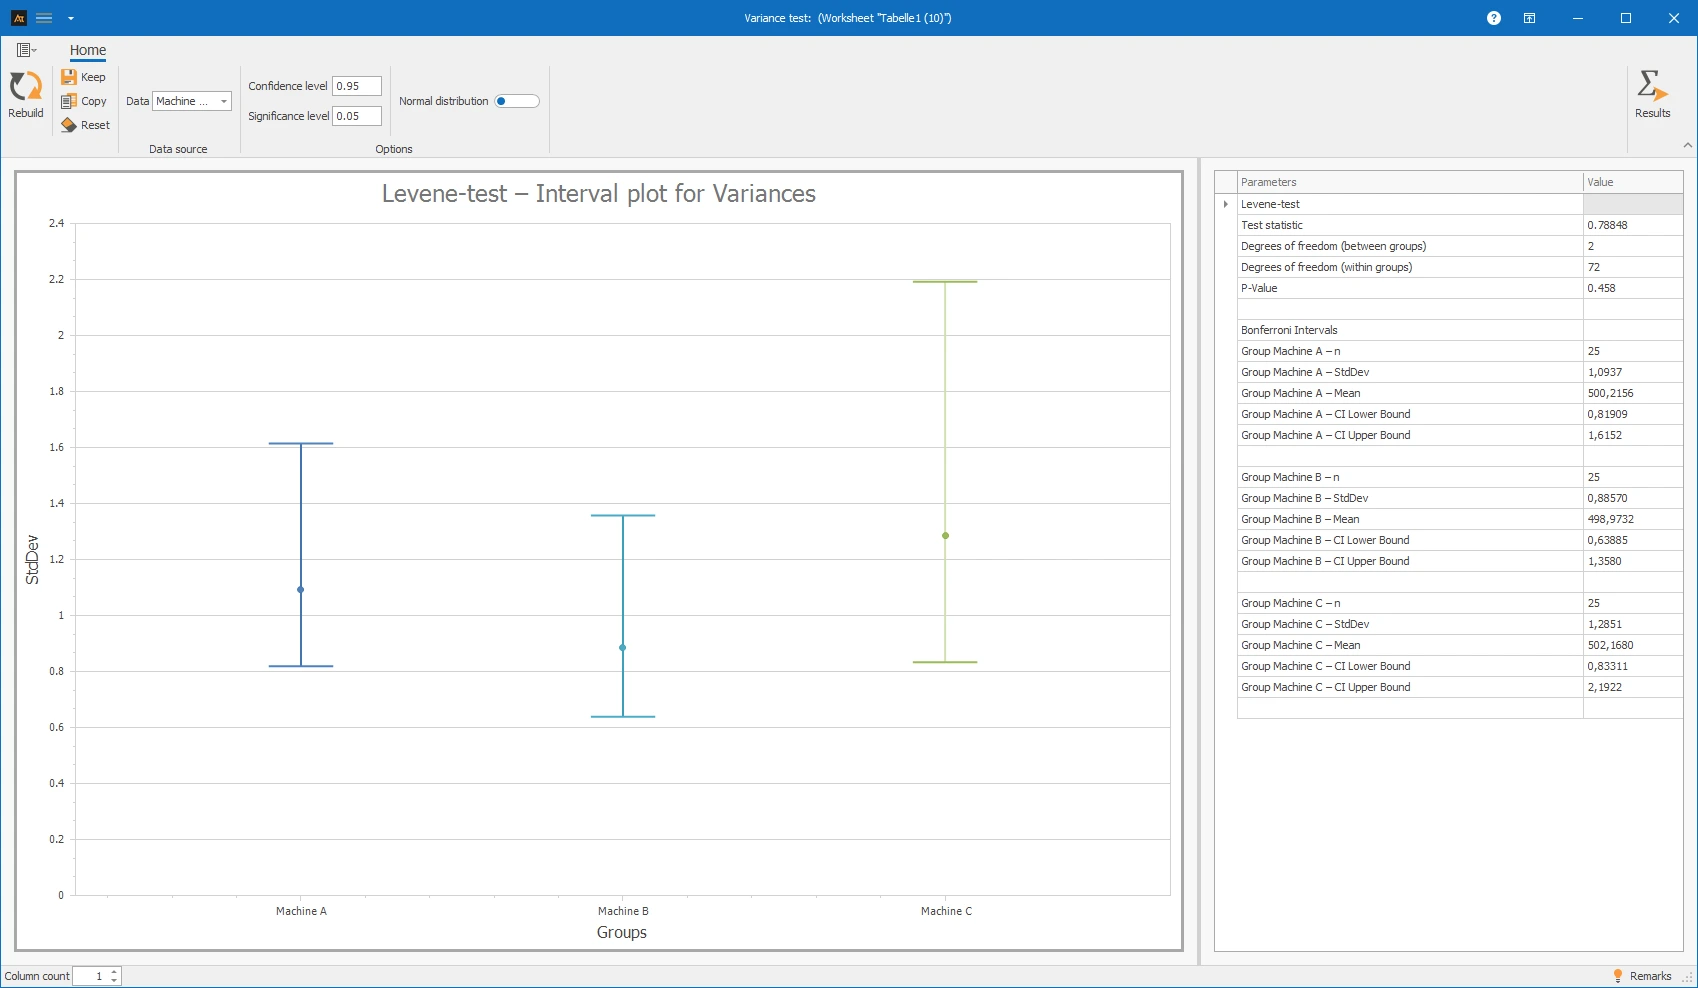
W produkcji używane są trzy maszyny napełniające. Należy zbadać, czy ilości napełnienia maszyn różnią się znacząco. Podczas gdy ANOVA porównuje średnie ilości napełnienia, test wariancji bada rozproszenie maszyn.
Interpretacja
Wartość p jest powyżej 0,05. Dlatego hipoteza zerowa o równych wariancjach nie jest odrzucana.
Ilości napełnienia maszyn nie różnią się statystycznie znacząco. Maszyny działają porównywalnie stabilnie pod względem ich fluktuacji. Różnice w średnich musiałyby być testowane osobno.
Czas reakcji helpdesku IT vs. lokalizacja
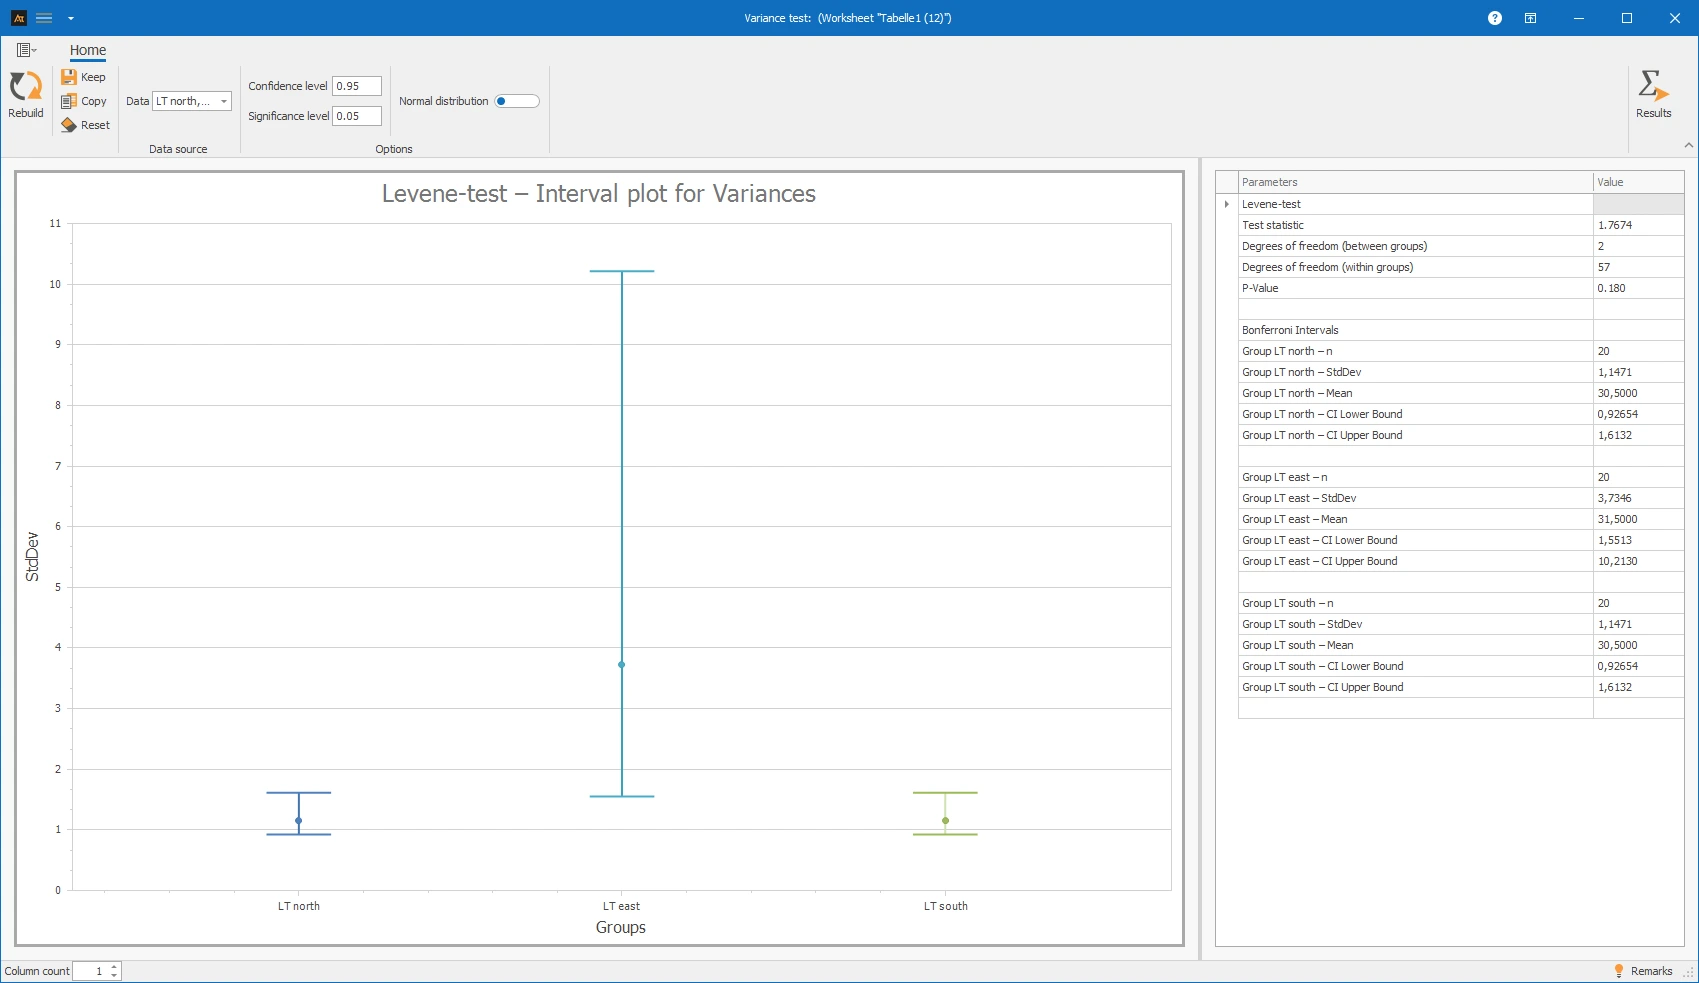
W serwisie IT, zgłoszenia są przetwarzane w wielu lokalizacjach. Należy sprawdzić, czy czasy reakcji różnią się znacząco między lokalizacjami. Wysoka zmienność może wskazywać na niespójne procesy serwisowe lub bardzo zmienne obciążenie pracą.
Interpretacja
Wartość p jest powyżej 0,05. Hipoteza zerowa o równości wariancji nie jest odrzucona.
Czasy reakcji lokalizacji nie różnią się statystycznie istotnie. Szeroki przedział ufności na diagramie raczej wskazuje na niepewne oszacowanie, na przykład z powodu małej wielkości próby lub pojedynczych wartości odstających. Z tego nie można wyprowadzić jednoznacznej różnicy w wariancjach.
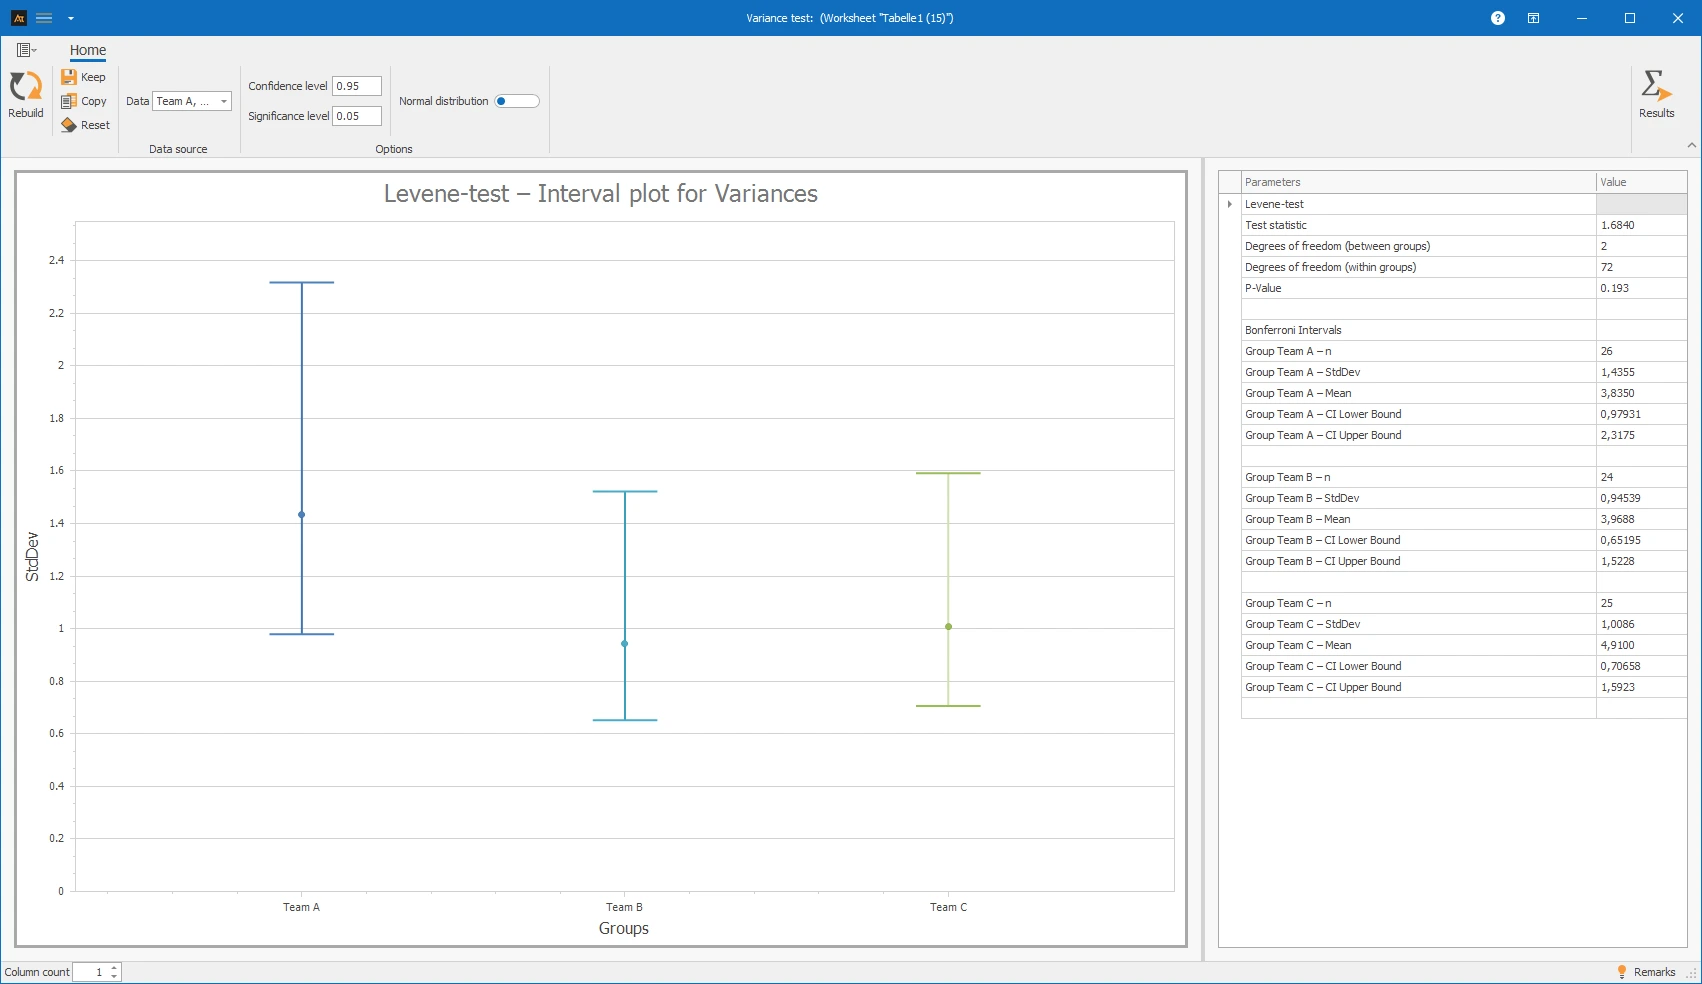
Czas realizacji według regionu
W sprzedaży oferty dla klientów są przetwarzane przez wiele zespołów. Oprócz średniego czasu realizacji, interesujące jest również sprawdzenie, czy czas przetwarzania jest spójny, czy bardzo zmienny.
Interpretacja
Wartość p jest powyżej 0,05. Hipoteza zerowa o równości wariancji nie jest odrzucona.
Czasy realizacji zespołów nie różnią się statystycznie istotnie. W związku z tym nie ma wskazań, że jeden zespół pracuje znacząco mniej spójnie lub mniej przewidywalnie niż inne.
Czas dostawy po centrum logistycznym
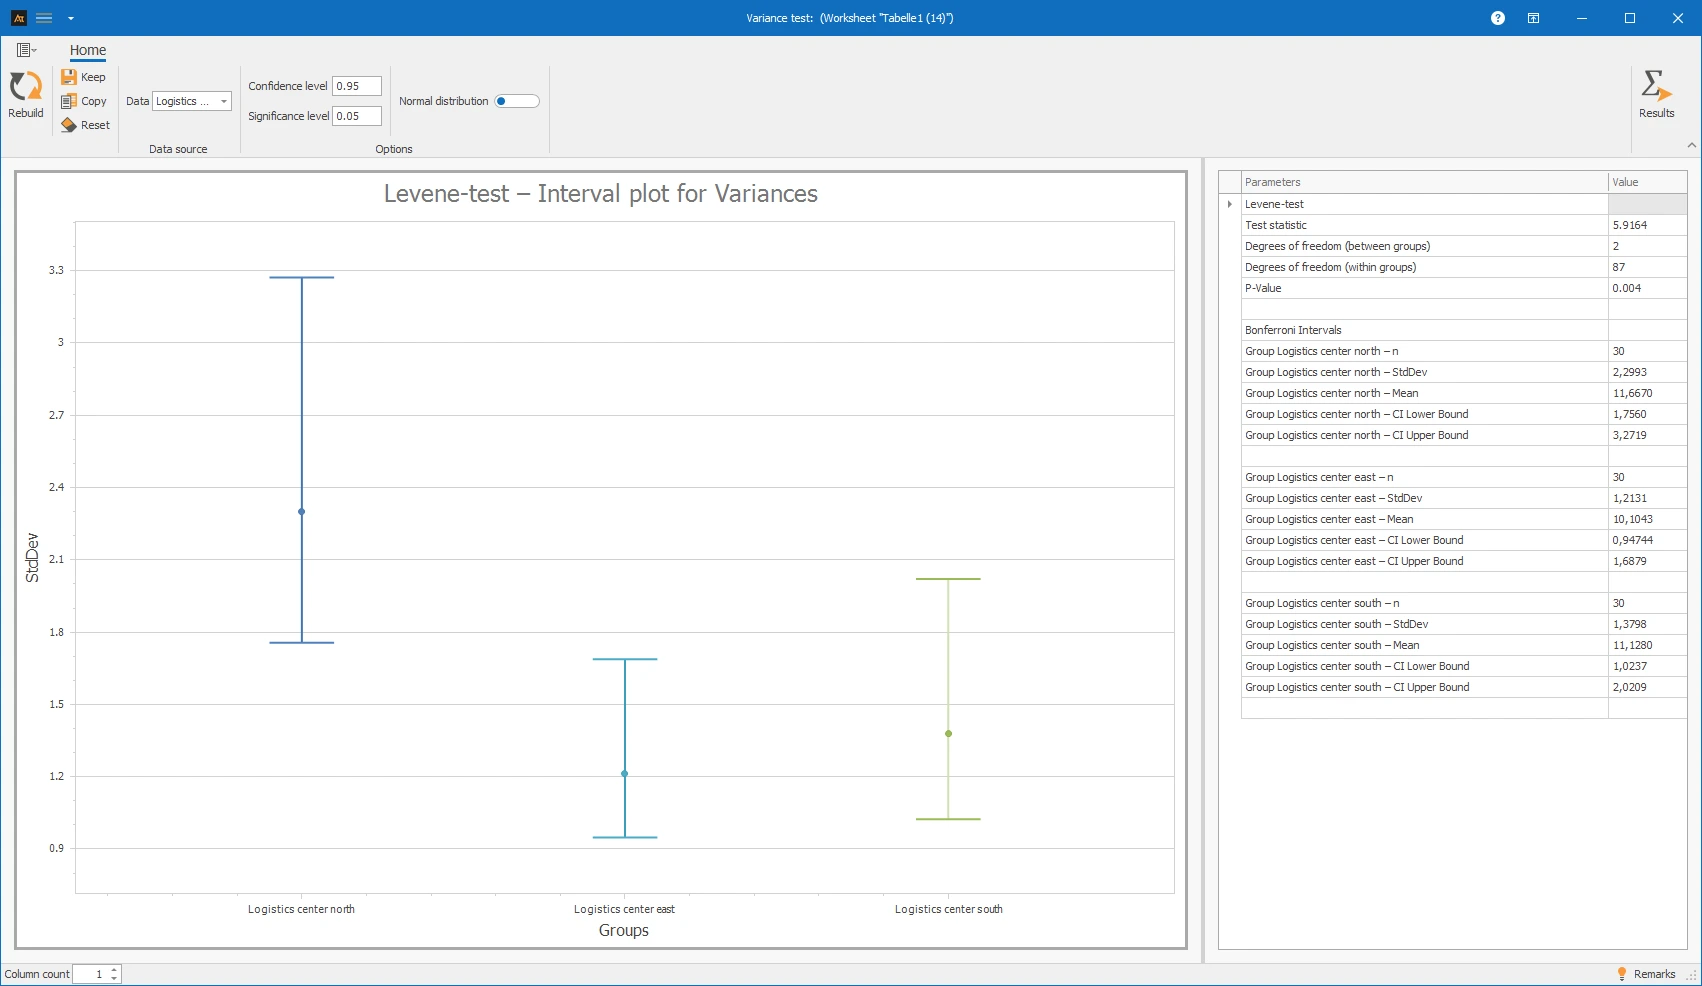
W dziale logistyki zamówienia klientów są kompletowane i wysyłane. Należy zbadać, czy czasy dostawy w centrach logistycznych różnią się znacząco.
- H₀: σ²_Centrum A = σ²_Centrum B = σ²_Centrum C
- H₁: Przynajmniej jedna wariancja się różni.
Interpretacja
Wartość p jest poniżej 0,05. Hipoteza zerowa o równości wariancji jest odrzucona.
Czasy dostawy różnią się statystycznie istotnie między centrami logistycznymi. Przynajmniej jedno centrum dostarcza mniej konsekwentnie. Może to wskazywać na różnice w obciążeniu pracą, procesach lub warunkach transportu.
Porównanie dostawców
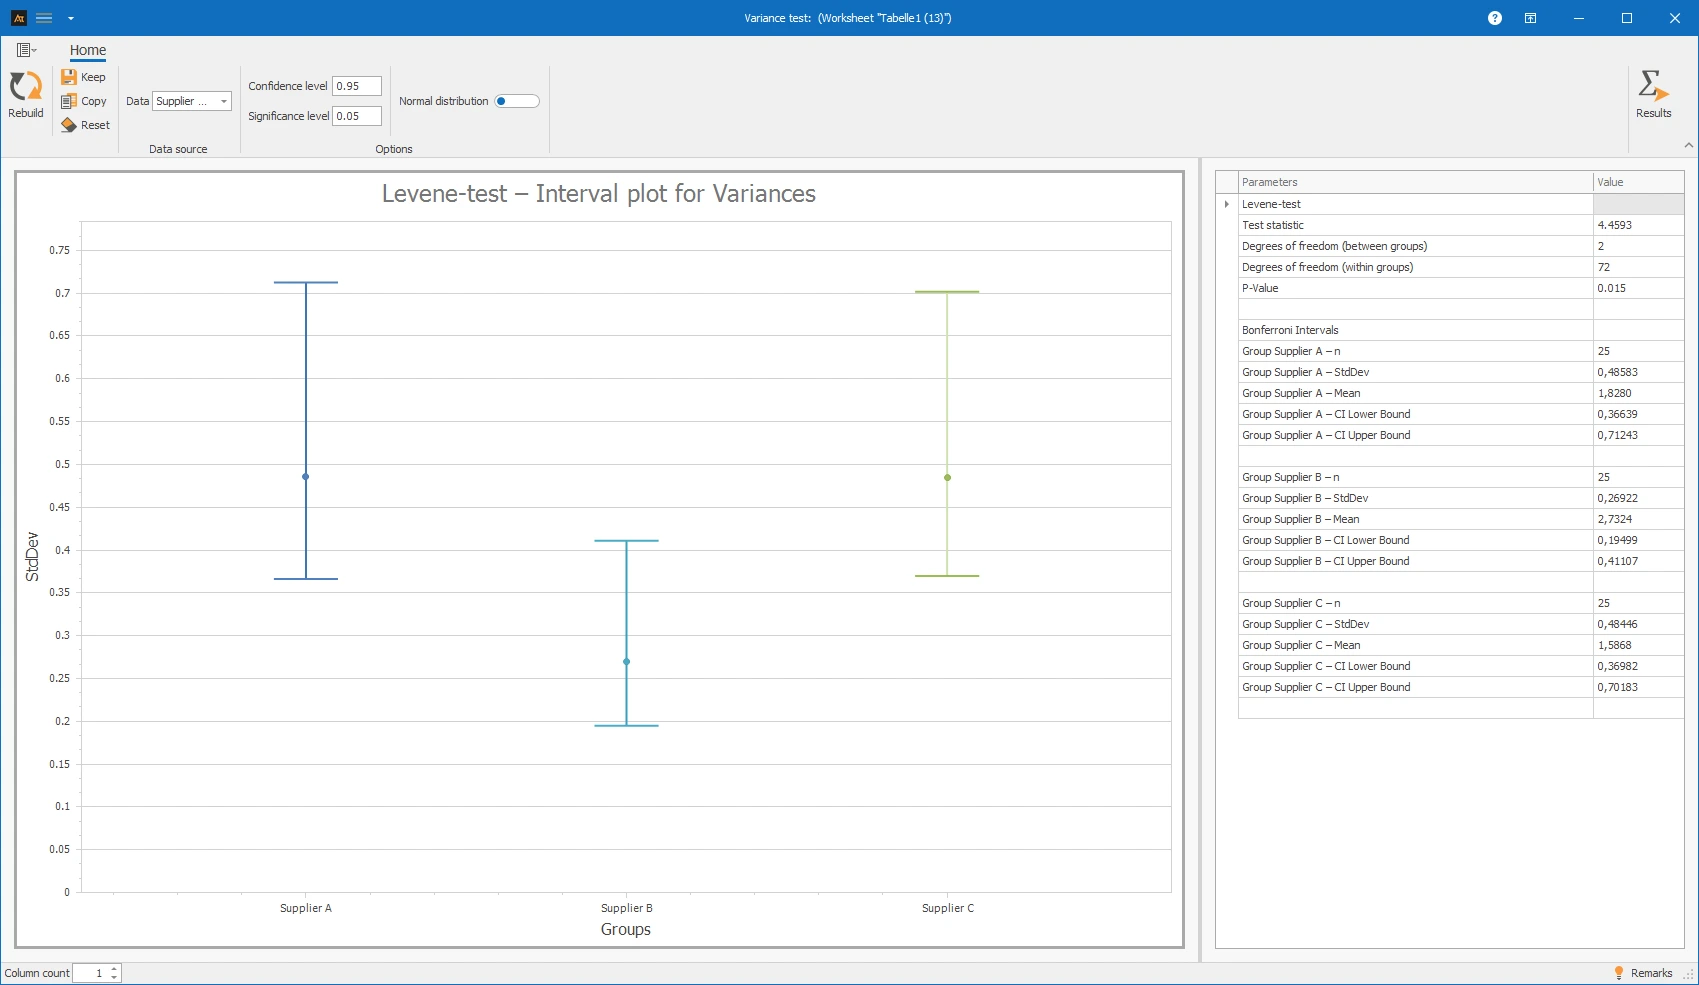
W zakupach komponenty są pozyskiwane od trzech dostawców. Należy zbadać, czy wskaźniki odrzutów na dostawę wahają się bardziej u poszczególnych dostawców niż u innych.
Uwaga:
Wartości procentowe, takie jak wskaźnik odrzutów, mogą być dyskretne, ponieważ wynikają z wartości liczbowych. Przy małych ilościach dostaw pojawia się tylko kilka możliwych wartości procentowych. W takich przypadkach należy profesjonalnie zbadać przydatność testu.
Interpretacja
Wartość p jest poniżej 0,05. Hipoteza zerowa o równych wariancjach jest odrzucona.
Wskaźniki odrzutów różnią się statystycznie istotnie między dostawcami. Dostawca może być akceptowalny średnio, ale dostarczać mniej niezawodnie, ponieważ jakość bardziej się waha.
Odchylenie prognozy
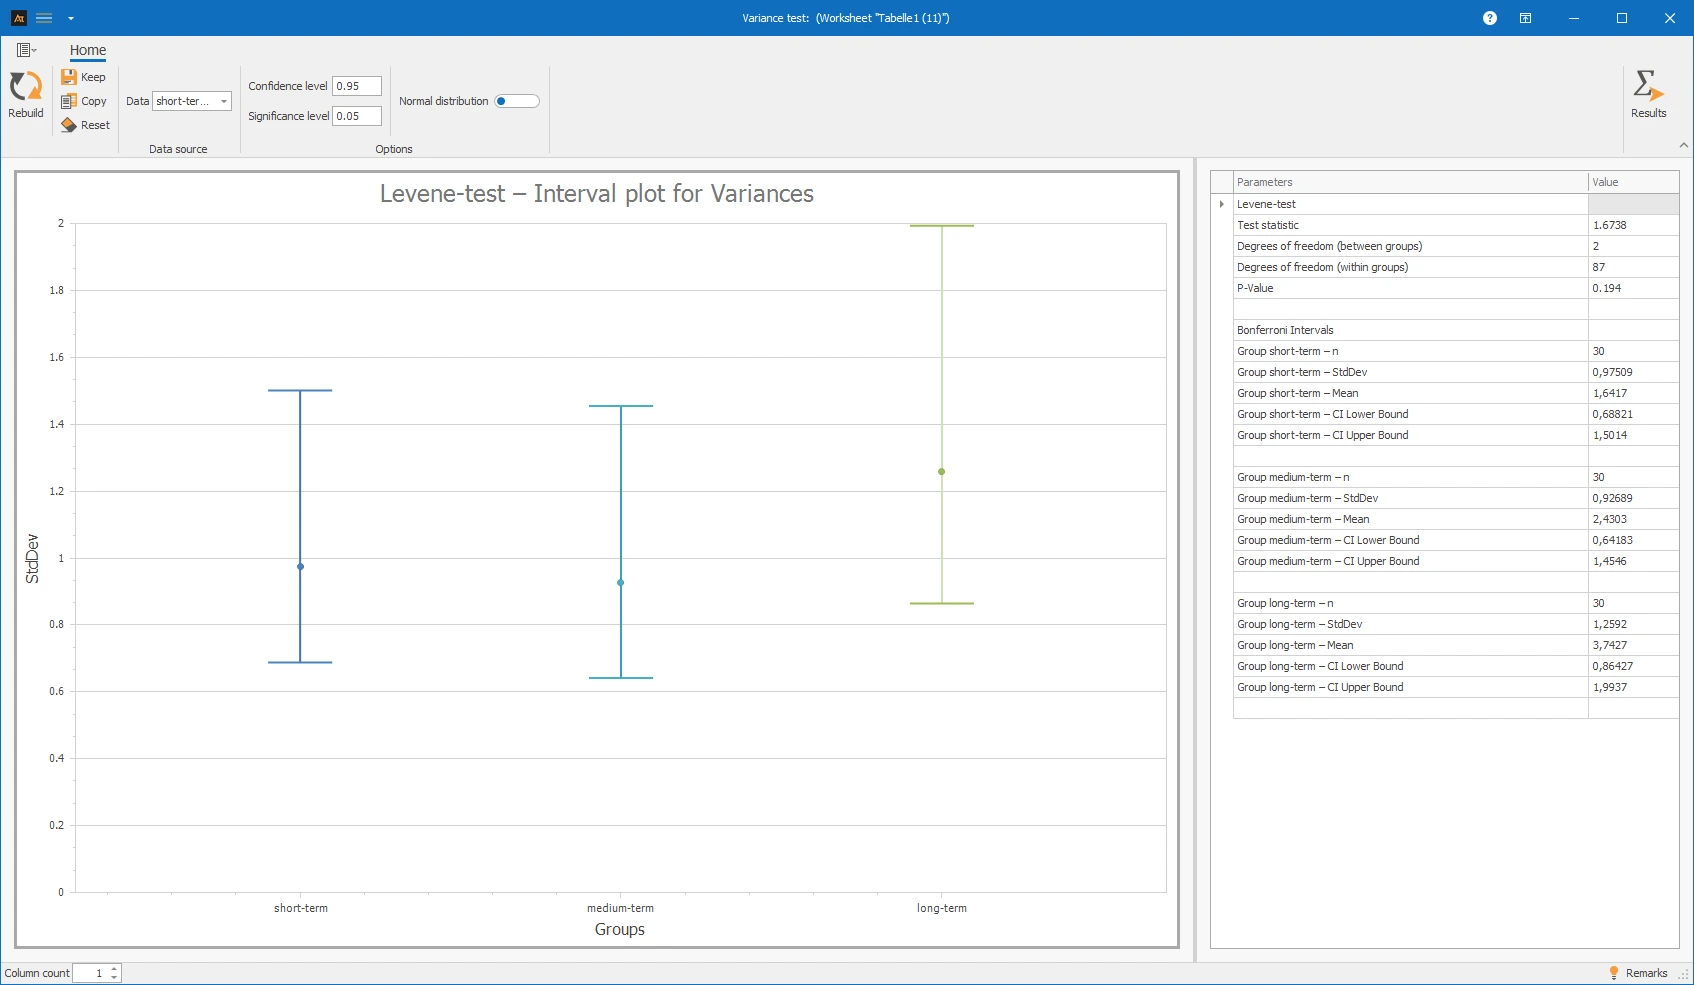
W planowaniu produkcji tworzone są prognozy popytu dla różnych okresów planowania. Należy zbadać, czy odchylenia prognoz różnią się znacząco między krótkoterminowymi, średnioterminowymi i długoterminowymi horyzontami planowania.
Interpretacja
Wartość p wynosząca 0,194 jest powyżej poziomu istotności 0,05. Dlatego hipoteza zerowa o równości wariancji nie jest odrzucana.
Tak więc nie ma statystycznie istotnych dowodów na to, że rozkład odchyleń prognoz różni się między horyzontami planowania. Różnice w zakresie zmienności mogą być widoczne w próbie, ale nie są statystycznie potwierdzone na podstawie tego testu.
Dane ciągłe: Dane zebrane za pomocą przyrządu pomiarowego, które mogą mieć zarówno jednostki, jak i miejsca dziesiętne.
Dane rozkładu normalnego: Dane, które można dobrze opisać za pomocą rozkładu normalnego. Można to sprawdzić na przykład za pomocą testu na rozkład normalny lub za pomocą odpowiednich diagramów.
s: Odchylenie standardowe próby. Opisuje rozproszenie pomiarów wokół średniej.
s²: Wariancja próby. Jest kwadratem odchylenia standardowego.
n: Wielkość próby. Liczba obserwacji w próbie.
α: Poziom istotności. Ustalona z góry prawdopodobieństwo błędu, z którym błędnie odrzuca się hipotezę zerową.
p-wartość: Wynik testu hipotezy używany do podjęcia decyzji między hipotezą zerową a hipotezą alternatywną.
F-wartość: Statystyka testowa w teście F lub teście Levene'a. W teście F opisuje stosunek dwóch wariancji próby.
Wartość chi-kwadrat: Statystyka testowa w teście Bartletta dla więcej niż dwóch grup przy założeniu rozkładu normalnego.
df: Stopnie swobody. Wartości pochodzące z liczby grup i obserwacji, które określają kształt rozkładu testowego.
Poziom ufności: Prawdopodobieństwo, z jakim obliczony przedział ufności obejmuje prawdziwą wartość parametru (np. 95%).
Przedział ufności: Zakres wartości, który zawiera prawdziwe odchylenie standardowe lub wariancję z wybranym poziomem ufności.
Hipoteza zerowa: Hipoteza początkowa, która zakłada równość wariancji dla wszystkich grup podczas testowania wariancji.
Hipoteza alternatywna: Hipoteza przeciwna do hipotezy zerowej. Stwierdza, że co najmniej jedna wariancja różni się od pozostałych.
Test Levene'a: Solidny test równości wariancji. W narzędziu używane są absolutne odchylenia od mediany grupy.
Test F: Test równości dwóch wariancji przy założeniu rozkładu normalnego.
Test Bartletta: Test równości wielu wariancji przy założeniu rozkładu normalnego.
Przedziały Bonferroniego: Skorygowane przedziały ufności, które uwzględniają ogólne prawdopodobieństwo błędu przy porównywaniu wielu grup jednocześnie.
Test równości wariancji sprawdza, czy wariancje kilku grup różnią się statystycznie istotnie.
Przy założeniu rozkładu normalnego narzędzie używa testu F dla dokładnie dwóch grup oraz testu Bartletta dla więcej niż dwóch grup. Bez założenia rozkładu normalnego używany jest test Levene'a oparty na medianie.
Wymagane funkcje rozkładu i kwantyle rozkładu F, Chi-kwadrat i normalnego są oceniane przy użyciu CenterSpace NMath.
Hipotezy
Test F dla dwóch grup o rozkładzie normalnym
Jeśli obecne są dokładnie dwie grupy i opcja Rozkład normalny jest włączona, narzędzie używa dwustronnego testu F.
Wartość p jest określana dwustronnie z rozkładu F. Funkcja rozkładu rozkładu F jest oceniana przy użyciu CenterSpace NMath.
F < 1: p = 2 · Fdf1,df2(F)
Test Bartletta dla wielu grup o rozkładzie normalnym
Jeśli obecne są więcej niż dwie grupy i opcja Rozkład normalny jest włączona, narzędzie używa testu Bartletta.
Najpierw obliczana jest wariancja łączona:
Statystyka testu Bartletta używana w narzędziu to:
Zgodnie z hipotezą zerową, statystyka testu jest oceniana przybliżeniem rozkładem Chi-kwadrat z k − 1 stopniami swobody. Funkcja rozkładu Chi-kwadrat jest obliczana przy użyciu CenterSpace NMath.
Test Levene'a bez założenia rozkładu normalnego
Jeśli opcja Rozkład normalny nie jest włączona, narzędzie używa wariantu testu Levene'a opartego na medianie. Najpierw obliczane są bezwzględne odchylenia od mediany odpowiedniej grupy dla każdej grupy.
Następnie stosuje się jednoczynnikową analizę wariancji (ANOVA) do bezwzględnych odchyleń. Statystyka testu jest wyprowadzana z ilorazu średnich kwadratów między i wewnątrz grup.
dfwewnątrz = N − k
Wartość p jest określana z prawego ogona rozkładu F. Funkcja rozkładu F jest oceniana przy użyciu CenterSpace NMath.
Przedziały ufności Bonferroniego
Oprócz testu wariancji narzędzie oblicza jednoczesny przedział ufności dla odchylenia standardowego dla każdej grupy. Globalny poziom błędu jest rozdzielany między grupy zgodnie z Bonferronim.
Przedziały z założeniem rozkładu normalnego
Przy założeniu rozkładu normalnego obliczane są przedziały ufności dla wariancji oparte na rozkładzie Chi-kwadrat. Wymagane kwantyle rozkładu Chi-kwadrat są określane przy użyciu CenterSpace NMath.
Granice dla odchylenia standardowego są uzyskiwane przez wyciągnięcie pierwiastka kwadratowego:
SDgórny = √(Vargórny)
Przedziały Bonetta bez założenia rozkładu normalnego
Bez założenia rozkładu normalnego narzędzie używa przedziałów Bonetta. Uwzględniane są wielkość próbki i kurtoza odpowiedniej grupy.
Dla większych próbek najpierw określana jest średnia przycięta. Dla próbek z co najwyżej pięcioma obserwacjami używana jest zwykła średnia.
Kurtoza nadmiarowa jest określana z odchyleń od średniej przyciętej:
Następnie obliczany jest błąd standardowy:
Wymagany kwantyl standardowego rozkładu normalnego jest określany przy użyciu CenterSpace NMath:
Używany w narzędziu współczynnik korekty Bonetta to:
Następnie granice wariancji są obliczane jako:
Granice dla odchylenia standardowego są ponownie uzyskiwane z pierwiastków kwadratowych granic wariancji.
SDgórny = √(Vargórny)