


Die Trennschärfe (Power) gibt an, mit welcher Wahrscheinlichkeit ein statistischer Test einen tatsächlich vorhandenen Effekt erkennt.
Sie wird eingesetzt, um zu beurteilen, ob die vorhandene Datenbasis ausreichend ist, um relevante Unterschiede, Streuungen oder Quotenänderungen zuverlässig zu erkennen.
Im Unterschied zum klassischen Hypothesentest steht bei der Trennschärfe nicht die Entscheidung zwischen der Alternativhypothese und der Nullhypothese im Vordergrund, sondern die Frage, wie leistungsfähig der Test unter den eingegebenen Annahmen ist:
- hohe Trennschärfe → ein relevanter Effekt wird mit hoher Wahrscheinlichkeit erkannt
- niedrige Trennschärfe → ein vorhandener Effekt kann trotz Untersuchung unentdeckt bleiben
Wichtig: Bei der Berechnung der Trennschärfe werden in AlphadiTab zusammengefasste Daten eingegeben. Es werden also keine Rohdaten benötigt, sondern Kennzahlen wie Stichprobengröße, Mittelwert, Standardabweichung oder Anzahl der Ereignisse.
In der Produktentwicklung wird eine neue Rezeptur für Tomatensoße getestet. Ziel ist es zu prüfen, ob sich die Viskosität der neuen Rezeptur im Mittel von der bisherigen Rezeptur unterscheidet.
Hierzu werden Viskositätsmessungen an Proben der alten Rezeptur und der neuen Rezeptur durchgeführt.
Mithilfe des t-Tests (2 Stichproben) wurde geprüft, ob der beobachtete Unterschied der Mittelwerte statistisch signifikant ist oder durch zufällige Streuung erklärt werden kann.

Der ermittelte p-Wert liegt deutlich über dem Signifikanzniveau von 0,05, sodass die Nullhypothese beibehalten wird. Auf Basis dieses Tests wird daher kein signifikanter Unterschied zwischen der durchschnittlichen Viskosität der alten und der neuen Rezeptur festgestellt. Mit der Berechnung der Trennschärfe wollen wir nun beurteilen, wie sicher ein tatsächlich vorhandener Unterschied erkannt werden kann.
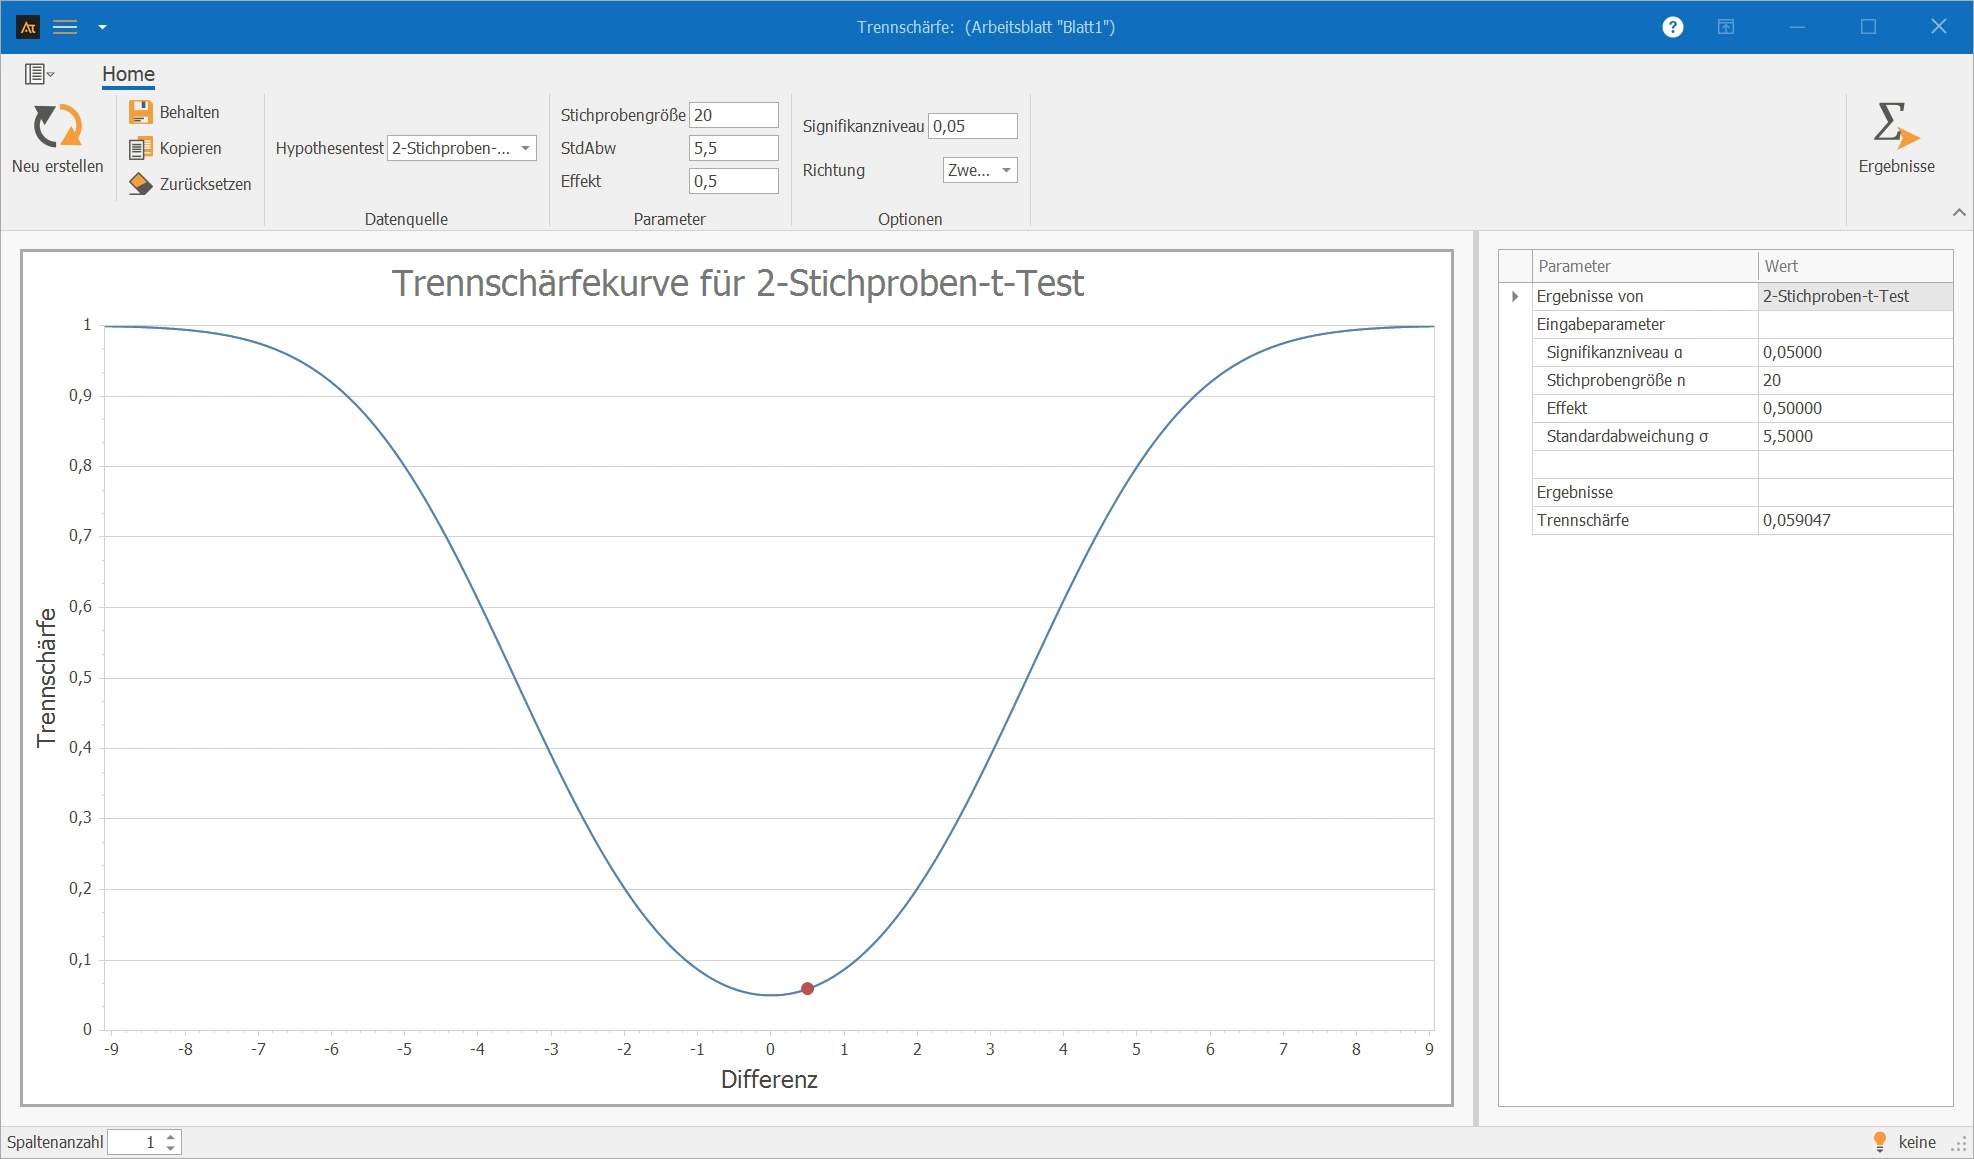
Hierzu müssen wir festlegen, welchen Unterschied in der mittleren Viskosität wir erkennen wollen. Entscheidend ist, welcher Unterschied praktisch relevant ist. In diesem Beispiel soll ein Unterschied der Mittelwerte von 0,5 MPa erkannt werden. Dieser Unterschied entspricht dem Effekt. Den Stichprobenumfang und die Standardabweichung können wir aus dem durchgeführten Test übernehmen. Die Standardabweichung wurde auf 5,5 gerundet; verwendet wird hier die ungünstigere der beiden Standardabweichungen.
Interpretation der Ergebnisse:
Die Trennschärfe beträgt 0,059. Das entspricht einem β-Fehler von 94,1 %. Unter diesen Gegebenheiten kann der Test einen tatsächlich vorhandenen Unterschied von 0,5 MPa nicht zuverlässig erkennen. Aus der Trennschärfekurve ist ersichtlich, dass ein Effekt von etwa 5 MPa mit diesem Test mit ungefähr 80 % Trennschärfe erkannt werden kann. Der β-Fehler läge dann bei etwa 20 %.
Erklärungen zur Grafik:
- Die Kurve zeigt die Trennschärfe für verschiedene Effekte (Differenzen)
- Der Punkt stellt die aktuelle Eingabe dar.
Im Folgenden finden Sie die Überlegungen und Schritte, die notwendig sind, um die Trennschärfe für verschiedene statistische Tests zu berechnen.
Vorarbeit
- Den passenden Test auswählen (z. B. t-Test, F-Test, Test von Anteilen oder ANOVA).
- Festlegen, welcher Unterschied, welches Varianzverhältnis oder welche Quotenänderung praktisch relevant ist.
- Signifikanzniveau festlegen (in der Regel α = 0,05).
- Festlegen, welche Trennschärfe bzw. Beta-Fehler man haben möchte.
- Richtung der Fragestellung festlegen (zweiseitig, größer oder kleiner), sofern das Verfahren diese Auswahl unterstützt.
 Nutzung in AlphadiTab
- In der Analyze-Phase das Tool Trennschärfe auswählen.
- Die passende Testart auswählen, z. B. t-Test, F-Test, Test von Anteilen oder ANOVA.
- Die zusammengefassten Kennzahlen in die Eingabefelder eintragen.
- Die Analyse durch „Neu erstellen“ durchführen.
Interpretation
- Prüfen, ob die berechnete Trennschärfe ausreichend hoch ist.
- Als Orientierung werden in der Praxis häufig 80 % oder 90 % Trennschärfe verwendet.
- Bei niedriger Trennschärfe sollte geprüft werden, ob eine größere Stichprobe oder ein stärker fokussiertes Studiendesign notwendig ist.
Wichtig: Die Trennschärfe ist keine nachträgliche Bestätigung eines p-Wertes. Sie beschreibt, wie wahrscheinlich ein Test einen angenommenen Effekt unter den gewählten Eingaben erkennt.
Testart
- t-Test: Trennschärfe für den Vergleich von Mittelwerten.
- F-Test: Trennschärfe für den Vergleich von Varianzen bzw. Streuungen.
- Test von Anteilen: Trennschärfe für den Vergleich von Quoten oder binären Ereignissen.
- ANOVA: Trennschärfe für den Vergleich von Mittelwerten aus zwei oder mehr Gruppen.
- Test auf Varianzen: : Trennschärfe für den Vergleich von Varianzen bzw. Streuungen für zwei oder mehr Stichproben, optional auch verteilungsfrei.
Bei Hypothesentests mit 2 Stichproben kann die Richtung für die Alternativhypothese ausgewählt werden.
Wählen Sie zweiseitig, wenn ein Unterschied erkannt werden soll, ohne eine bestimmte Richtung vorzugeben.
- Diese Einstellung ist sinnvoll, wenn sowohl höhere als auch niedrigere Werte relevant wären.
Beispiel:
Unterscheidet sich die mittlere Lieferzeit zwischen zwei Prozessen?
Wählen Sie größer, wenn ein Effekt nur in Richtung höherer Werte relevant ist.
- Diese Einstellung ist sinnvoll, wenn z. B. geprüft werden soll, ob eine Erfolgsquote steigt.
Beispiel:
Ist die Verkaufsquote mit einem neuen Vertriebsansatz höher als bisher?
Wählen Sie kleiner, wenn ein Effekt nur in Richtung niedrigerer Werte relevant ist.
- Diese Einstellung ist sinnvoll, wenn z. B. geprüft werden soll, ob eine Bearbeitungszeit oder Ausschussquote sinkt.
Beispiel:
Ist die durchschnittliche Bearbeitungszeit nach einer Optimierung geringer als vorher?
Abfüllmenge Tomatensoße – Maschine A vs. Maschine B
In der Produktion werden mehrere Abfüllmaschinen eingesetzt. Es soll beurteilt werden, ob die vorhandenen Daten ausreichen, um einen Unterschied zwischen Maschine A und Maschine B zuverlässig zu erkennen.
t-Test:
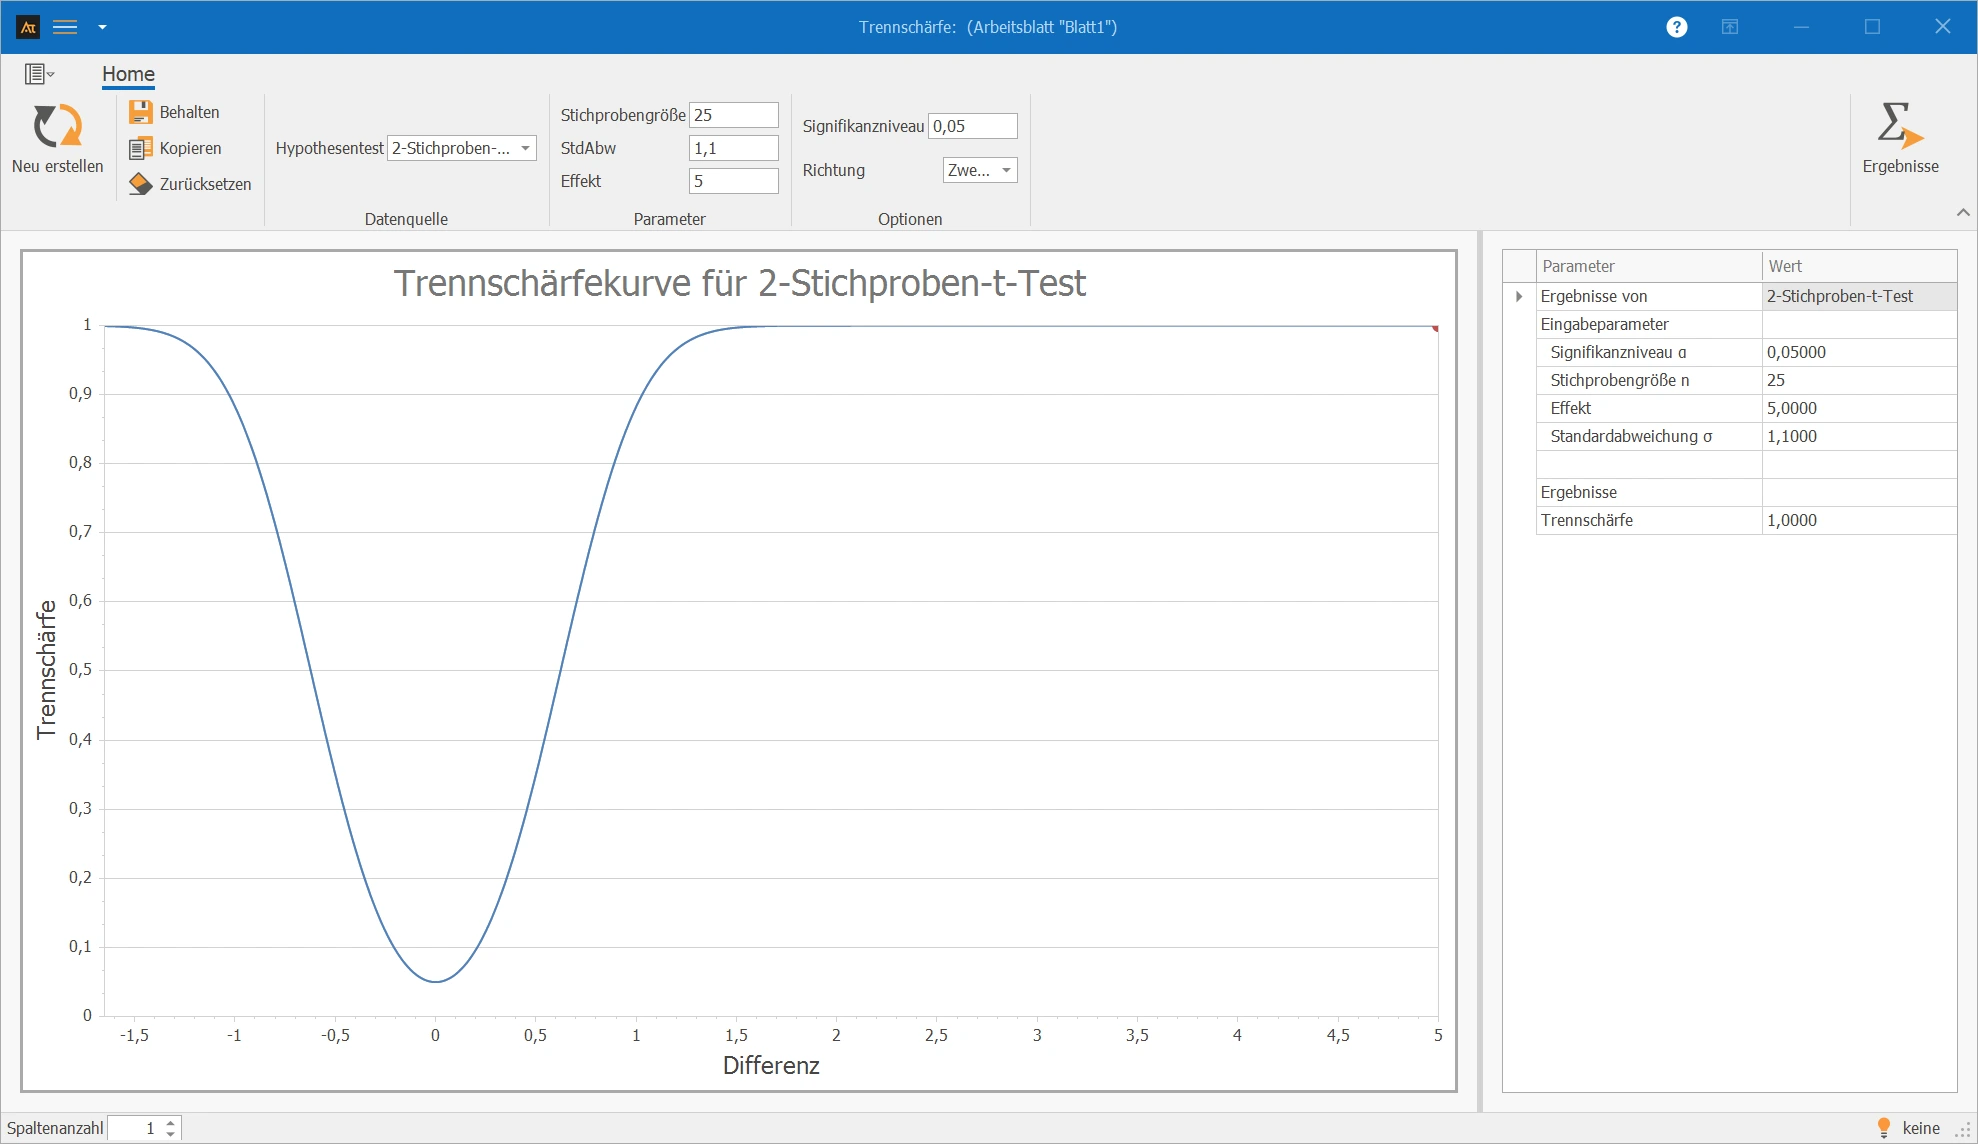
Unterschiede in den Mittelwerten: Reicht die Trennschärfe aus, um einen Unterschied von 5 ml in der mittleren Abfüllmenge zu erkennen?
Interpretation
Für den t-Test zeigt die Trennschärfe, mit welcher Wahrscheinlichkeit ein Unterschied der mittleren Abfüllmenge erkannt wird. Die Trennschärfe liegt bei 1,000. Damit kann der Test den angenommenen Unterschied unter den gewählten Eingaben mit sehr hoher Wahrscheinlichkeit erkennen. Der β-Fehler liegt entsprechend nahe bei 0 %.
F-Test:
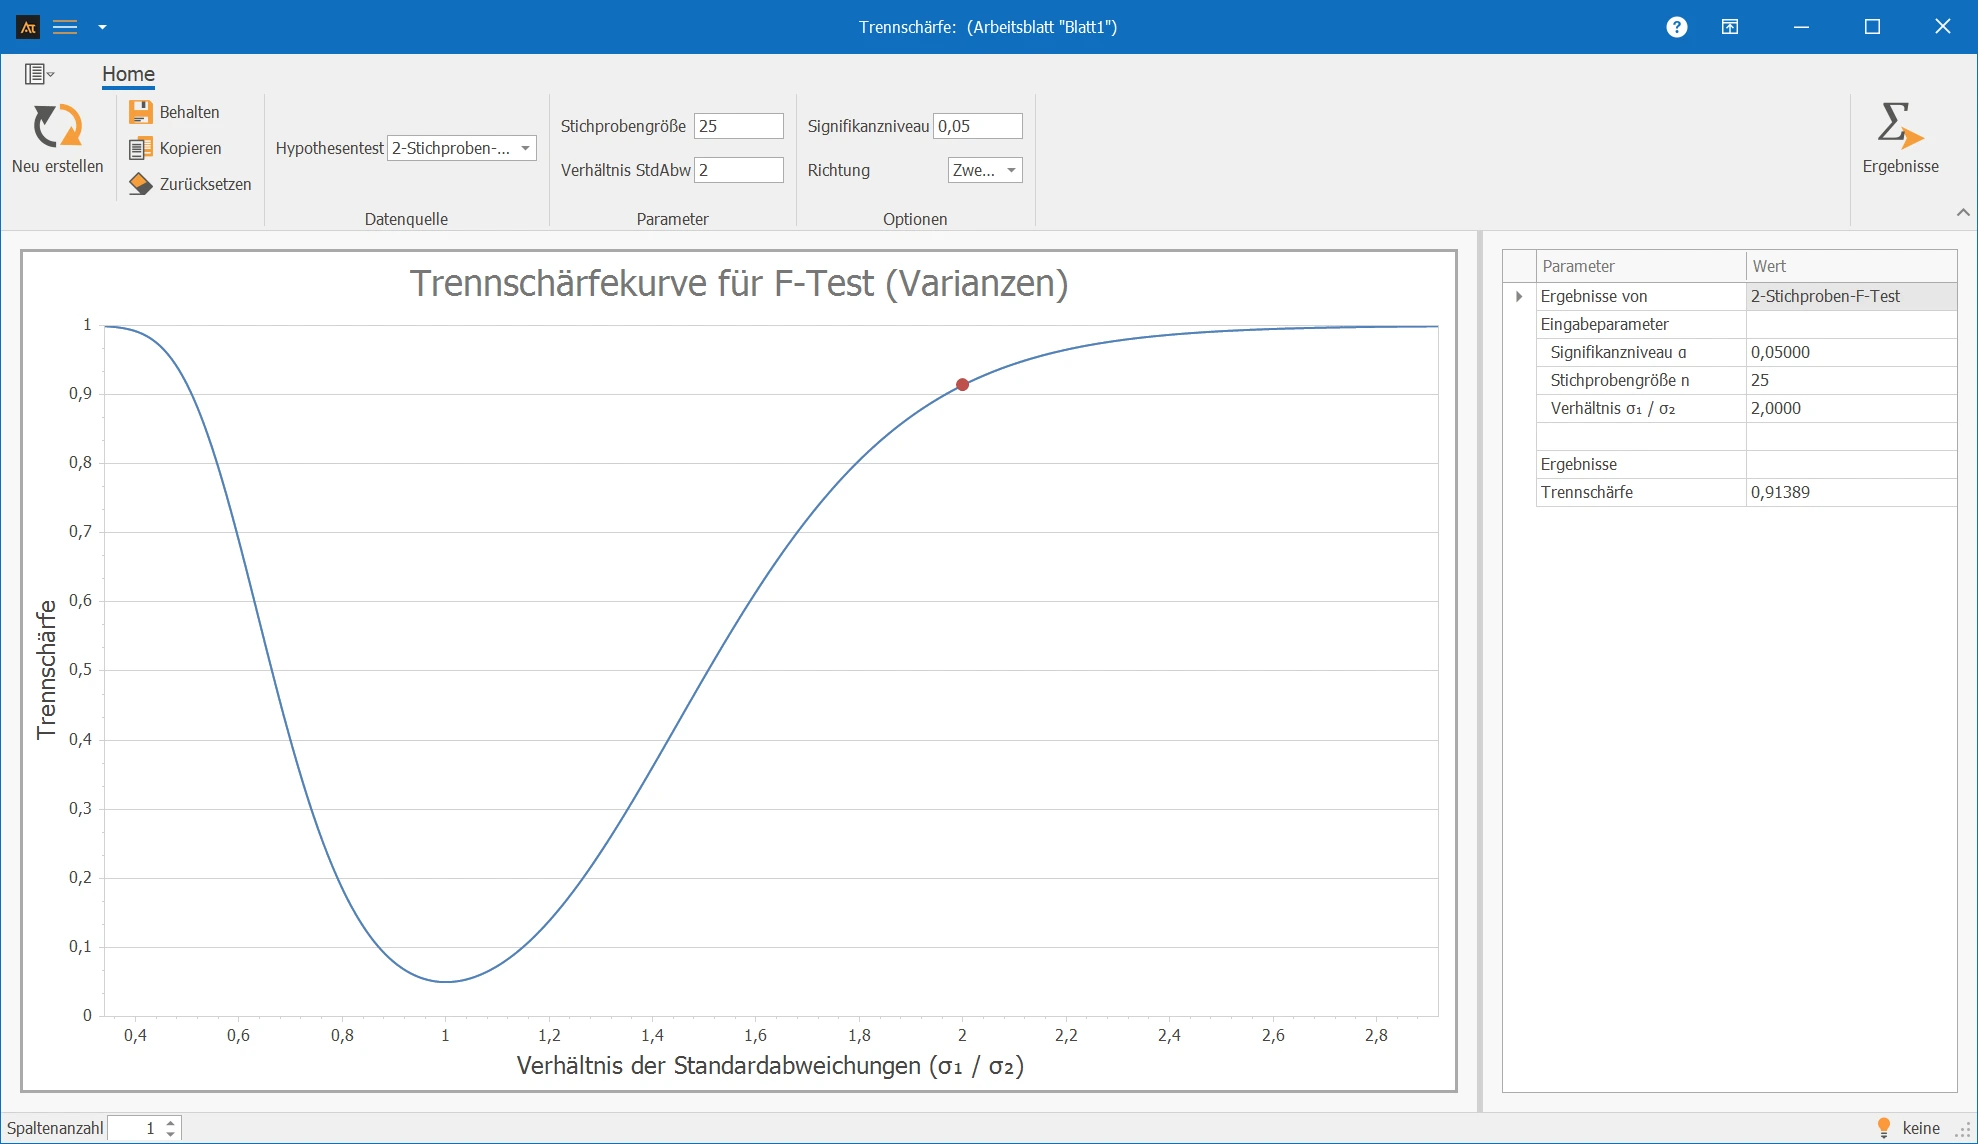
Unterschiede in den Streuungen: Reicht die Trennschärfe aus, um eine Verdopplung der Streuung der Abfüllmenge zu erkennen?
Interpretation
Für den F-Test zeigt die Trennschärfe, mit welcher Wahrscheinlichkeit ein Unterschied in der Streuung erkannt wird. Die Trennschärfe liegt bei 0,91389. Eine Verdopplung der Standardabweichung kann damit mit ca. 91,4 % Trennschärfe erkannt werden. Der β-Fehler beträgt ca. 8,6 %.
Reaktionszeit des IT-Helpdesks vs. Standort-ANOVA
Im IT-Service-Desk werden Tickets an mehreren Standorten bearbeitet. Die Reaktionszeiten werden regelmäßig ausgewertet, um Unterschiede in der Servicequalität zu erkennen.
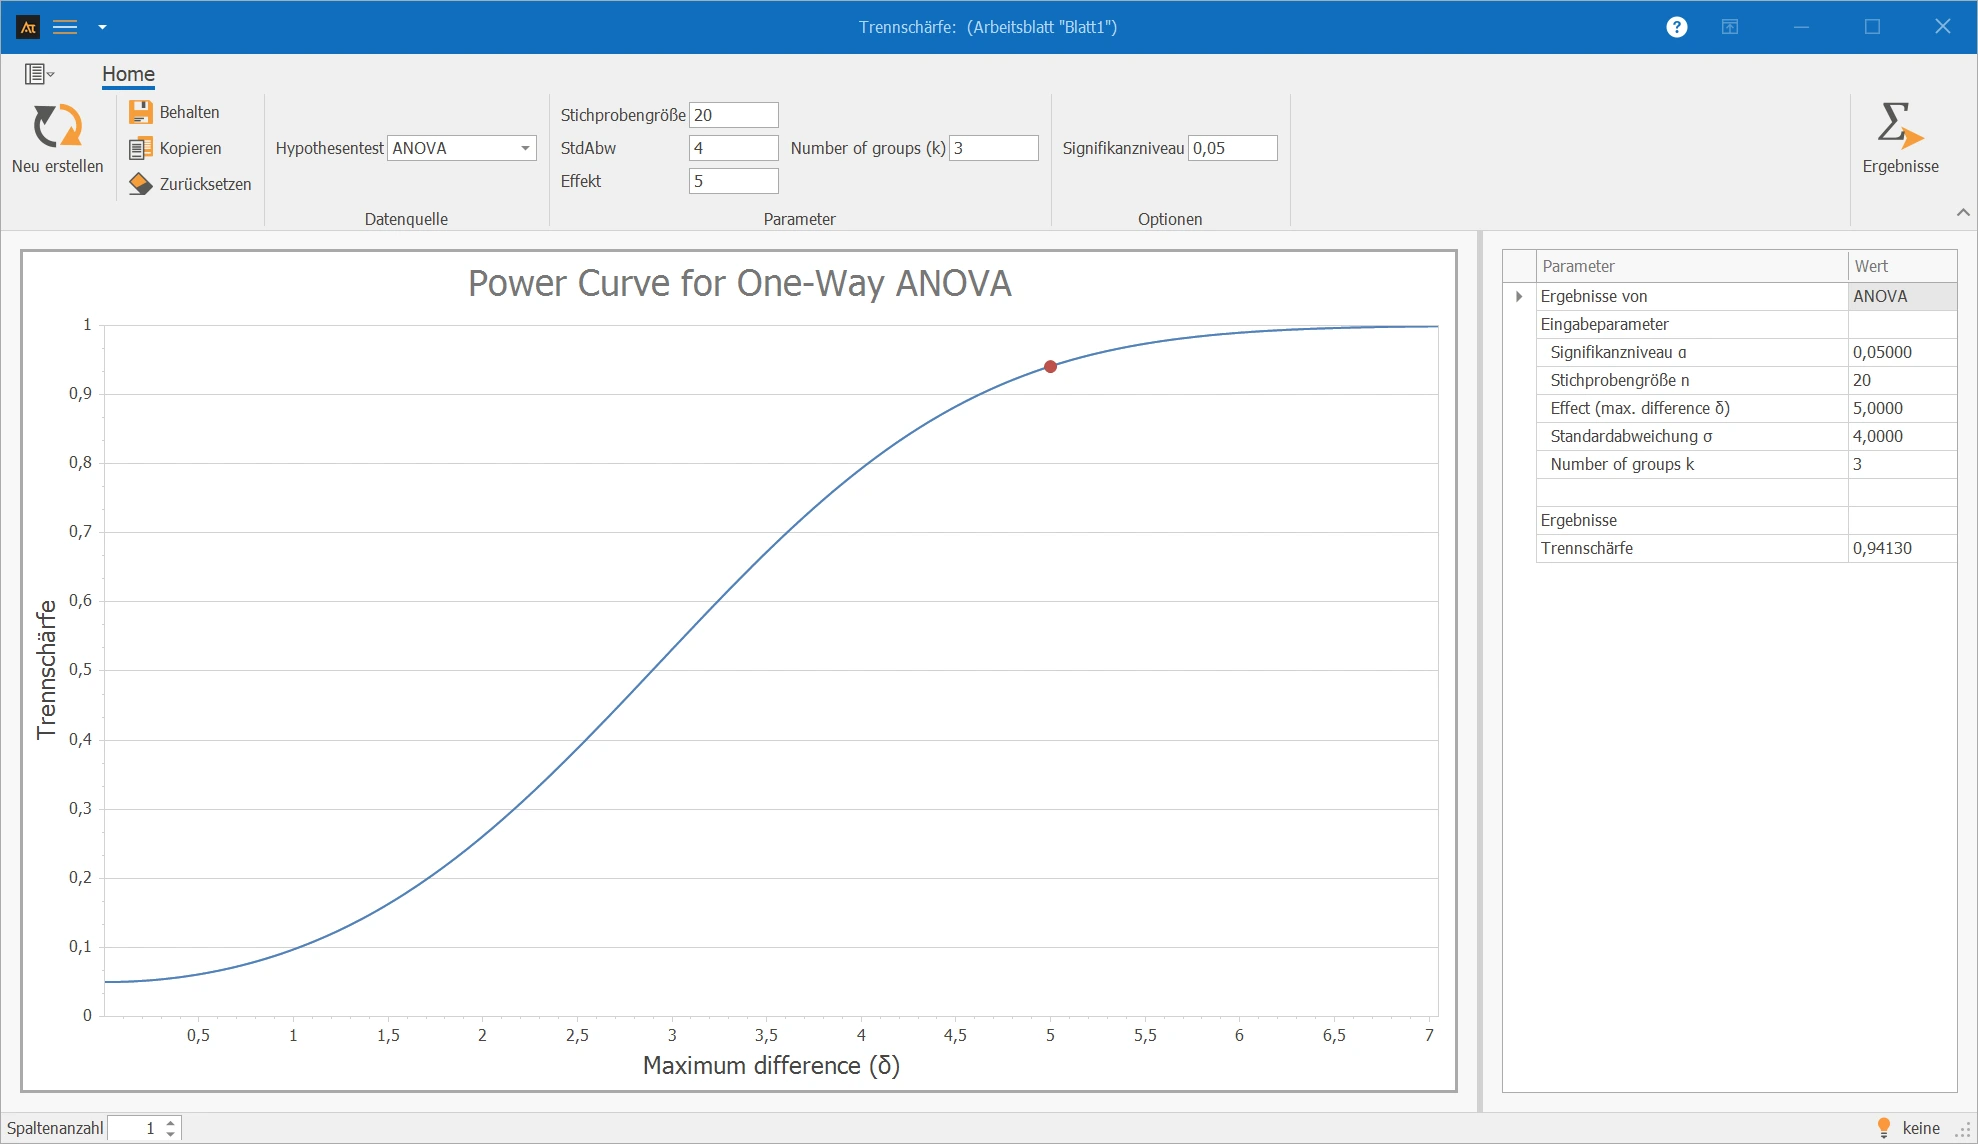
Im Beispiel der IT-Tickets liegen Daten von drei Standorten vor. Mithilfe der Trennschärfe soll beurteilt werden, ob ein Unterschied von 5 min in der Reaktionszeit mit der ANOVA erkannt werden würde.
Interpretation der Ergebnisse
Der Aufbau des Tests ist geeignet, um einen Unterschied von 5 min bei drei Stufen und einer Standardabweichung von 4 zu erkennen. Die Trennschärfe ist ausreichend hoch; der β-Fehler ist entsprechend niedrig.
Test von Anteilen - Verlustquote nach Vertriebsansatz
Im Vertrieb werden zwei Vertriebsansätze verglichen. Es soll beurteilt werden, ob die vorhandenen Angebotszahlen ausreichen, um eine relevante Veränderung der Verlustquote zuverlässig zu erkennen. Der Test von Anteilen ergab, dass sich die Vertriebsarten nicht signifikant unterscheiden.
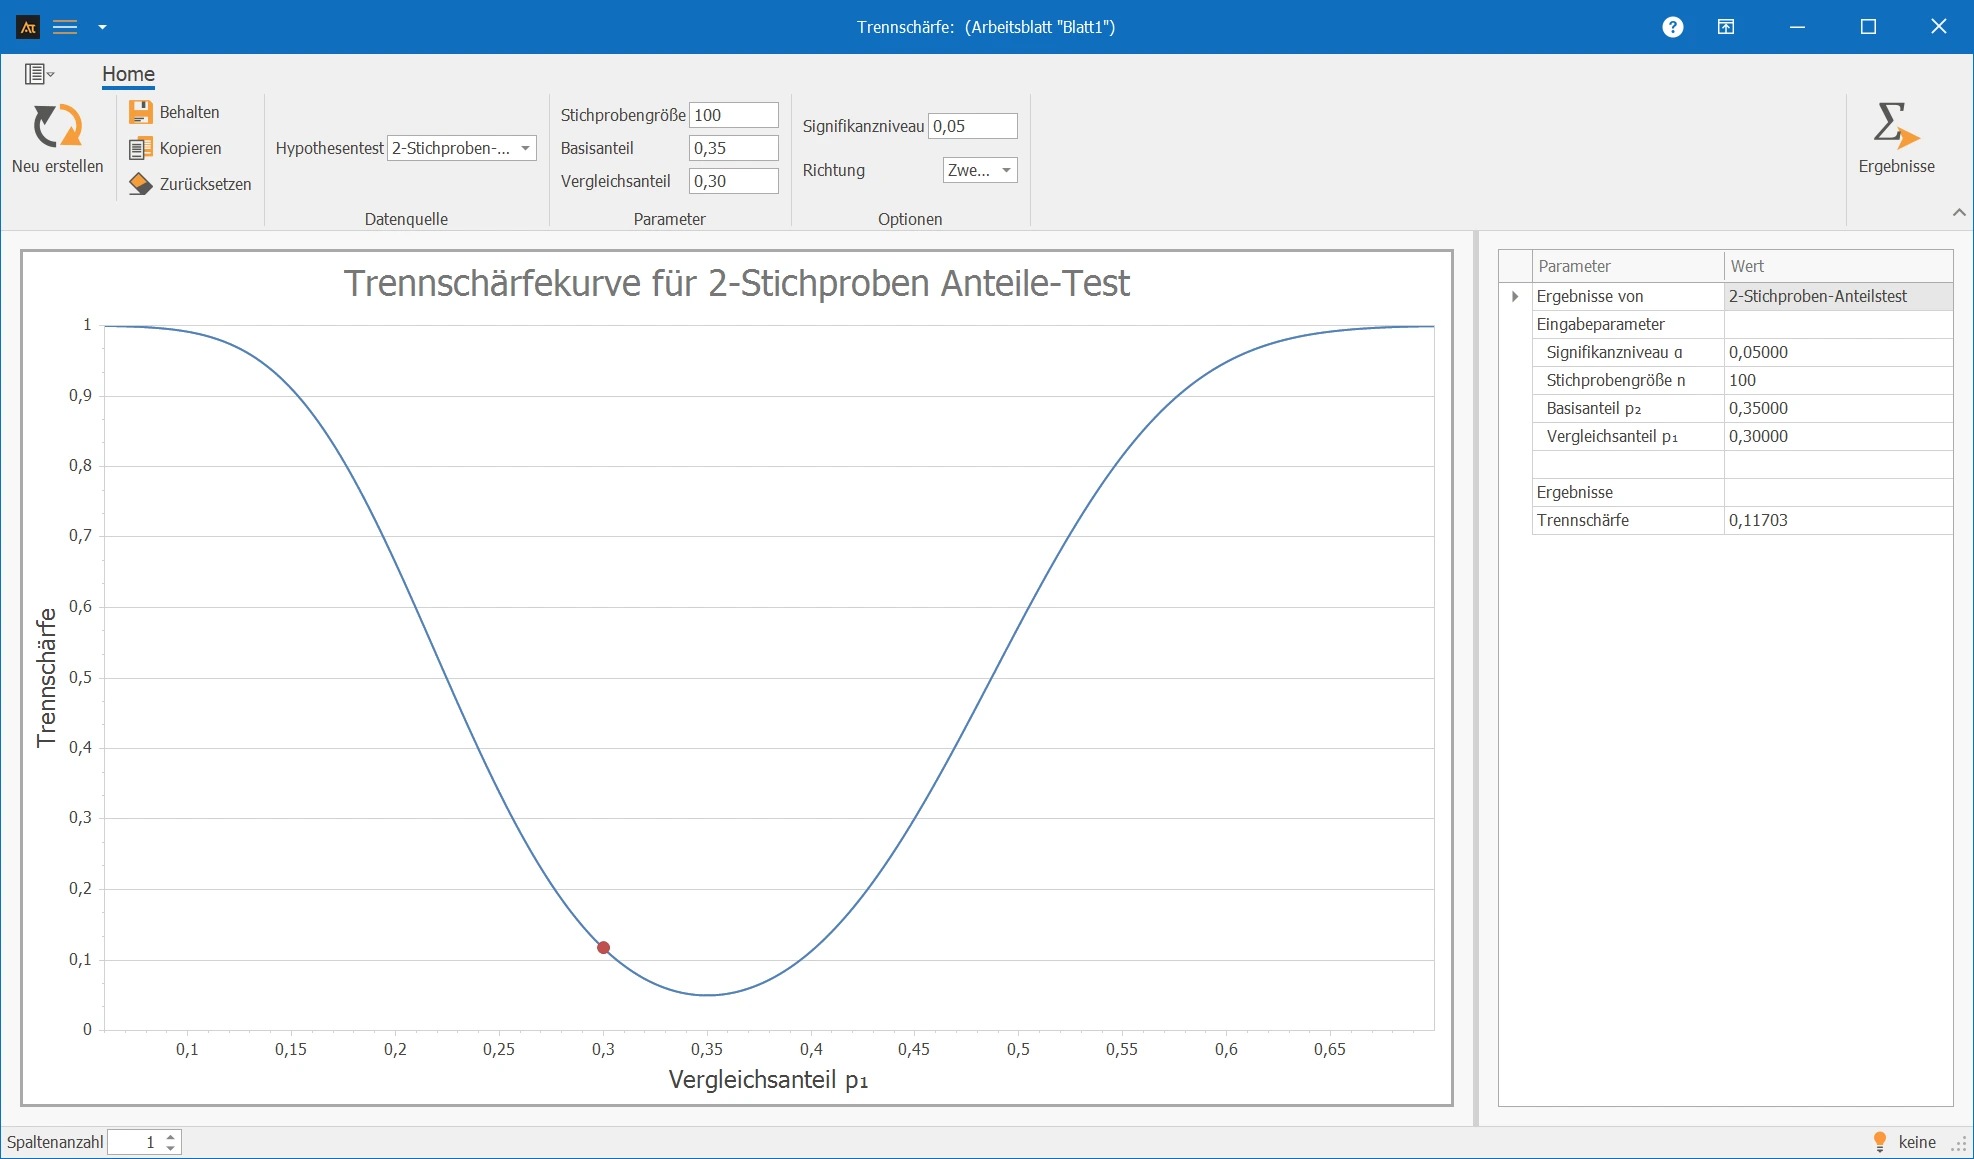
Nun soll mithilfe der Trennschärfeberechnung herausgefunden werden, ob eine Veränderung von 35 % auf 30 % erkannt werden würde.
Interpretation
Die Trennschärfe gibt an, mit welcher Wahrscheinlichkeit der Test eine relevante Änderung der Verlustquote erkennt. Die Trennschärfe ist mit 0,11703 niedrig. Das entspricht einem β-Fehler von ca. 88,3 %. Dass mit dem Test von Anteilen kein signifikanter Unterschied festgestellt werden konnte, kann daher daran liegen, dass zu wenige Angebote ausgewertet wurden.
Lieferzeit nach Logistikzentrum
In der Logistikabteilung werden Kundenaufträge kommissioniert und versendet. Zur Effizienzsteigerung wurden neue Stapler eingeführt.
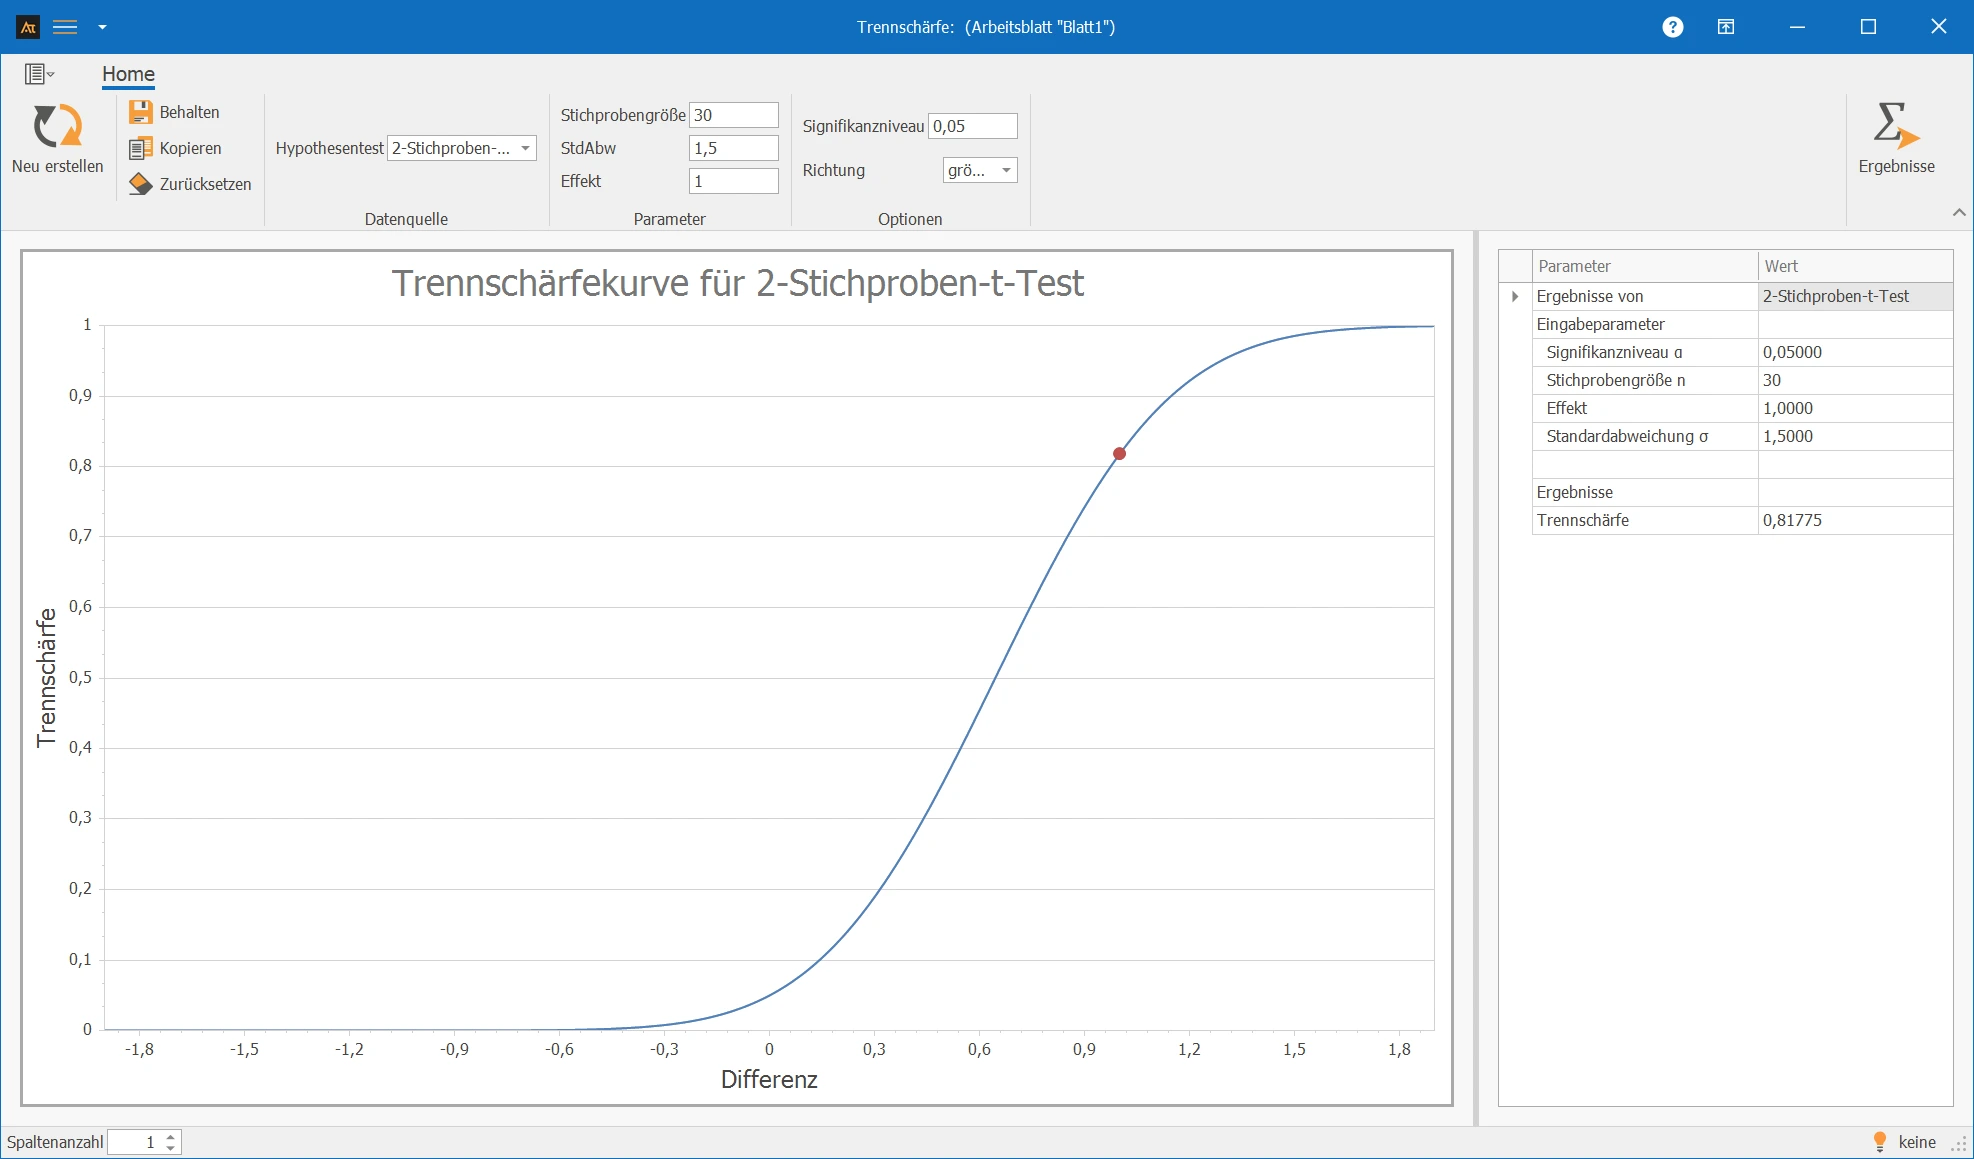
Es soll untersucht werden, ob bei einem gerichteten t-Test eine Verbesserung der Lieferzeit um 1 Tag erkannt werden kann. Die Streuung der Lieferzeit wird auf 2,5 Tage geschätzt. Es sollen 30 Messwerte erhoben werden.
Interpretation
Die Trennschärfe liegt bei 81,775 %. Damit kann ein Unterschied von 1 Tag mit ca. 81,8 % Trennschärfe erkannt werden. Der β-Fehler beträgt ca. 18,2 %. Häufig wird eine Trennschärfe von mindestens 80 % als Orientierung verwendet. Dennoch sollte im Vorfeld festgelegt werden, welche Trennschärfe mindestens erreicht werden soll.
Lieferantenvergleich
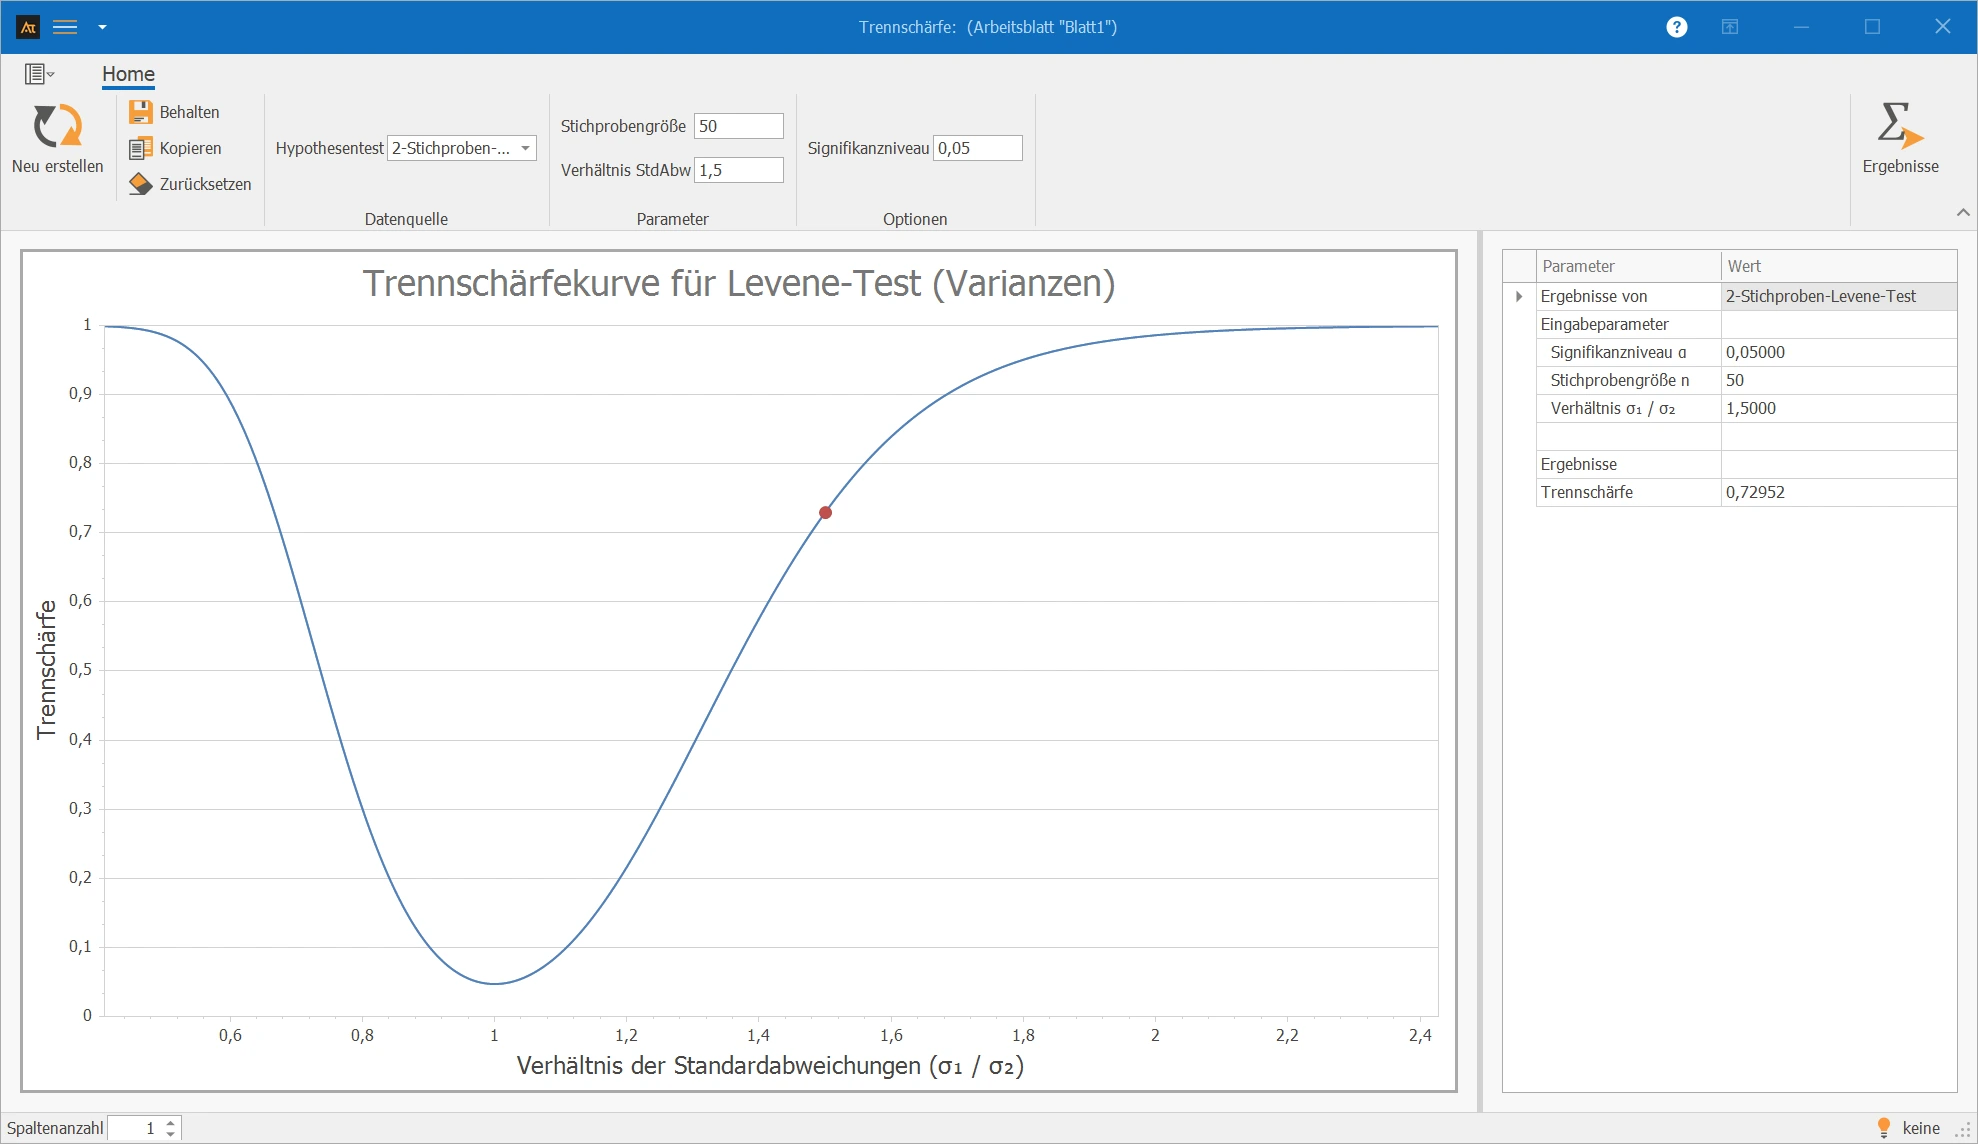
Im Einkauf werden Bauteile von mehreren Lieferanten bezogen. Es soll beurteilt werden, ob die vorhandenen Prüfungen ausreichen, um einen Unterschied um das 1,5-Fache in der Standardabweichung zwischen Lieferanten zu erkennen. Pro Lieferant liegen 50 Datensätze vor.
Interpretation
Die Trennschärfe hilft einzuschätzen, ob die vorhandene Anzahl an Lieferungen ausreicht, um relevante Lieferantenunterschiede zuverlässig zu erkennen. Bei niedriger Trennschärfe wäre der β-Fehler hoch; ein tatsächlich vorhandener Unterschied könnte dann unentdeckt bleiben.
Prognoseabweichung
In der Produktionsplanung werden Bedarfsprognosen für unterschiedliche Planungszeiträume erstellt. Zur Bewertung der Prognosegüte wird die Prognoseabweichung berechnet.
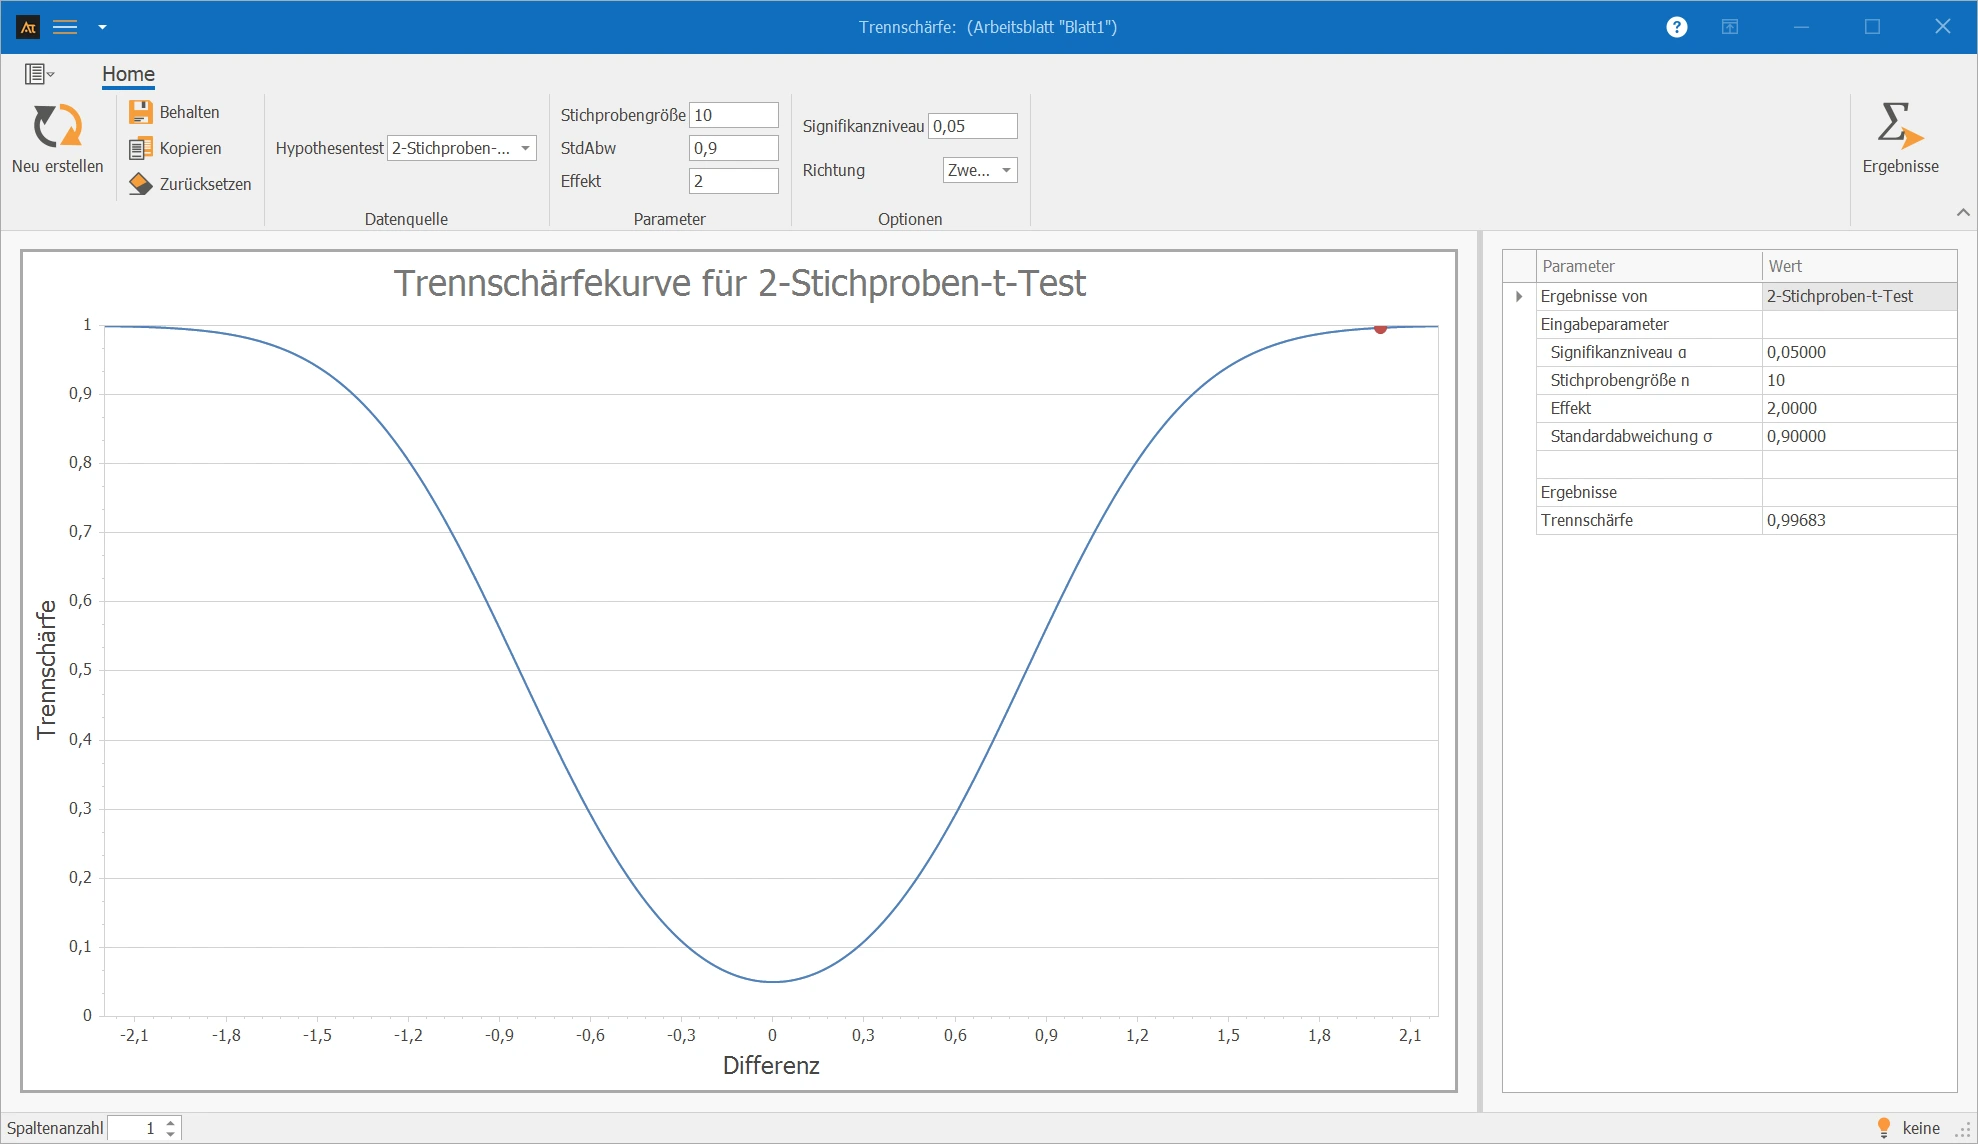
Es soll beurteilt werden, ob die vorhandene Stichprobe ausreicht, um Unterschiede zwischen kurzfristigem und langfristigem Planungshorizont mit einem t-Test zu erkennen. Hierbei soll ein Unterschied von 2 % erkannt werden. Die Standardabweichung ist aus vorherigen Analysen bekannt und beträgt 0,9 %. Je Horizont sollen 10 Prognosen erstellt und verglichen werden.
Interpretation
Mit dem t-Test kann ein Unterschied von 2 % zuverlässig erkannt werden, wenn die Standardabweichung bei 0,9 % liegt. Die Trennschärfe beträgt 99,68 %. Der β-Fehler liegt damit bei ca. 0,32 %.
Trennschärfe / Power: Wahrscheinlichkeit, mit der ein Test einen tatsächlich vorhandenen Effekt erkennt.
Effekt: Praktisch relevanter Unterschied, z. B. Mittelwertdifferenz, Varianzverhältnis oder Quotenänderung.
n = Stichprobengröße: Anzahl der Beobachtungen, Teile, Angebote oder Versuche innerhalb einer Gruppe.
α = Signifikanzniveau: Vorgegebene Irrtumswahrscheinlichkeit, mit der die Nullhypothese fälschlicherweise verworfen wird.
β = Fehler 2. Art: Wahrscheinlichkeit, einen tatsächlich vorhandenen Effekt nicht zu erkennen.
Power = 1 - β: Gegenwahrscheinlichkeit zum Fehler 2. Art.
x̄ = Mittelwert der Stichprobe: Durchschnittswert der erhobenen Messdaten.
s = Standardabweichung der Stichprobe: Maß für die Streuung der Daten um den Mittelwert.
p̂ = Stichprobenanteil: Anteil der Ereignisse in einer Stichprobe; berechnet als Ereignisse / Anzahl der Versuche.
Ereignis: Der interessierende Fall in einer Anteilsanalyse, z. B. undicht, verloren, pünktlich oder bestanden.
Faktor: Kategoriale Einflussgröße bei der ANOVA, z. B. Logistikzentrum, Lieferant oder Rezeptur.
Gruppen / Stufen: Ausprägungen des Faktors, z. B. Zentrum A, Zentrum B und Zentrum C.
Zweiseitig: Es wird geprüft, ob ein Unterschied in beide Richtungen erkannt werden kann.
Größer: Es wird geprüft, ob ein Effekt in Richtung größerer Werte erkannt werden kann.
Kleiner: Es wird geprüft, ob ein Effekt in Richtung kleinerer Werte erkannt werden kann.
Die folgenden Formeln beschreiben die im Tool verwendete Berechnungslogik der Trennschärfe. Die benötigten Verteilungs- und Quantilsfunktionen werden nicht manuell implementiert, sondern über die Statistikbibliotheken CenterSpace NMath und – soweit angegeben – Numerics.NET ausgewertet.
Grundprinzip
Die Trennschärfe, auch Power genannt, beschreibt die Wahrscheinlichkeit, dass ein statistischer Test einen tatsächlich vorhandenen Effekt erkennt.
Eine hohe Trennschärfe bedeutet, dass ein vorhandener Effekt mit hoher Wahrscheinlichkeit erkannt wird. Eine niedrige Trennschärfe bedeutet, dass der β-Fehler entsprechend größer ist.
t-Test für zwei Stichproben
Beim t-Test für zwei Stichproben wird berechnet, mit welcher Wahrscheinlichkeit ein angenommener Unterschied zwischen zwei Mittelwerten erkannt wird. Das Tool geht von gleich großen Stichproben aus.
Der Nichtzentralitätsparameter lautet:
Die Freiheitsgrade lauten:
Für die Berechnung werden Quantile der zentralen t-Verteilung und die Verteilungsfunktion der nichtzentralen t-Verteilung verwendet. Diese Funktionen werden über CenterSpace NMath ausgewertet. Dabei bezeichnet Ft,v,λ(x) die Verteilungsfunktion der nichtzentralen t-Verteilung.
Power = 1 − Ft,v,λ(t1−α,v)
Power = Ft,v,λ(tα,v)
Power = Ft,v,λ(tα/2,v) + 1 − Ft,v,λ(t1−α/2,v)
F-Test für zwei Varianzen
Beim F-Test wird die Trennschärfe für einen angenommenen Unterschied zwischen den Streuungen zweier Gruppen bestimmt. Als Eingabe verwendet das Tool das Verhältnis der Standardabweichungen:
Für die Berechnung wird daraus das Verhältnis der Varianzen gebildet:
Bei gleich großen Stichproben gelten folgende Freiheitsgrade:
Die benötigten Quantile und Verteilungsfunktionen der F-Verteilung werden über CenterSpace NMath ausgewertet. Fk1,k2(x) bezeichnet im Folgenden die Verteilungsfunktion der F-Verteilung.
Power = 1 − Fk1,k2 (F1−α,k1,k2 / ρ²)
Power = Fk1,k2 (Fα,k1,k2 / ρ²)
Power = Fk1,k2 (Fα/2,k1,k2 / ρ²) + 1 − Fk1,k2 (F1−α/2,k1,k2 / ρ²)
Levene-Test für zwei Varianzen
Für die Power-Berechnung des Levene-Tests verwendet das Tool eine Näherungsberechnung auf Basis des Verhältnisses der Standardabweichungen.
Die Freiheitsgrade der verwendeten t-Verteilung lauten:
Der kritische t-Wert wird über die Quantilsfunktion der t-Verteilung bestimmt:
Zusätzlich verwendet die Berechnung folgende Hilfsgrößen:
c = √(π/2 − 1)
SE = c·√(ρ²/n₁ + 1/n₂)
Daraus werden die beiden z-Werte bestimmt:
z₂ = −tkrit/θ − (ρ−1)/SE
Die Power wird anschließend mithilfe der Standardnormalverteilung bestimmt. Die t- und Normalverteilungsfunktionen werden über CenterSpace NMath ausgewertet.
Test von Anteilen für zwei Stichproben
Beim Test von Anteilen wird berechnet, mit welcher Wahrscheinlichkeit ein tatsächlicher Unterschied zwischen zwei Anteilen erkannt wird.
Die Differenz der Anteile lautet:
Der gemeinsame Anteil für die Berechnung unter der Nullhypothese lautet:
Der Standardfehler unter der Nullhypothese lautet:
Der Standardfehler unter der Alternativhypothese lautet:
Die Quantile und die Verteilungsfunktion der Standardnormalverteilung werden über CenterSpace NMath ausgewertet.
Power = Φ((d − z1−α·SE₀) / SE₁)
Power = 1 − Φ((d + z1−α·SE₀) / SE₁)
Power = 1 − Φ((d + z1−α/2·SE₀) / SE₁) + Φ((d − z1−α/2·SE₀) / SE₁)
Einfaktorielle ANOVA
Die einfaktorielle ANOVA prüft, ob sich die Mittelwerte mehrerer Gruppen unterscheiden.
H₁: Mindestens ein Gruppenmittelwert unterscheidet sich.
Im Tool wird als Effekt die maximale Differenz zwischen den Gruppenmittelwerten verwendet:
Für die Berechnung des Nichtzentralitätsparameters wird angenommen, dass zwei Gruppen den maximalen Abstand Δ bilden. Der im Tool verwendete Nichtzentralitätsparameter lautet:
Die Freiheitsgrade lauten:
Das kritische F-Quantil wird mithilfe von CenterSpace NMath bestimmt:
Für die Auswertung der nichtzentralen F-Verteilung verwendet das Tool Numerics.NET.
t-Test für eine Stichprobe
Beim t-Test für eine Stichprobe wird die Trennschärfe für einen vorgegebenen Effekt, eine Stichprobengröße und eine angenommene Standardabweichung berechnet.
Der Nichtzentralitätsparameter lautet:
Die Freiheitsgrade lauten:
Die benötigten Quantile der t-Verteilung sowie die Verteilungsfunktion der nichtzentralen t-Verteilung werden über CenterSpace NMath ausgewertet.
Power = 1 − Ft,v,λ (t1−α,v)
Power = Ft,v,λ (tα,v)
Power = Ft,v,λ (tα/2,v) + 1 − Ft,v,λ (t1−α/2,v)
Varianztest für eine Stichprobe
Beim Varianztest für eine Stichprobe wird die Trennschärfe für ein angenommenes Verhältnis zwischen der tatsächlichen Standardabweichung und der hypothetischen Standardabweichung bestimmt.
Für die Berechnung wird das quadrierte Verhältnis verwendet:
Die Freiheitsgrade der Chi-Quadrat-Verteilung lauten:
Die benötigten Quantile und Verteilungsfunktionen der Chi-Quadrat-Verteilung werden über CenterSpace NMath ausgewertet.
Power = 1 − Fχ²,v (χ²1−α,v / r²)
Power = Fχ²,v (χ²α,v / r²)
Power = Fχ²,v (χ²α/2,v / r²) + 1 − Fχ²,v (χ²1−α/2,v / r²)
Test eines Anteils für eine Stichprobe
Beim Test eines Anteils wird die Trennschärfe für einen tatsächlichen Vergleichsanteil p gegenüber einem hypothetischen Anteil p₀ berechnet.
Der Standardfehler unter der Nullhypothese lautet:
Der Standardfehler unter der Alternativhypothese lautet:
Die benötigten Quantile und Verteilungsfunktionen der Standardnormalverteilung werden über CenterSpace NMath ausgewertet.
Power = Φ((d − z1−α·SE₀) / SE₁)
Power = Φ((−d − z1−α·SE₀) / SE₁)
Power = Φ((d − z1−α/2·SE₀) / SE₁) + Φ((−d − z1−α/2·SE₀) / SE₁)