


Das Tool Verteilungstest dient dazu, eine ausgewählte Datenreihe mit mehreren theoretischen Verteilungen zu vergleichen. Es hilft zu erkennen, welche Verteilung die Messwerte am besten beschreibt und ob die Daten für weiterführende statistische Analysen mit einer bestimmten Verteilungsannahme geeignet sind.
Das Ergebnis ist keine endgültige „Beweisführung“ für eine Verteilung. Ein hoher p-Wert bedeutet lediglich, dass der Anderson-Darling-Test keine statistisch auffällige Abweichung von der gewählten Verteilung findet. Die fachliche Plausibilität, der Prozessbezug und das Wahrscheinlichkeitsnetz müssen immer mit betrachtet werden.

Bei der Herstellung von Tomatensoße werden regelmäßig Viskositätswerte erfasst. Die Viskosität beschreibt, wie dickflüssig die Soße ist. Sie ist wichtig, damit das Produkt gleichmäßig abgefüllt werden kann und für den Kunden immer die gleiche Konsistenz besitzt.
Bevor weitere Analysen durchgeführt werden, soll geprüft werden, welche der ausgewählten Verteilungen die gemessenen Viskositätswerte sinnvoll beschreiben kann. Dazu werden die Daten mit den Verteilungstests für die Verteilungen Normal, Lognormal, Loglogistisch und Logistisch verglichen.
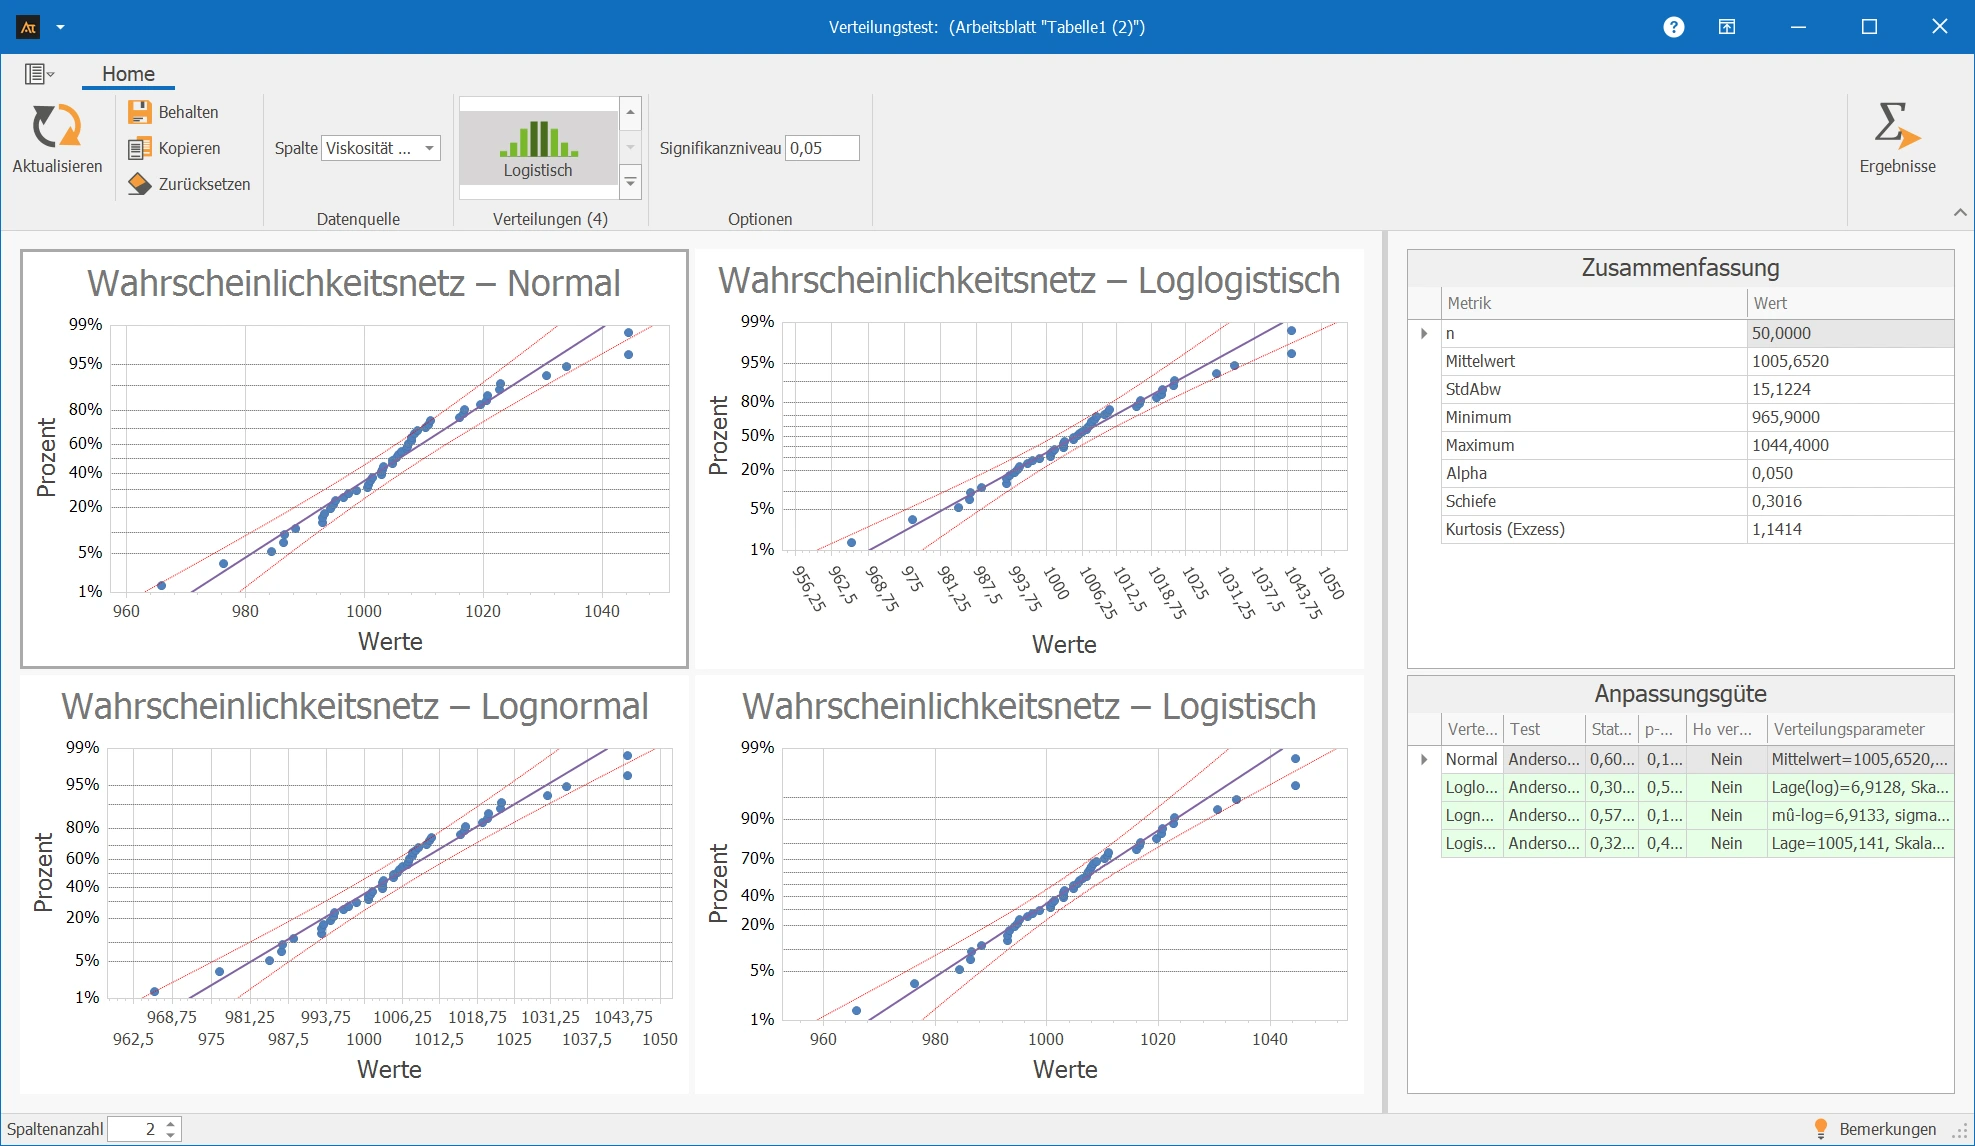
Erklärungen zu den Ergebnissen:
Wahrscheinlichkeitsnetze
Für jede erfolgreich berechnete Verteilung erzeugt Verteilungstest ein eigenes Wahrscheinlichkeitsnetz. Darin werden die sortierten Messwerte mit den Werten verglichen, die unter der jeweiligen theoretischen Verteilung zu erwarten wären.
- Liegen die Punkte nahe an der eingezeichneten Geraden, passt die gewählte Verteilung gut zu den Daten. Je stärker die Punkte von der Geraden abweichen, desto schlechter beschreibt diese Verteilung die Daten.
- Kurvenförmige Muster, S-Formen, deutliche Ausreißer oder Abweichungen in den Randbereichen zeigen, dass die Daten nicht gut zur getesteten Verteilung passen.
- Beim Vergleich mehrerer Verteilungen sollte nicht nur auf den p-Wert geachtet werden. Wichtig ist auch, ob das Wahrscheinlichkeitsnetz ein plausibles, ruhiges Muster zeigt und ob die Verteilung fachlich zum Merkmal passt.
Man kann die Gerade wie eine Schablone verstehen: Je besser die Punkte zur Schablone der Verteilung passen, desto eher eignet sich diese Verteilung als Modell für die Daten.
Anderson-Darling-Test
Der Verteilungstest verwendet den Anderson-Darling-Test als rechnerischen Güte-Test. Der Test prüft, ob die Messwerte zur jeweils ausgewählten Verteilung passen. Er wird für alle unterstützten Verteilungen durchgeführt, die mit den vorhandenen Daten berechnet werden können.
Der Test gibt je Verteilung eine Teststatistik und einen p-Wert aus:
- p-Wert größer als Alpha: Es gibt keine statistischen Hinweise, dass die Daten von dieser Verteilung abweichen. → Die Verteilung kann als mögliches Modell betrachtet werden.
- p-Wert kleiner oder gleich Alpha: Der Test findet deutliche Abweichungen. → Die Nullhypothese wird verworfen; die getestete Verteilung passt statistisch nicht ausreichend zu den Daten.
Warum wird der Anderson-Darling-Test verwendet? Er reagiert besonders empfindlich auf Abweichungen in den Randbereichen der Verteilung. Gerade dort liegen häufig Ausreißer oder extreme Werte, die für Qualitäts-, Prozess- und Lebensdaueranalysen wichtig sind.
Interpretation der Ergebnisse:
Die Viskositätswerte wurden mit den Verteilungen Normal, Lognormal, Loglogistisch und Logistisch verglichen. Bei allen vier Verteilungen ist der p-Wert größer als 0,05. Die Nullhypothese wird daher bei keiner Verteilung verworfen. Es liegen somit keine statistischen Hinweise vor, dass die Daten deutlich von einer der geprüften Verteilungen abweichen.
Auch die Wahrscheinlichkeitsnetze zeigen, dass die Punkte überwiegend nahe an den Geraden liegen. Damit können die Viskositätswerte mit den geprüften Verteilungen annähernd beschrieben werden.
Aus dem Ergebnis lässt sich jedoch nicht sicher ableiten, dass eine dieser Verteilungen eindeutig die beste ist. Die Auswahl der Verteilung sollte deshalb zusätzlich anhand der fachlichen Plausibilität und der geplanten weiteren Analyse erfolgen. Da Viskosität eine stetige Messgröße ist und die Daten annähernd symmetrisch um den Mittelwert streuen, kann zum Beispiel die Normalverteilung für viele weitere Standardauswertungen eine sinnvolle und gut begründbare Wahl sein.
Im Folgenden finden Sie die Überlegungen und Schritte, die notwendig sind, um mit Best Fit eine Datenreihe gegen mehrere Verteilungen zu prüfen.
Vorarbeit
- Eine geeignete numerische Messgröße auswählen.
- Messwerte erheben.
- Verteilungen auswählen, z. B. Weibull, Gamma, Lognormal.
 Nutzung in AlphadiTab
- In der Measure-Phase das Tool Verteilungstest auswählen.
- Die zu prüfende Datenreihe auswählen und in der Verteilungsgalerie eine oder mehrere Verteilungen aktivieren.
- Das Signifikanzniveau prüfen oder anpassen.
- Analyse mit Aktualisieren ausführen.
Interpretation
Prüfen Sie anschließend für jede ausgewählte Verteilung, ob sie geeignet ist, die Messwerte zu beschreiben.
- p-Wert: Ist der p-Wert größer als 0,05, liegen keine statistischen Hinweise auf eine Abweichung von der Verteilung vor. Die Daten können daher als annähernd passend zur Verteilung betrachtet werden.
- Wahrscheinlichkeitsnetz: Liegen die Punkte überwiegend nahe an der eingezeichneten Geraden, ist die gewählte Verteilung ein plausibles Modell für die Daten.
Im Tool stehen folgende Verteilungen zur Verfügung:
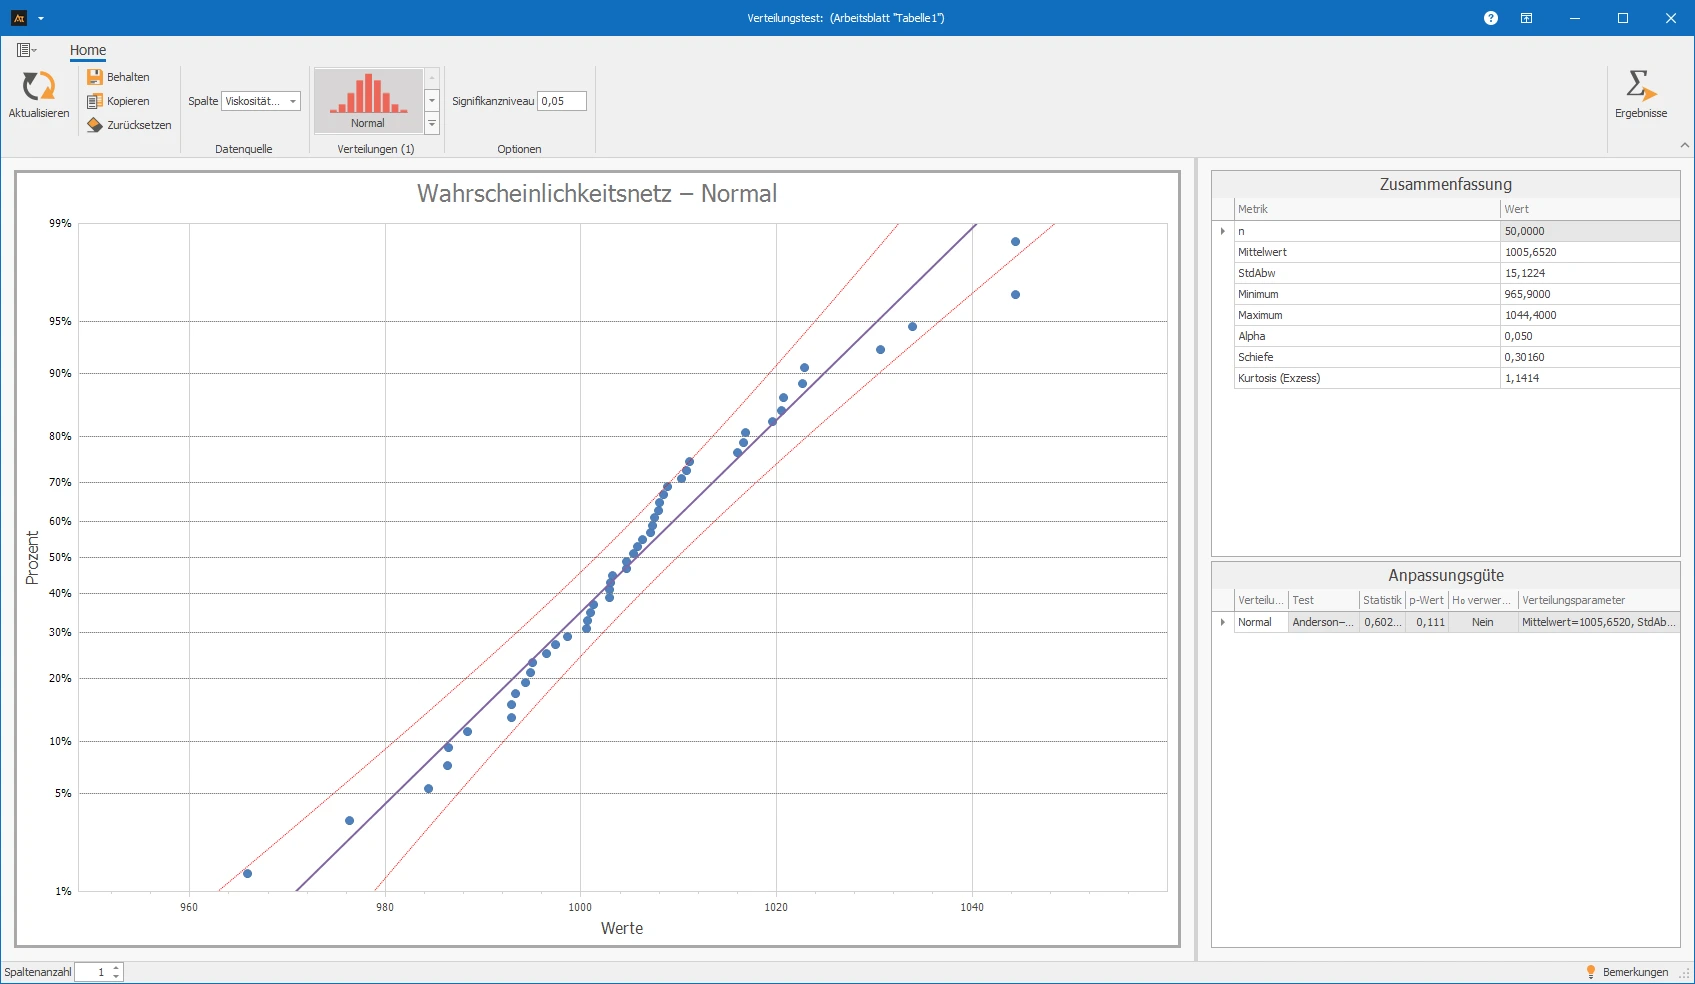
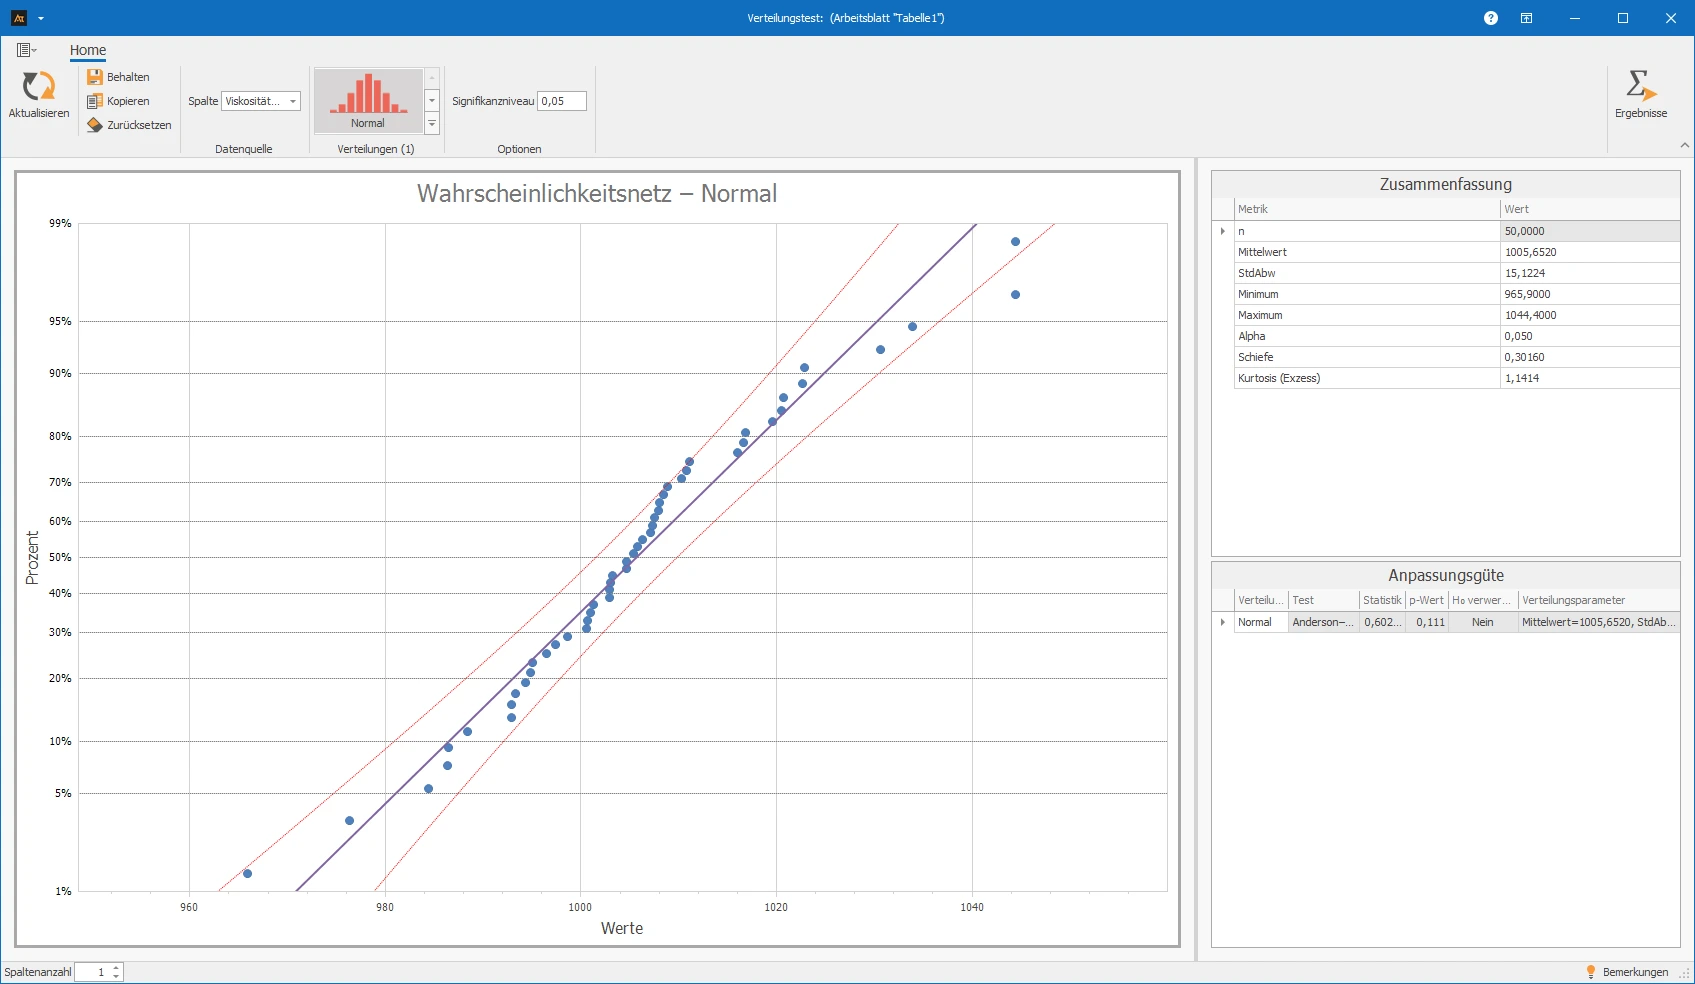
Normalverteilung
Die Normalverteilung ist eine symmetrische, glockenförmige Verteilung. Sie tritt häufig bei Messwerten auf, die durch viele kleine, zufällige Einflüsse entstehen. Beispiele sind Maße, Gewichte, Füllmengen oder Prozesswerte.
Typisch ist, dass die meisten Werte nahe am Mittelwert liegen und große Abweichungen nach oben oder unten seltener werden. Wenn die Daten gut zur Normalverteilung passen, können viele klassische statistische Verfahren verwendet werden.
Weibull-Verteilung
Die Weibull-Verteilung wird häufig für Lebensdauer-, Ausfall- und Zuverlässigkeitsdaten verwendet. Sie eignet sich besonders dann, wenn nur positive Werte auftreten, zum Beispiel Betriebszeiten bis zum Ausfall.
Je nach Formparameter kann die Weibull-Verteilung unterschiedliche Verläufe abbilden. Dadurch ist sie sehr flexibel und wird oft genutzt, um technische Lebensdauern, Verschleißverhalten oder Ausfallwahrscheinlichkeiten zu beschreiben.
Exponentialverteilung
Die Exponentialverteilung beschreibt Wartezeiten oder Zeiten bis zum nächsten Ereignis. Sie wird häufig verwendet, wenn Ereignisse zufällig und unabhängig voneinander auftreten.
Typische Beispiele sind Wartezeiten, Reaktionszeiten oder einfache Ausfallzeitmodelle. Die Verteilung beginnt bei null und fällt danach stetig ab. Sie ist nur für Werte größer oder gleich null geeignet.
Loglogistische Verteilung
Die loglogistische Verteilung eignet sich für positive, rechtsschiefe Daten. Sie wird häufig bei Lebensdauer-, Zeit- oder Prozessdaten eingesetzt, bei denen viele kleinere Werte und einige deutlich größere Werte auftreten.
Sie ähnelt in manchen Fällen der Lognormalverteilung, kann aber stärkere Ausprägungen im rechten Randbereich abbilden. Dadurch ist sie nützlich, wenn lange Bearbeitungszeiten oder späte Ausfälle stärker ins Gewicht fallen.
Gamma-Verteilung
Die Gamma-Verteilung wird für positive, rechtsschiefe Daten verwendet. Sie eignet sich für Messgrößen wie Wartezeiten, Durchlaufzeiten, Mengen oder Belastungen, sofern keine negativen Werte auftreten können.
Sie ist flexibler als die Exponentialverteilung, weil sie unterschiedliche Formen annehmen kann. Dadurch kann sie sowohl stark schiefe als auch moderat schiefe Daten gut beschreiben.
Lognormalverteilung
Die Lognormalverteilung entsteht, wenn die logarithmierten Werte annähernd normalverteilt sind. Sie wird für positive Daten verwendet, die nach rechts schief verteilt sind.
Typische Beispiele sind Zeiten, Lebensdauern, Konzentrationen, Kosten oder andere Größen, bei denen sehr große Einzelwerte auftreten können. Wenn Daten nicht normalverteilt sind, kann eine Lognormalverteilung oft besser passen.
Logistische Verteilung
Die logistische Verteilung ist symmetrisch und ähnelt der Normalverteilung. Sie besitzt jedoch etwas stärkere Randbereiche, wodurch extreme Werte etwas häufiger auftreten können als bei der Normalverteilung.
Sie kann verwendet werden, wenn Daten grundsätzlich symmetrisch verteilt sind, aber die Normalverteilung die Randbereiche nicht gut genug beschreibt.
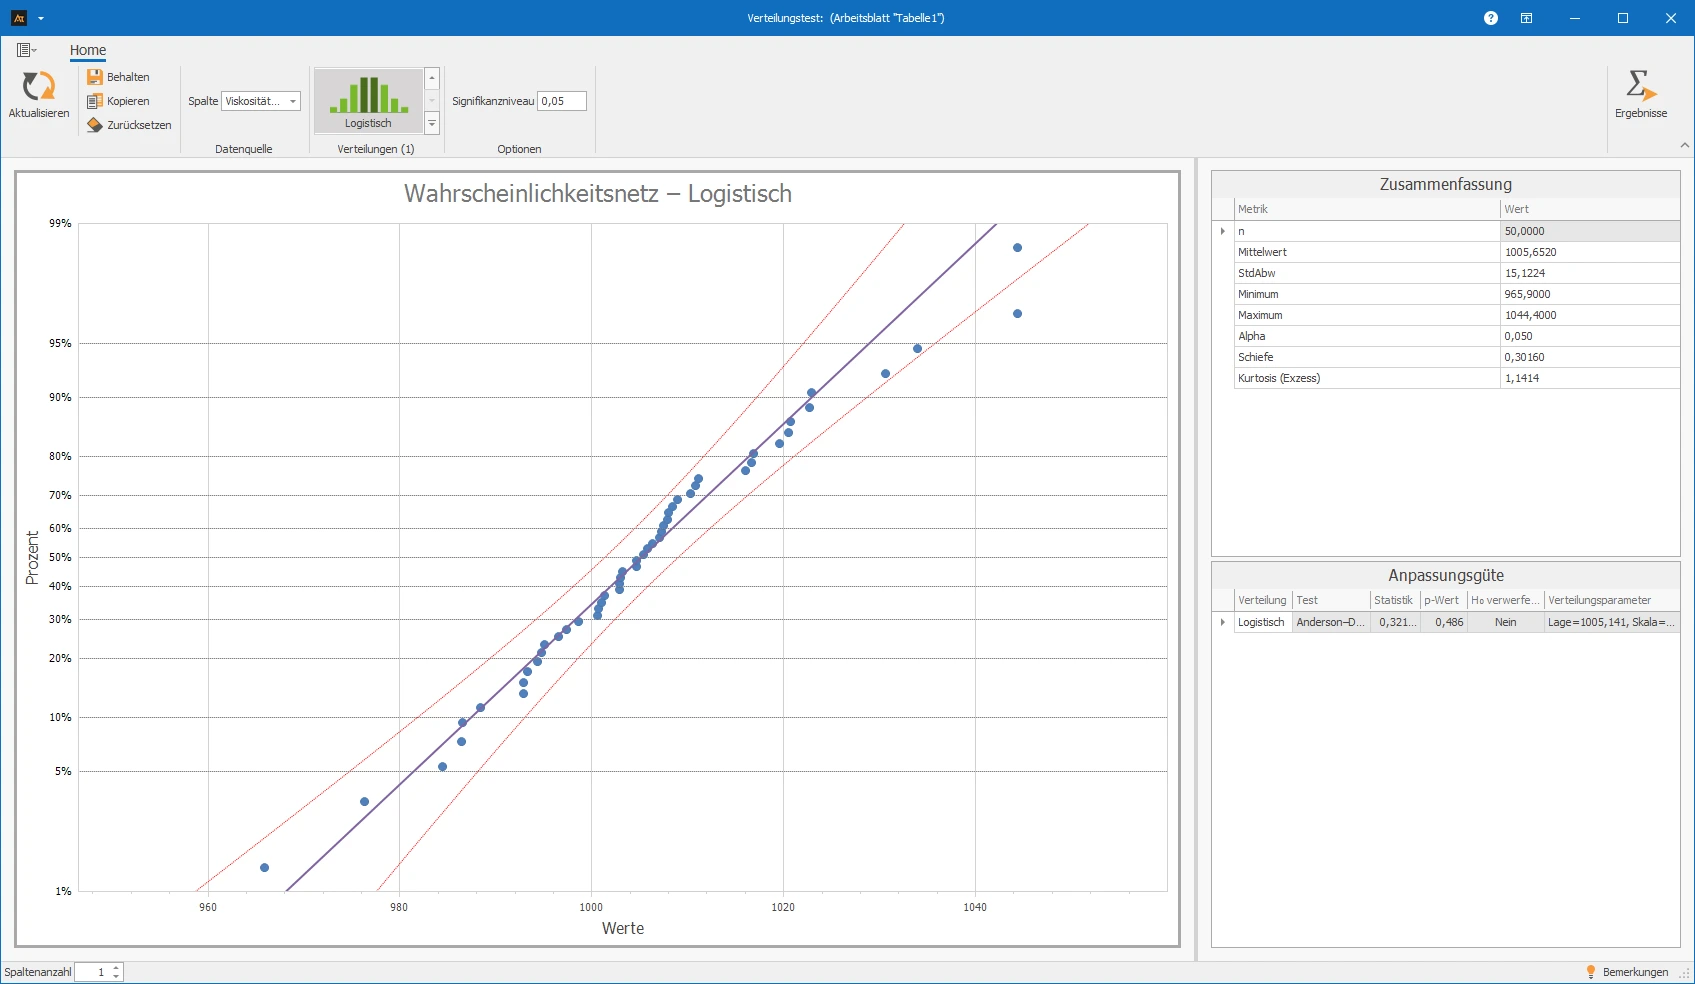
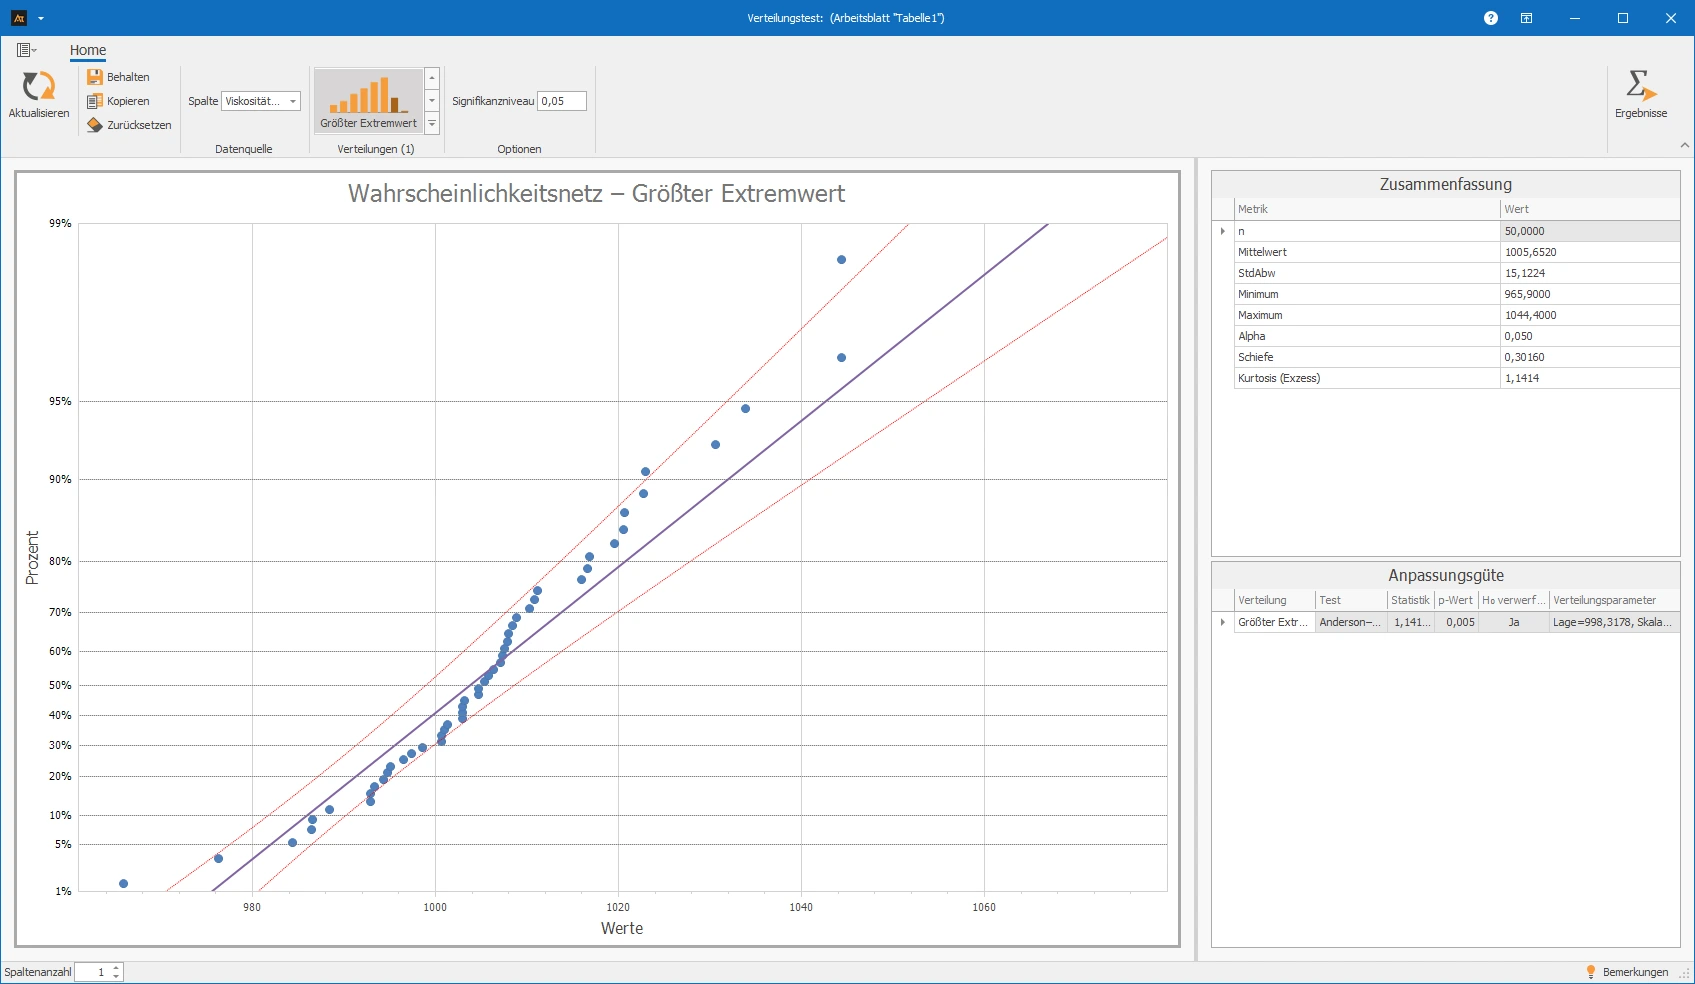
Größte Extremwertverteilung
Die größte Extremwertverteilung beschreibt maximale Werte. Sie wird verwendet, wenn besonders hohe Werte im Fokus stehen, zum Beispiel maximale Belastungen, Höchsttemperaturen, maximale Wartezeiten oder Spitzenwerte.
Sie ist geeignet, wenn nicht der typische Durchschnittswert, sondern das Verhalten der größten Beobachtungen wichtig ist.
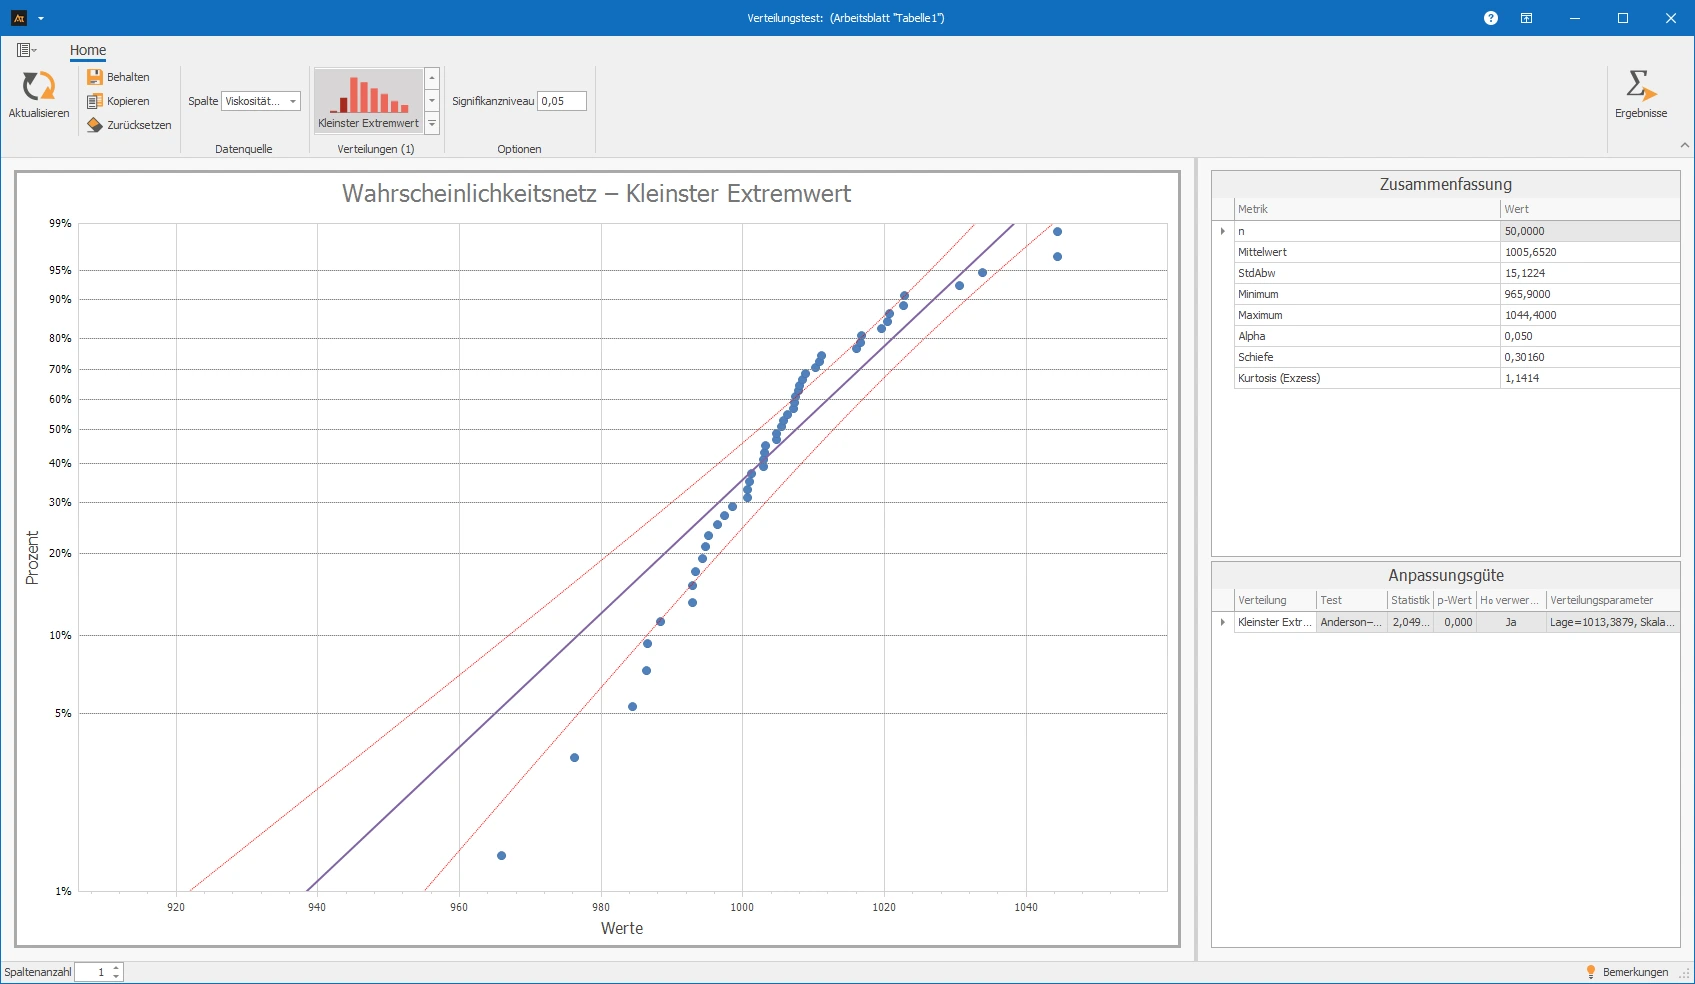
Kleinste Extremwertverteilung
Die kleinste Extremwertverteilung beschreibt minimale Werte. Sie wird verwendet, wenn besonders kleine Werte im Fokus stehen, zum Beispiel Mindestfestigkeiten, niedrigste Lebensdauern oder früheste Ausfälle.
Sie ist hilfreich, wenn das Risiko durch sehr kleine Messwerte bewertet werden soll, zum Beispiel bei Sicherheitsgrenzen oder Mindestanforderungen.
Bei nominalen oder ordinalen Daten ist der Verteilungstest nicht sinnvoll, da diese Datentypen nicht durch stetige Verteilungen wie Normal, Weibull oder Gamma beschrieben werden können.
Bei reinen Zähldaten oder diskreten Ereignissen sollte geprüft werden, ob ein spezielles Verfahren für diskrete Verteilungen besser geeignet ist. Der Verteilungstest ist für die im Tool unterstützten stetigen Verteilungen ausgelegt.
Der Verteilungstest ist besser geeignet, wenn mehrere mögliche Verteilungen miteinander verglichen werden sollen.
Abfüllmenge Tomatensoße
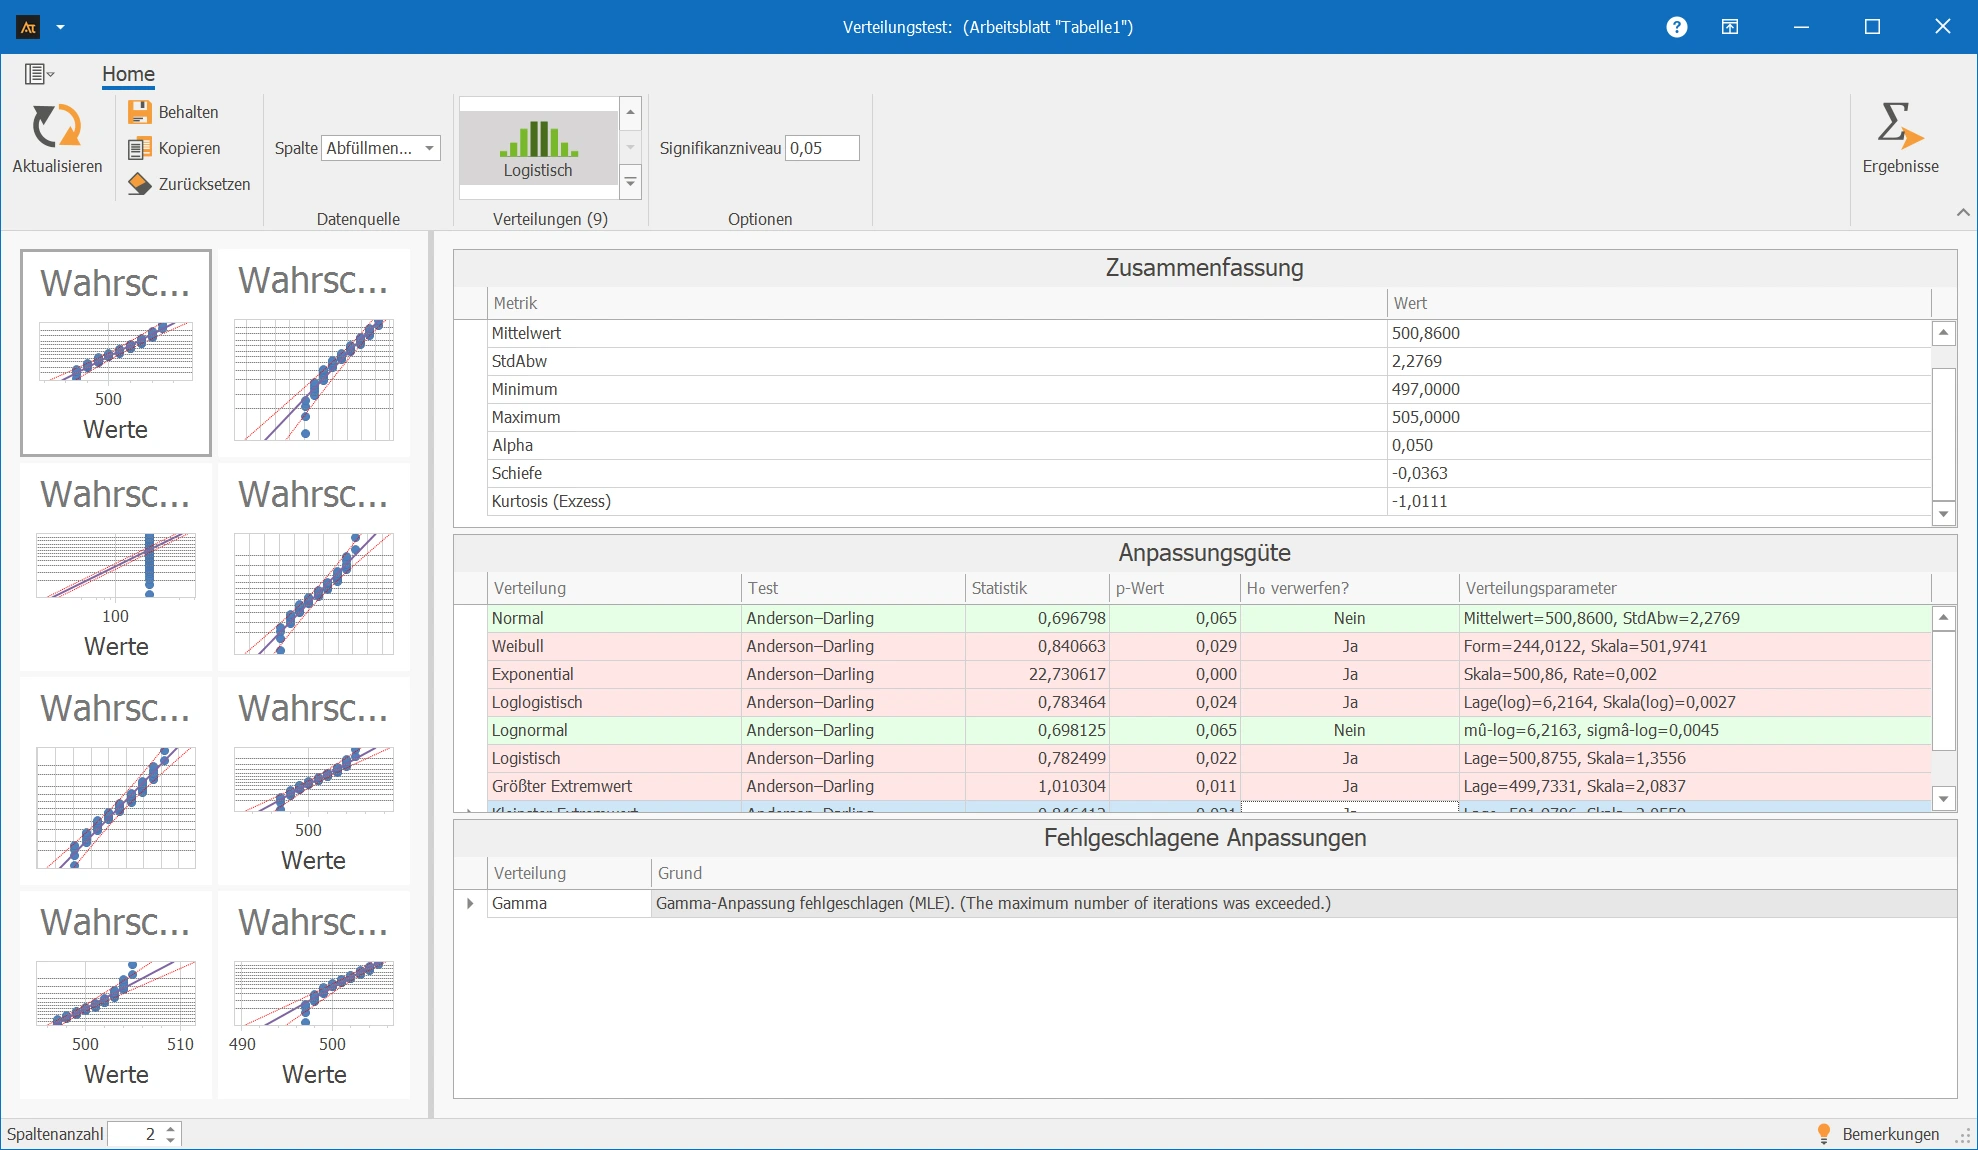
In diesem Beispiel wird die Abfüllmenge einer Tomatensoße untersucht. Jede Füllung soll 500 ml enthalten. Durch normale Prozessschwankungen liegen einige Füllmengen etwas unter und andere etwas über dem Zielwert. Da solche Messwerte häufig annähernd symmetrisch um den Zielwert streuen, wird geprüft, welche Verteilung die Daten sinnvoll beschreibt. Dazu werden die Abfüllmengen mit mehreren Verteilungen verglichen, unter anderem mit der Normalverteilung.
Interpretation
Die Abfüllmengen wurden mit mehreren Verteilungen verglichen. Im Ergebnis wird die Normalverteilung nicht verworfen, da der p-Wert mit 0,065 größer als das Signifikanzniveau von 0,05 ist. Auch im Wahrscheinlichkeitsnetz liegen die Punkte überwiegend nahe an der Geraden. Die Abfüllmengen können daher annähernd durch eine Normalverteilung beschrieben werden.
Mehrere andere Verteilungen werden dagegen verworfen, da ihre p-Werte kleiner oder gleich 0,05 sind. Dazu gehören unter anderem Weibull, Exponential, Loglogistisch, Logistisch und die größte Extremwertverteilung. Für diese Verteilungen gibt es statistische Hinweise, dass sie die Daten nicht passend beschreiben.
Die Lognormalverteilung wird ebenfalls nicht verworfen. Fachlich ist bei Abfüllmengen jedoch häufig die Normalverteilung sinnvoll, da es sich um eine stetige Messgröße handelt, die typischerweise um einen Zielwert streut.
Die Gamma-Verteilung konnte nicht berechnet werden, da die Anpassung fehlgeschlagen ist. Sie wird daher für die Interpretation nicht verwendet.
Fazit:
Für die weitere Analyse kann die Normalverteilung verwendet werden, da sie statistisch nicht verworfen wird und fachlich gut zu Abfüllmengen passt.
Durchlaufzeit eines Auftrags im Wareneingang
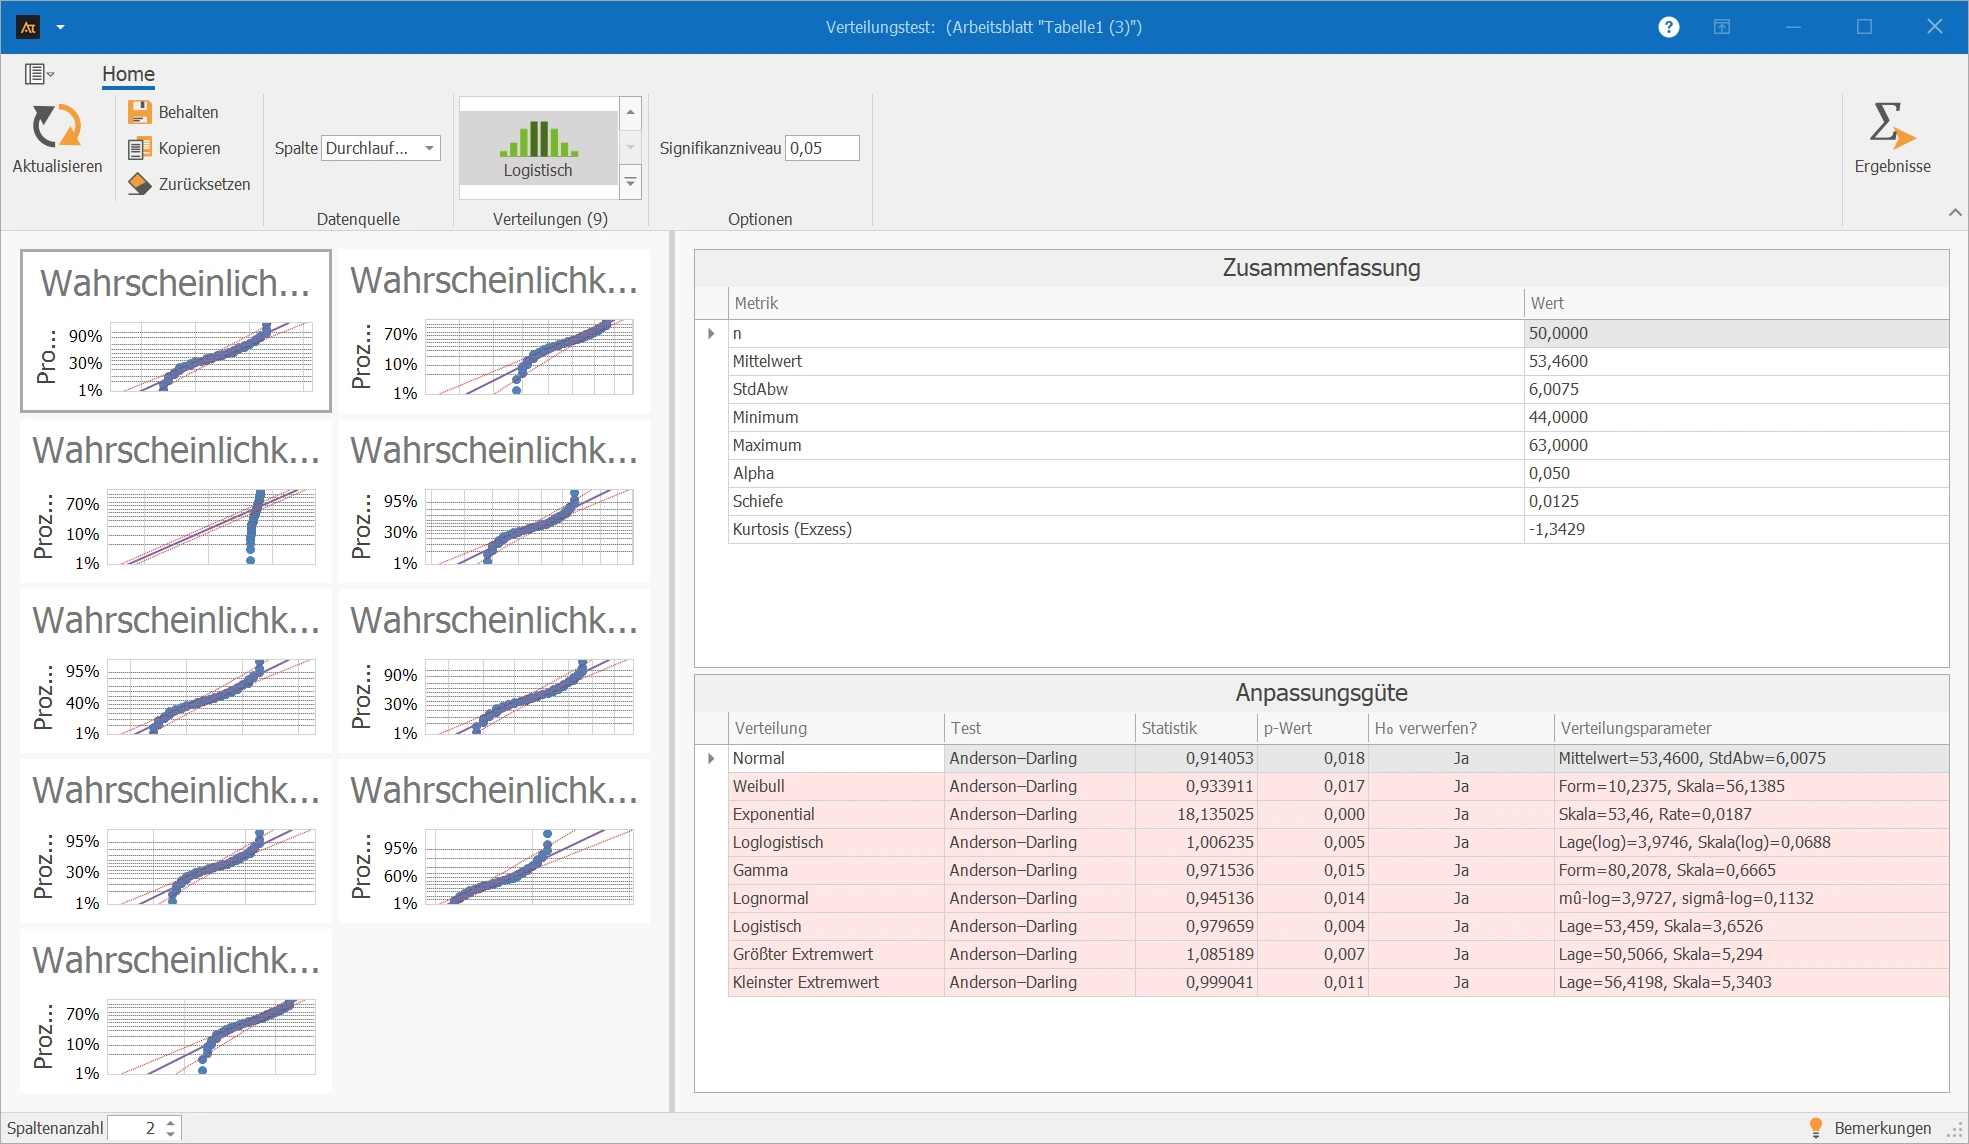
Im Wareneingang entstehen Bearbeitungszeiten, die häufig rechtsschief sind: Viele Aufträge werden schnell erledigt, einzelne Vorgänge dauern jedoch deutlich länger. Deshalb kann eine Lognormal-, Gamma-, Weibull- oder Exponentialverteilung plausibler sein als eine Normalverteilung.
Interpretation
Die Durchlaufzeiten wurden mit mehreren Verteilungen verglichen. Bei allen geprüften Verteilungen ist der p-Wert kleiner als 0,05. Damit werden alle Verteilungen verworfen.
Auch in den Wahrscheinlichkeitsnetzen liegen die Punkte nicht ausreichend gut auf den Geraden. Die Daten können daher durch keine der geprüften Verteilungen passend beschrieben werden.
Fazit:
Für die Durchlaufzeiten sollte keine der geprüften Verteilungen verwendet werden. Es sollte geprüft werden, ob unterschiedliche Prozesszustände oder Auftragsarten die Streuung verursachen.
Reaktionszeit des IT-Helpdesks (Spezifikation: max. 35 Minuten (OSG))
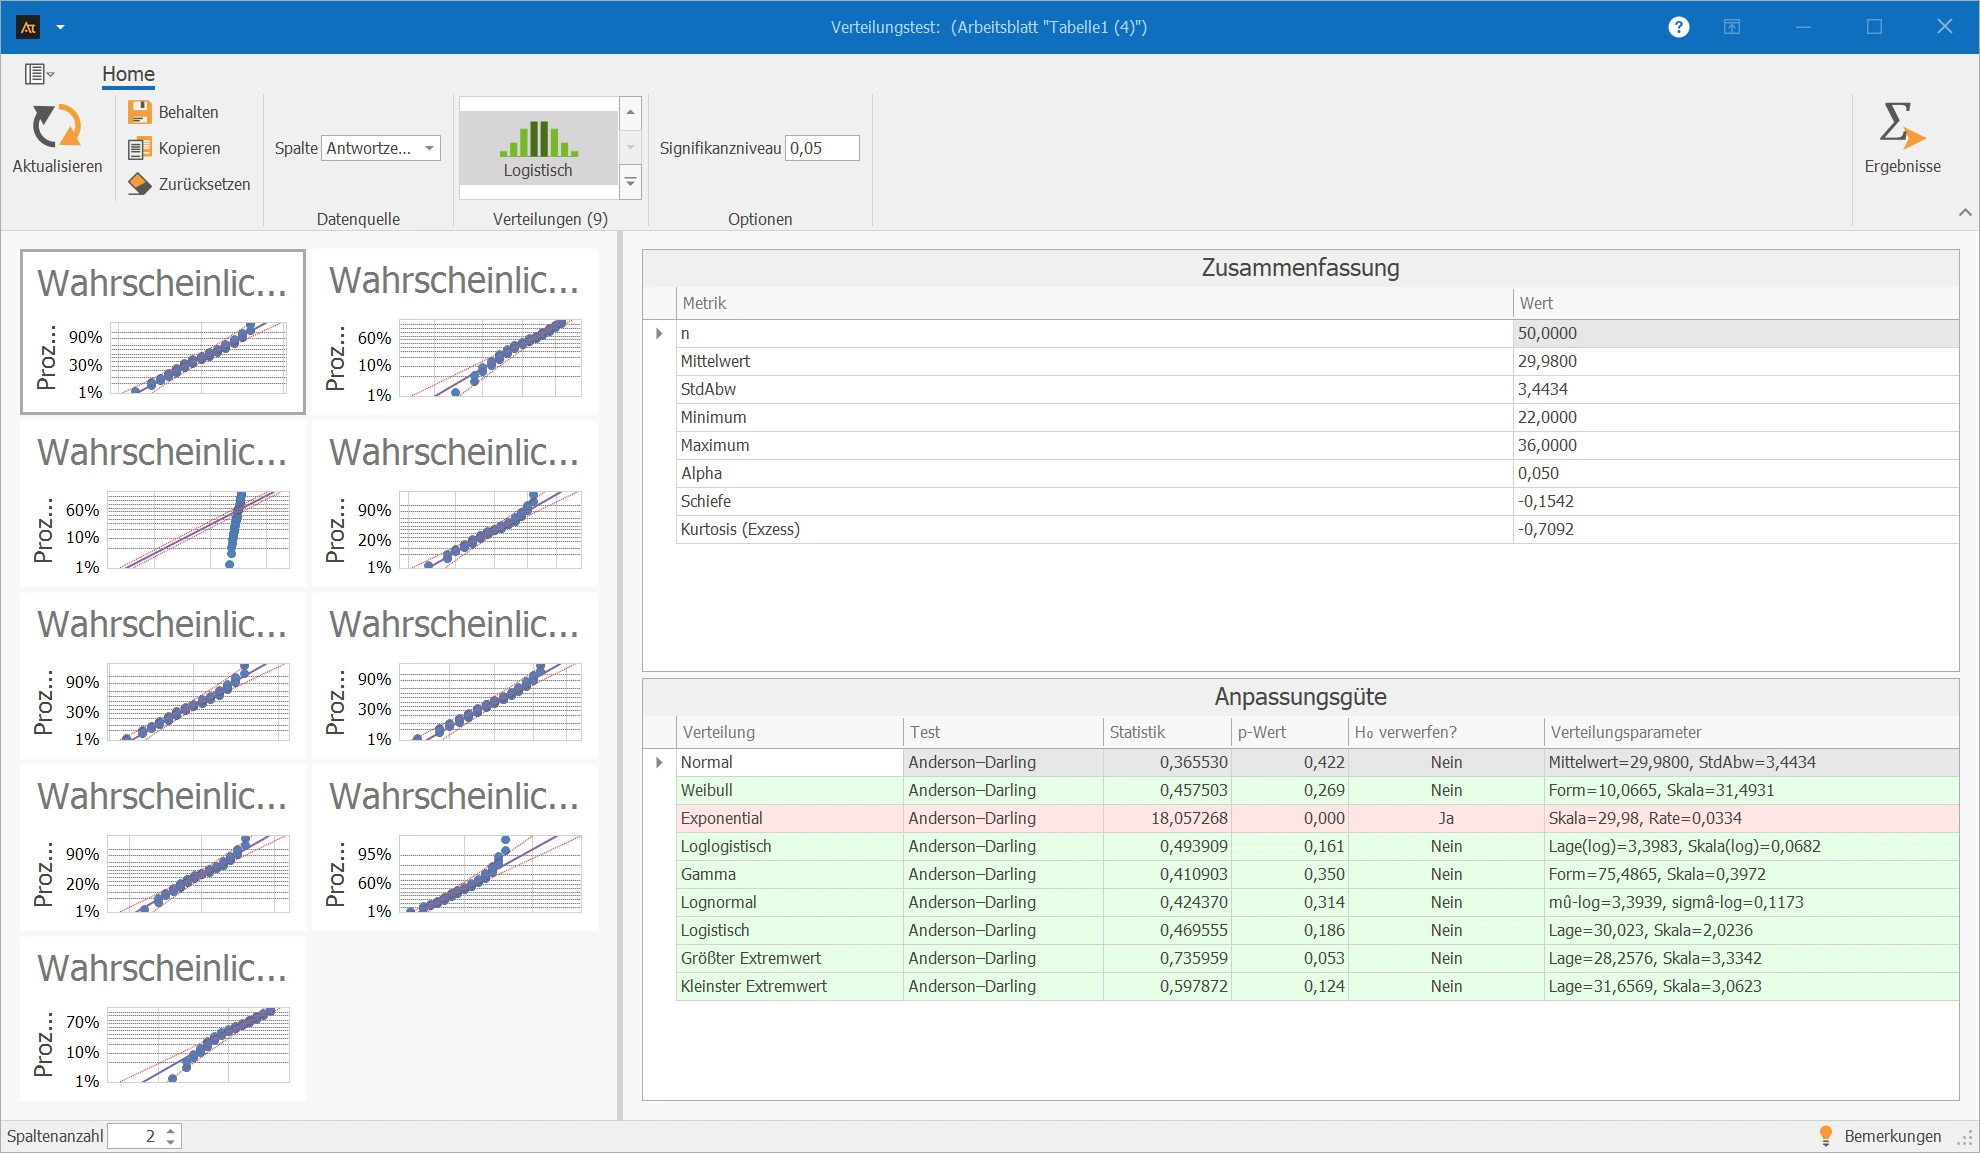
Im IT-Service-Desk gehen einfache und komplexe Anfragen ein. Dadurch können Antwortzeiten entstehen, die zwar teilweise um einen typischen Wert streuen, aber auch lange rechte Ausläufer besitzen. Best Fit hilft zu prüfen, welche Verteilung dieses Verhalten am besten beschreibt.
Interpretation
Die Antwortzeiten wurden mit mehreren Verteilungen verglichen. Die meisten geprüften Verteilungen werden nicht verworfen, da ihre p-Werte größer als 0,05 sind. Nur die Exponentialverteilung wird verworfen, da der p-Wert kleiner als 0,05 ist.
Für diese Verteilung passen die Daten nicht ausreichend gut. Auch die Wahrscheinlichkeitsnetze zeigen bei den nicht verworfenen Verteilungen überwiegend Punkte nahe an der Geraden.
Fazit:
Die Antwortzeiten können durch mehrere Verteilungen annähernd beschrieben werden. Für die weitere Analyse sollte eine fachlich passende Verteilung gewählt werden; die Exponentialverteilung sollte nicht verwendet werden.
Lebensdauer von Kugellagern
Für einen neuen Maschinentyp werden Kugellager im Dauerlauf getestet. Jedes Lager bleibt so lange im Prüfstand, bis es nicht mehr funktionsfähig ist. Solche Lebensdauerdaten sind typischerweise positiv und häufig nicht normalverteilt.
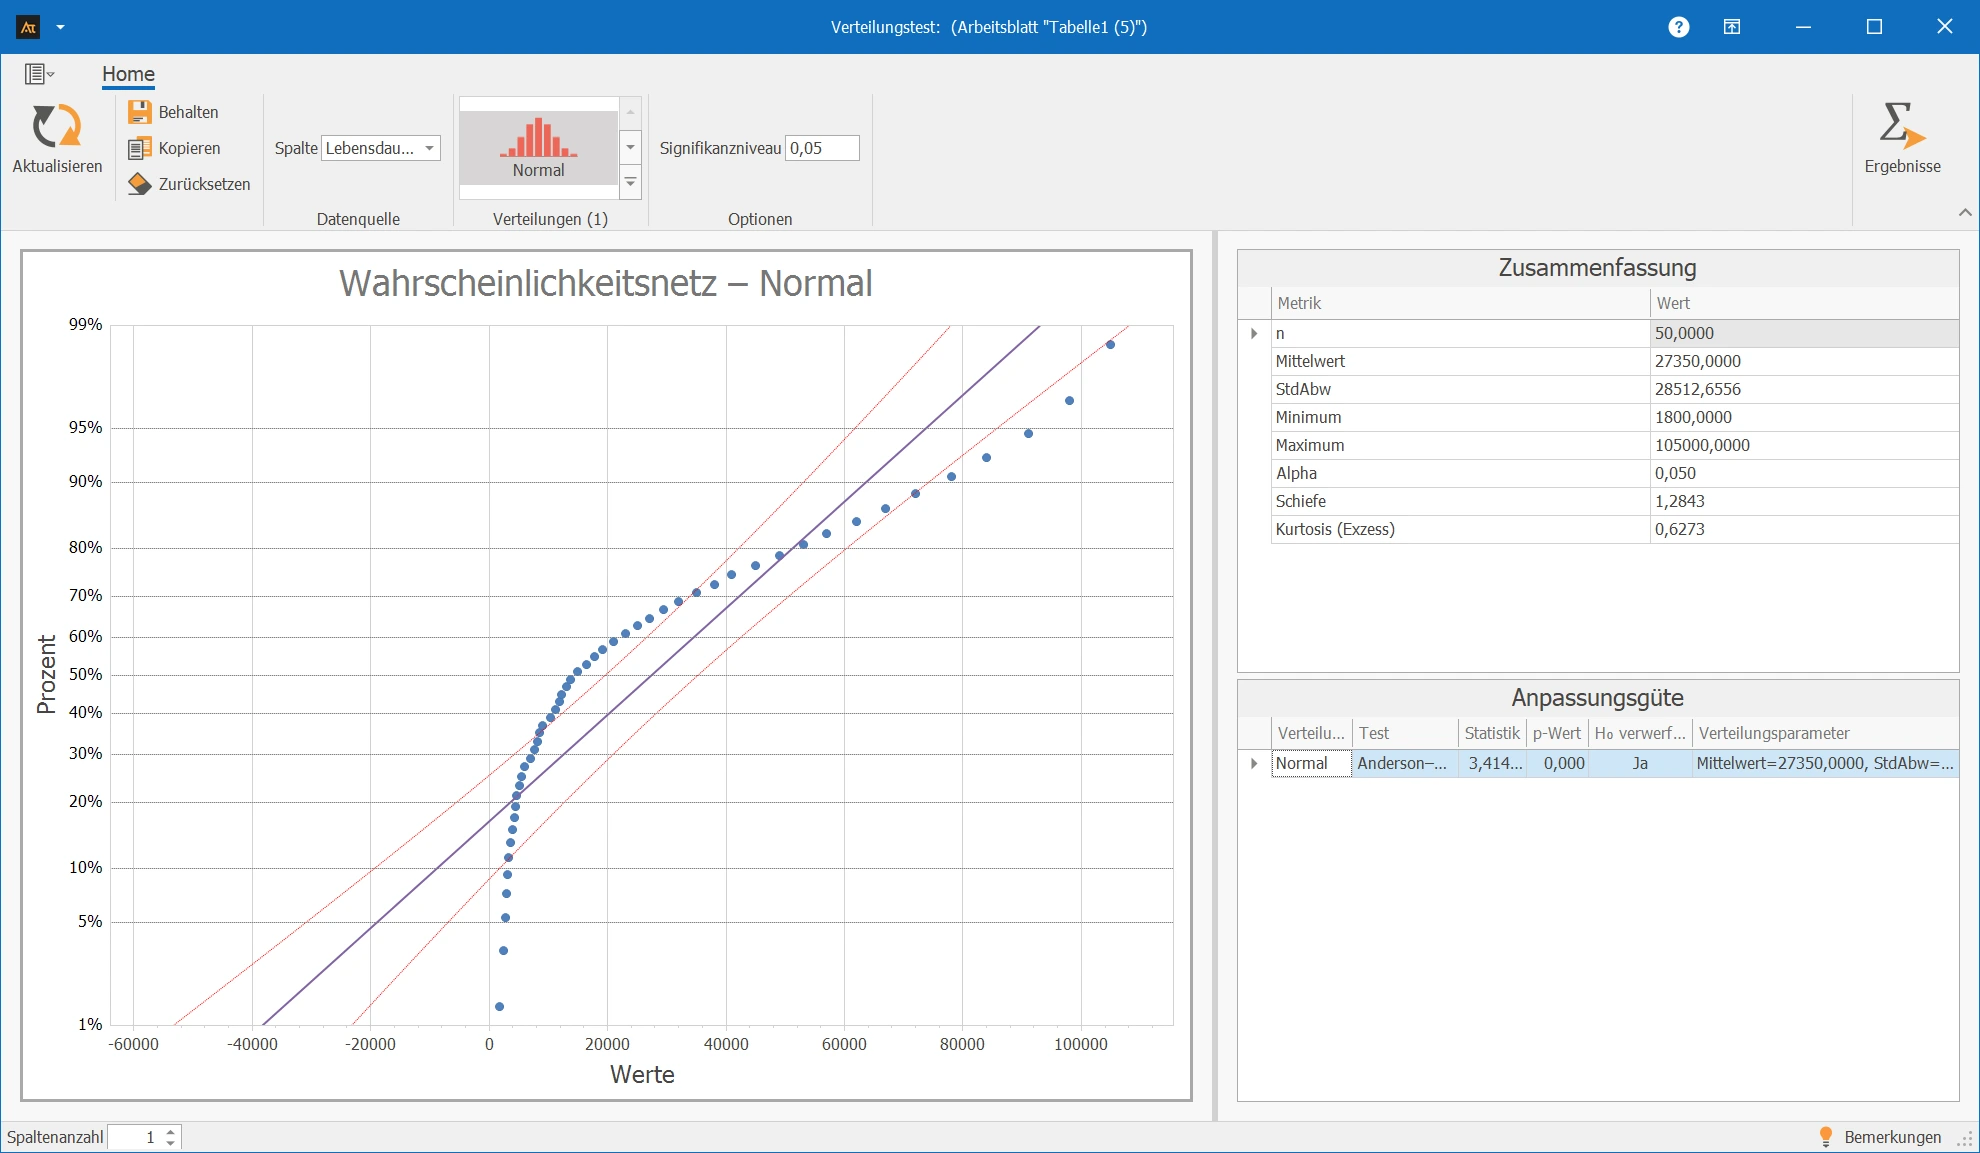
Im Wahrscheinlichkeitsnetz der Normalverteilung können die Punkte deutlich von der Geraden abweichen. Das spricht gegen eine normale Verteilung der Lebensdauern.
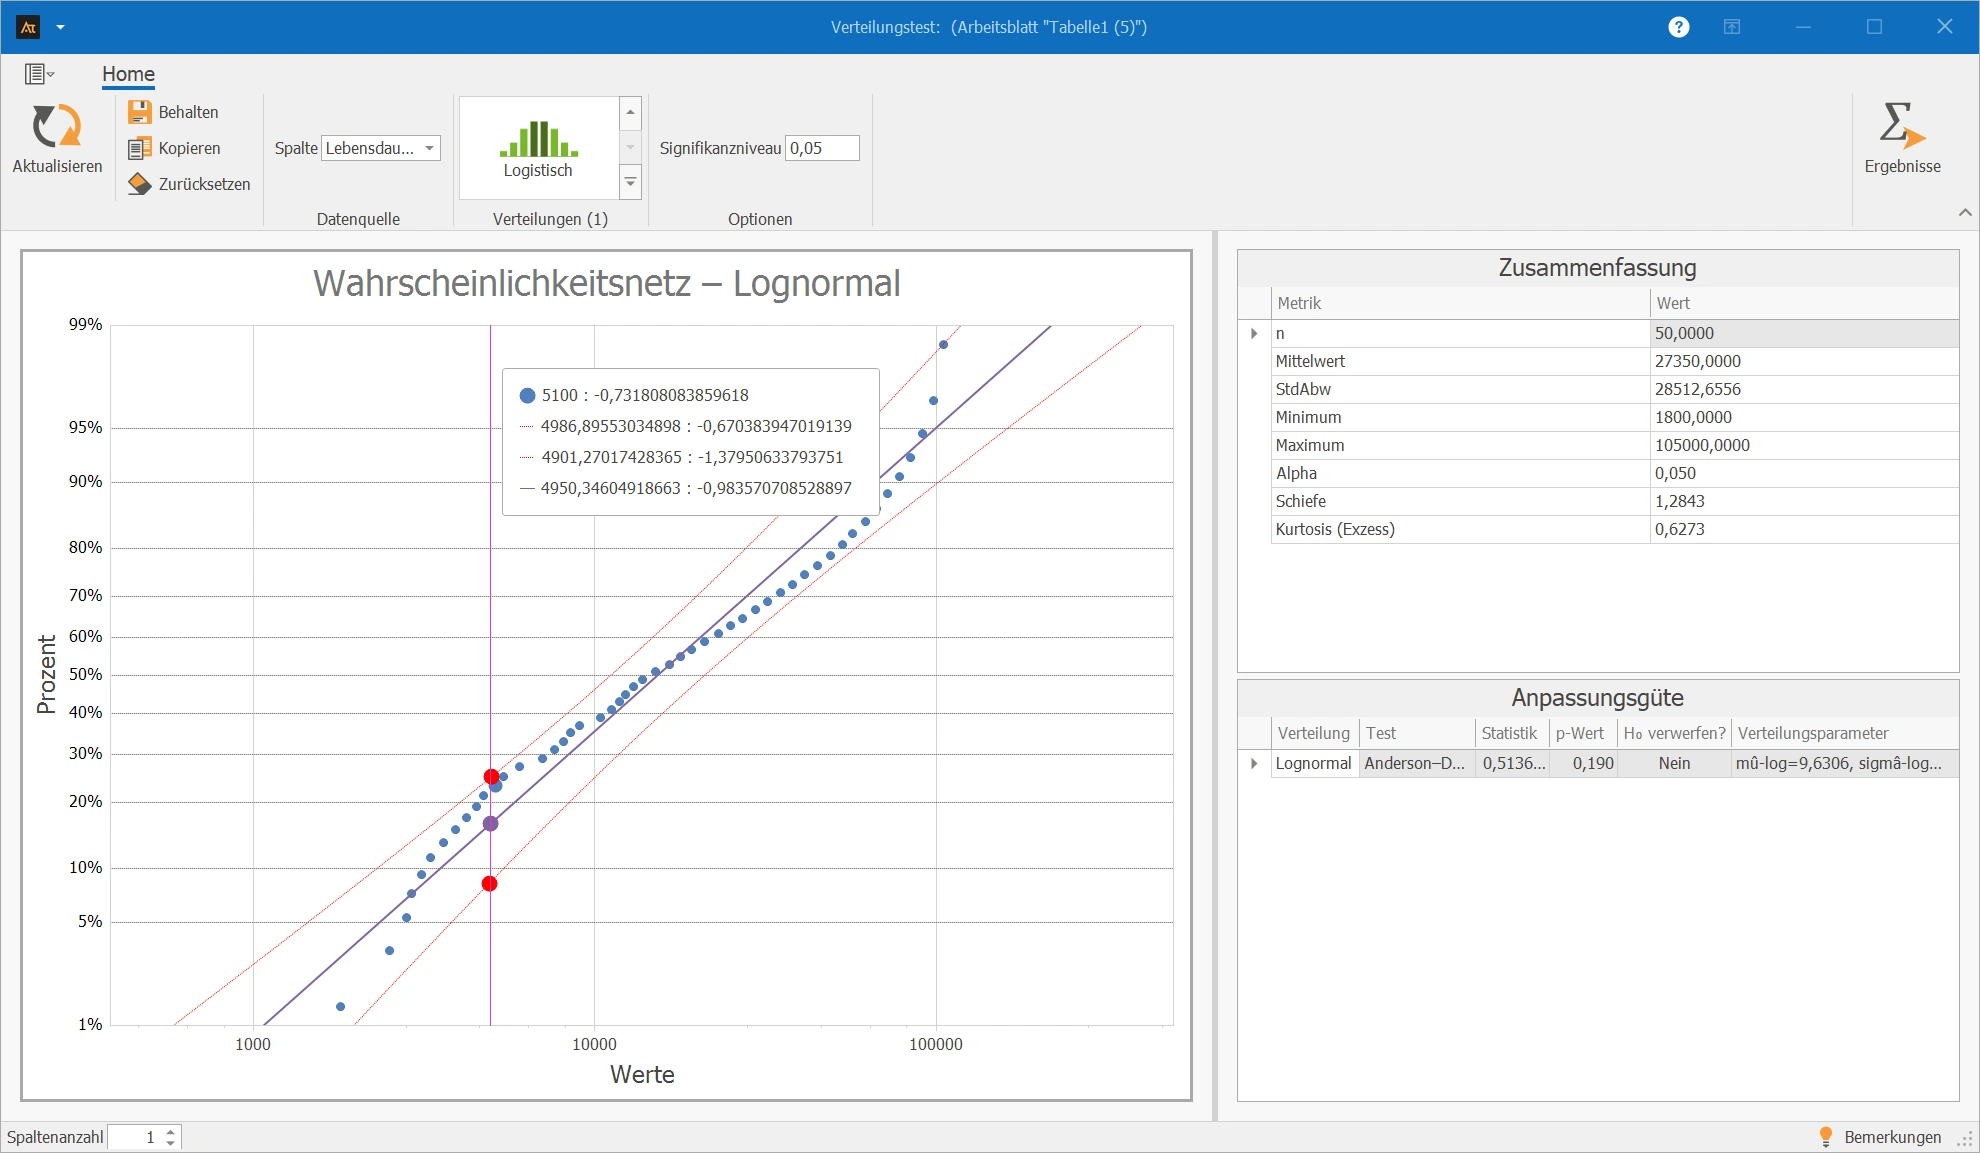
Die Lebensdauer der Kugellager wurde mit der Lognormalverteilung geprüft. Der p-Wert beträgt 0,190 und ist damit größer als 0,05. Die Lognormalverteilung wird daher nicht verworfen.
Auch im Wahrscheinlichkeitsnetz liegen die Punkte überwiegend nahe an der Geraden. Die Lebensdauerdaten können daher annähernd durch eine Lognormalverteilung beschrieben werden.
Stetige Daten: Daten, die mit einem Messmittel erfasst werden und Einheiten sowie Nachkommastellen besitzen können.
Verteilung: Mathematisches Modell, das beschreibt, wie Messwerte typischerweise streuen.
Anderson-Darling-Test: Statistischer Test zur Prüfung, ob Daten zu einer ausgewählten Verteilung passen.
p-Wert: Kennzahl zur Bewertung des Testergebnisses. Je kleiner der p-Wert, desto stärker sprechen die Daten gegen die getestete Verteilung.
A²-Statistik: Maß für die Abweichung der Daten von der getesteten Verteilung. Kleinere Werte sprechen tendenziell für geringere Abweichungen von der geprüften Verteilung.
H0: Nullhypothese des Tests. Sie lautet: Die Daten folgen der geprüften Verteilung.
n = Stichprobenumfang: Anzahl der gültigen Messwerte in der Stichprobe.
Mittelwert: Durchschnitt aller Messwerte. Er beschreibt die zentrale Lage der Daten.
Standardabweichung: Maß dafür, wie stark die Messwerte um den Mittelwert streuen. Eine kleine Standardabweichung bedeutet eine geringe Streuung, eine große Standardabweichung eine stärkere Streuung.
Minimum: Kleinster Messwert innerhalb der betrachteten Stichprobe.
Maximum: Größter Messwert innerhalb der betrachteten Stichprobe.
Alpha (α): Festgelegtes Signifikanzniveau und Entscheidungsgrenze für den p-Wert. Häufig wird α = 0,05 verwendet. Ist der p-Wert kleiner als Alpha, wird die Nullhypothese H0 verworfen.
Schiefe (Skewness): Kennzahl für die Symmetrie einer Verteilung. Ein Wert nahe 0 spricht für eine annähernd symmetrische Verteilung. Positive oder negative Werte zeigen eine stärkere Ausprägung der Verteilung nach rechts beziehungsweise links.
Kurtosis: Kennzahl, die die Form einer Verteilung beschreibt, insbesondere wie stark sich Messwerte im Zentrum und in den Randbereichen konzentrieren. Sie kann Hinweise darauf geben, ob eine Verteilung im Vergleich zu einer Normalverteilung eher spitz oder flach ausgeprägt ist.
Der Verteilungstest berechnet für die ausgewählten Verteilungen die entsprechenden Parameter, die Teststatistik und den p-Wert. Für die Berechnung der Teststatistik werden Funktionen aus der Bibliothek Numerics.NET verwendet.