

Lo strumento di test di distribuzione viene utilizzato per confrontare una serie di dati selezionata con diverse distribuzioni teoriche. Aiuta a identificare quale distribuzione descrive meglio le misurazioni e se i dati sono adatti per ulteriori analisi statistiche con un'ipotesi di distribuzione specifica.
Il risultato non è una "prova" definitiva per una distribuzione. Un alto valore p significa semplicemente che il test di Anderson-Darling non trova una deviazione statisticamente significativa dalla distribuzione scelta. La plausibilità tecnica, il riferimento al processo e la rete di probabilità devono sempre essere considerati.

Durante la produzione della salsa di pomodoro, i valori di viscosità vengono registrati regolarmente. La viscosità descrive quanto è densa la salsa. È importante affinché il prodotto possa essere riempito uniformemente e abbia sempre la stessa consistenza per il cliente.
Prima di condurre ulteriori analisi, dovrebbe essere verificato quale delle distribuzioni selezionate può descrivere in modo significativo i valori di viscosità misurati. A tal fine, i dati vengono confrontati con i test di distribuzione per le distribuzioni Normale, Lognormale, Loglogistica e Logistica.
Spiega dei risultati:
Grafici di probabilità
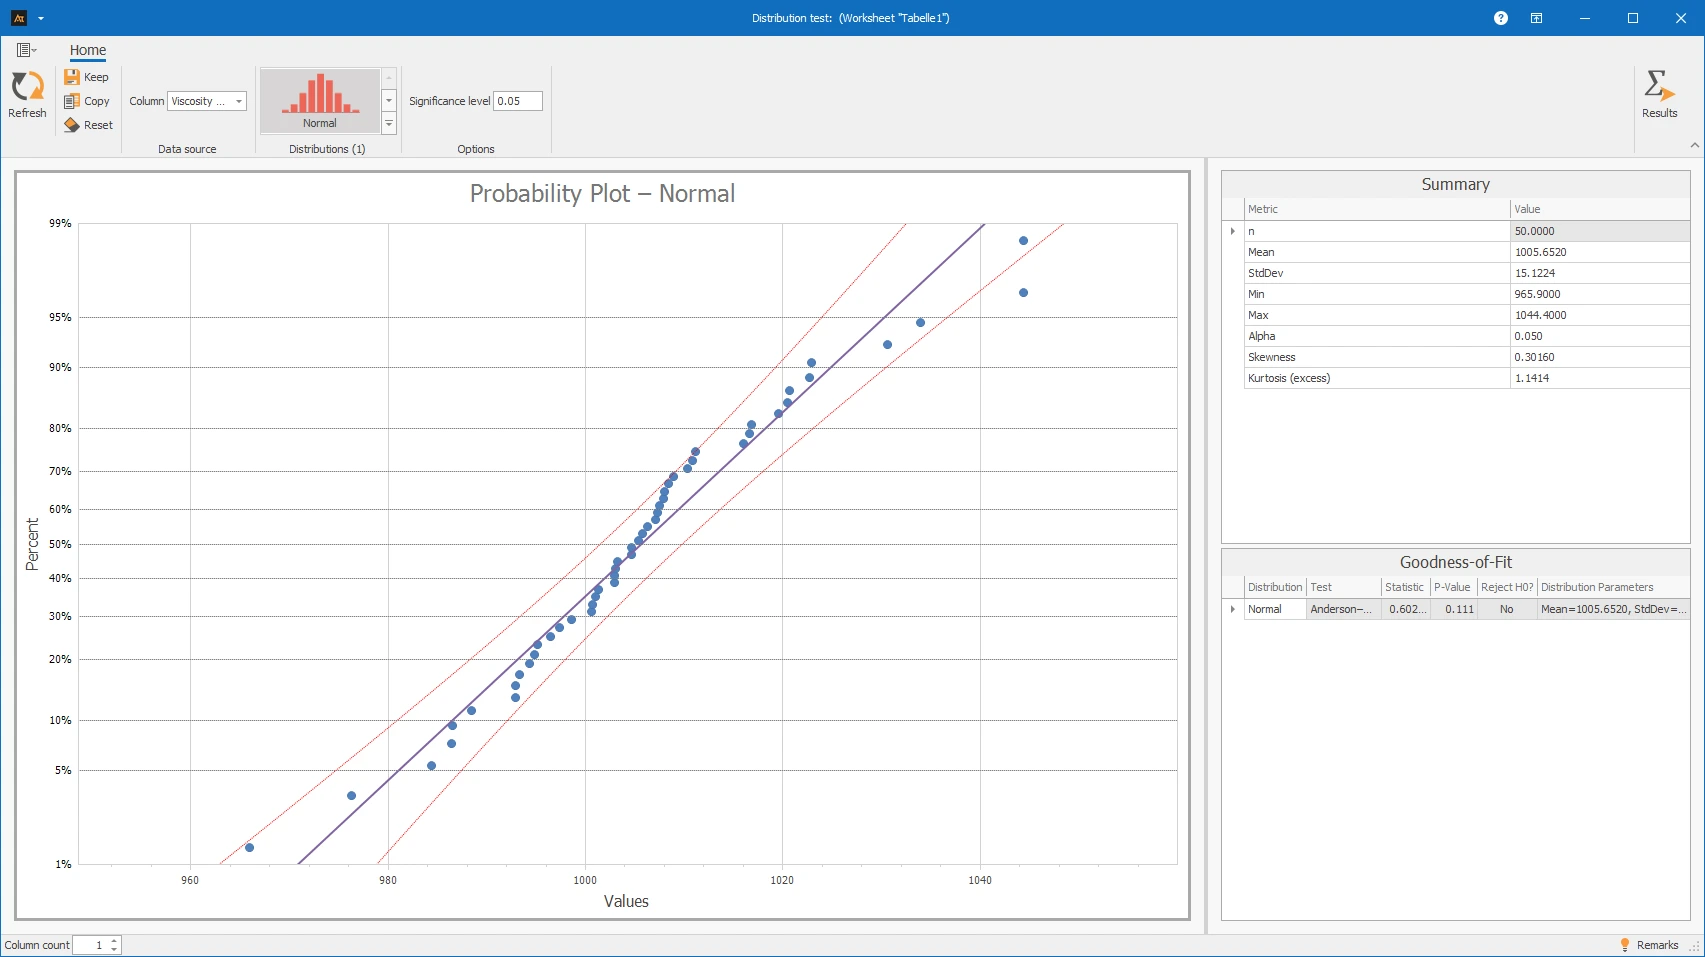
Per ogni distribuzione calcolata con successo, il test di distribuzione genera il proprio grafico di probabilità. In esso, i valori misurati ordinati vengono confrontati con i valori che ci si aspetterebbe sotto la rispettiva distribuzione teorica.
- Se i punti sono vicini alla linea tracciata, la distribuzione scelta si adatta bene ai dati. Più i punti si discostano dalla linea, peggio questa distribuzione descrive i dati.
- Modelli curvi, forme a S, outlier significativi o deviazioni nelle aree di bordo indicano che i dati non si adattano bene alla distribuzione testata.
- Quando si confrontano più distribuzioni, non solo il p-value dovrebbe essere considerato. È anche importante se il grafico di probabilità mostra un modello plausibile e calmo e se la distribuzione si adatta tecnicamente alla caratteristica.
La linea può essere intesa come un modello: Più i punti si adattano al modello della distribuzione, più questa distribuzione è adatta come modello per i dati.
Test di Anderson-Darling
Il test di distribuzione utilizza il test di Anderson-Darling come test di bontà di adattamento computazionale. Il test verifica se i valori misurati si adattano alla distribuzione selezionata. Viene eseguito per tutte le distribuzioni supportate che possono essere calcolate con i dati disponibili.
Il test fornisce una statistica di test e un p-value per ciascuna distribuzione:
- p-value maggiore di alfa: Non ci sono prove statistiche che i dati si discostino da questa distribuzione. → La distribuzione può essere considerata un modello possibile.
- p-value minore o uguale ad alfa: Il test trova deviazioni significative. → L'ipotesi nulla è respinta; la distribuzione testata non si adatta statisticamente ai dati in modo sufficiente.
Perché viene utilizzato il test di Anderson-Darling? È particolarmente sensibile alle deviazioni nelle aree di bordo della distribuzione. Qui si verificano spesso outlier o valori estremi, che sono importanti per le analisi di qualità, processo e durata.
Interpretazione dei risultati:
I valori di viscosità sono stati confrontati con le distribuzioni Normale, Lognormale, Loglogistica e Logistica. Per tutte e quattro le distribuzioni, il p-value è maggiore di 0,05. Pertanto, l'ipotesi nulla non è respinta per nessuna distribuzione. Non ci sono prove statistiche che i dati si discostino significativamente da una delle distribuzioni testate.
I grafici di probabilità mostrano anche che i punti si trovano per lo più vicino alle linee. Pertanto, i valori di viscosità possono essere approssimativamente descritti con le distribuzioni testate.
Tuttavia, il risultato non consente una conclusione definitiva che una di queste distribuzioni sia chiaramente la migliore. La selezione della distribuzione dovrebbe quindi basarsi anche sulla plausibilità tecnica e sull'analisi ulteriore pianificata. Poiché la viscosità è una misura continua e i dati sono approssimativamente distribuiti simmetricamente attorno alla media, la distribuzione normale può essere una scelta sensata e ben giustificata per molte ulteriori valutazioni standard.
I seguenti sono le considerazioni e i passaggi necessari per testare una serie di dati contro più distribuzioni con Best Fit.
Preparazione
- Seleziona una misura numerica appropriata.
- Raccogli le misurazioni.
- Seleziona le distribuzioni, ad esempio, Weibull, Gamma, Lognormale.
 Usa in AlphadiTab
- Seleziona lo strumento Test di Distribuzione nella Fase di Misurazione.
- Seleziona la serie di dati da testare e attiva una o più distribuzioni nella galleria delle distribuzioni.
- Verifica o regola il livello di significatività.
- Esegui l'analisi con Aggiorna.
Interpretazione
Quindi verifica per ciascuna distribuzione selezionata se è adatta a descrivere le misurazioni.
- p-value: Se il p-value è maggiore di 0.05, non ci sono prove statistiche di una deviazione dalla distribuzione. I dati possono quindi essere considerati approssimativamente adatti alla distribuzione.
- Probability plot: Se i punti sono per lo più vicini alla linea tracciata, la distribuzione scelta è un modello plausibile per i dati.
Le seguenti distribuzioni sono disponibili nello strumento:
Distribuzione Normale
La distribuzione normale è una distribuzione simmetrica a forma di campana. Si verifica spesso in misurazioni che derivano da molte piccole influenze casuali. Esempi includono dimensioni, pesi, quantità di riempimento o valori di processo.
Tipicamente, la maggior parte dei valori è vicina alla media, e grandi deviazioni verso l'alto o verso il basso diventano più rare. Se i dati si adattano bene alla distribuzione normale, possono essere utilizzati molti metodi statistici classici.
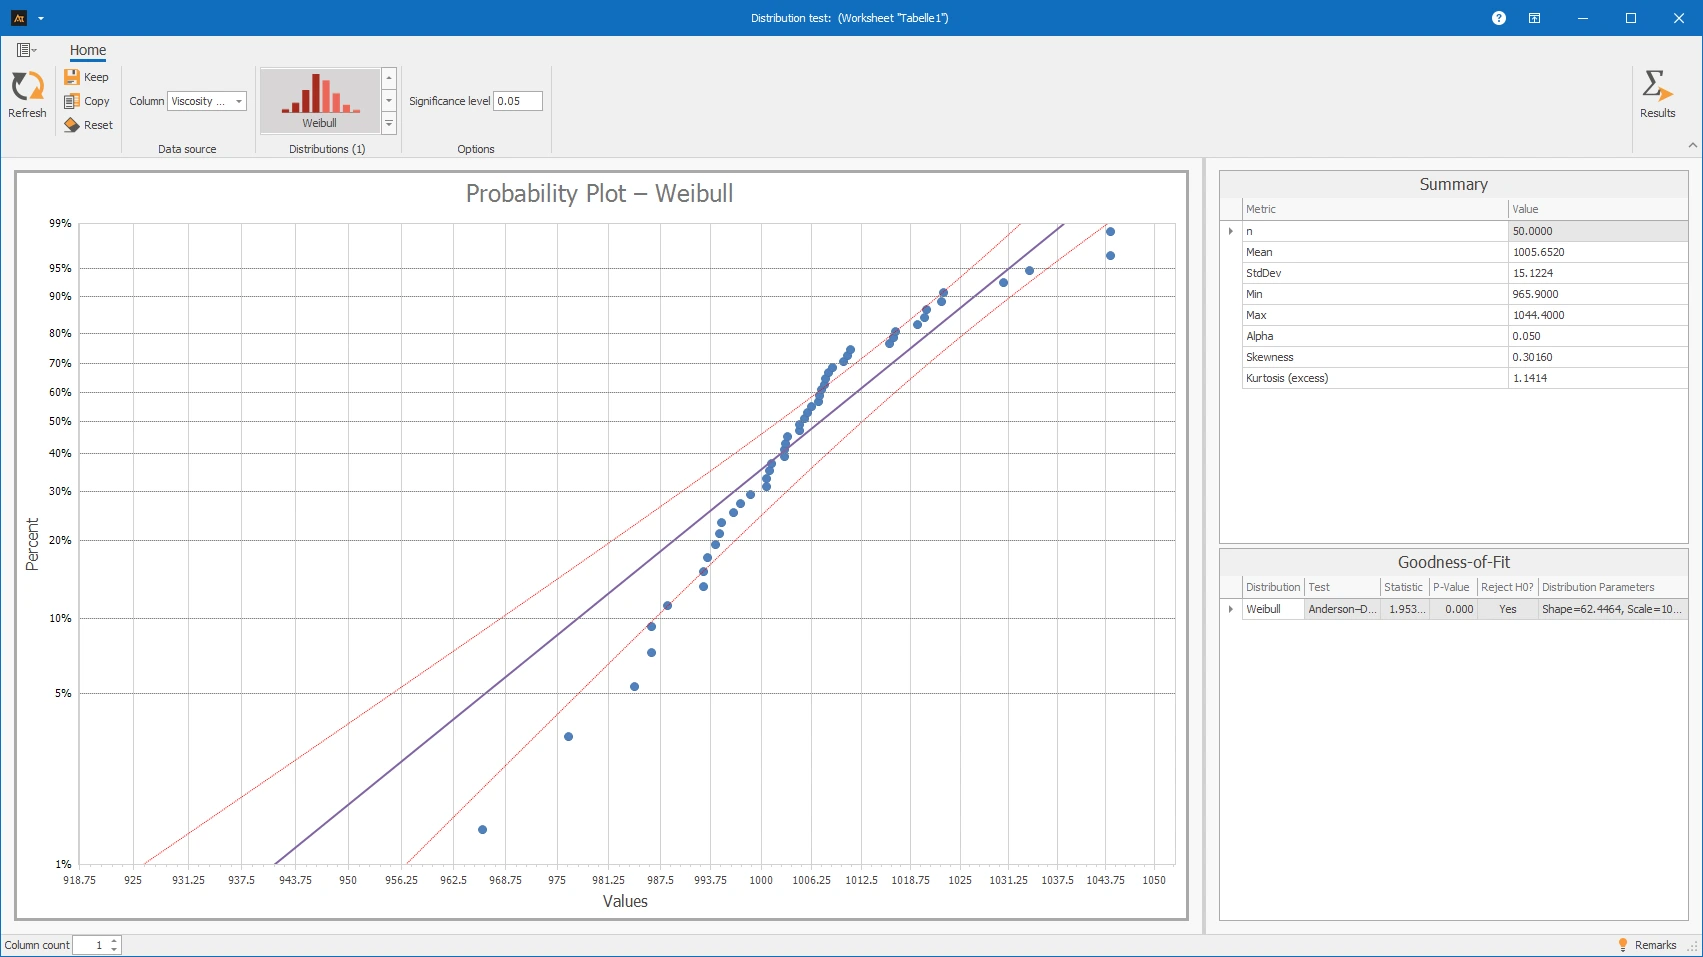
Distribuzione di Weibull
La distribuzione di Weibull è spesso utilizzata per dati di durata, guasto e affidabilità. È particolarmente adatta quando si verificano solo valori positivi, come i tempi di funzionamento fino al guasto.
A seconda del parametro di forma, la distribuzione di Weibull può rappresentare diversi andamenti. Questo la rende molto flessibile e spesso utilizzata per descrivere durate tecniche, comportamento di usura o probabilità di guasto.
Distribuzione Esponenziale
La distribuzione esponenziale descrive i tempi di attesa o i tempi fino al prossimo evento. È spesso utilizzata quando gli eventi si verificano in modo casuale e indipendente l'uno dall'altro.
Esempi tipici sono i tempi di attesa, i tempi di reazione o i modelli di inattività semplici. La distribuzione inizia da zero e poi diminuisce costantemente. È adatta solo per valori maggiori o uguali a zero.
Distribuzione Log-logistica
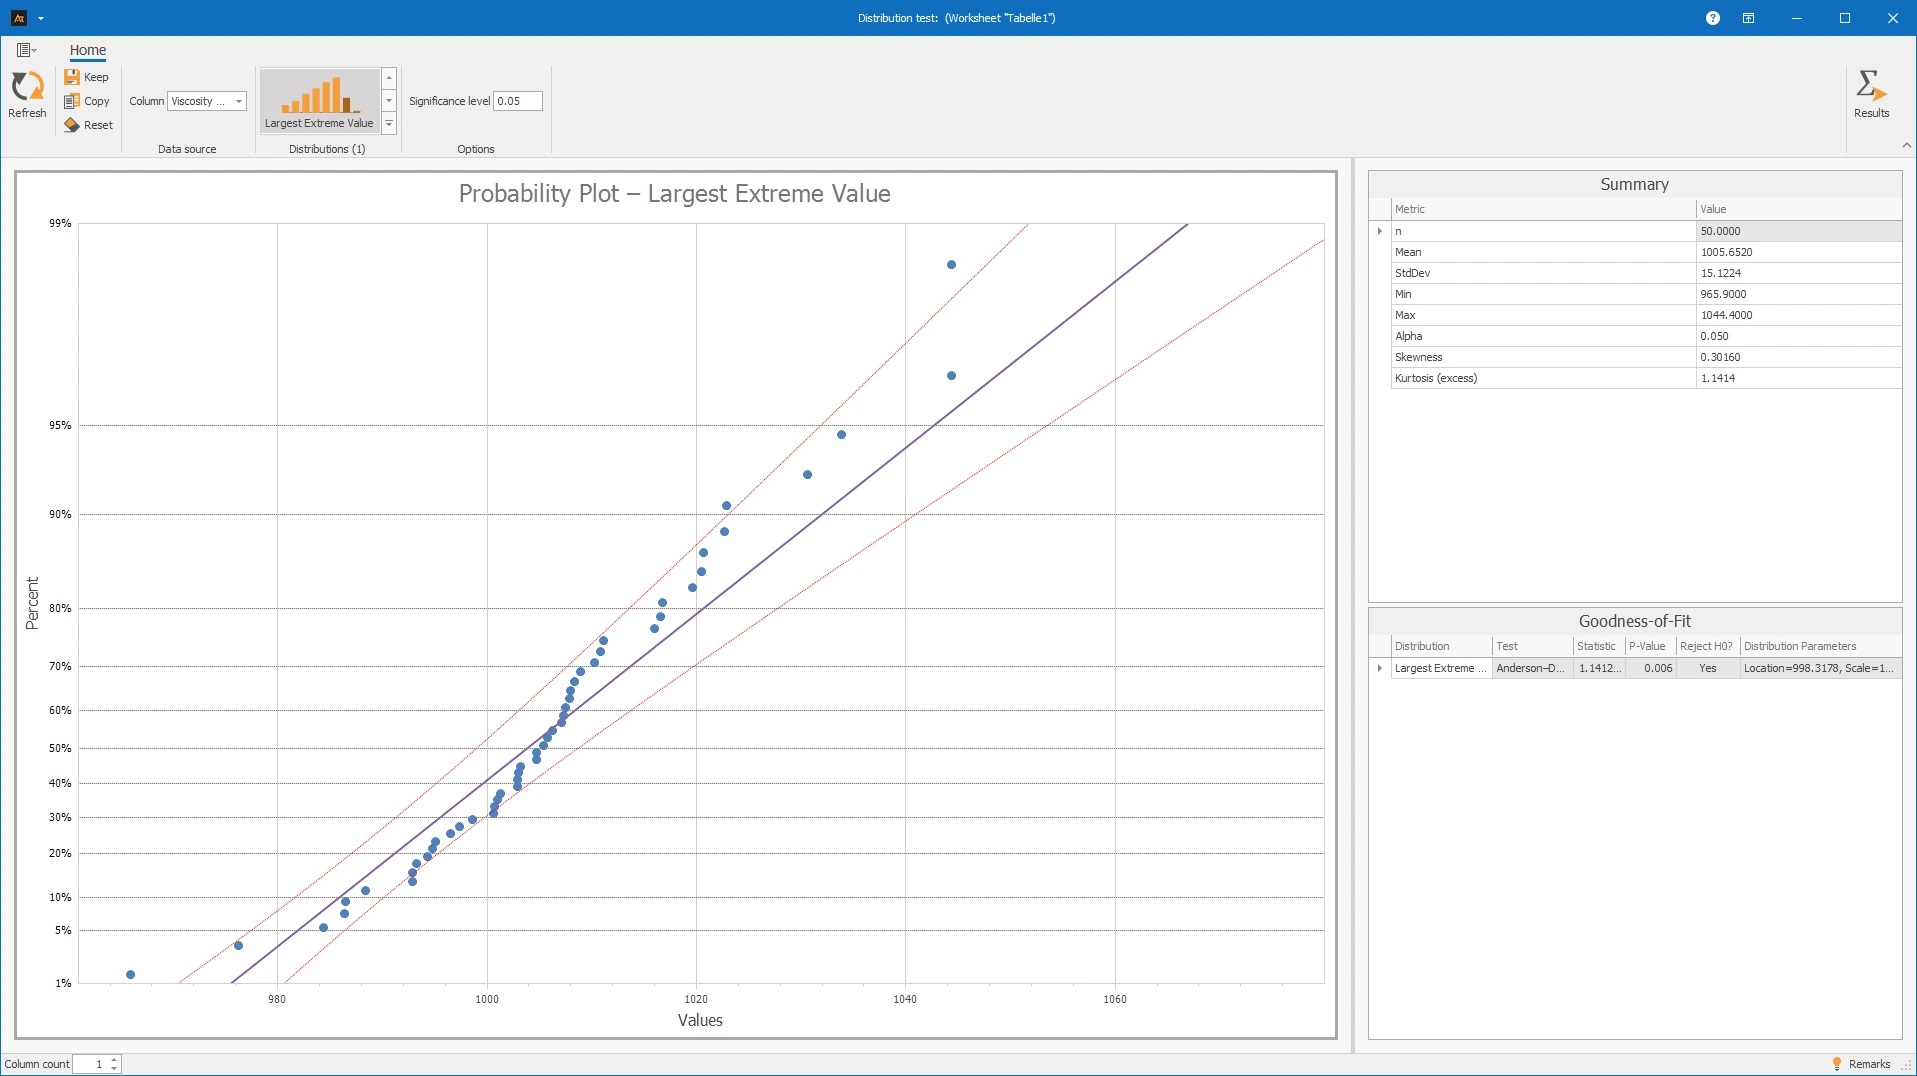
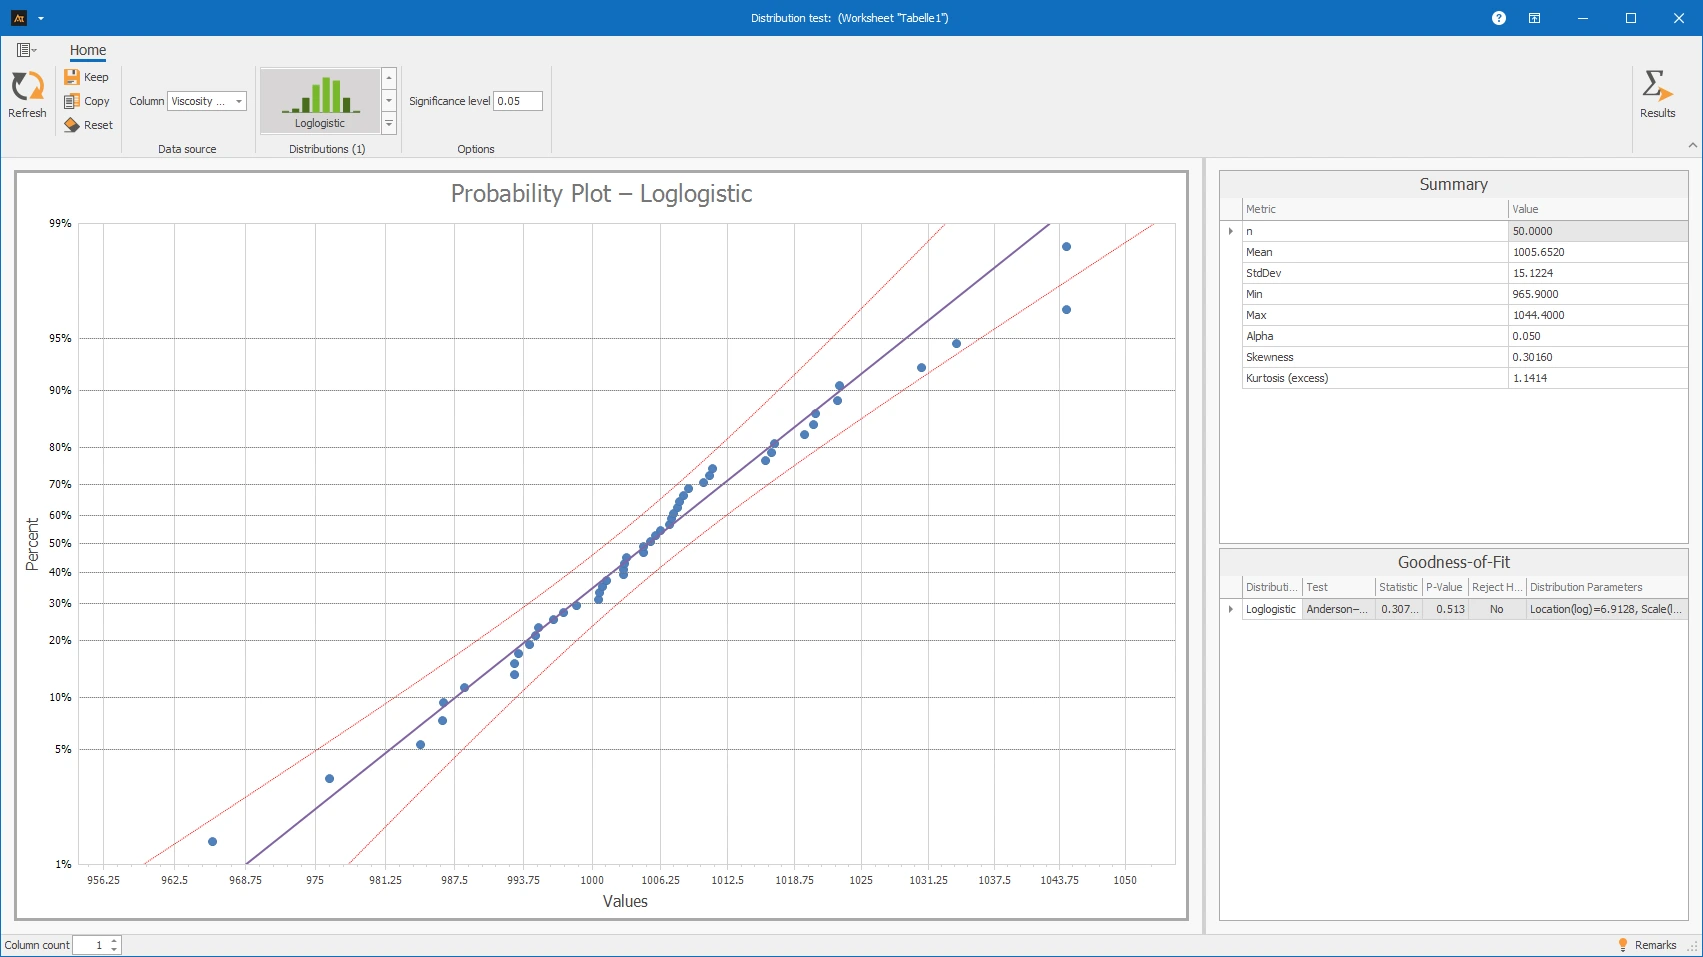
La distribuzione log-logistica è adatta per dati positivi e asimmetrici a destra. È spesso utilizzata per dati di durata, tempo o processo in cui si verificano molti valori più piccoli e alcuni valori significativamente più grandi.
In alcuni casi, assomiglia alla distribuzione lognormale ma può rappresentare espressioni più forti nella coda destra. Questo la rende utile quando tempi di elaborazione lunghi o guasti tardivi pesano di più.
Distribuzione Gamma
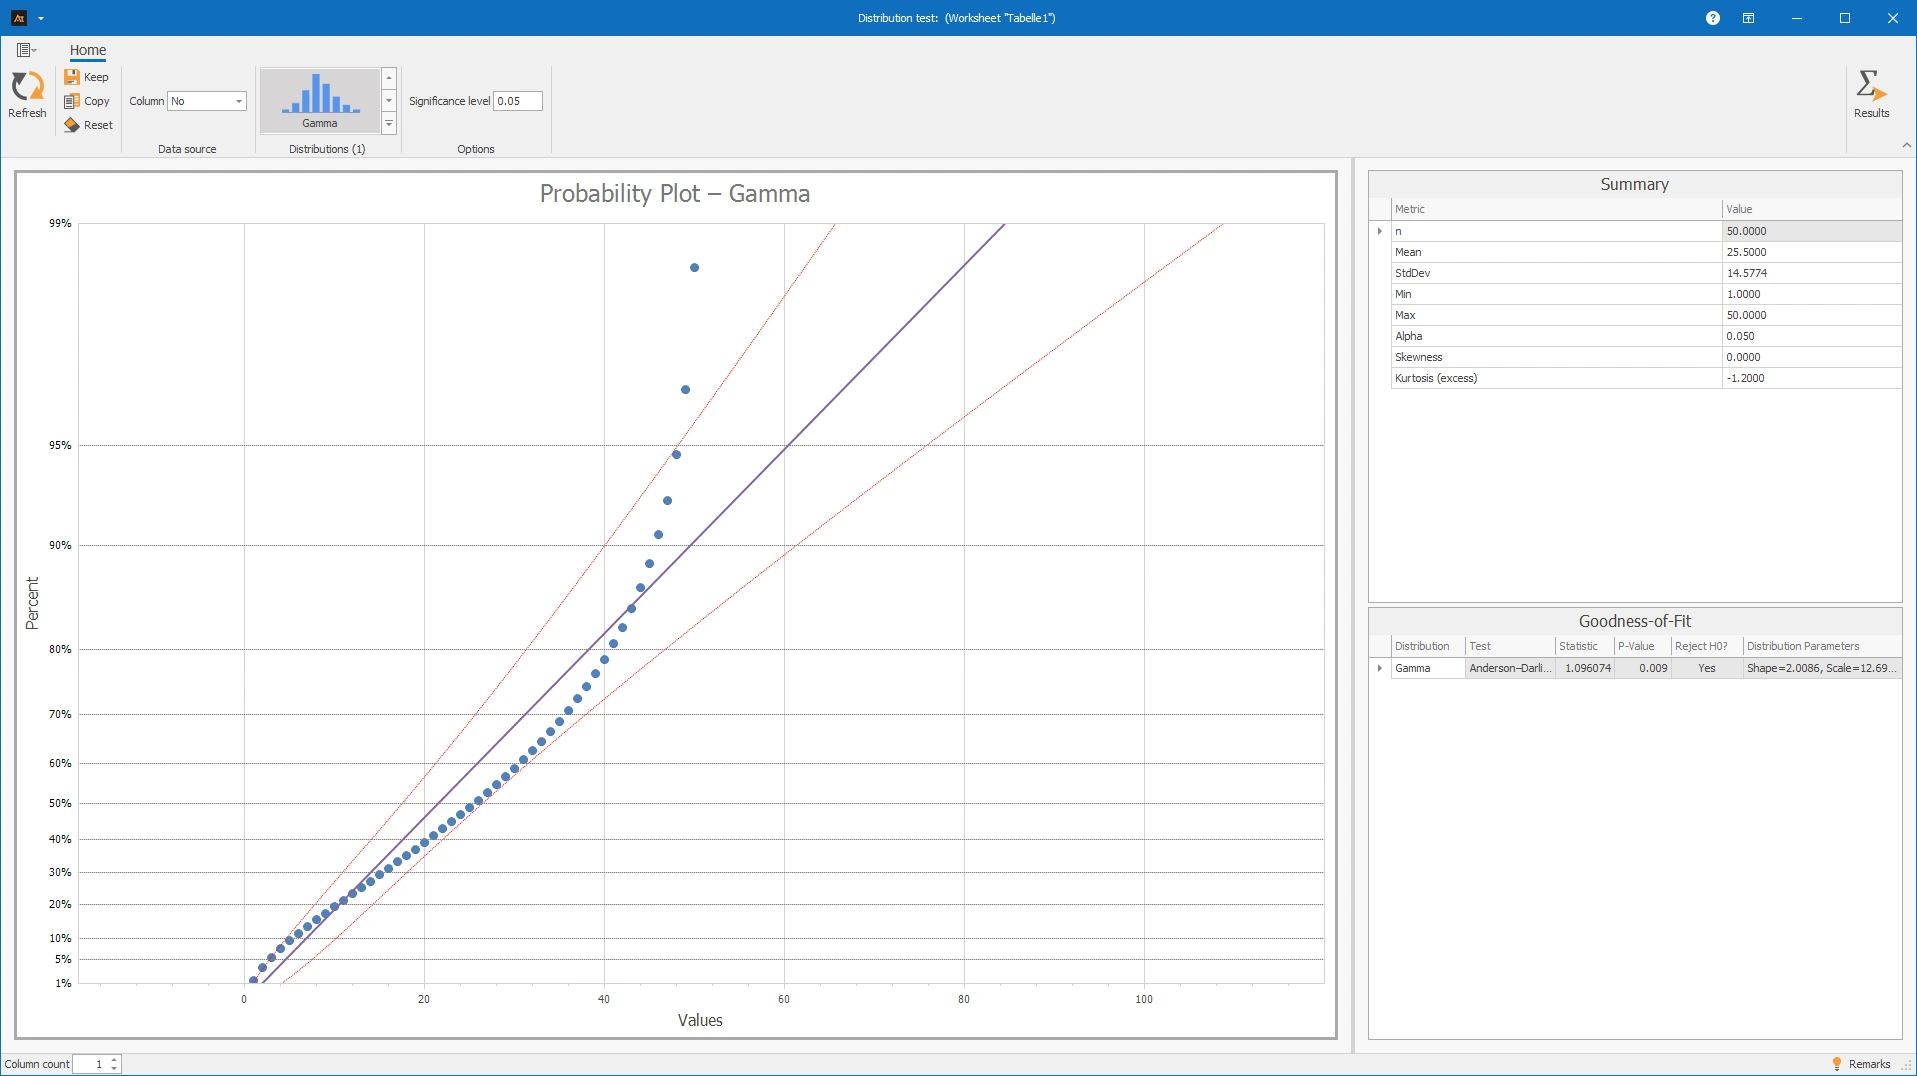
La distribuzione gamma è utilizzata per dati positivi e asimmetrici a destra. È adatta per misurazioni come tempi di attesa, tempi di attraversamento, quantità o carichi, a condizione che non possano verificarsi valori negativi.
È più flessibile della distribuzione esponenziale perché può assumere forme diverse. Questo le consente di descrivere bene sia dati altamente asimmetrici che moderatamente asimmetrici.
Distribuzione Lognormale
La distribuzione lognormale si verifica quando i valori logaritmici sono approssimativamente distribuiti normalmente. È utilizzata per dati positivi che sono asimmetrici a destra.
Esempi tipici sono tempi, durate, concentrazioni, costi o altre quantità in cui possono verificarsi valori individuali molto grandi. Se i dati non sono distribuiti normalmente, una distribuzione lognormale può spesso adattarsi meglio.
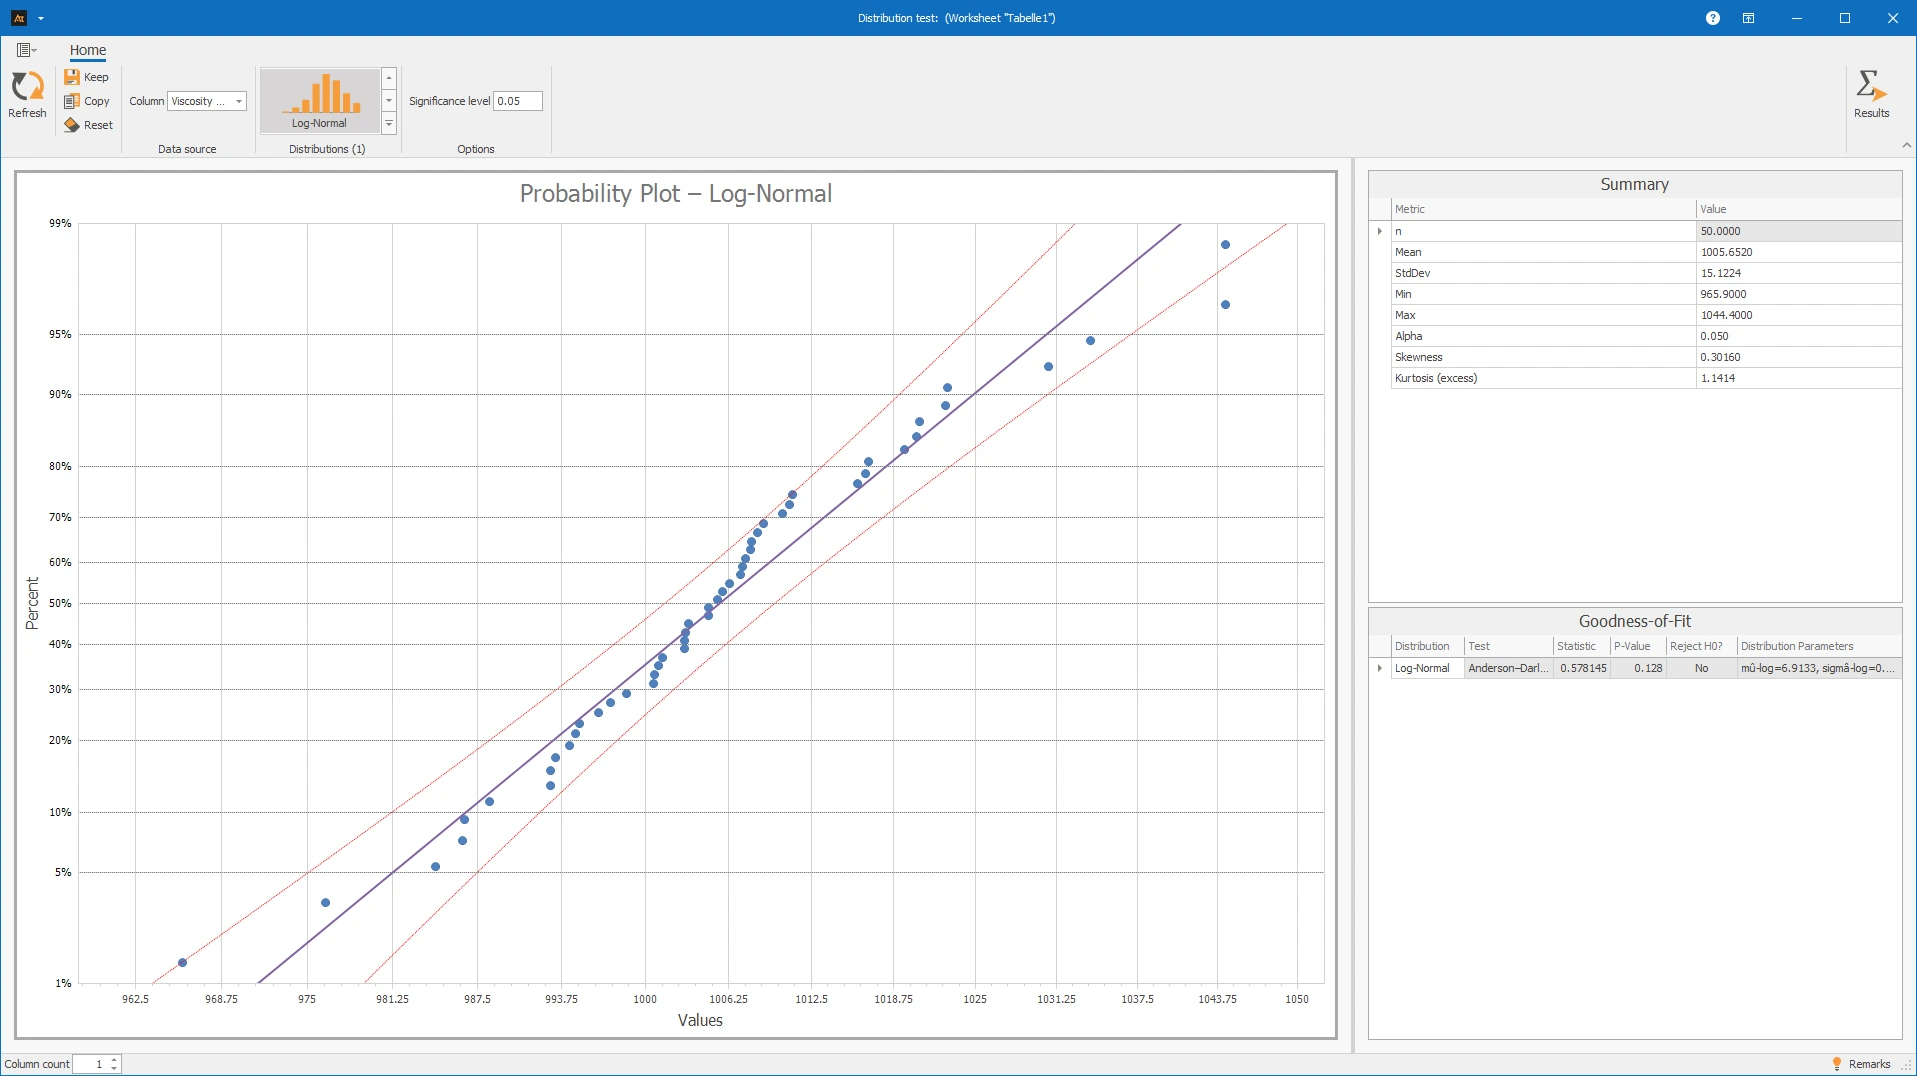
Distribuzione Logistica
La distribuzione logistica è simmetrica e assomiglia alla distribuzione normale. Tuttavia, ha code leggermente più forti, permettendo che i valori estremi si verifichino un po' più frequentemente rispetto alla distribuzione normale.
Può essere utilizzata quando i dati sono generalmente distribuiti simmetricamente, ma la distribuzione normale non descrive sufficientemente bene le code.
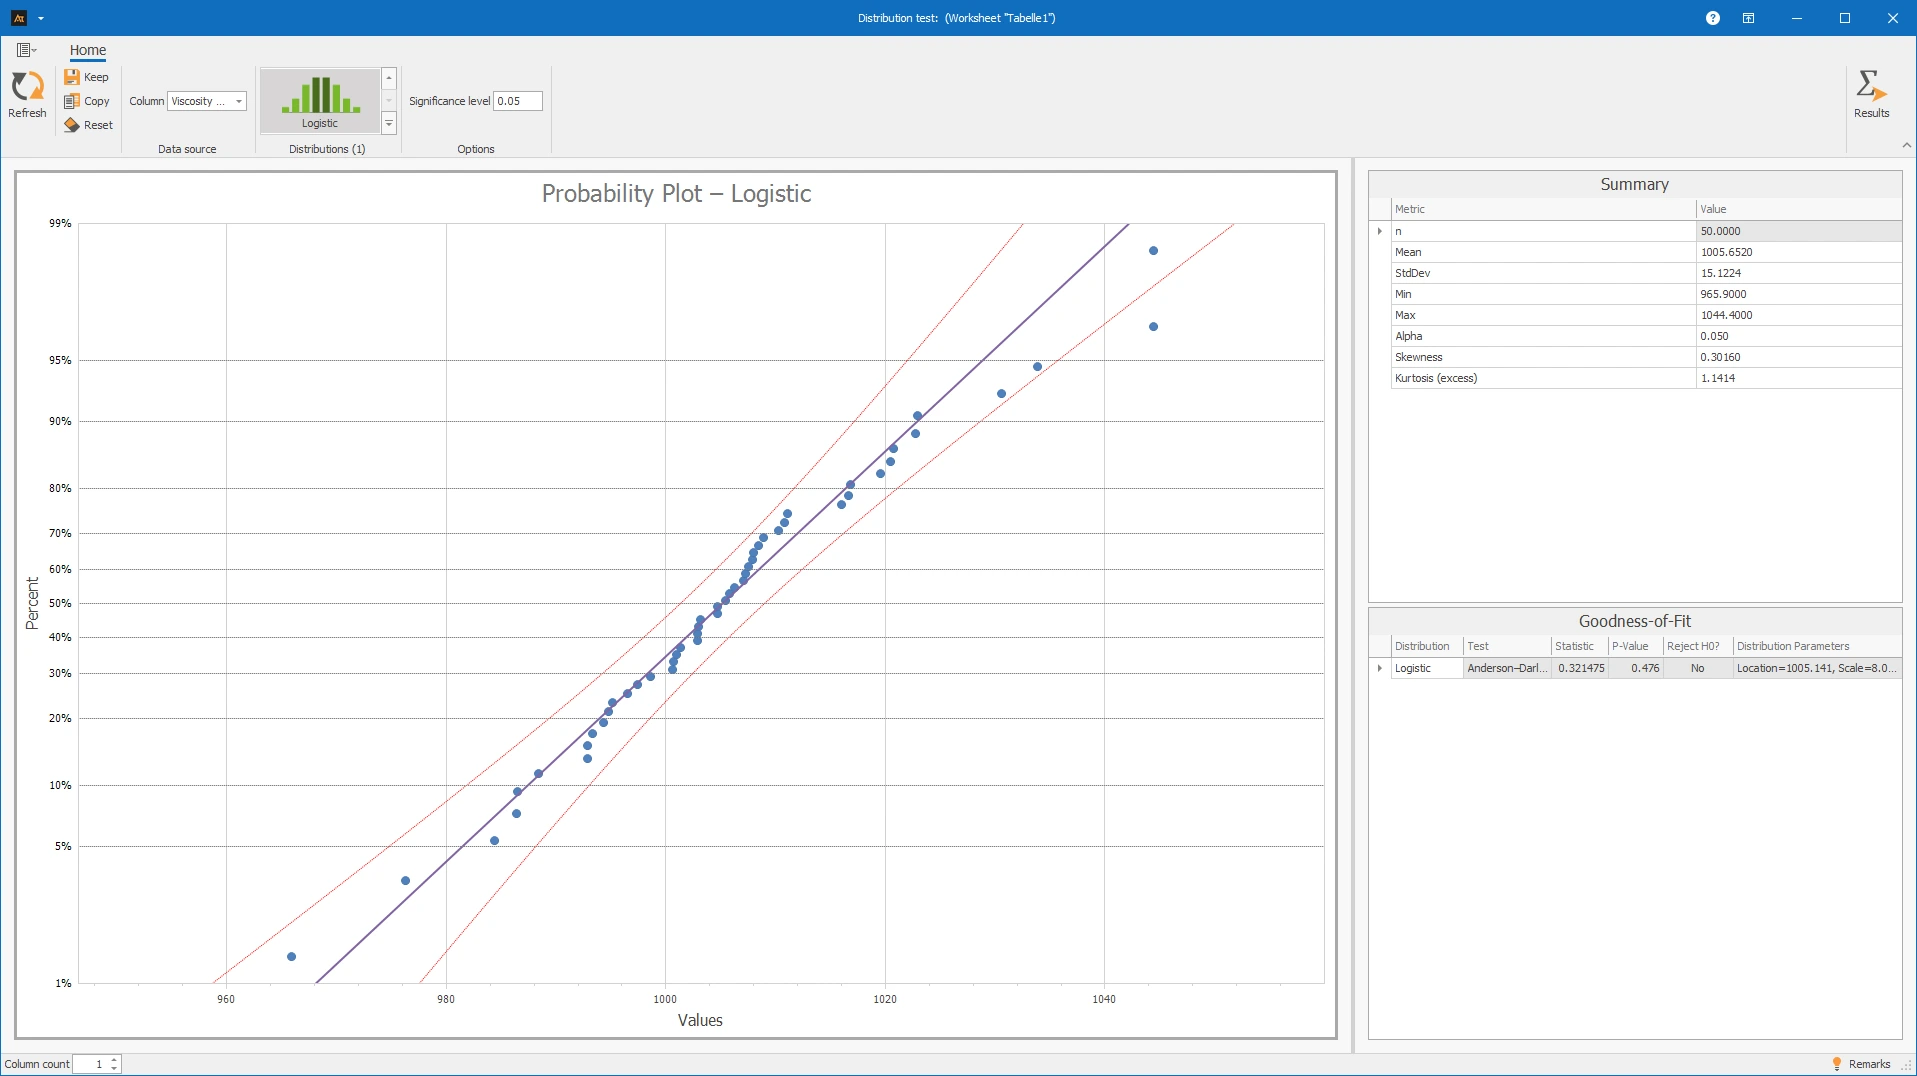
Distribuzione di Gumbel
La distribuzione di Gumbel descrive i valori massimi. È utilizzata quando i valori particolarmente alti sono al centro dell'attenzione, come carichi massimi, temperature di picco, tempi di attesa massimi o valori di picco.
È adatta quando non è il valore medio tipico, ma il comportamento delle osservazioni più grandi è importante.
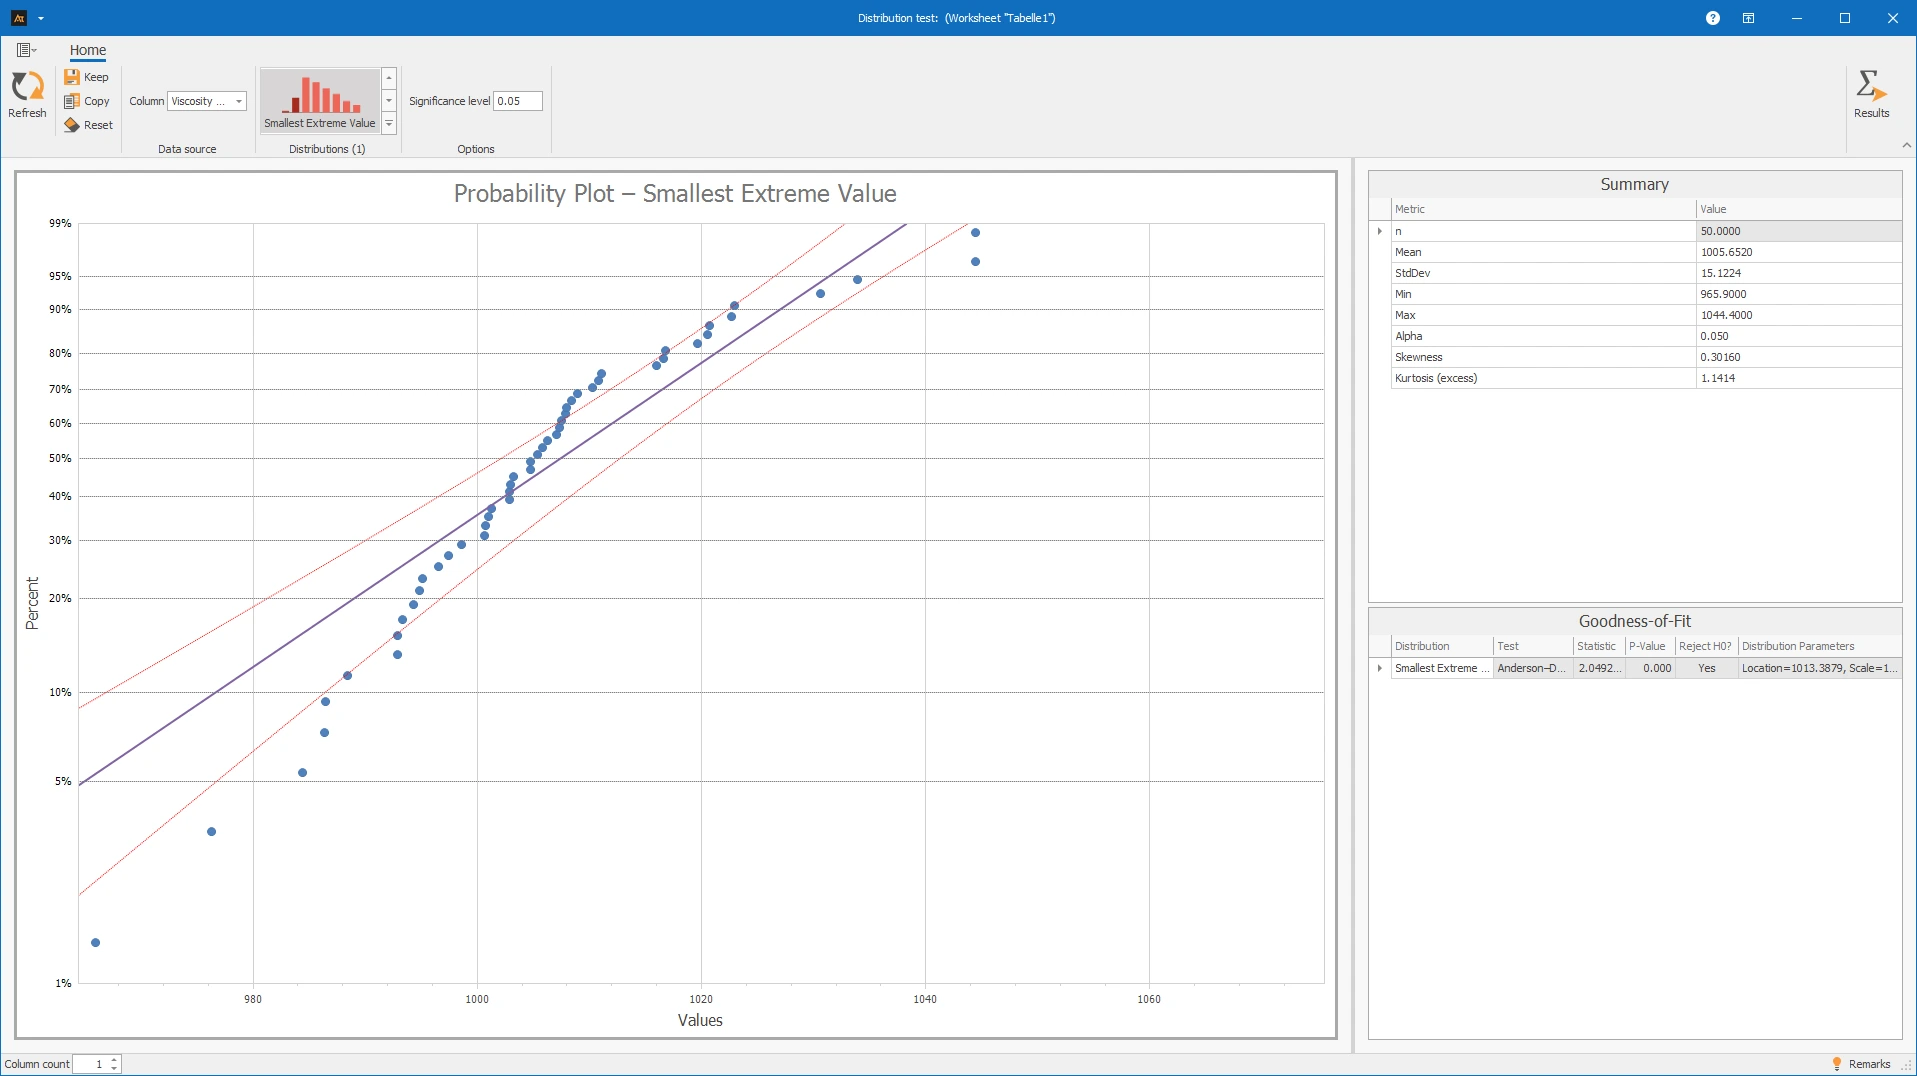
Distribuzione del Valore Estremo Minimo
La distribuzione del valore estremo minimo descrive i valori minimi. È utilizzata quando i valori particolarmente piccoli sono al centro dell'attenzione, come le resistenze minime, le durate di vita più basse o i guasti più precoci.
È utile quando è necessario valutare il rischio derivante da misurazioni molto piccole, ad esempio nei limiti di sicurezza o nei requisiti minimi.
Per i dati nominali o ordinali, il test di distribuzione non è significativo, poiché questi tipi di dati non possono essere descritti da distribuzioni continue come normale, Weibull o gamma.
Per i dati di conteggio puro o eventi discreti, dovrebbe essere verificato se un metodo specifico per distribuzioni discrete è più adatto. Il test di distribuzione è progettato per le distribuzioni continue supportate nello strumento.
Il test di distribuzione è più adatto quando si vogliono confrontare tra loro diverse distribuzioni possibili.
Quantità di riempimento salsa di pomodoro
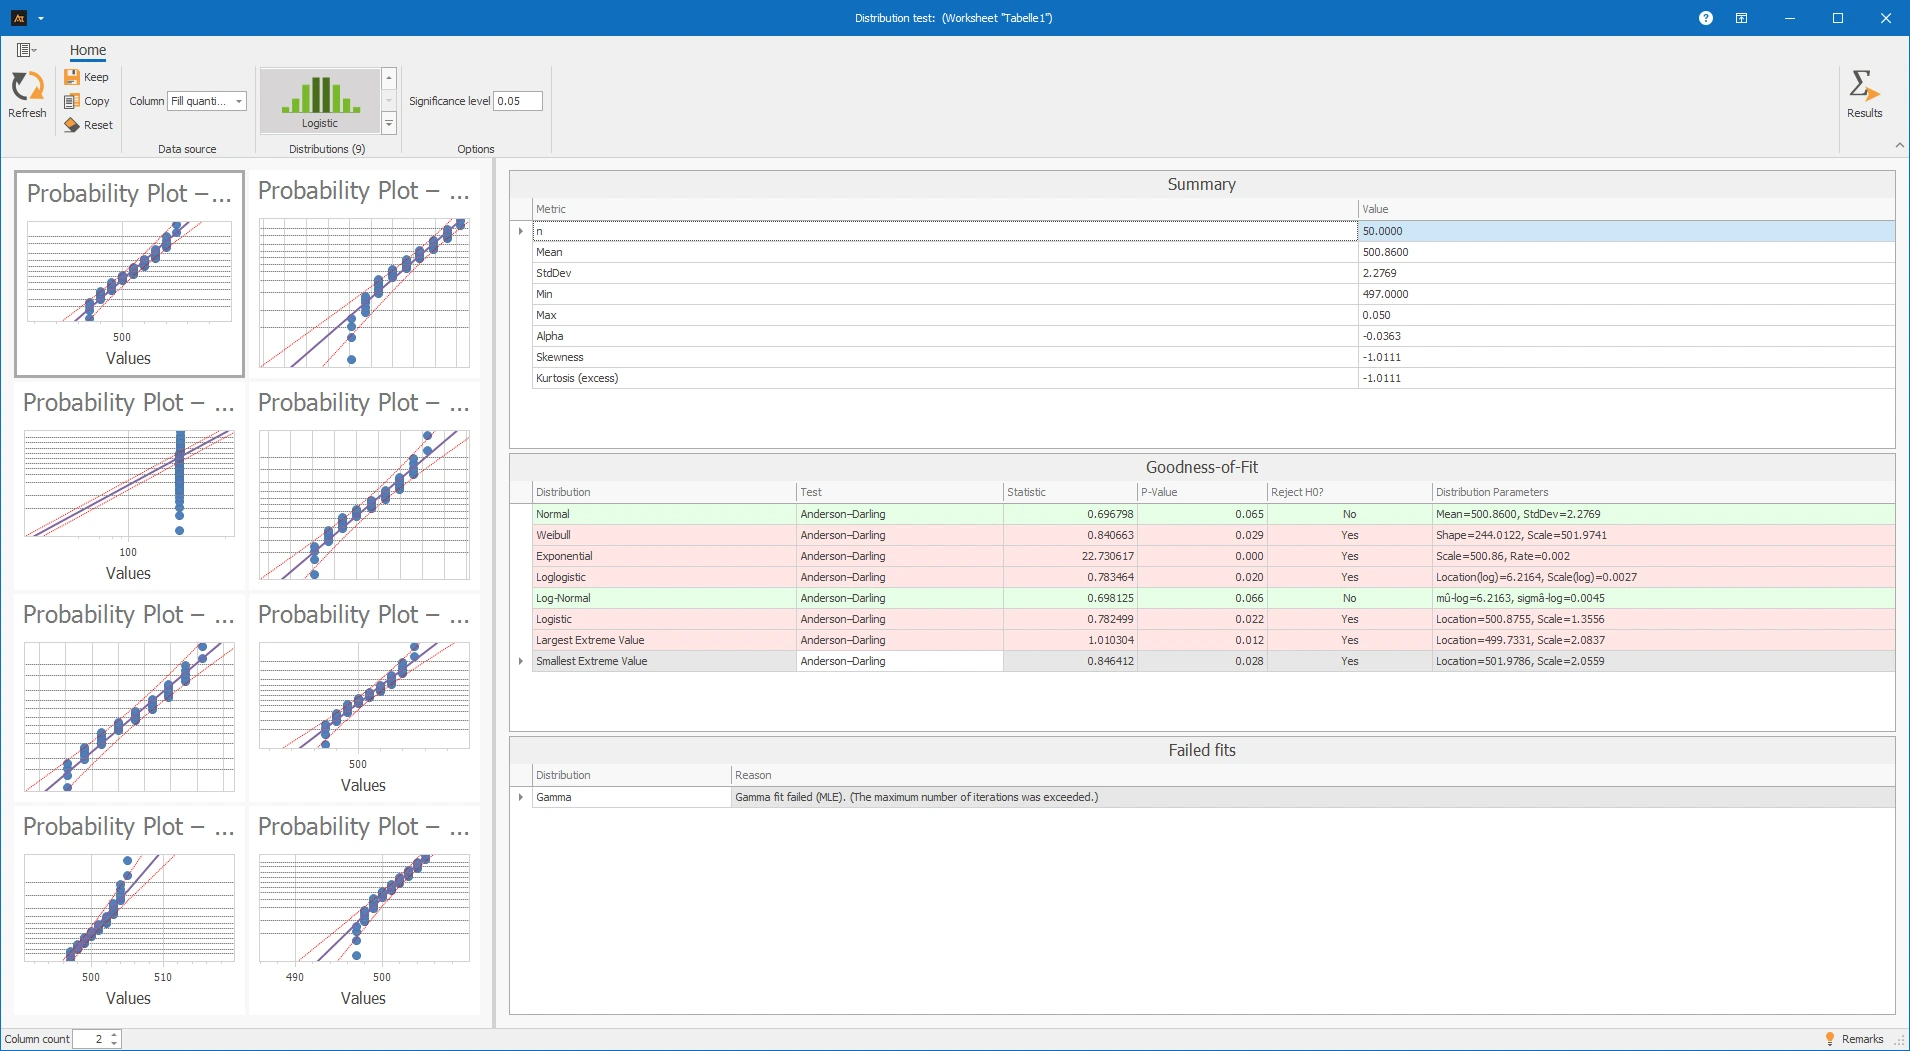
In questo esempio, viene esaminata la quantità di riempimento di una salsa di pomodoro. Ogni riempimento dovrebbe contenere 500 ml. A causa delle normali fluttuazioni del processo, alcune quantità di riempimento sono leggermente al di sotto e altre leggermente al di sopra del valore target. Poiché tali misurazioni spesso si disperdono approssimativamente in modo simmetrico attorno al valore target, si verifica quale distribuzione descrive sensatamente i dati. A tal fine, le quantità di riempimento vengono confrontate con diverse distribuzioni, inclusa la distribuzione normale.
Interpretazione
Le quantità di riempimento sono state confrontate con diverse distribuzioni. Di conseguenza, la distribuzione normale non è respinta perché il p-value di 0.065 è maggiore del livello di significatività di 0.05. Inoltre, nel grafico di probabilità, i punti si trovano per lo più vicino alla linea. Pertanto, le quantità di riempimento possono essere approssimativamente descritte da una distribuzione normale.
Altre distribuzioni, invece, sono respinte perché i loro p-value sono inferiori o uguali a 0.05. Queste includono, tra le altre, Weibull, Esponenziale, Log-logistica, Logistica, e la distribuzione del valore estremo maggiore. Ci sono prove statistiche per queste distribuzioni che non descrivono adeguatamente i dati.
Anche la distribuzione log-normale non è respinta. Tuttavia, in termini di quantità di riempimento, la distribuzione normale è spesso sensata perché è una misurazione continua che tipicamente si disperde attorno a un valore target.
La distribuzione gamma non è stata calcolata perché l'adattamento è fallito. Pertanto, non viene utilizzata per l'interpretazione.
Conclusione:
Per ulteriori analisi, può essere utilizzata la distribuzione normale perché non è statisticamente respinta e si adatta bene alle quantità di riempimento.
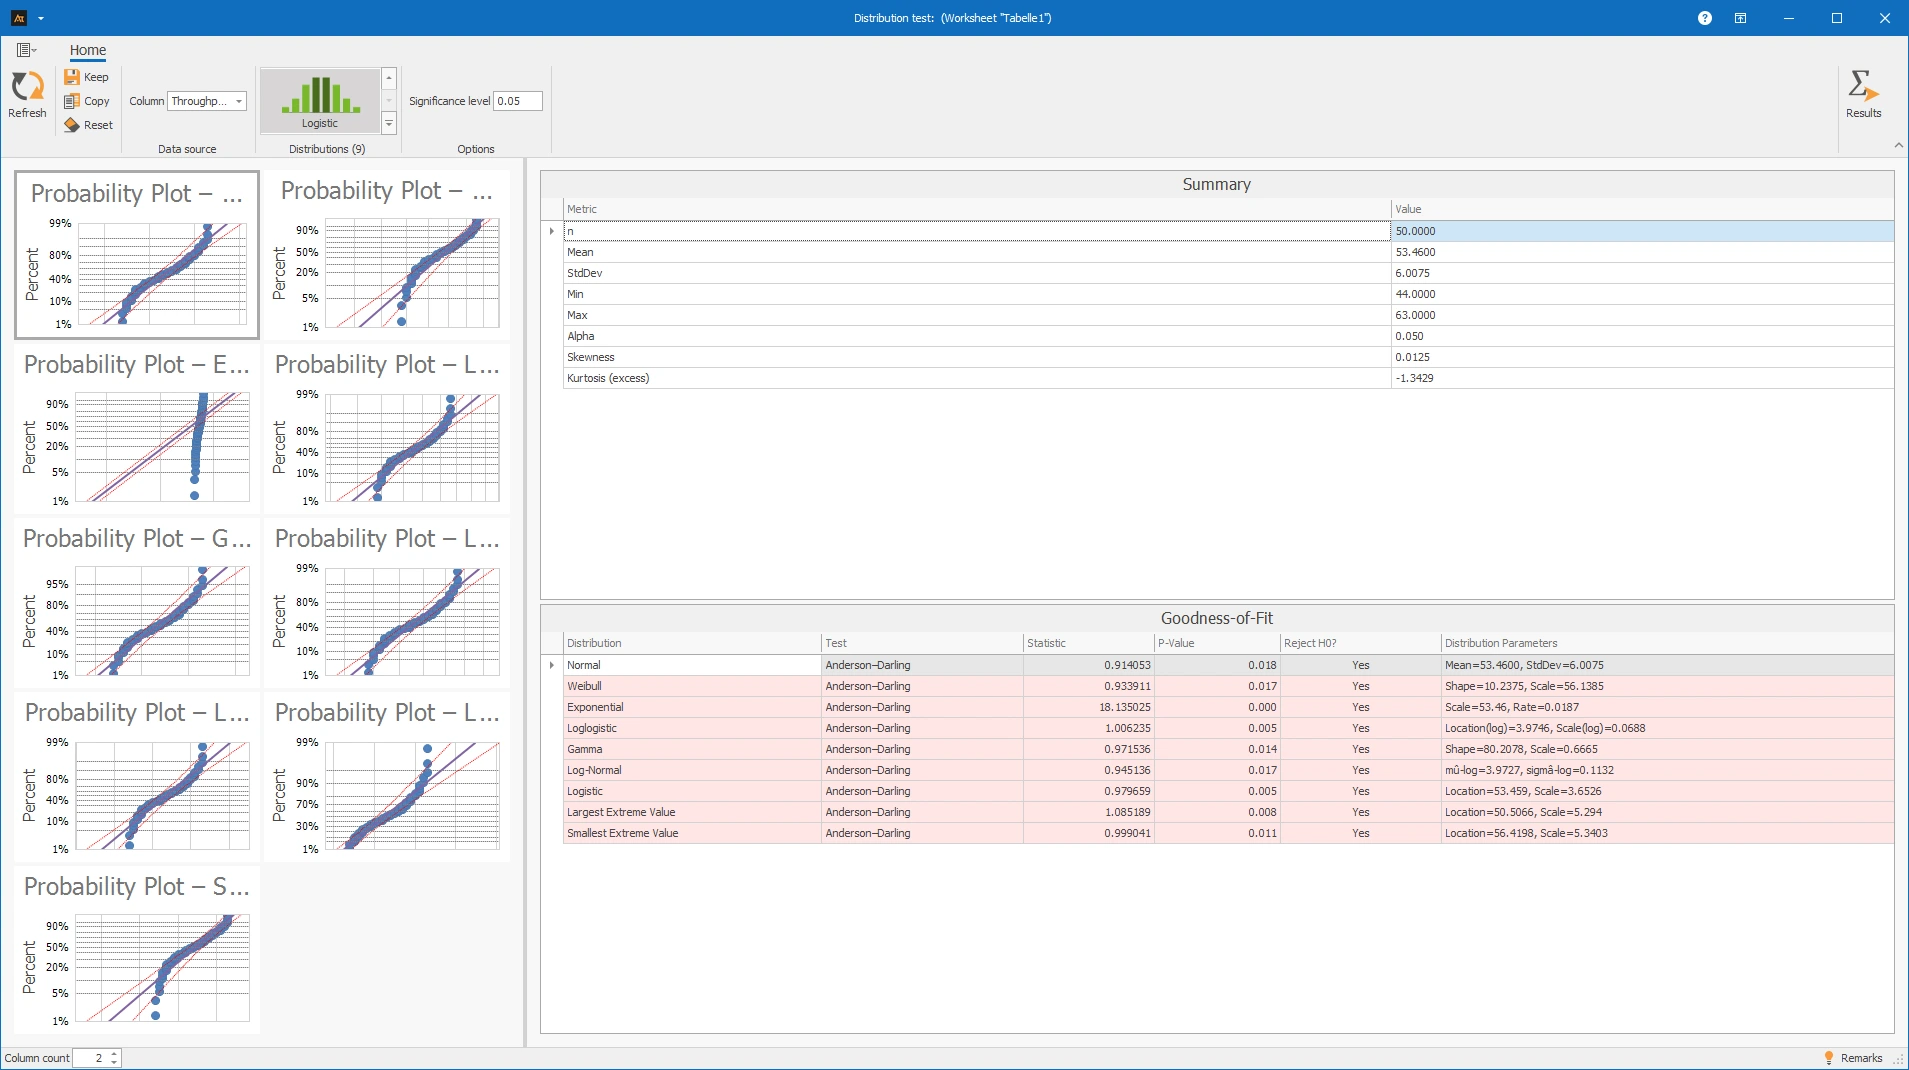
Tempo di Consegna di un Ordine in Ricevimento Merci
Nel ricevimento merci, i tempi di elaborazione spesso hanno una distribuzione asimmetrica a destra: molti ordini vengono completati rapidamente, ma alcuni processi richiedono significativamente più tempo. Pertanto, una distribuzione log-normale, gamma, Weibull o esponenziale può essere più plausibile di una distribuzione normale.
Interpretazione
I tempi di consegna sono stati confrontati con diverse distribuzioni. Per tutte le distribuzioni testate, il valore p è inferiore a 0,05. Pertanto, tutte le distribuzioni sono rifiutate.
Inoltre, nei grafici di probabilità, i punti non si trovano sufficientemente bene sulle linee. Pertanto, i dati non possono essere adeguatamente descritti da nessuna delle distribuzioni testate.
Conclusione:
Nessuna delle distribuzioni testate dovrebbe essere utilizzata per i tempi di consegna. Dovrebbe essere verificato se diversi stati di processo o tipi di ordini causano la variazione.
Tempo di risposta dell'helpdesk IT (Specifiche: max. 35 minuti (OSG))
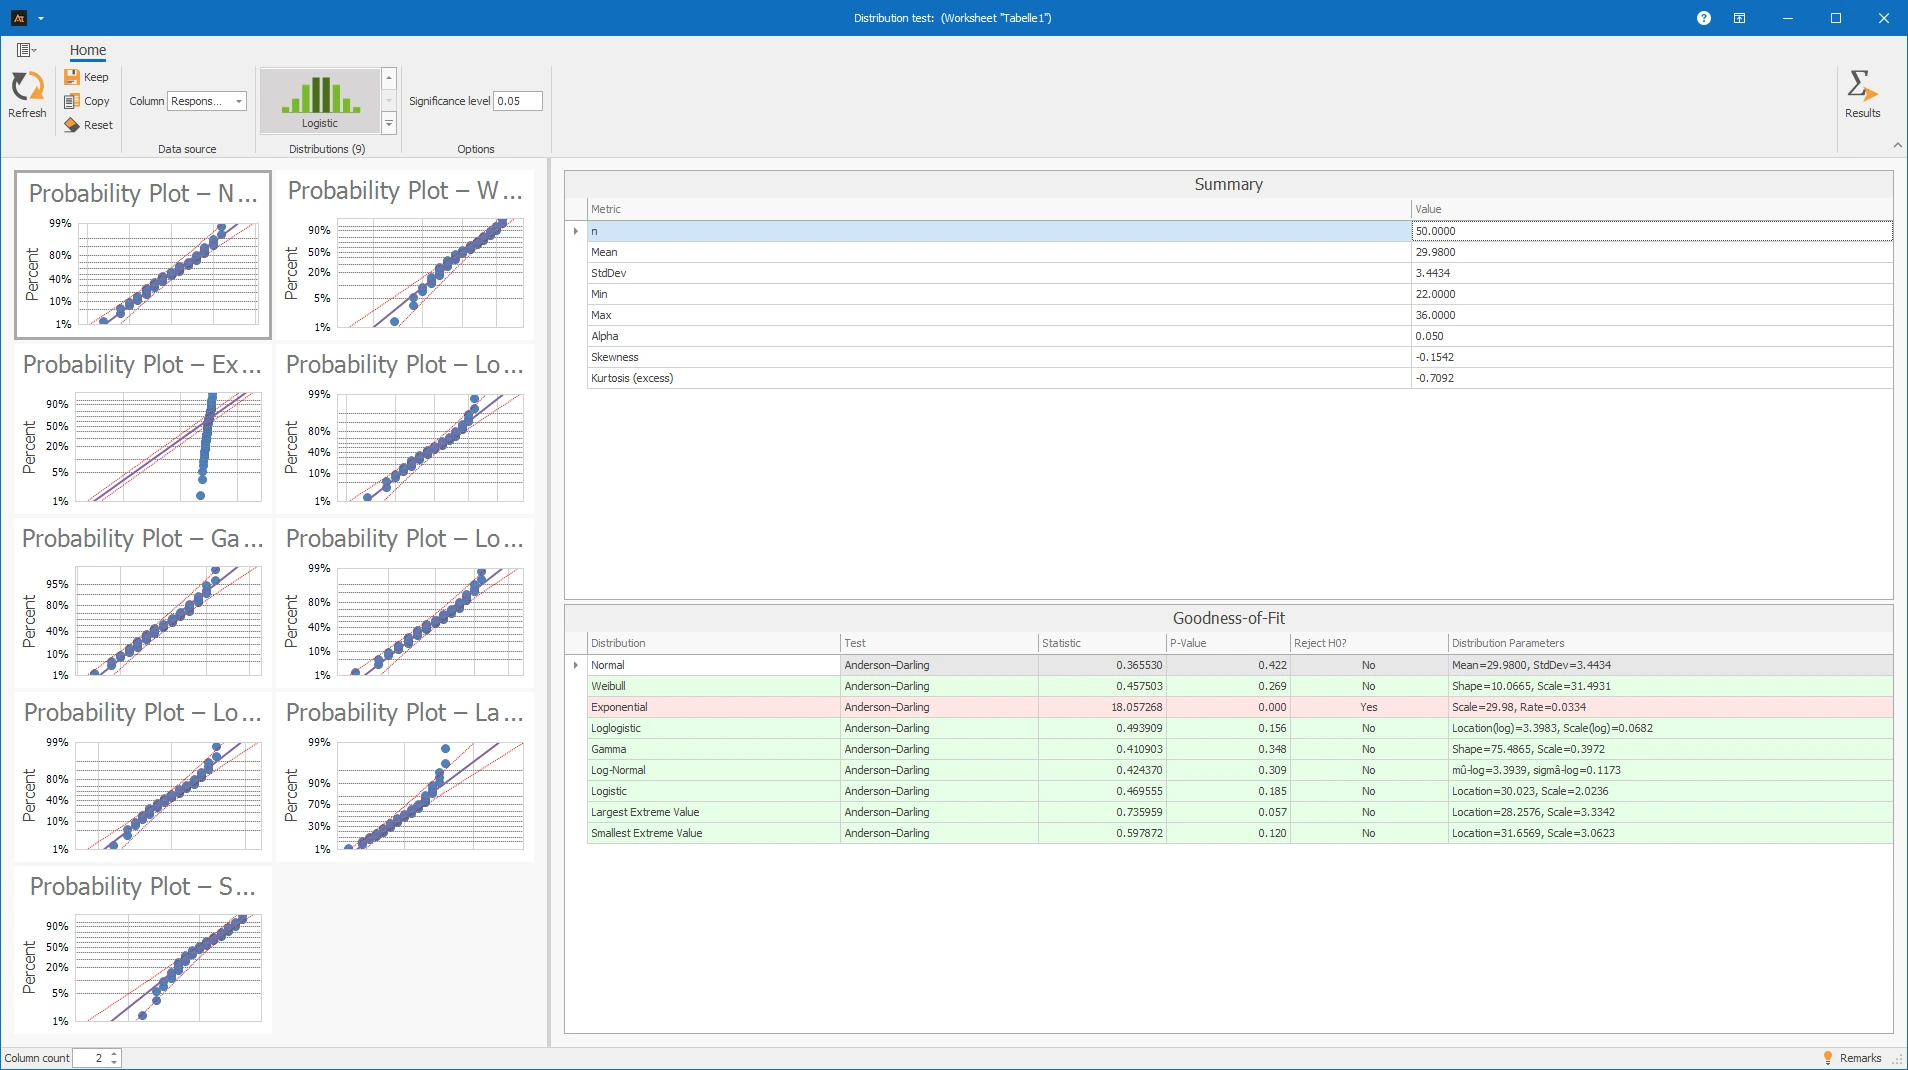
Richieste semplici e complesse vengono ricevute al service desk IT. Questo può comportare tempi di risposta che variano attorno a un valore tipico ma che hanno anche code lunghe a destra. Best Fit aiuta a verificare quale distribuzione descrive meglio questo comportamento.
Interpretazione
I tempi di risposta sono stati confrontati con diverse distribuzioni. La maggior parte delle distribuzioni testate non viene respinta perché i loro p-value sono maggiori di 0.05. Solo la distribuzione esponenziale viene respinta perché il p-value è inferiore a 0.05.
Per questa distribuzione, i dati non si adattano sufficientemente bene. I grafici di probabilità mostrano anche prevalentemente punti vicini alla linea per le distribuzioni non respinte.
Conclusione:
I tempi di risposta possono essere approssimativamente descritti da diverse distribuzioni. Per ulteriori analisi, dovrebbe essere scelta una distribuzione appropriata per l'argomento; la distribuzione esponenziale non dovrebbe essere utilizzata.
Vita utile dei cuscinetti a sfera
Per un nuovo tipo di macchina, i cuscinetti a sfera sono testati in funzionamento continuo. Ogni cuscinetto rimane nel banco di prova fino a quando non è più funzionale. Tali dati sulla vita utile sono tipicamente positivi e spesso non distribuiti normalmente.
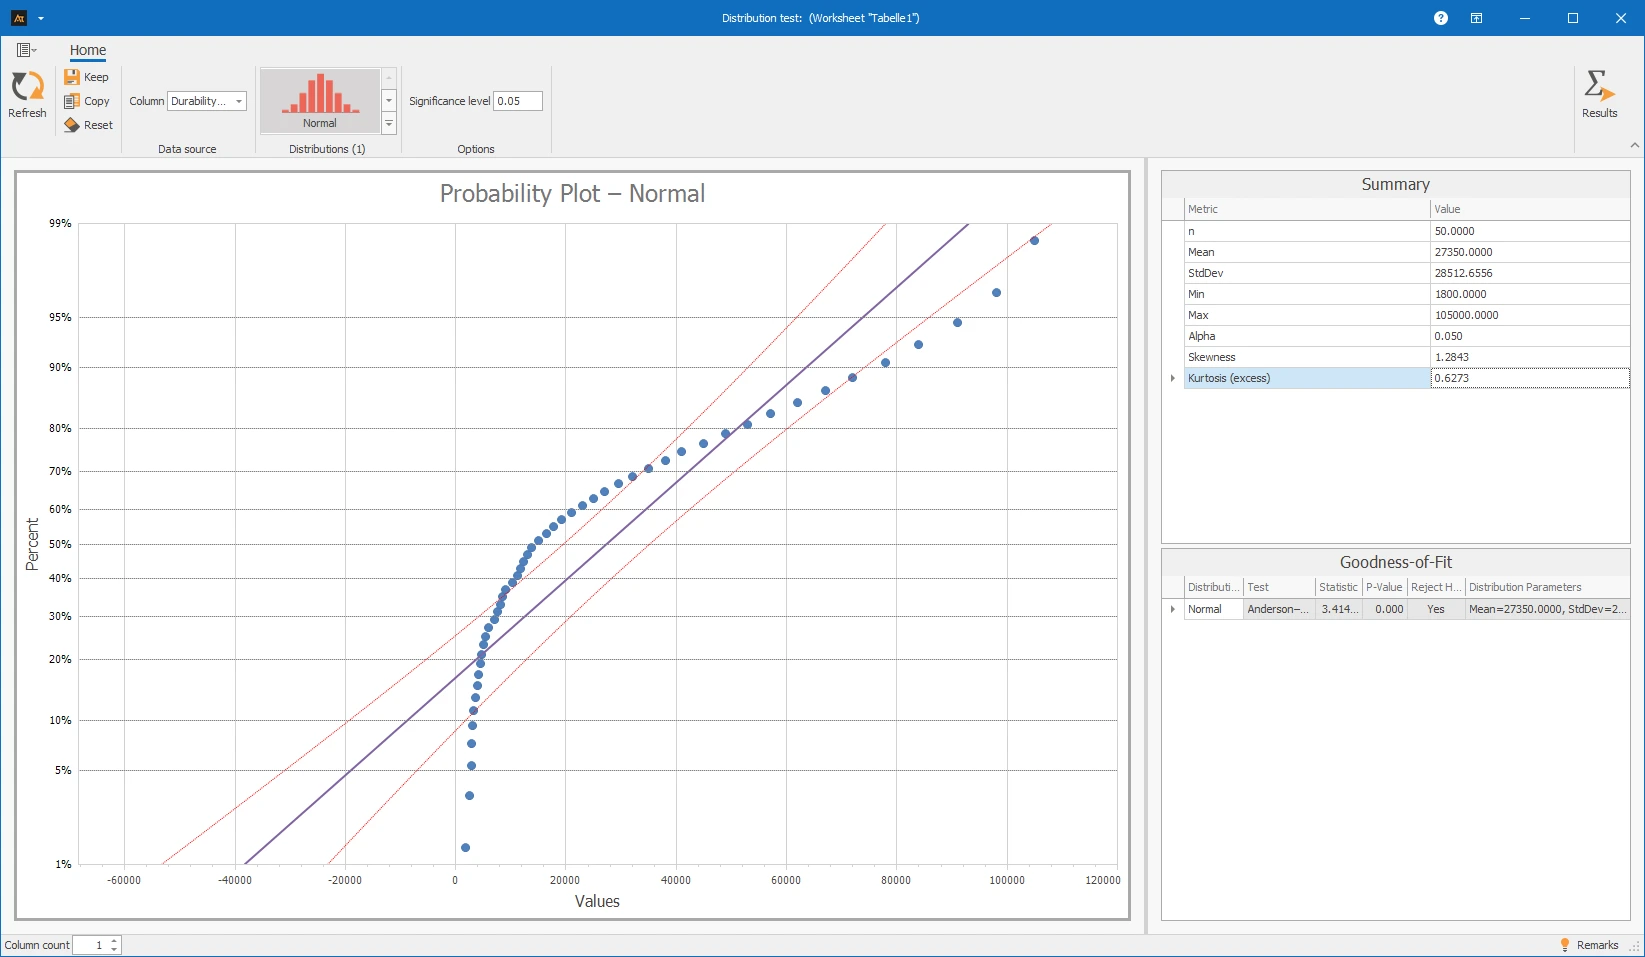
Nel grafico di probabilità della distribuzione normale, i punti possono deviare significativamente dalla linea. Questo argomenta contro una distribuzione normale delle vite utili.
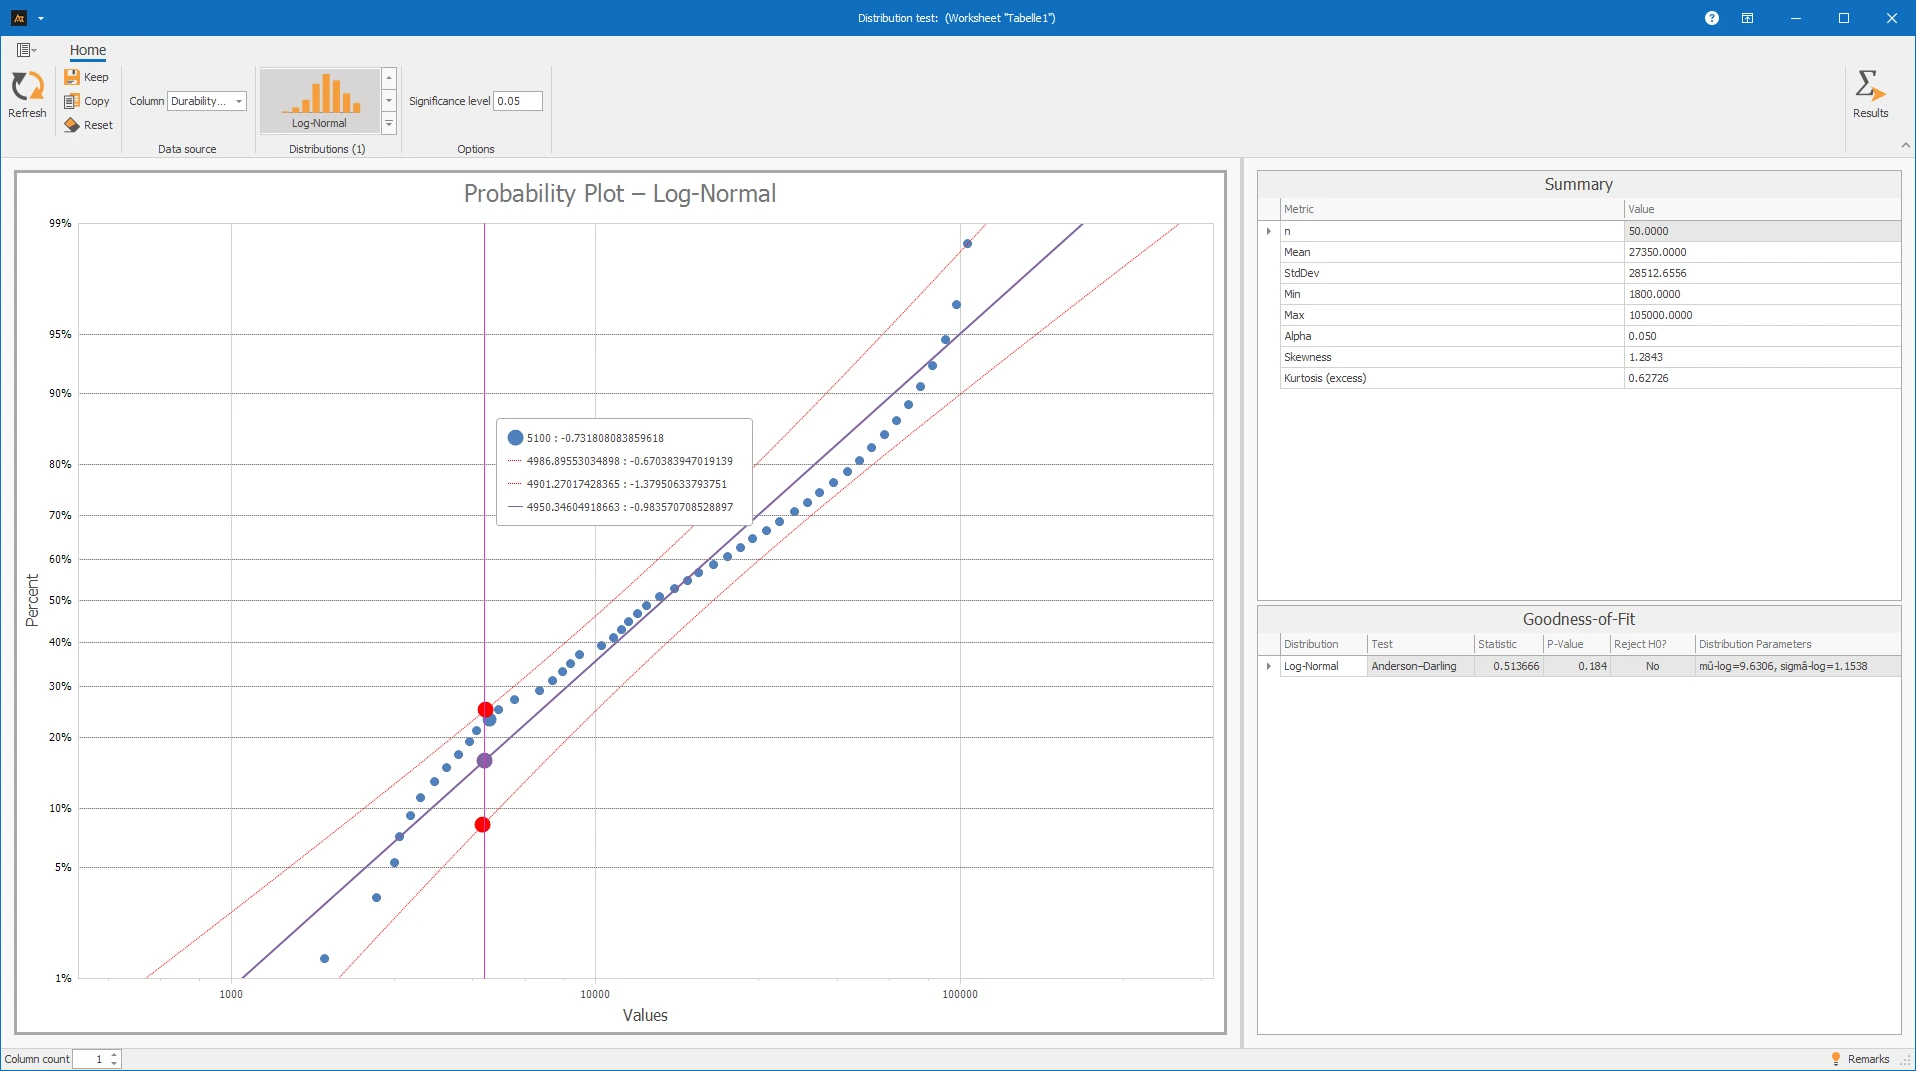
La vita utile dei cuscinetti a sfera è stata testata con la distribuzione lognormale. Il valore p è 0.190 ed è quindi maggiore di 0.05. La distribuzione lognormale non è quindi respinta.
Anche nel grafico di probabilità, i punti sono per lo più vicini alla linea. I dati sulla vita utile possono quindi essere approssimativamente descritti da una distribuzione lognormale.
Dati continui: Dati raccolti con uno strumento di misura che possono avere unità e cifre decimali.
Distribuzione: Modello matematico che descrive come le misurazioni si distribuiscono tipicamente.
Test di Anderson-Darling: Test statistico per verificare se i dati si adattano a una distribuzione selezionata.
p-value: Metrica per valutare il risultato del test. Più piccolo è il p-value, più forte è l'evidenza contro la distribuzione testata.
Statistica A²: Misura della deviazione dei dati dalla distribuzione testata. Valori più piccoli tendono a indicare una minore deviazione dalla distribuzione testata.
H0: Ipotesi nulla del test. Afferma: I dati seguono la distribuzione testata.
n = Dimensione del campione: Numero di misurazioni valide nel campione.
Media: Media di tutte le misurazioni. Descrive la posizione centrale dei dati.
Deviazione standard: Misura di quanto le misurazioni si disperdono attorno alla media. Una piccola deviazione standard significa poca dispersione, una grande deviazione standard significa maggiore dispersione.
Minimo: Misurazione più piccola all'interno del campione considerato.
Massimo: Misurazione più grande all'interno del campione considerato.
Alpha (α): Livello di significatività impostato e soglia decisionale per il p-value. Spesso si usa α = 0.05. Se il p-value è più piccolo di Alpha, l'ipotesi nulla H0 viene respinta.
Asimmetria: Metrica per la simmetria di una distribuzione. Un valore vicino a 0 indica una distribuzione approssimativamente simmetrica. Valori positivi o negativi indicano una maggiore espressione della distribuzione rispettivamente a destra o a sinistra.
Curtoisi: Metrica che descrive la forma di una distribuzione, in particolare quanto fortemente le misurazioni si concentrano al centro e nelle code. Può fornire indizi sul fatto che una distribuzione sia più appuntita o piatta rispetto a una distribuzione normale.
Il test di distribuzione calcola i parametri corrispondenti, la statistica del test e il valore p per le distribuzioni selezionate. Le funzioni della libreria Numerics.NET sono utilizzate per calcolare la statistica del test.