

Il potere indica la probabilità con cui un test statistico rileva un effetto effettivamente esistente.
Viene utilizzato per valutare se la base di dati esistente è sufficiente per rilevare in modo affidabile differenze, varianze o cambiamenti nei tassi.
A differenza del test classico delle ipotesi, il potere non si concentra sulla decisione tra l'ipotesi alternativa e l'ipotesi nulla, ma piuttosto su quanto sia potente il test sotto le ipotesi date:
- potere alto → un effetto rilevante viene rilevato con alta probabilità
- potere basso → un effetto esistente può rimanere non rilevato nonostante l'indagine
Importante: Quando si calcola il potere, vengono inseriti i dati riassunti in AlphadiTab. Pertanto, non sono richiesti dati grezzi, ma metriche come dimensione del campione, media, deviazione standard o numero di eventi.
Nello sviluppo del prodotto, si sta testando una nuova formulazione di salsa di pomodoro. L'obiettivo è determinare se la viscosità della nuova formulazione differisce in media dalla formulazione precedente.
A tal fine, vengono effettuate misurazioni della viscosità su campioni della vecchia formulazione e della nuova formulazione.
Utilizzando il t-test (2 campioni), è stato verificato se la differenza osservata nelle medie è statisticamente significativa o può essere spiegata dalla variazione casuale.
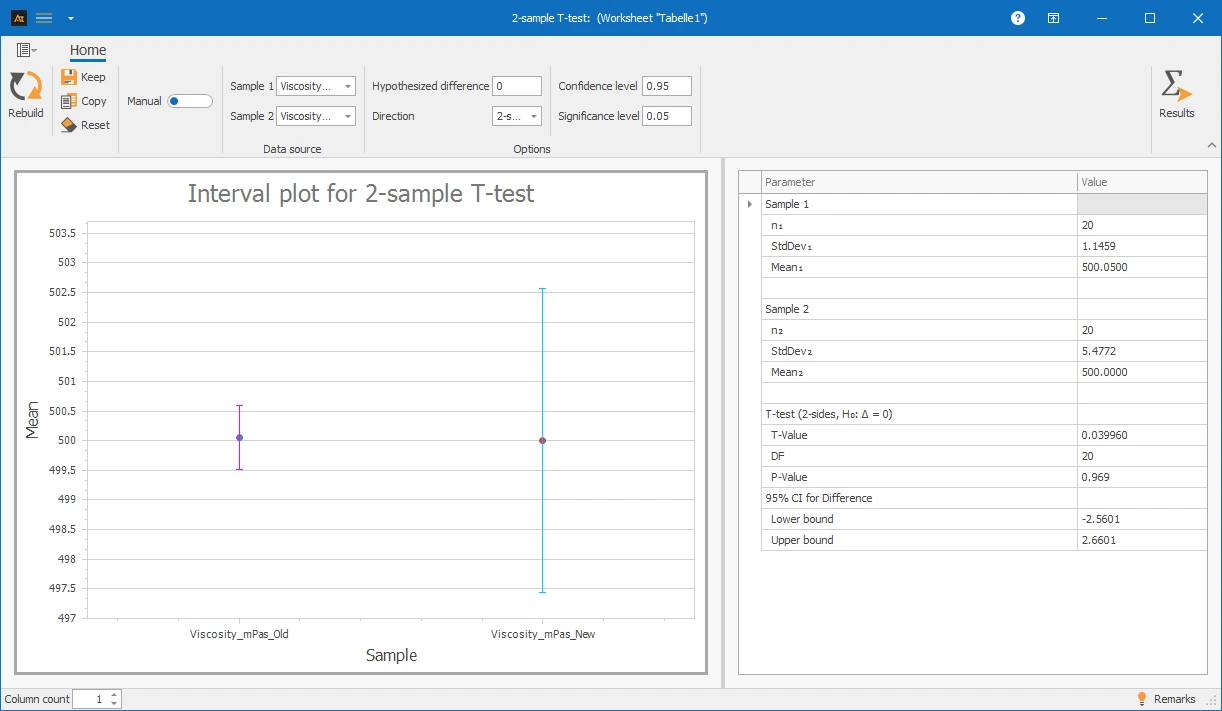
Il p-value calcolato è significativamente superiore al livello di significatività di 0,05, quindi l'ipotesi nulla viene mantenuta. Sulla base di questo test, non si riscontra alcuna differenza significativa tra la viscosità media della vecchia e della nuova formulazione. Con il calcolo della potenza, vogliamo ora valutare quanto affidabilmente possa essere rilevata una differenza effettiva.
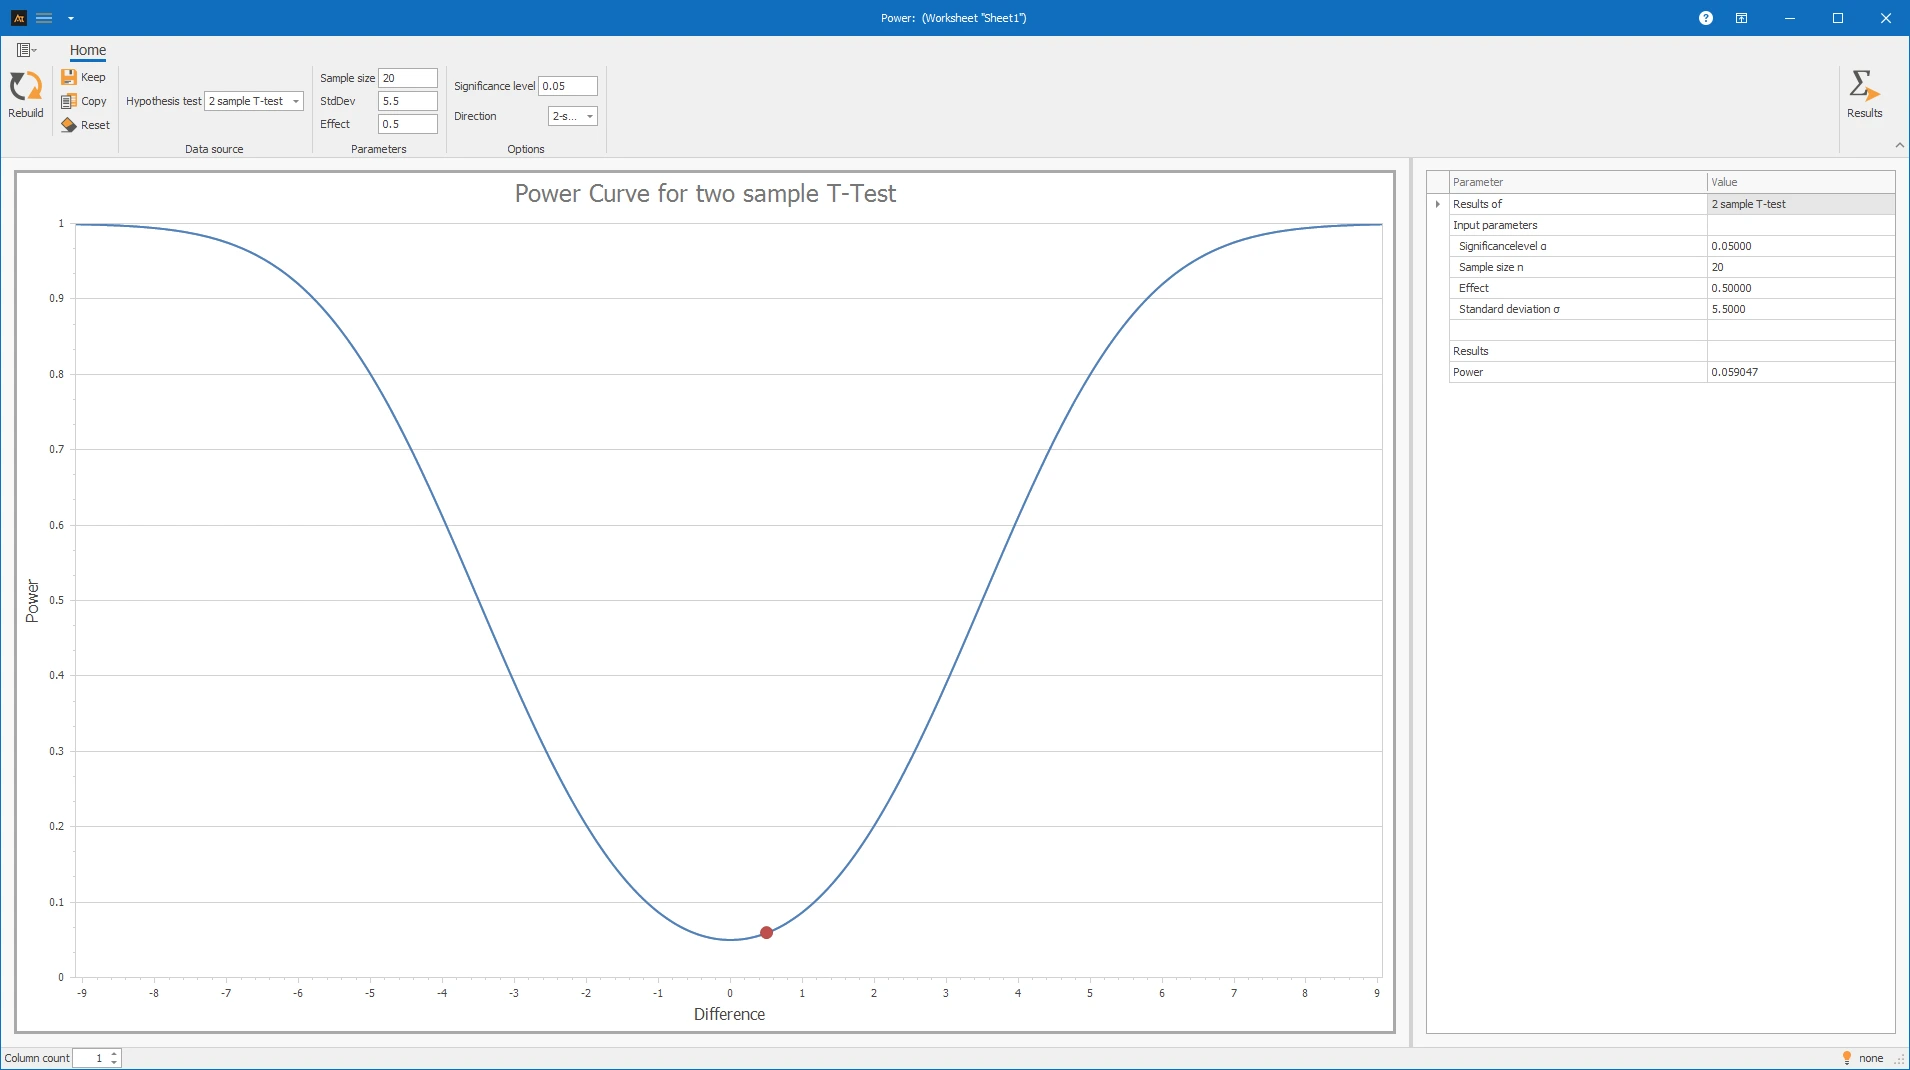
Per questo, dobbiamo determinare quale differenza nella viscosità media vogliamo rilevare. La chiave è quale differenza è praticamente rilevante. In questo esempio, si vuole rilevare una differenza nelle medie di 0,5 MPa. Questa differenza corrisponde all'effetto. Possiamo prendere la dimensione del campione e la deviazione standard dal test condotto. La deviazione standard è stata arrotondata a 5,5; qui viene utilizzata la meno favorevole delle due deviazioni standard.
Interpretazione dei risultati:
La potenza è 0,059. Questo corrisponde a un errore β del 94,1%. In queste condizioni, il test non può rilevare in modo affidabile una differenza effettiva di 0,5 MPa. Dalla curva di potenza, è evidente che un effetto di circa 5 MPa può essere rilevato con questo test con una potenza di circa l'80%. L'errore β sarebbe quindi di circa il 20%.
Spiega del grafico:
- La curva mostra la potenza per diversi effetti (differenze)
- Il punto rappresenta l'input attuale.
I seguenti sono le considerazioni e i passaggi necessari per calcolare la potenza per vari test statistici.
Preparazione
- Selezionare il test appropriato (ad es., t-test, F-test, test delle proporzioni o ANOVA).
- Determinare quale differenza, rapporto di varianza o cambiamento nelle proporzioni è praticamente rilevante.
- Impostare il livello di significatività (di solito α = 0,05).
- Determinare la potenza desiderata o l'errore beta.
- Determinare la direzione dell'ipotesi (a due code, maggiore o minore), se il metodo supporta questa scelta.
 Uso in AlphadiTab
- Nella Fase di Analisi, selezionare lo strumento Potenza.
- Selezionare il tipo di test appropriato, ad es., t-test, F-test, test delle proporzioni o ANOVA.
- Inserire le metriche riassunte nei campi di input.
- Condurre l'analisi tramite “Crea Nuovo”.
Interpretazione
- Verificare se la potenza calcolata è sufficientemente alta.
- Nella pratica, l'80% o il 90% di potenza è spesso utilizzato come linea guida.
- Se la potenza è bassa, verificare se è necessario un campione più grande o un design di studio più mirato.
Importante: La potenza non è una conferma retrospettiva di un valore p. Descrive quanto è probabile che un test rilevi un effetto presunto con gli input scelti.
Tipi di test
- T-Test: Sensibilità per confrontare le medie.
- F-Test: Sensibilità per confrontare le varianze o le dispersioni.
- Test delle proporzioni: Sensibilità per confrontare i rapporti o gli eventi binari.
- ANOVA: Sensibilità per confrontare le medie di due o più gruppi.
- Test sulle varianze: Sensibilità per confrontare le varianze o le dispersioni di due o più campioni, eventualmente non parametrici.
Nei test di ipotesi con 2 campioni, è possibile selezionare la direzione per l'ipotesi alternativa.
Scegli bilaterale se si vuole rilevare una differenza senza specificare una direzione particolare.
- Questa impostazione è utile quando sia valori più alti che più bassi sarebbero rilevanti.
Esempio:
La media dei tempi di consegna è diversa tra due processi?
Scegli maggiore se un effetto è rilevante solo nella direzione di valori più alti.
- Questa impostazione è utile, ad esempio, se si vuole testare se un tasso di successo aumenta.
Esempio:
Il tasso di vendita è più alto con un nuovo approccio di vendita rispetto a prima?
Scegli minore se un effetto è rilevante solo nella direzione di valori più bassi.
- Questa impostazione è utile, ad esempio, se si vuole testare se un tempo di elaborazione o un tasso di difetti diminuisce.
Esempio:
Il tempo medio di elaborazione dopo un'ottimizzazione è inferiore rispetto a prima?
Quantità di riempimento salsa di pomodoro – Macchina A vs. Macchina B
In produzione, vengono utilizzate diverse macchine di riempimento. Si dovrebbe valutare se i dati disponibili siano sufficienti per rilevare in modo affidabile una differenza tra la Macchina A e la Macchina B.
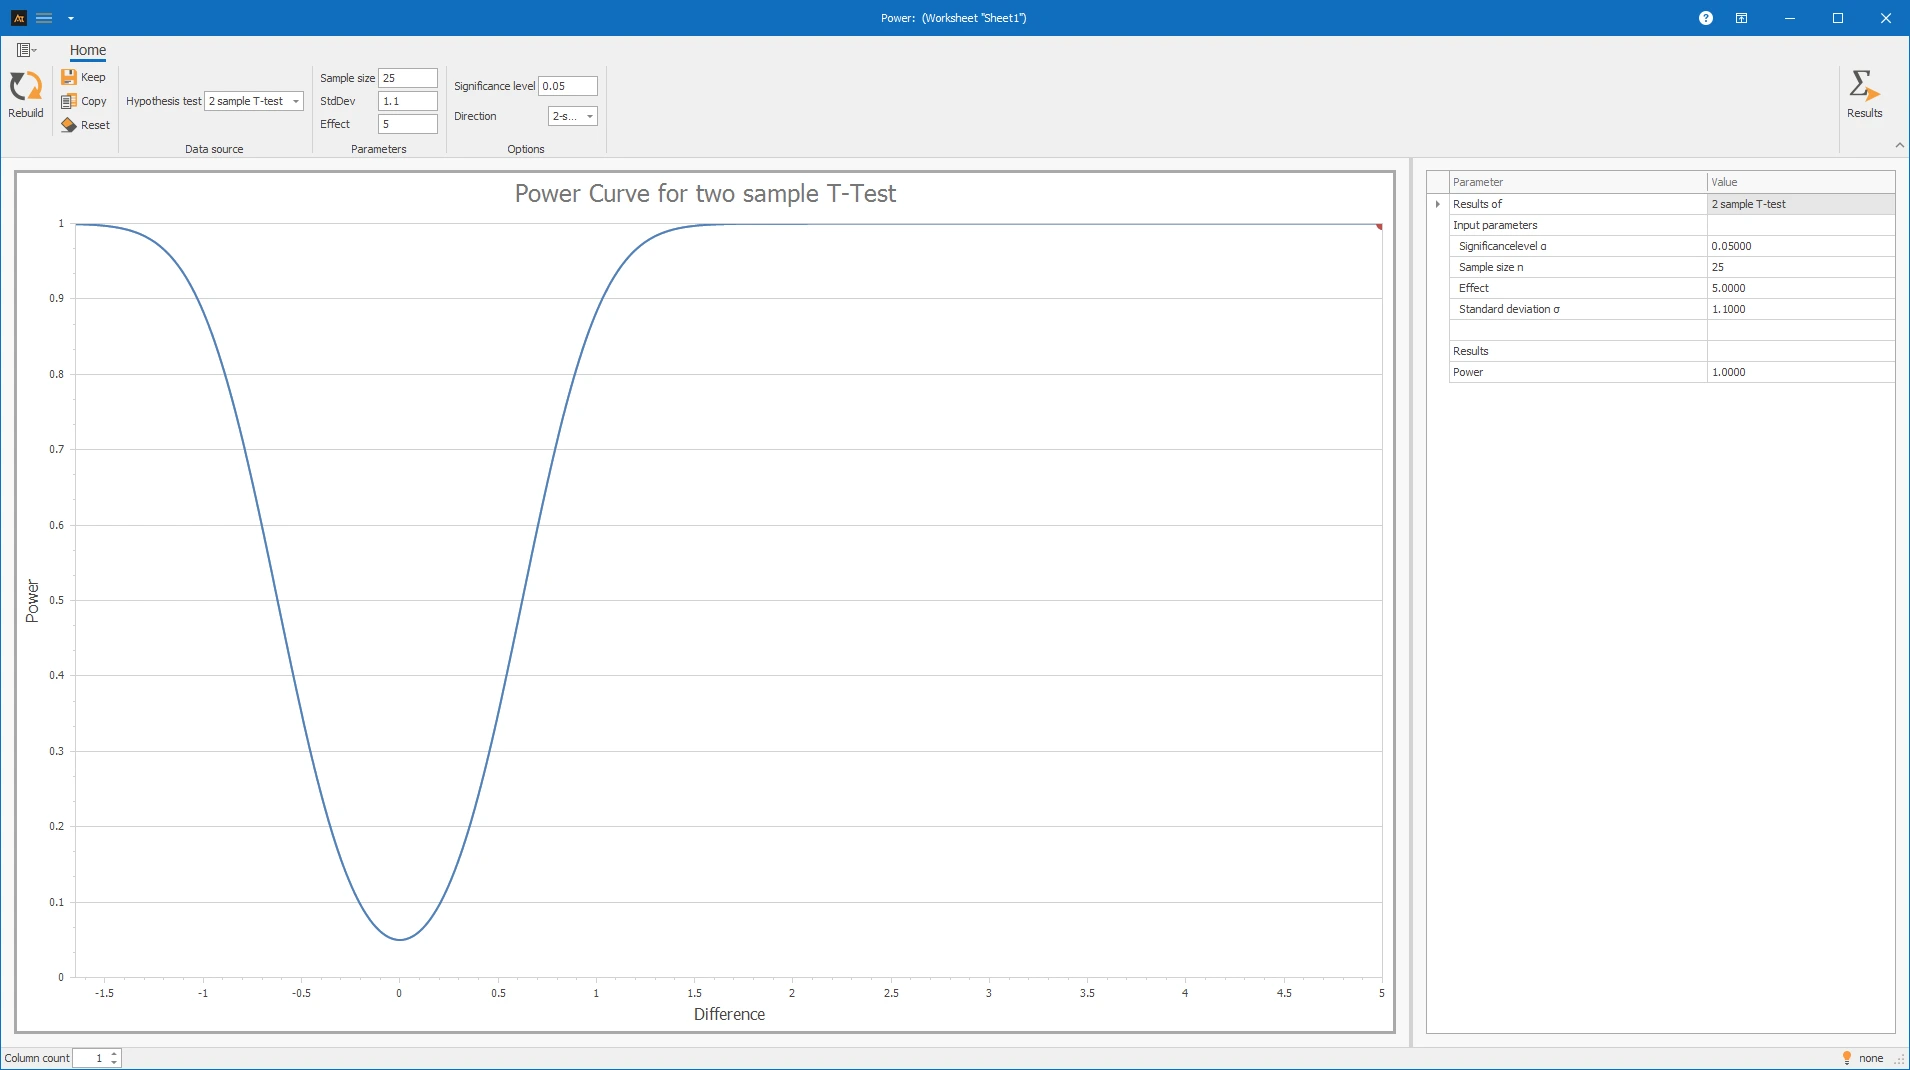
T-Test:
Differenze nei mezzi: La potenza è sufficiente per rilevare una differenza di 5 ml nella quantità media di riempimento?
Interpretazione
Per il t-test, la potenza mostra la probabilità con cui viene rilevata una differenza nella quantità media di riempimento. La potenza è 1.000. Pertanto, il test può rilevare la differenza presunta con una probabilità molto alta sotto gli input scelti. L'errore β è corrispondentemente vicino allo 0%.
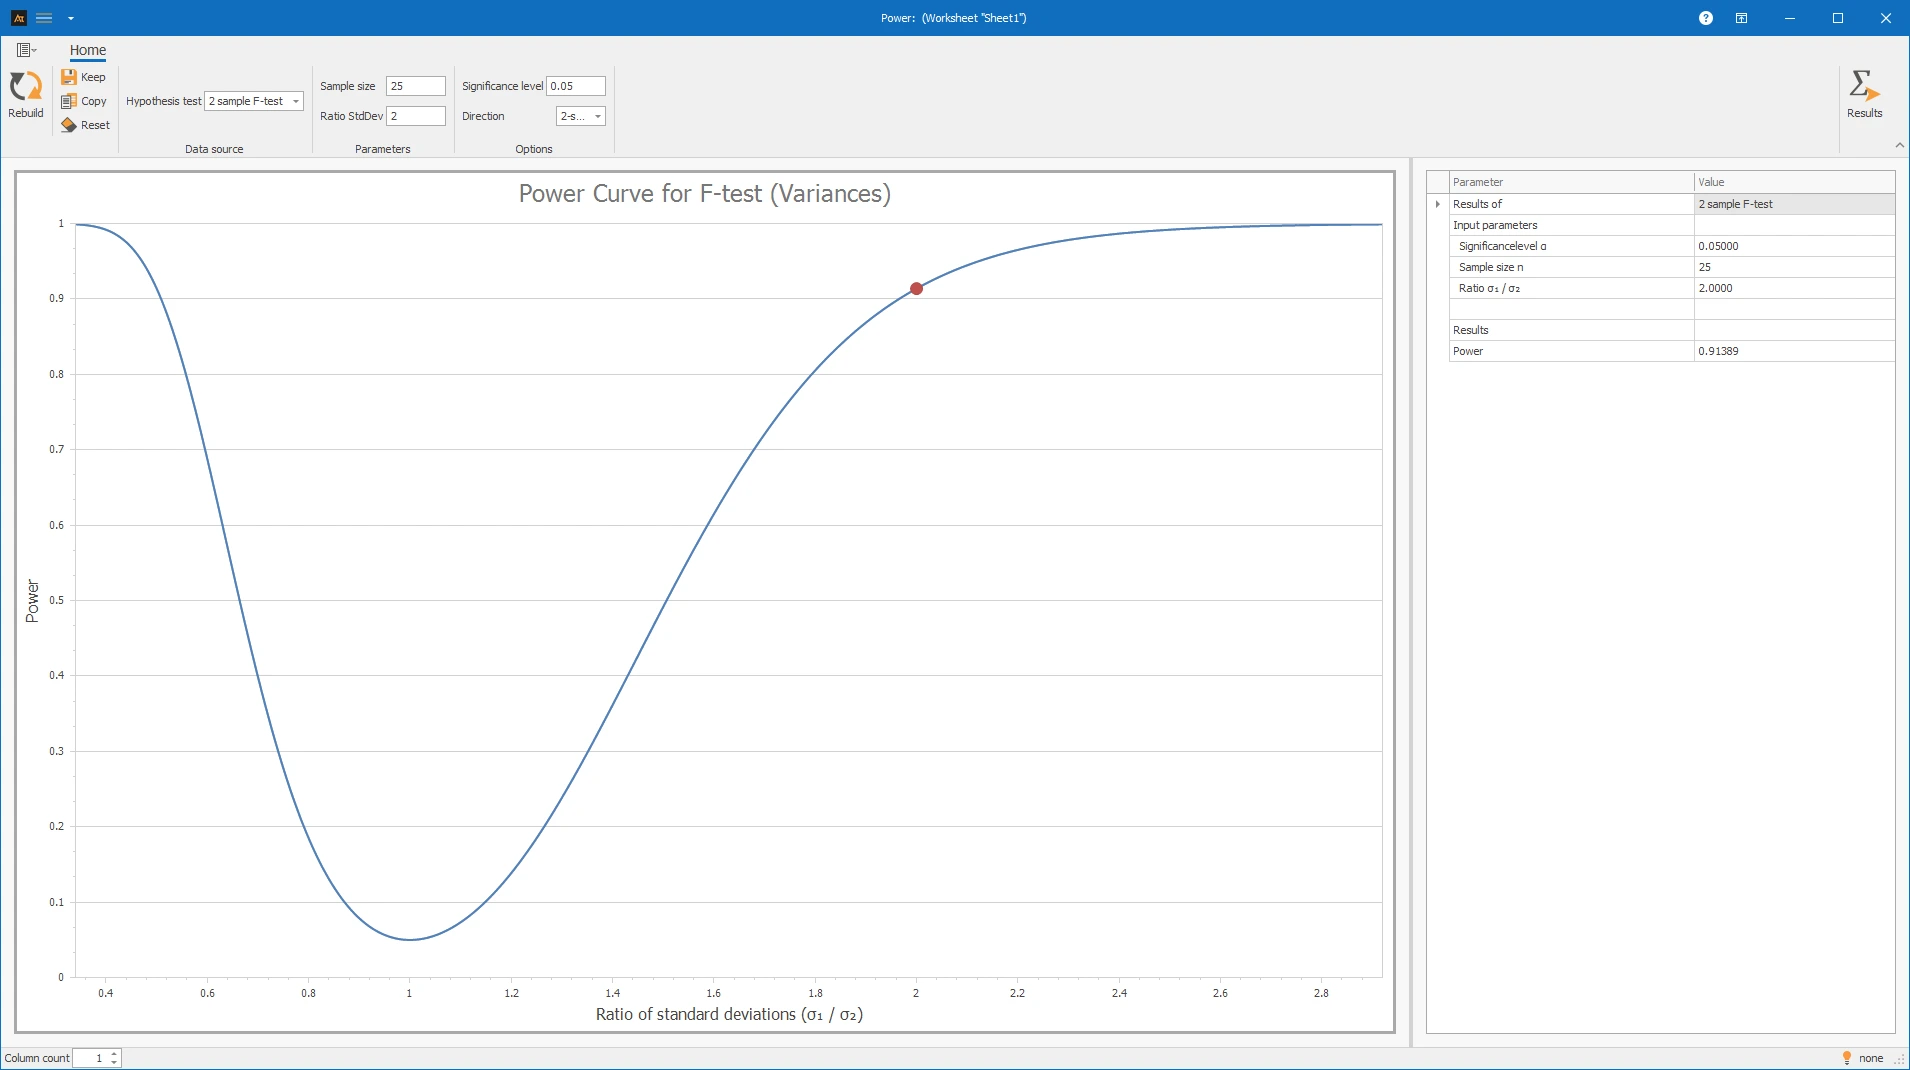
F-Test:
Differenze nelle varianze: La potenza è sufficiente per rilevare un raddoppio della varianza della quantità di riempimento?
Interpretazione
Per il F-test, la potenza mostra la probabilità con cui viene rilevata una differenza nella varianza. La potenza è 0.91389. Un raddoppio della deviazione standard può quindi essere rilevato con una potenza di circa 91,4%. L'errore β è approssimativamente dell'8,6%.
Tempo di risposta dell'helpdesk IT vs. ANOVA della posizione
Nel service desk IT, i ticket vengono elaborati in più sedi. I tempi di risposta vengono regolarmente valutati per identificare differenze nella qualità del servizio.
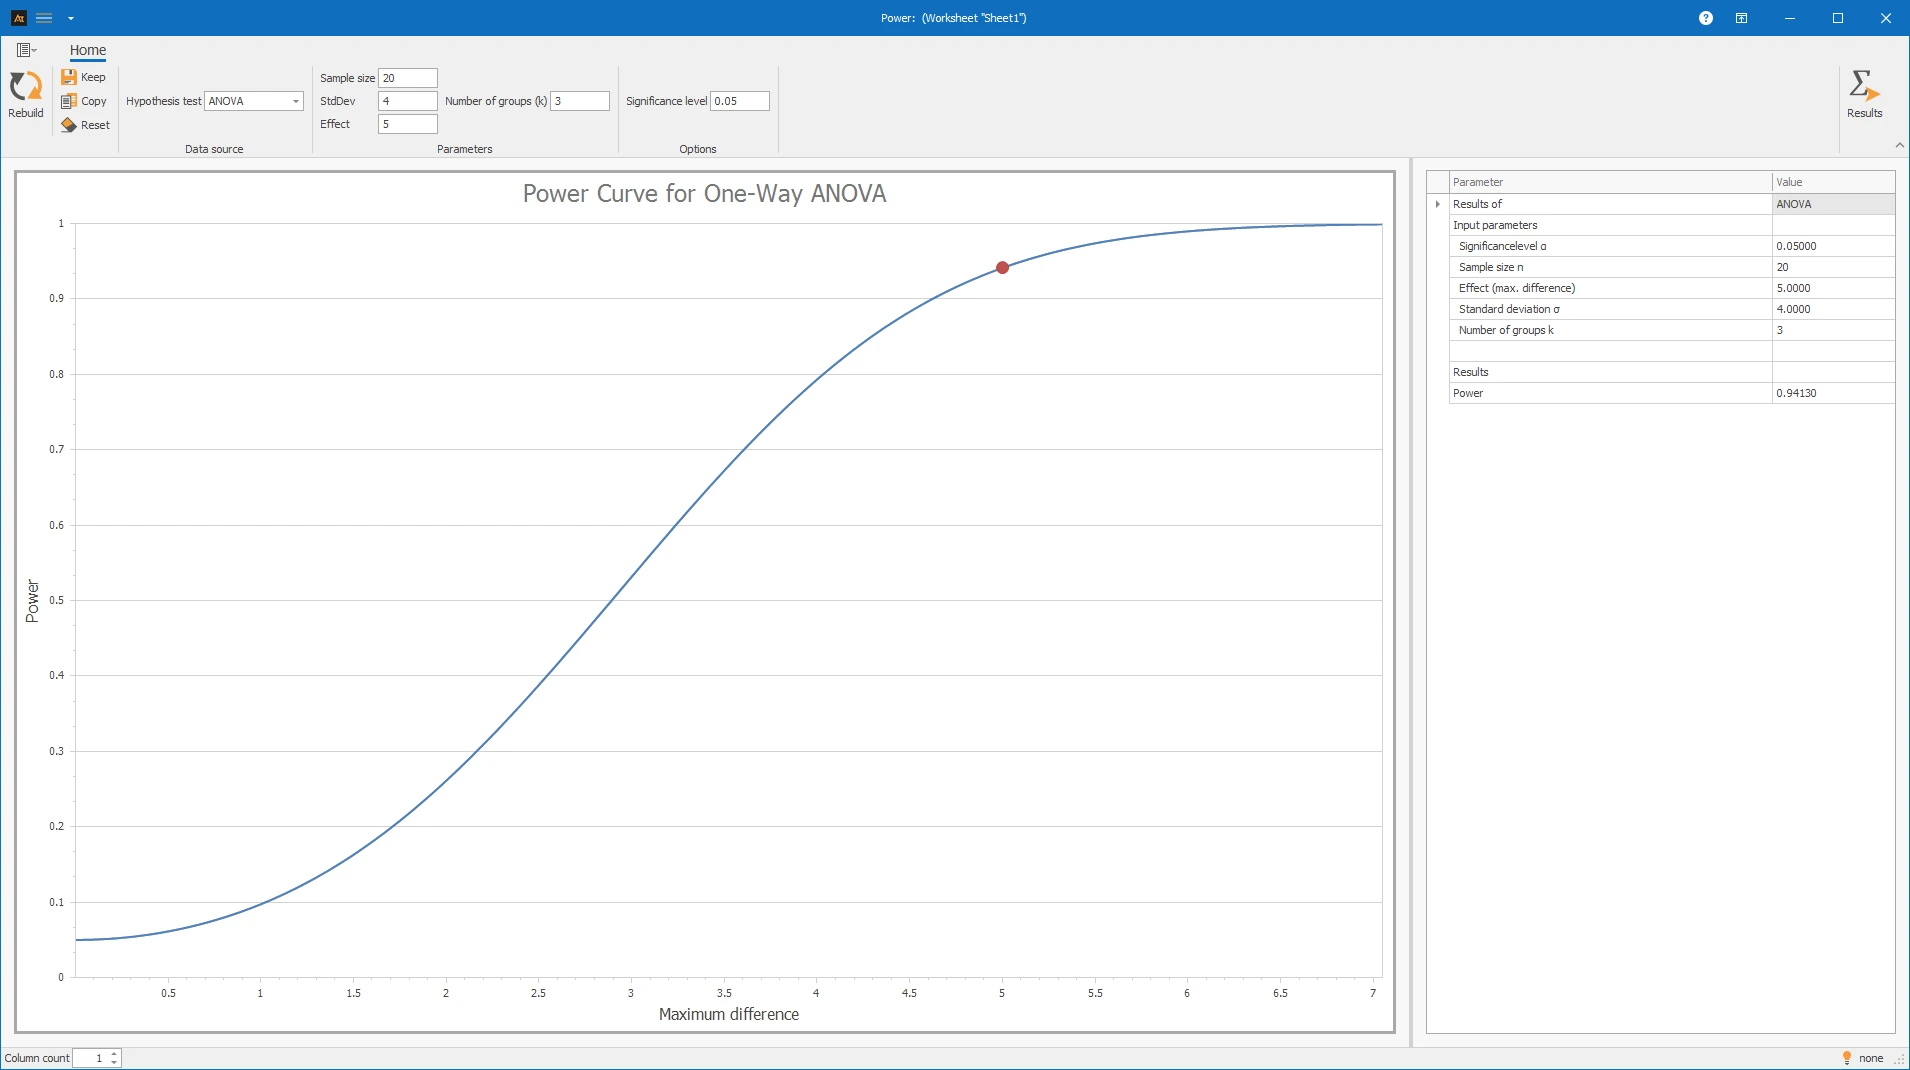
Nell'esempio dei ticket IT, sono disponibili dati da tre sedi. La sensibilità viene utilizzata per valutare se una differenza di 5 minuti nel tempo di risposta verrebbe rilevata con l'ANOVA.
Interpretazione dei risultati
L'impostazione del test è adatta per rilevare una differenza di 5 minuti con tre livelli e una deviazione standard di 4. La sensibilità è sufficientemente alta; l'errore β è corrispondentemente basso.
Test delle proporzioni - Tasso di perdita per approccio di vendita
Nelle vendite, vengono confrontati due approcci di vendita. Si dovrebbe valutare se i numeri delle offerte esistenti siano sufficienti per rilevare in modo affidabile un cambiamento rilevante nel tasso di perdita. Il test delle proporzioni ha mostrato che i metodi di vendita non differiscono significativamente.
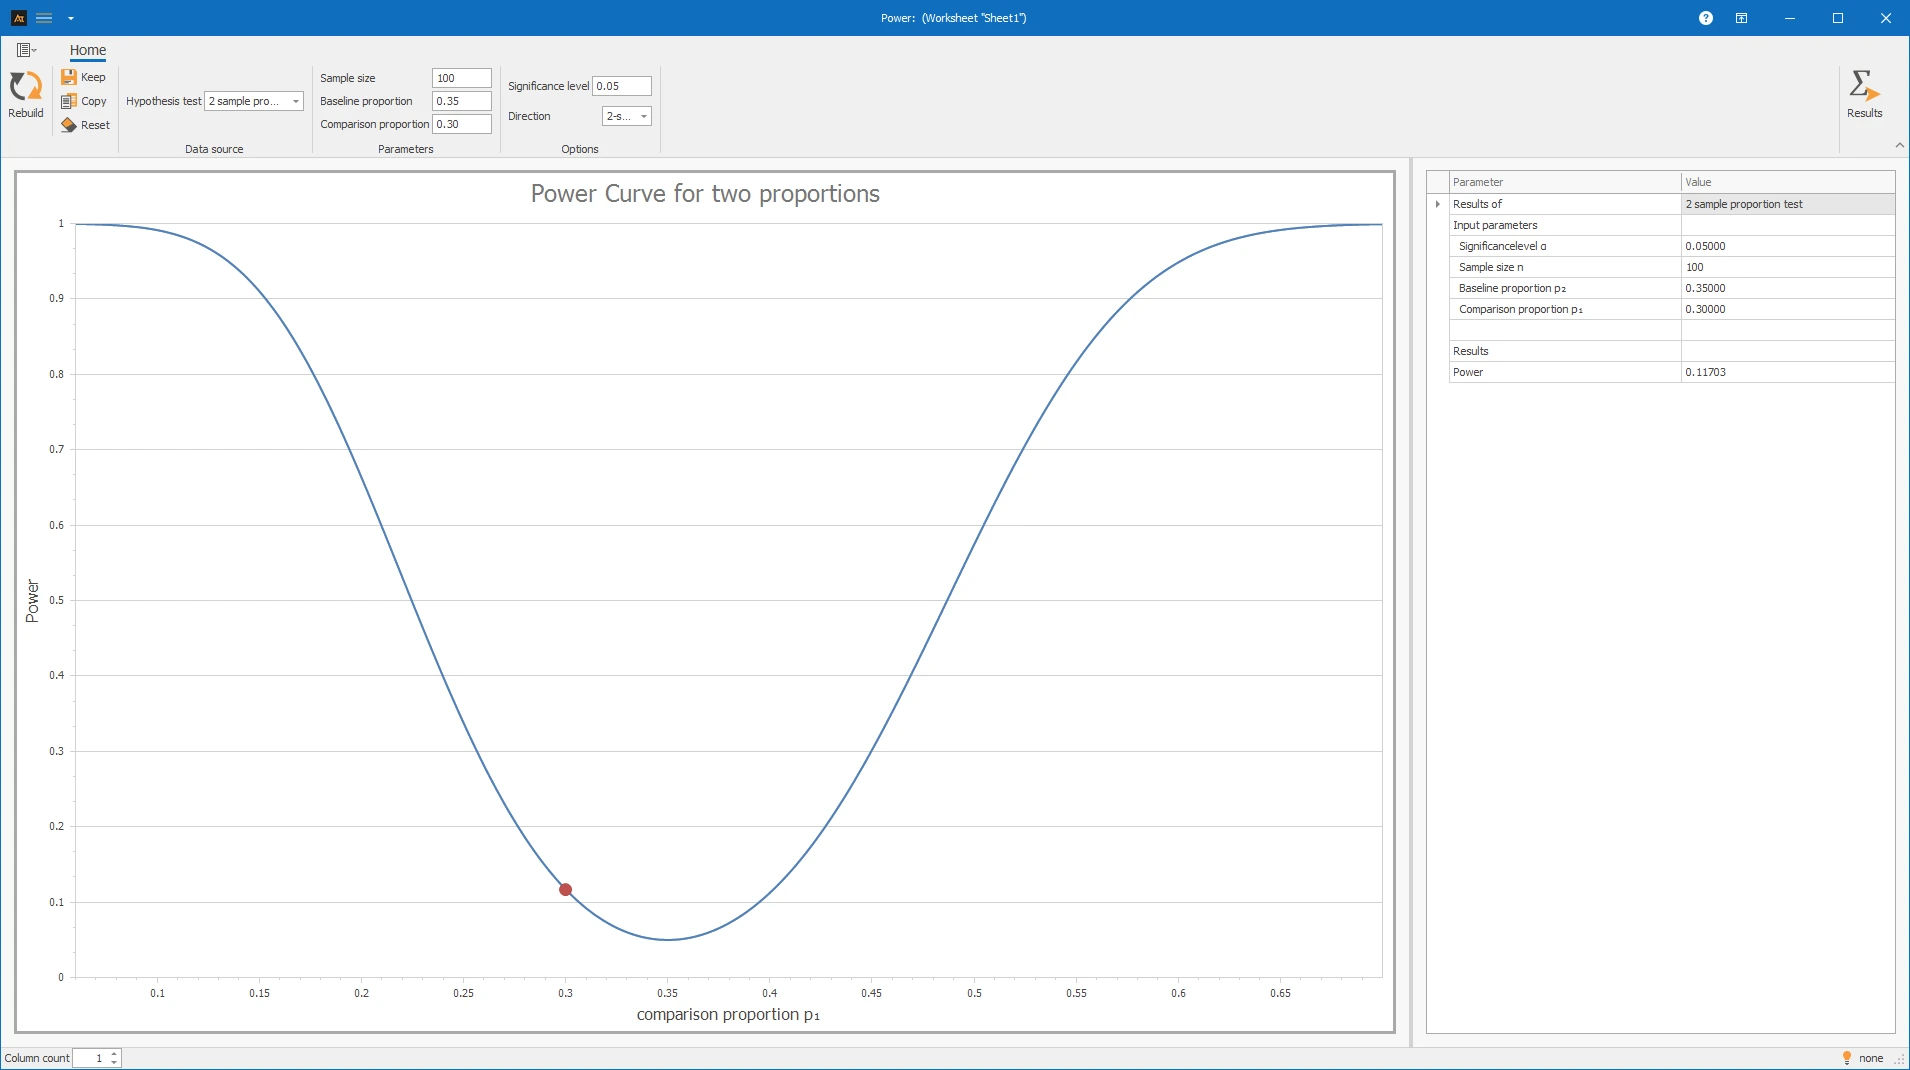
Ora, utilizzando il calcolo della potenza, si dovrebbe determinare se un cambiamento dal 35% al 30% verrebbe rilevato.
Interpretazione
La potenza indica la probabilità con cui il test rileva un cambiamento rilevante nel tasso di perdita. La potenza è bassa a 0.11703. Questo corrisponde a un errore β di circa 88.3%. Il fatto che non sia stata rilevata una differenza significativa con il test delle proporzioni può essere dovuto al fatto che sono state valutate troppe poche offerte.
Tempo di consegna dopo il centro logistico
Nel reparto logistico, gli ordini dei clienti vengono preparati e spediti. Per aumentare l'efficienza, sono stati introdotti nuovi carrelli elevatori.
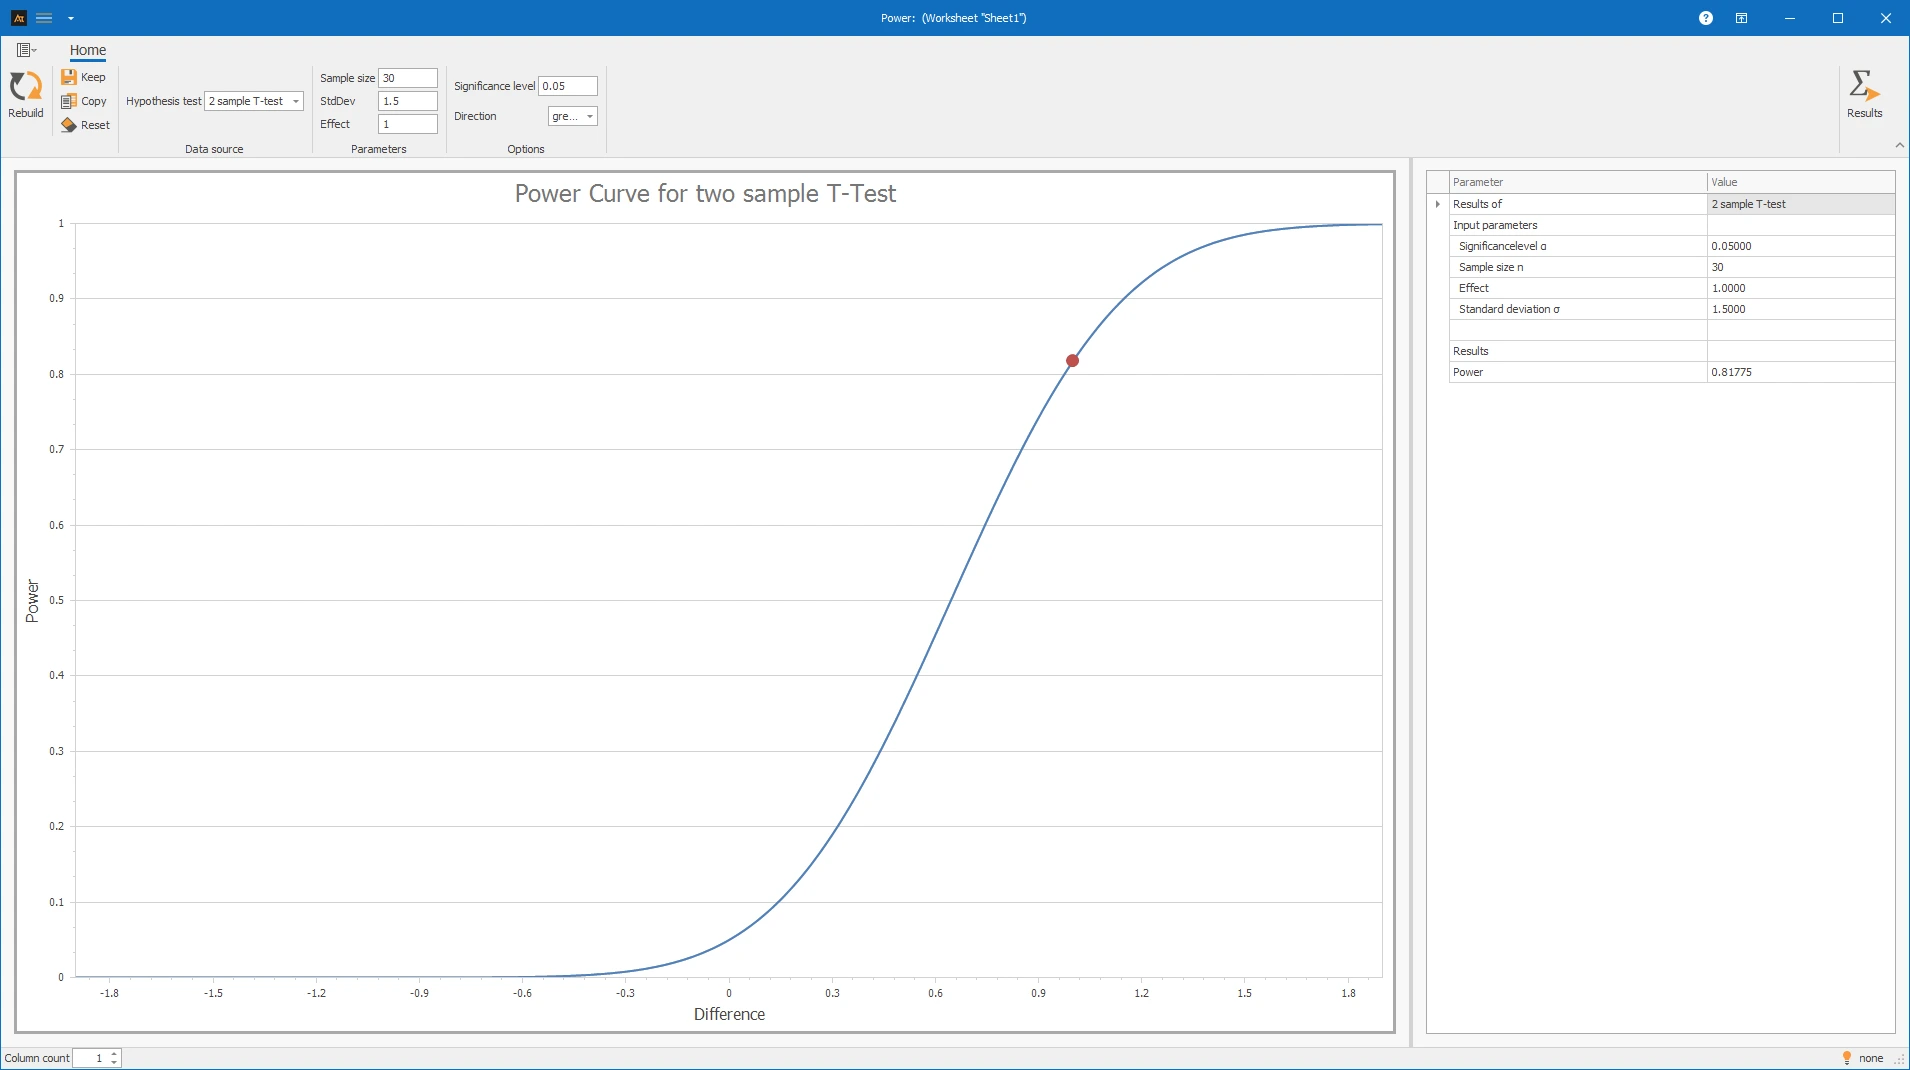
Si dovrebbe indagare se un miglioramento del tempo di consegna di 1 giorno può essere rilevato con un test t unilaterale. La variazione del tempo di consegna è stimata in 2,5 giorni. Devono essere effettuate 30 misurazioni.
Interpretazione
La potenza è 81,775%. Pertanto, una differenza di 1 giorno può essere rilevata con una potenza di circa 81,8%. L'errore β è di circa 18,2%. Una potenza di almeno l'80% è spesso utilizzata come linea guida. Tuttavia, dovrebbe essere determinato in anticipo quale potenza minima dovrebbe essere raggiunta.
Confronto tra fornitori
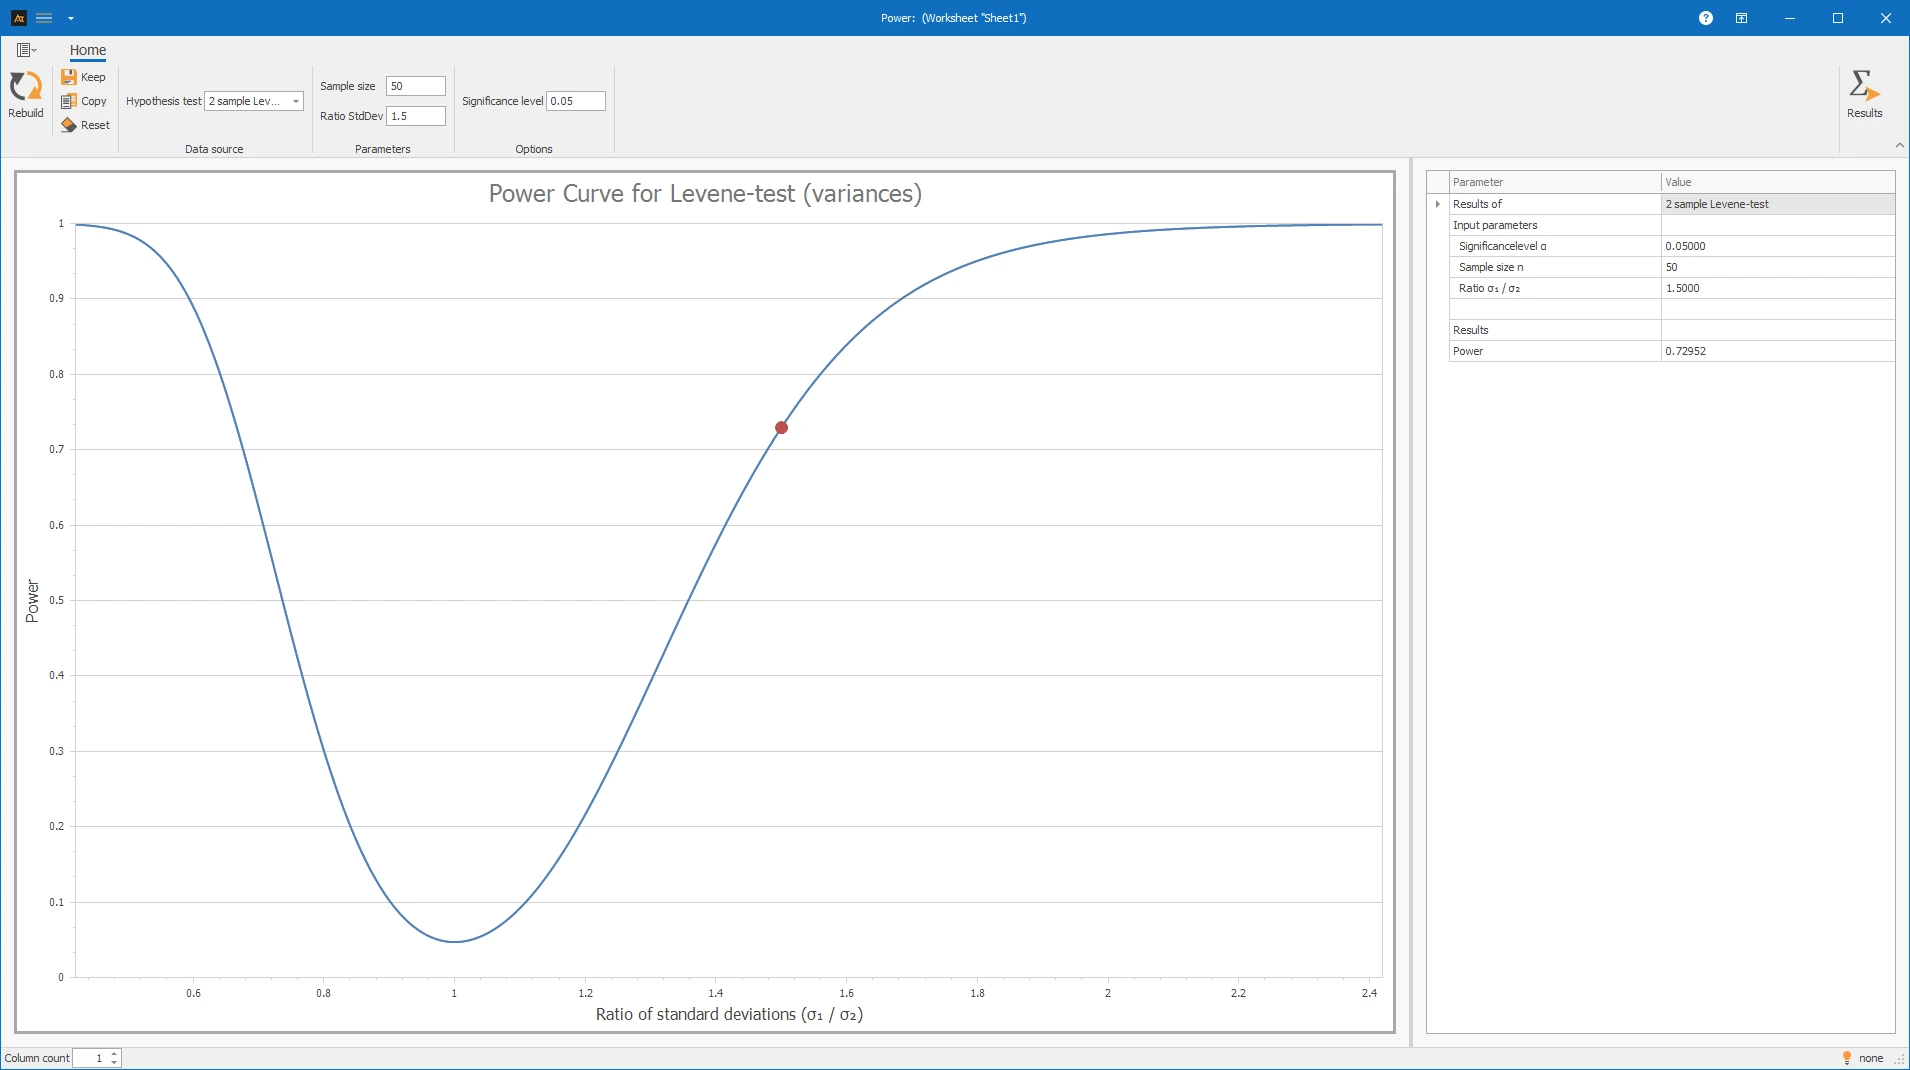
Nell'acquisto, i componenti sono acquistati da più fornitori. Si dovrebbe valutare se i test esistenti siano sufficienti per rilevare una differenza di 1,5 volte nella deviazione standard tra i fornitori. Ci sono 50 set di dati per fornitore.
Interpretazione
La sensibilità aiuta a valutare se il numero esistente di consegne sia sufficiente per rilevare in modo affidabile le differenze rilevanti tra i fornitori. Con bassa sensibilità, l'errore β sarebbe elevato; una differenza effettivamente esistente potrebbe quindi rimanere non rilevata.
Deviazione della previsione
Nella pianificazione della produzione, le previsioni della domanda vengono create per diversi periodi di pianificazione. Per valutare la qualità della previsione, viene calcolata la deviazione della previsione.
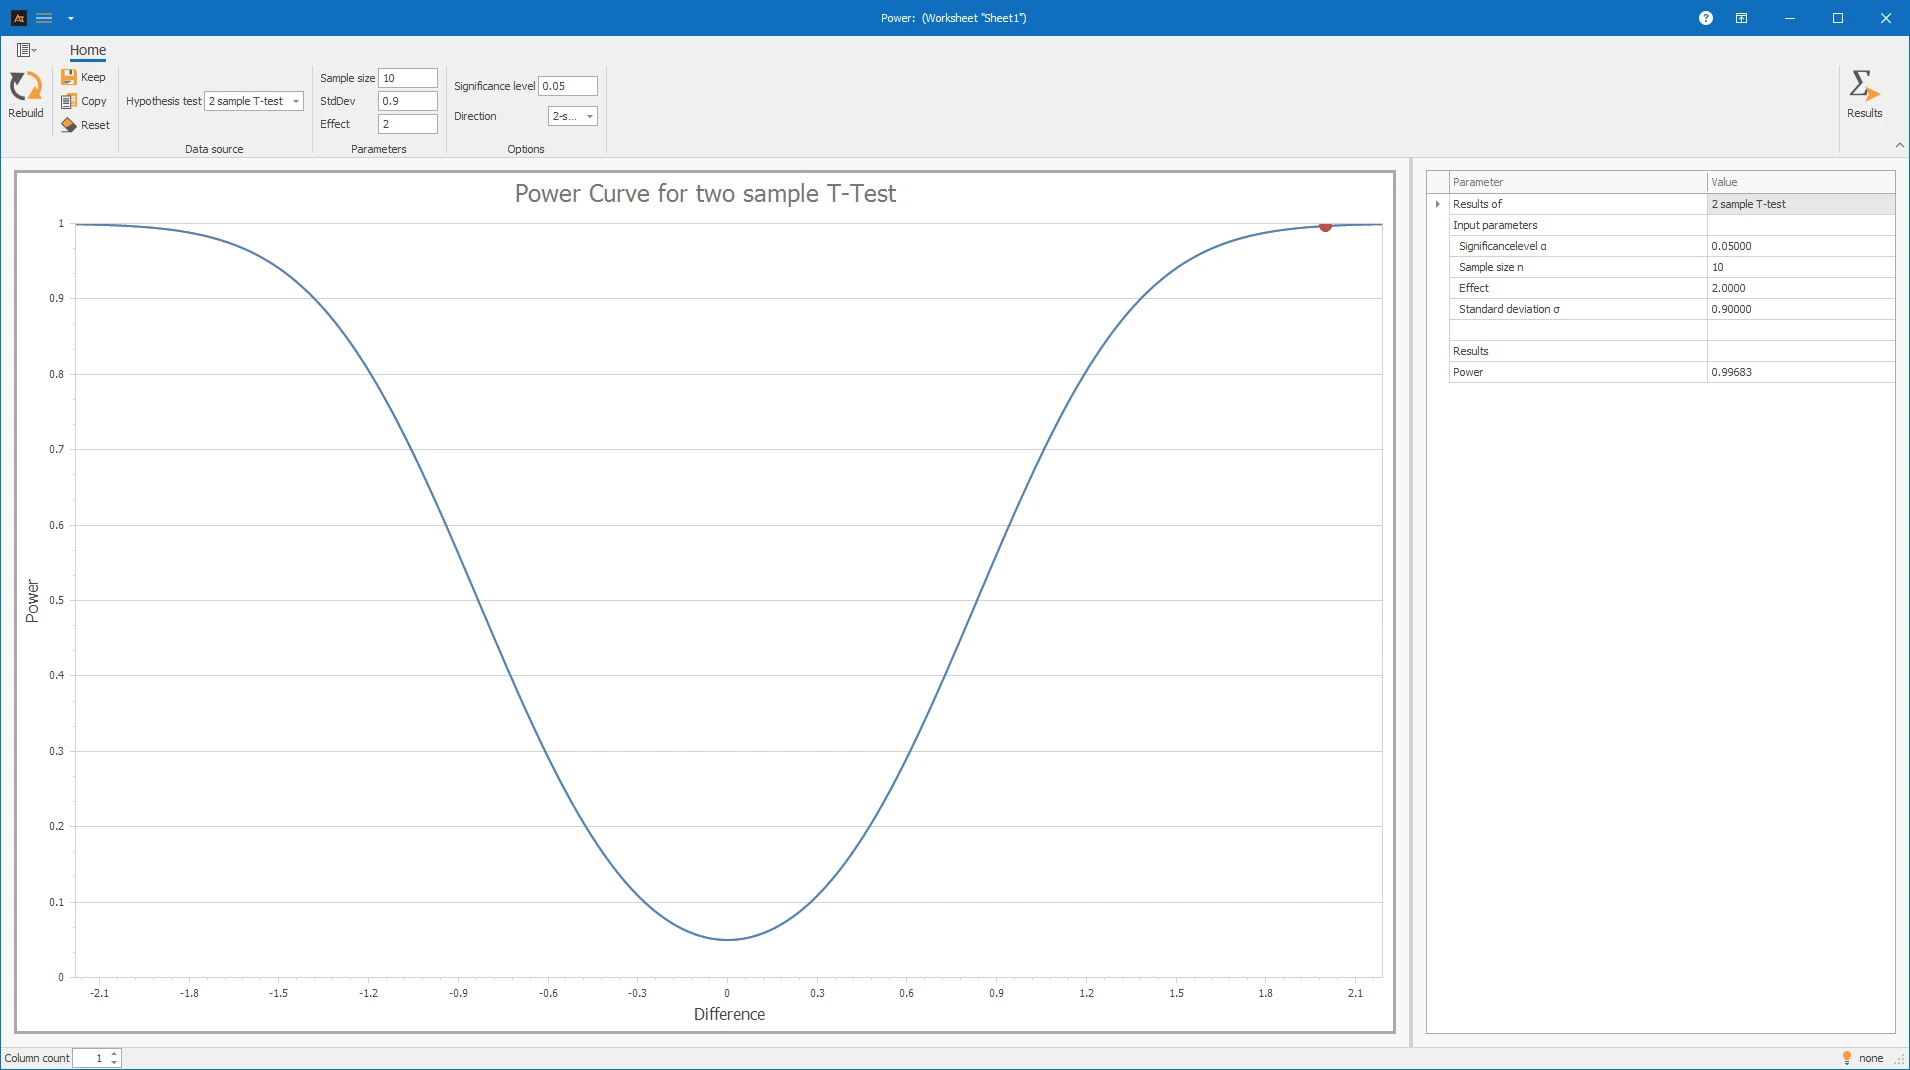
Si dovrebbe valutare se il campione esistente è sufficiente per rilevare differenze tra orizzonti di pianificazione a breve e lungo termine con un test t. Dovrebbe essere rilevata una differenza del 2%. La deviazione standard è nota da analisi precedenti ed è dello 0,9%. Per ciascun orizzonte, dovrebbero essere create e confrontate 10 previsioni.
Interpretazione
Con il test t, una differenza del 2% può essere rilevata in modo affidabile se la deviazione standard è dello 0,9%. La potenza è del 99,68%. L'errore β è quindi approssimativamente dello 0,32%.
Potere discriminatorio / Potere: Probabilità con cui un test rileva un effetto effettivamente esistente.
Effetto: Differenza praticamente rilevante, ad esempio, differenza media, rapporto di varianza o cambiamento nelle probabilità.
n = Dimensione del campione: Numero di osservazioni, parti, offerte o prove all'interno di un gruppo.
α = Livello di significatività: Probabilità di errore preimpostata con cui l'ipotesi nulla viene erroneamente respinta.
β = Errore di tipo II: Probabilità di non rilevare un effetto effettivamente esistente.
Potere = 1 - β: Contro-probabilità all'errore di tipo II.
x̄ = Media del campione: Valore medio dei dati di misurazione raccolti.
s = Deviazione standard del campione: Misura della dispersione dei dati attorno alla media.
p̂ = Proporzione del campione: Proporzione di eventi in un campione; calcolata come eventi / numero di prove.
Evento: Il caso di interesse in un'analisi di proporzione, ad esempio, perdita, smarrito, in orario o superato.
Fattore: Variabile influenzante categorica in ANOVA, ad esempio, centro logistico, fornitore o formulazione.
Gruppi / Livelli: Manifestazioni del fattore, ad esempio, Centro A, Centro B e Centro C.
Due lati: Si verifica se una differenza può essere rilevata in entrambe le direzioni.
Maggiore: Si verifica se un effetto può essere rilevato nella direzione di valori maggiori.
Inferiore: Si verifica se un effetto può essere rilevato nella direzione di valori minori.
Le seguenti formule descrivono la logica di calcolo della potenza discriminante utilizzata nello strumento. Le funzioni di distribuzione e quantile richieste non sono implementate manualmente ma vengono valutate utilizzando le librerie statistiche CenterSpace NMath e – come specificato – Numerics.NET.
Principio di base
Il potere discriminante, chiamato anche potenza, descrive la probabilità che un test statistico rilevi un effetto effettivamente esistente.
Una potenza discriminante elevata significa che un effetto esistente viene rilevato con alta probabilità. Una potenza discriminante bassa significa che l'errore β è corrispondentemente maggiore.
T-Test per due campioni
Nel t-test per due campioni, viene calcolata la probabilità di rilevare una differenza presunta tra due medie. Lo strumento assume campioni di dimensioni uguali.
Il parametro di non centralità è:
I gradi di libertà sono:
Per il calcolo, vengono utilizzati i quantili della distribuzione t centrale e la funzione di distribuzione della distribuzione t non centrale. Queste funzioni sono valutate utilizzando CenterSpace NMath. Ft,v,λ(x) denota la funzione di distribuzione della distribuzione t non centrale.
Potenza = 1 − Ft,v,λ(t1−α,v)
Potenza = Ft,v,λ(tα,v)
Potenza = Ft,v,λ(tα/2,v) + 1 − Ft,v,λ(t1−α/2,v)
F-Test per due varianze
Nel test F, viene determinata la potenza discriminante per una differenza presunta tra le varianze di due gruppi. Lo strumento utilizza il rapporto delle deviazioni standard come input:
Per il calcolo, viene formato il rapporto delle varianze:
Per campioni di dimensioni uguali, si applicano i seguenti gradi di libertà:
I quantili richiesti e le funzioni di distribuzione della distribuzione F sono valutati utilizzando CenterSpace NMath. Fk1,k2(x) denota la funzione di distribuzione della distribuzione F.
Potenza = 1 − Fk1,k2 (F1−α,k1,k2 / ρ²)
Potenza = Fk1,k2 (Fα,k1,k2 / ρ²)
Potenza = Fk1,k2 (Fα/2,k1,k2 / ρ²) + 1 − Fk1,k2 (F1−α/2,k1,k2 / ρ²)
Test di Levene per due varianze
Per il calcolo della potenza del test di Levene, lo strumento utilizza un'approssimazione basata sul rapporto delle deviazioni standard.
I gradi di libertà della distribuzione t utilizzata sono:
Il valore critico t è determinato utilizzando la funzione quantile della distribuzione t:
Inoltre, il calcolo utilizza le seguenti quantità ausiliarie:
c = √(π/2 − 1)
SE = c·√(ρ²/n₁ + 1/n₂)
Da questo, vengono determinati i due valori z:
z₂ = −tkrit/θ − (ρ−1)/SE
La potenza è quindi determinata utilizzando la distribuzione normale standard. Le funzioni di distribuzione t e normale sono valutate utilizzando CenterSpace NMath.
Test delle proporzioni per due campioni
Nel test delle proporzioni, viene calcolata la probabilità di rilevare una differenza effettiva tra due proporzioni.
La differenza nelle proporzioni è:
La proporzione comune per il calcolo sotto l'ipotesi nulla è:
L'errore standard sotto l'ipotesi nulla è:
L'errore standard sotto l'ipotesi alternativa è:
I quantili e la funzione di distribuzione della distribuzione normale standard sono valutati utilizzando CenterSpace NMath.
Potenza = Φ((d − z1−α·SE₀) / SE₁)
Potenza = 1 − Φ((d + z1−α·SE₀) / SE₁)
Potenza = 1 − Φ((d + z1−α/2·SE₀) / SE₁) + Φ((d − z1−α/2·SE₀) / SE₁)
ANOVA a una via
L'ANOVA a una via verifica se le medie di diversi gruppi differiscono.
H₁: Almeno una media di gruppo differisce.
Nello strumento, la differenza massima tra le medie dei gruppi è utilizzata come effetto:
Per il calcolo del parametro di non centralità, si assume che due gruppi formino la distanza massima Δ. Il parametro di non centralità utilizzato nello strumento è:
I gradi di libertà sono:
Il quantile F critico è determinato utilizzando CenterSpace NMath:
Per la valutazione della distribuzione F non centrale, viene utilizzato lo strumento Numerics.NET.
Test t a campione singolo
Nel test t a campione singolo, la potenza è calcolata per un dato effetto, una dimensione del campione e una deviazione standard presunta.
Il parametro di non centralità è:
I gradi di libertà sono:
I quantili richiesti della distribuzione t e la funzione di distribuzione della distribuzione t non centrale sono valutati utilizzando CenterSpace NMath.
Potenza = 1 − Ft,v,λ (t1−α,v)
Potenza = Ft,v,λ (tα,v)
Potenza = Ft,v,λ (tα/2,v) + 1 − Ft,v,λ (t1−α/2,v)
Test di varianza a campione singolo
Nel test di varianza a campione singolo, la potenza è determinata per un rapporto presunto tra la deviazione standard effettiva e la deviazione standard ipotetica.
Il rapporto al quadrato è utilizzato per il calcolo:
I gradi di libertà della distribuzione chi-quadro sono:
I quantili richiesti e le funzioni di distribuzione della distribuzione chi-quadro sono valutati utilizzando CenterSpace NMath.
Potenza = 1 − Fχ²,v (χ²1−α,v / r²)
Potenza = Fχ²,v (χ²α,v / r²)
Potenza = Fχ²,v (χ²α/2,v / r²) + 1 − Fχ²,v (χ²1−α/2,v / r²)
Test di proporzione a campione singolo
Nel test di proporzione, la potenza è calcolata per una proporzione di confronto effettiva p rispetto a una proporzione ipotetica p₀.
L'errore standard sotto l'ipotesi nulla è:
L'errore standard sotto l'ipotesi alternativa è:
I quantili richiesti e le funzioni di distribuzione della distribuzione normale standard sono valutati utilizzando CenterSpace NMath.
Potenza = Φ((d − z1−α·SE₀) / SE₁)
Potenza = Φ((−d − z1−α·SE₀) / SE₁)
Potenza = Φ((d − z1−α/2·SE₀) / SE₁) + Φ((−d − z1−α/2·SE₀) / SE₁)