


Der Test auf Varianzen dient dazu, zu prüfen, ob sich die Streuungen von zwei oder mehr Gruppen statistisch signifikant unterscheiden. Er beantwortet damit nicht die Frage, ob sich Mittelwerte unterscheiden, sondern ob die Varianzen bzw. Standardabweichungen vergleichbar sind.
Das Tool ist besonders hilfreich, wenn beurteilt werden soll, ob mehrere Prozesse, Rezepturen, Maschinen oder Gruppen ähnlich stabil arbeiten oder ob eine Gruppe deutlich stärker streut als die anderen.
Die Entscheidung erfolgt über den Vergleich des p-Wertes mit dem festgelegten Signifikanzniveau (in der Regel α = 0,05):
- p > α → H₀ beibehalten; es gibt keinen signifikanten Hinweis auf unterschiedliche Varianzen.
- p ≤ α → H₀ verwerfen; es gibt einen signifikanten Unterschied in den Varianzen.

In der Produktentwicklung werden mehrere Rezepturen für Tomatensoße getestet. Für dieselben Viskositätsdaten wird nun nicht geprüft, ob sich die Mittelwerte unterscheiden, sondern ob die Streuung der Viskosität zwischen den Rezepturen unterschiedlich groß ist.
Hierzu werden Viskositätsmessungen an Proben der Rezeptur A, Rezeptur B und Rezeptur C durchgeführt. Die Messwerte der Gruppen werden unabhängig voneinander erhoben und jeweils als Stichprobe betrachtet.
Mithilfe des Tests auf Varianzen soll geprüft werden, ob die Rezepturen eine vergleichbare Prozessstreuung besitzen oder ob mindestens eine Rezeptur deutlich variabler ist.
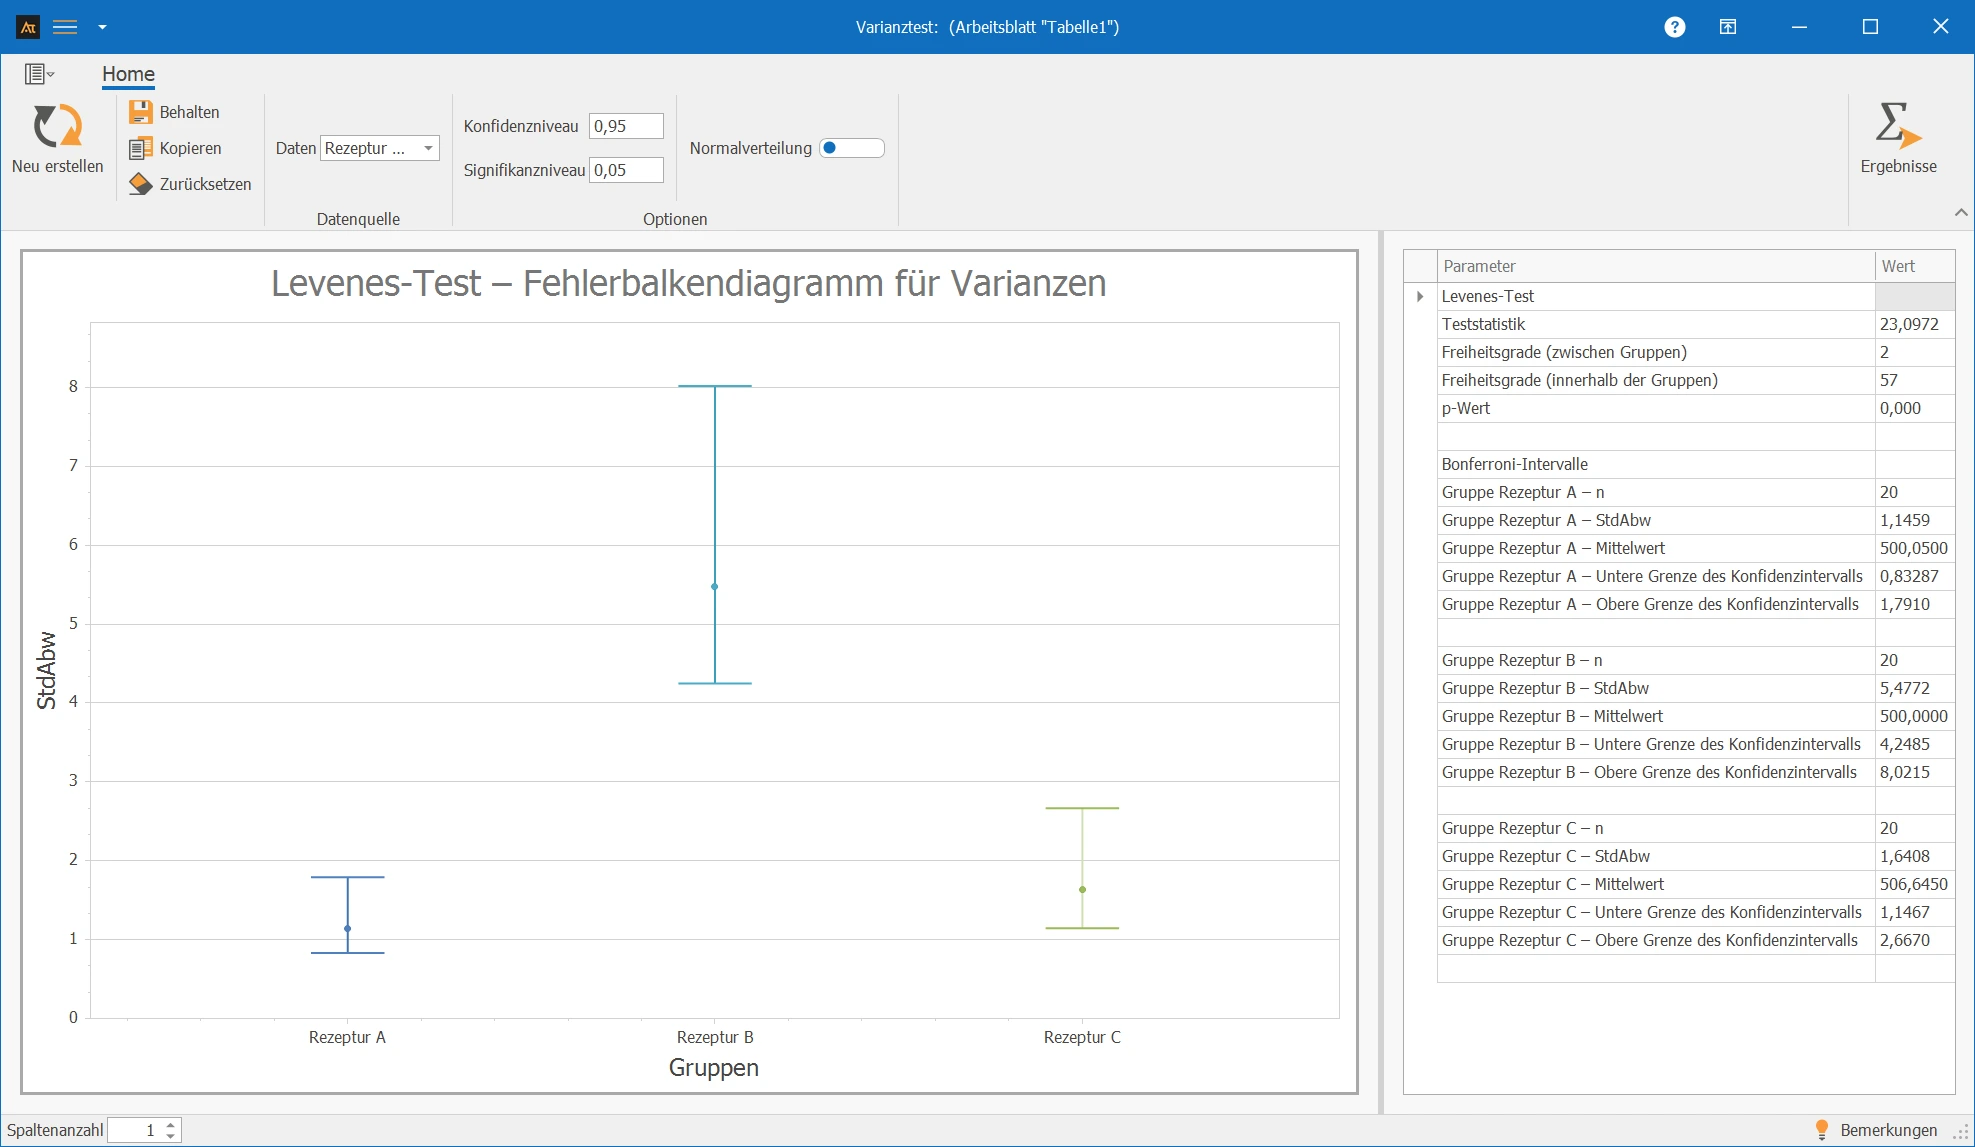
Interpretation der Ergebnisse:
Der p-Wert wird mit dem Signifikanzniveau von 0,05 verglichen. Da der p-Wert in diesem Beispiel als 0,000 angezeigt wird, liegt er unter 0,05. Die Nullhypothese gleicher Varianzen wird daher verworfen.
Das bedeutet: Die Rezepturen unterscheiden sich nicht nur möglicherweise in ihrer mittleren Viskosität, sondern auch in der Streuung der Viskositätswerte. Mindestens eine Rezeptur zeigt eine deutlich andere Streuung als die übrigen Rezepturen.
Für die Produktentwicklung ist das wichtig, weil eine Rezeptur mit hoher Streuung weniger stabil ist. Auch wenn der Mittelwert grundsätzlich im gewünschten Bereich liegt, können einzelne Chargen deutlich dünnflüssiger oder dickflüssiger ausfallen. Eine Rezeptur mit geringerer Streuung ist dagegen besser beherrschbar und liefert gleichmäßigere Produkteigenschaften.
Das Fehlerbalkendiagramm zeigt die Standardabweichungen der Rezepturen mit den zugehörigen Bonferroni-Konfidenzintervallen. Rezepturen mit größeren Standardabweichungen weisen eine stärkere Schwankung der Viskosität auf. Die endgültige statistische Entscheidung erfolgt jedoch über den p-Wert.
Erklärungen zur Grafik:
- Die Punkte markieren die Standardabweichungen der Viskosität für die einzelnen Rezepturen.
- Die Fehlerbalken stellen Konfidenzintervalle der Standardabweichungen dar. Bei aktivierter Normalverteilung werden Bonferroni-Intervalle verwendet, ohne aktivierte Normalverteilung Bonett-Intervalle.
- Überlappungen der Intervalle geben einen ersten visuellen Hinweis. Die abschließende Entscheidung erfolgt über den p-Wert.
Im Folgenden finden Sie die Überlegungen und Schritte, die notwendig sind, um einen Test auf Varianzen für zwei oder mehr Stichproben durchzuführen.
Vorarbeit
- Eine stetige Messgröße auswählen (z. B. Viskosität).
- Zwei oder mehr Gruppen festlegen, deren Streuungen verglichen werden sollen (z. B. Rezeptur A, B und C).
- Signifikanzniveau festlegen (in der Regel α = 0,05).
- Konfidenzniveau festlegen (in der Regel 95 %).
- Prüfen, ob die Messwerte unabhängig voneinander erhoben wurden.
- Entscheiden, ob mit Normalverteilung gerechnet werden soll. Ohne aktivierte Normalverteilung verwendet das Tool den Levene-Test; bei aktivierter Normalverteilung wird bei zwei Gruppen der F-Test und bei mehr als zwei Gruppen der Bartlett-Test verwendet.
 Nutzung in AlphadiTab
- In der Analyze-Phase das Tool Test auf Varianzen auswählen.
- Bei Daten alle zu vergleichenden Gruppen auswählen.
- Das Konfidenzniveau und das Signifikanzniveau einstellen.
- Optional Normalverteilung aktivieren, wenn die Normalverteilungsannahme fachlich begründet ist.
- Die Analyse durch „Neu erstellen“ durchführen.
Interpretation
- Prüfen, welcher Test angewendet wurde: Levene-Test, F-Test oder Bartlett-Test.
- Prüfen, ob der p-Wert kleiner oder gleich dem Signifikanzniveau ist.
- p ≤ α → statistisch signifikanter Unterschied zwischen mindestens zwei Varianzen bzw. Standardabweichungen.
- p > α → kein statistisch signifikanter Unterschied zwischen den Varianzen bzw. Standardabweichungen.
Wichtig: Der Test auf Varianzen prüft zunächst die Streuungen. Er trifft keine Aussage darüber, ob die Mittelwerte der Gruppen unterschiedlich sind.
Abfüllmenge Tomatensoße – Maschine A, Maschine B und Maschine C
In der Produktion werden drei Abfüllmaschinen eingesetzt. Es soll untersucht werden, ob die Abfüllmengen der Maschinen unterschiedlich stark streuen. Während eine ANOVA die mittleren Abfüllmengen vergleicht, prüft der Test auf Varianzen die Streuung der Maschinen.
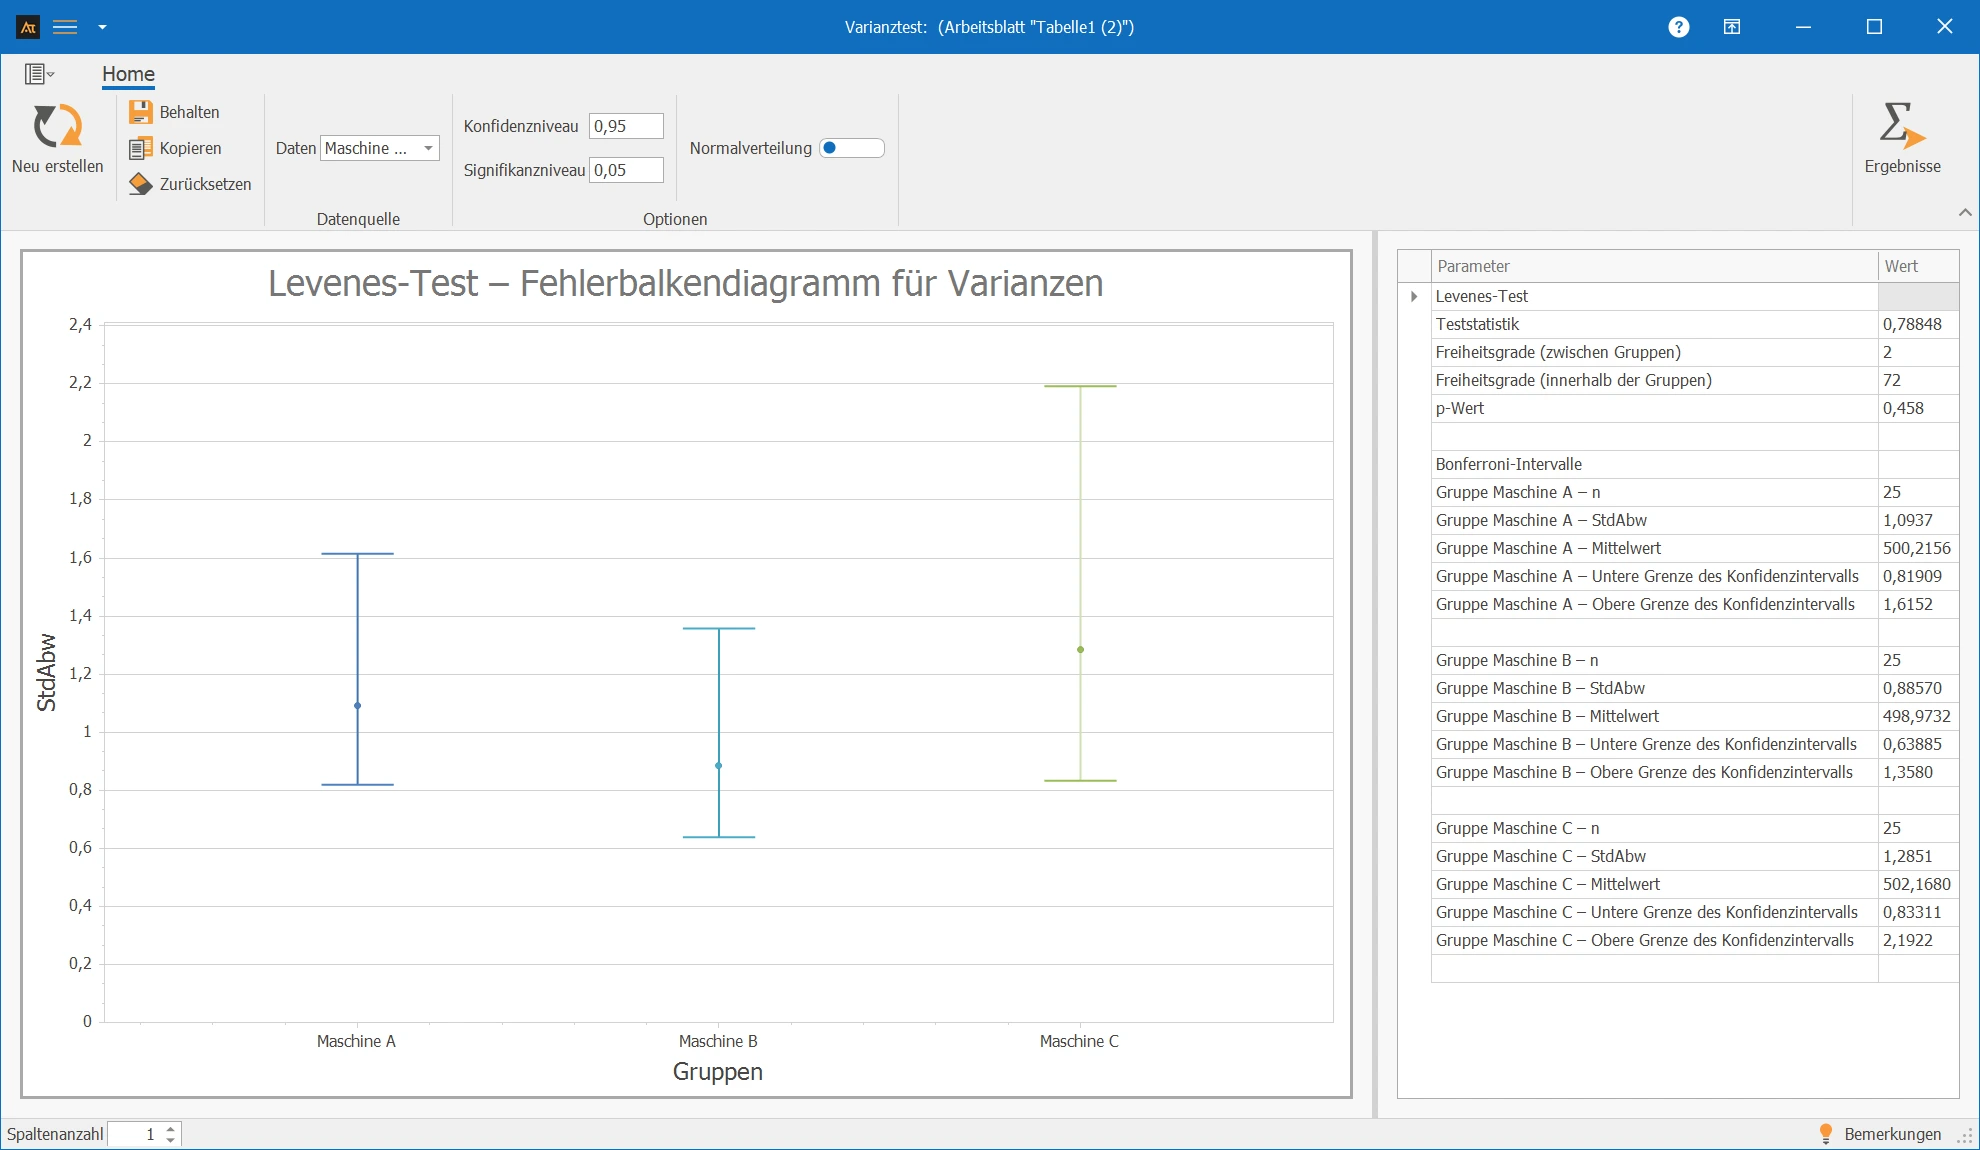
Interpretation
Der p-Wert liegt über 0,05. Die Nullhypothese gleicher Varianzen wird daher nicht verworfen.
Die Abfüllmengen der Maschinen streuen statistisch nicht signifikant unterschiedlich. Die Maschinen arbeiten hinsichtlich ihrer Schwankung vergleichbar stabil. Unterschiede in den Mittelwerten müssten separat geprüft werden.
Reaktionszeit des IT-Helpdesks vs. Standort
Im IT-Service-Desk werden Tickets an mehreren Standorten bearbeitet. Es soll geprüft werden, ob die Reaktionszeiten an den Standorten unterschiedlich stark streuen. Eine hohe Streuung kann auf uneinheitliche Serviceprozesse oder stark schwankende Auslastung hinweisen.
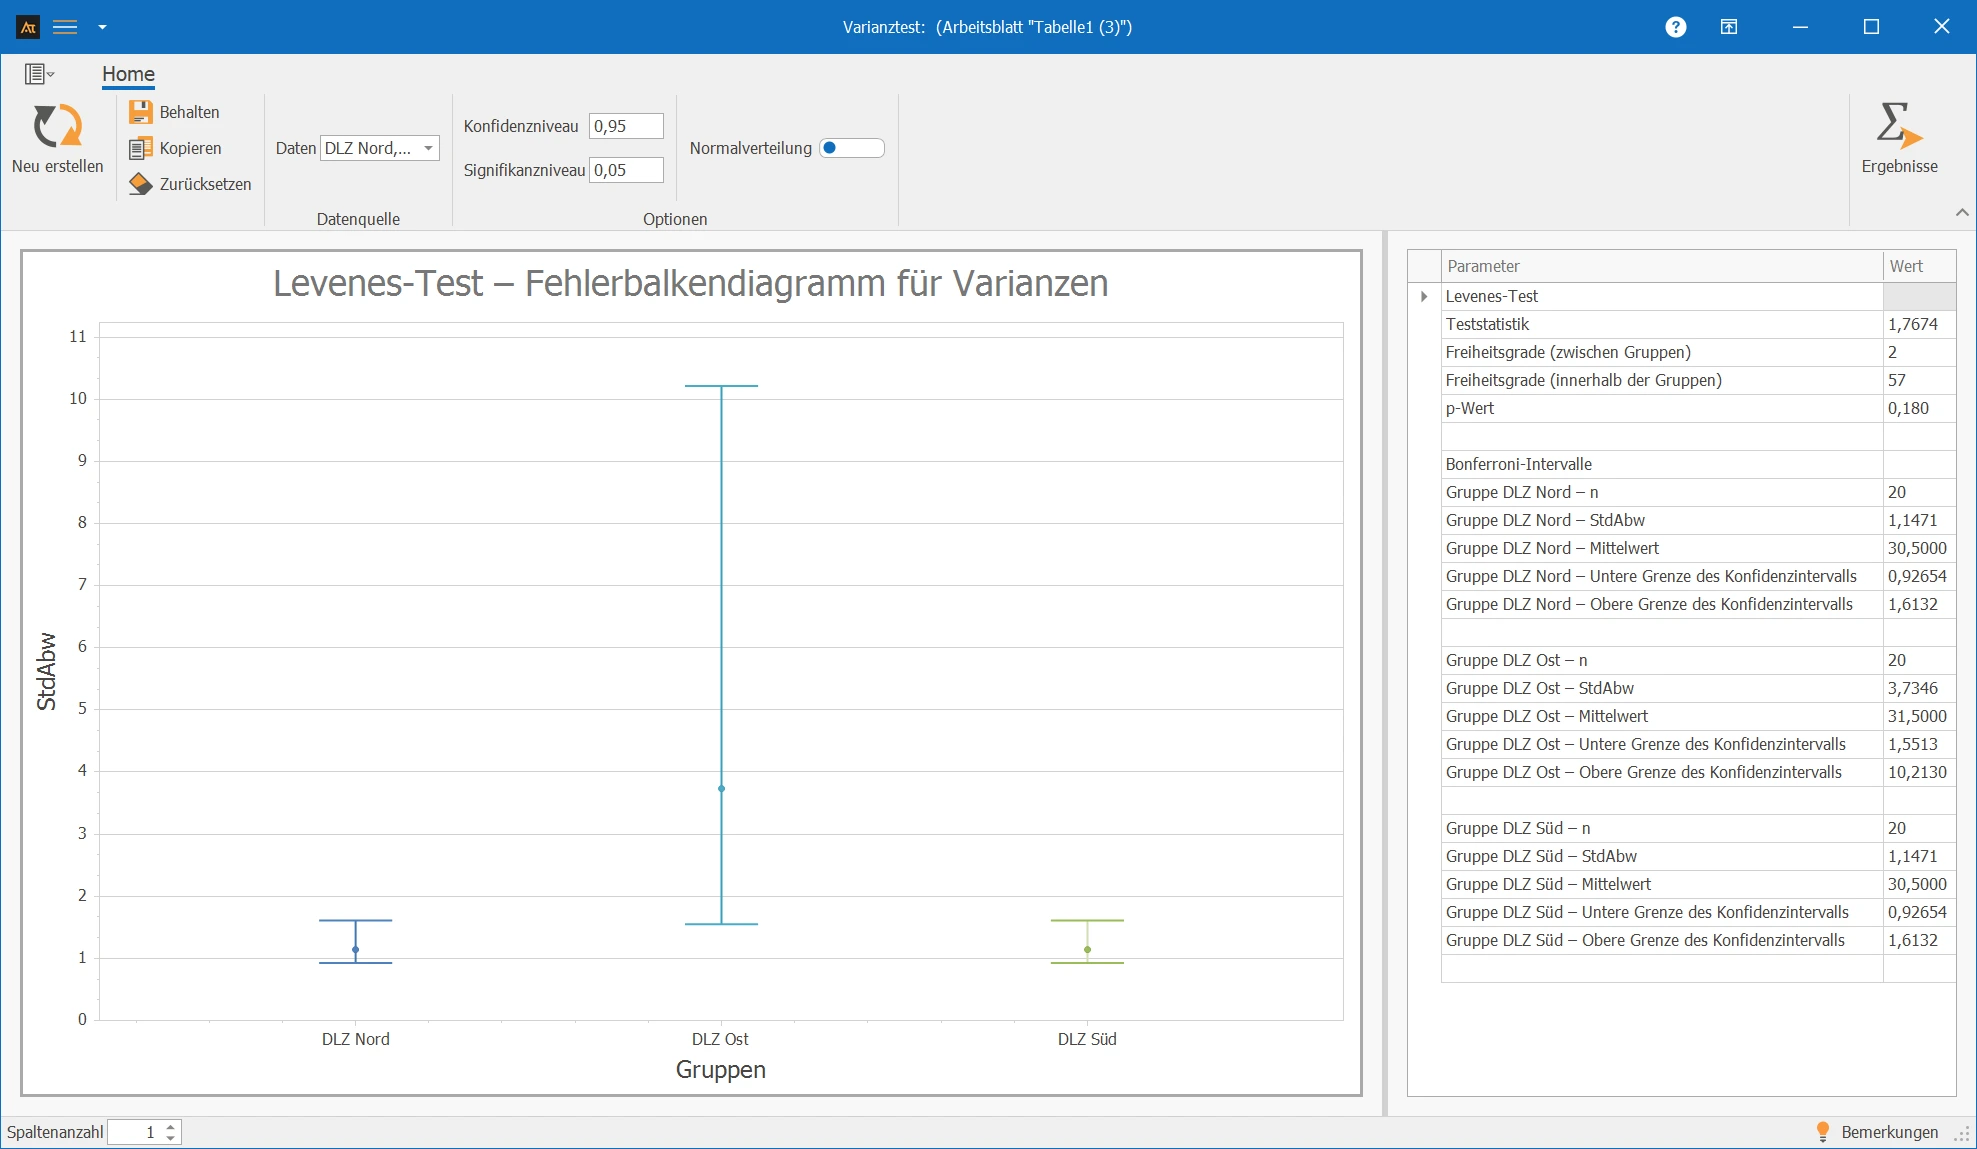
Interpretation
Der p-Wert liegt über 0,05. Die Nullhypothese gleicher Varianzen wird nicht verworfen.
Die Reaktionszeiten der Standorte streuen statistisch nicht signifikant unterschiedlich. Ein breites Konfidenzintervall im Diagramm weist eher auf eine unsichere Schätzung hin, zum Beispiel durch kleine Stichprobe oder einzelne Ausreißer. Ein sicherer Unterschied der Streuungen lässt sich daraus nicht ableiten.
Durchlaufzeit nach Region
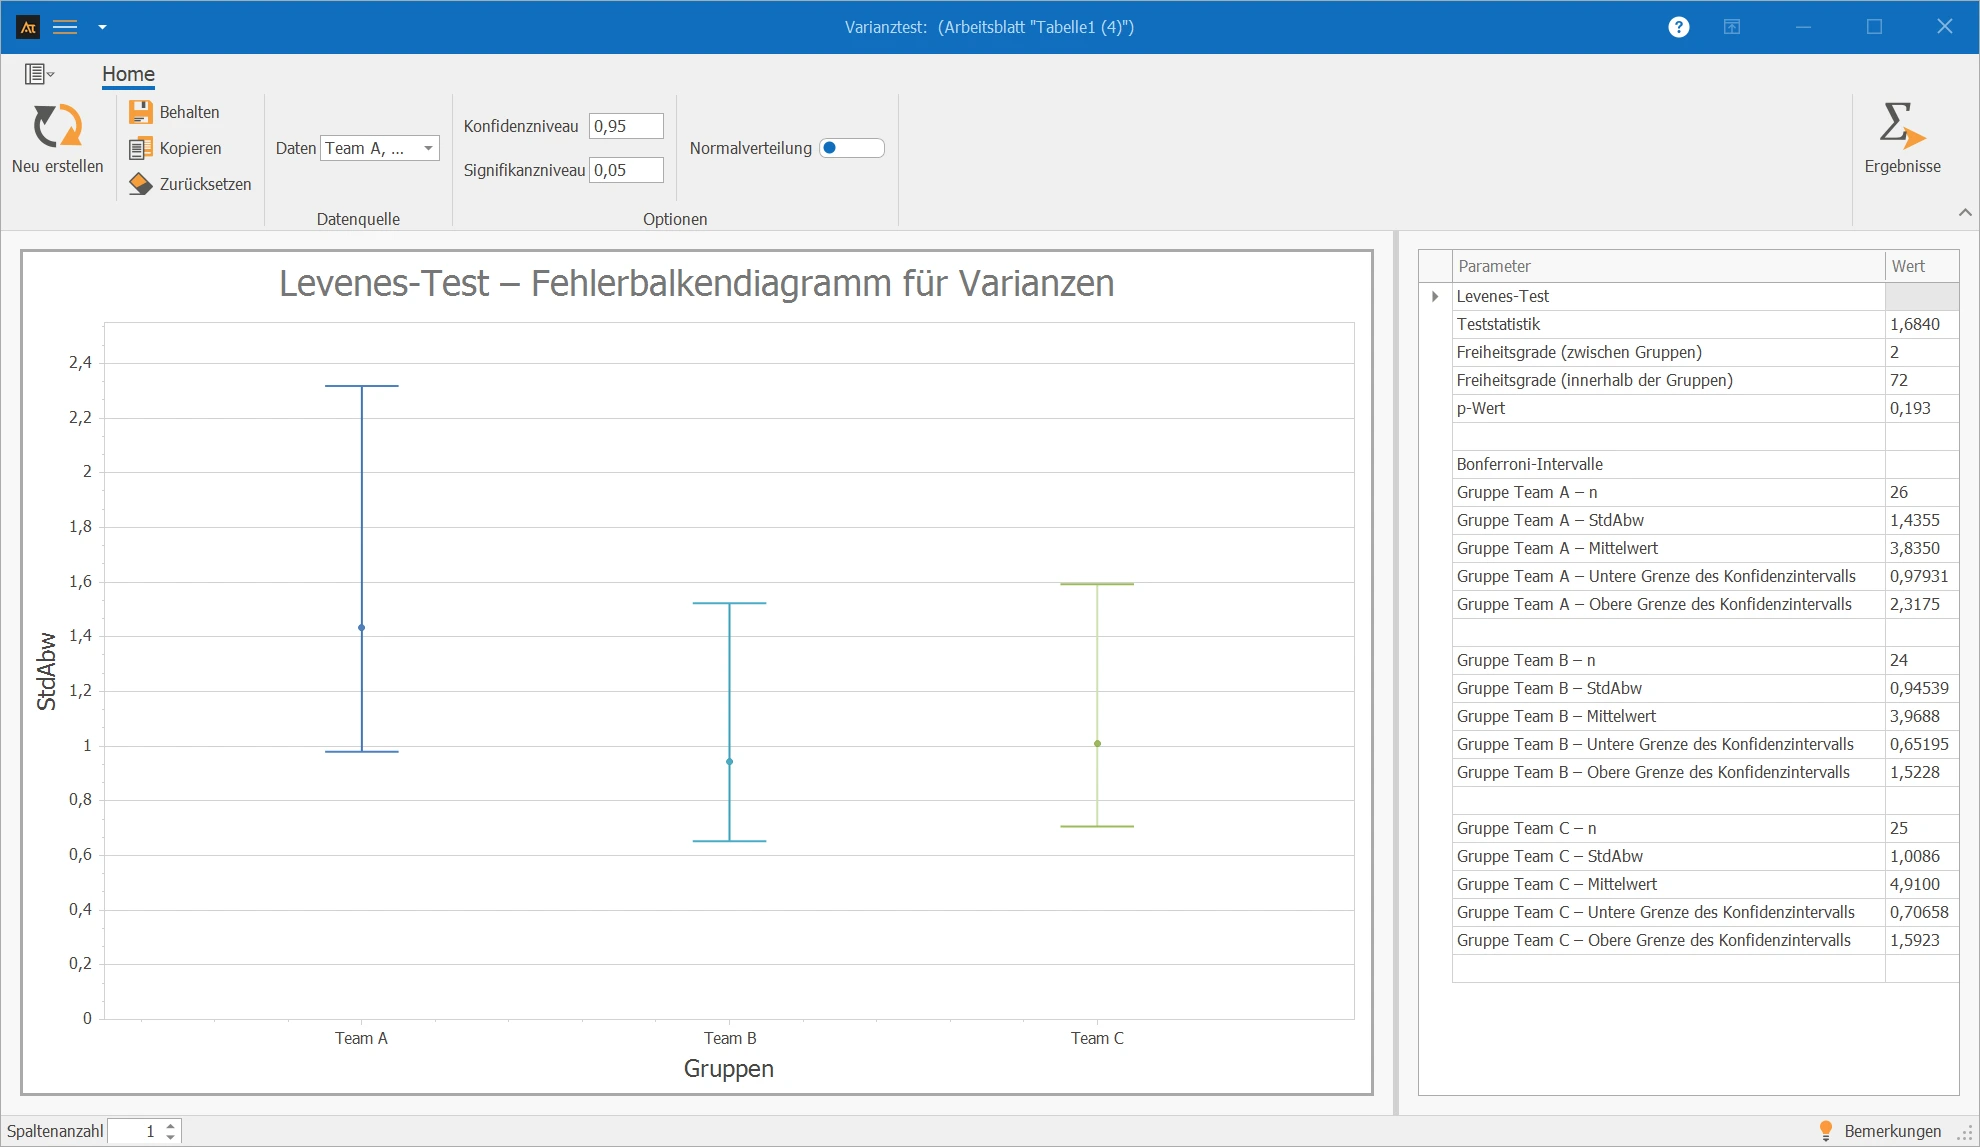
Im Vertrieb werden Kundenangebote von mehreren Teams bearbeitet. Neben der mittleren Durchlaufzeit ist auch interessant, ob die Bearbeitungsdauer gleichmäßig oder stark schwankend ist.
Interpretation
Der p-Wert liegt über 0,05. Die Nullhypothese gleicher Varianzen wird nicht verworfen.
Die Durchlaufzeiten der Teams streuen statistisch nicht signifikant unterschiedlich. Es gibt somit keinen Hinweis darauf, dass ein Team deutlich ungleichmäßiger oder weniger planbar arbeitet als die anderen.
Lieferzeit nach Logistikzentrum
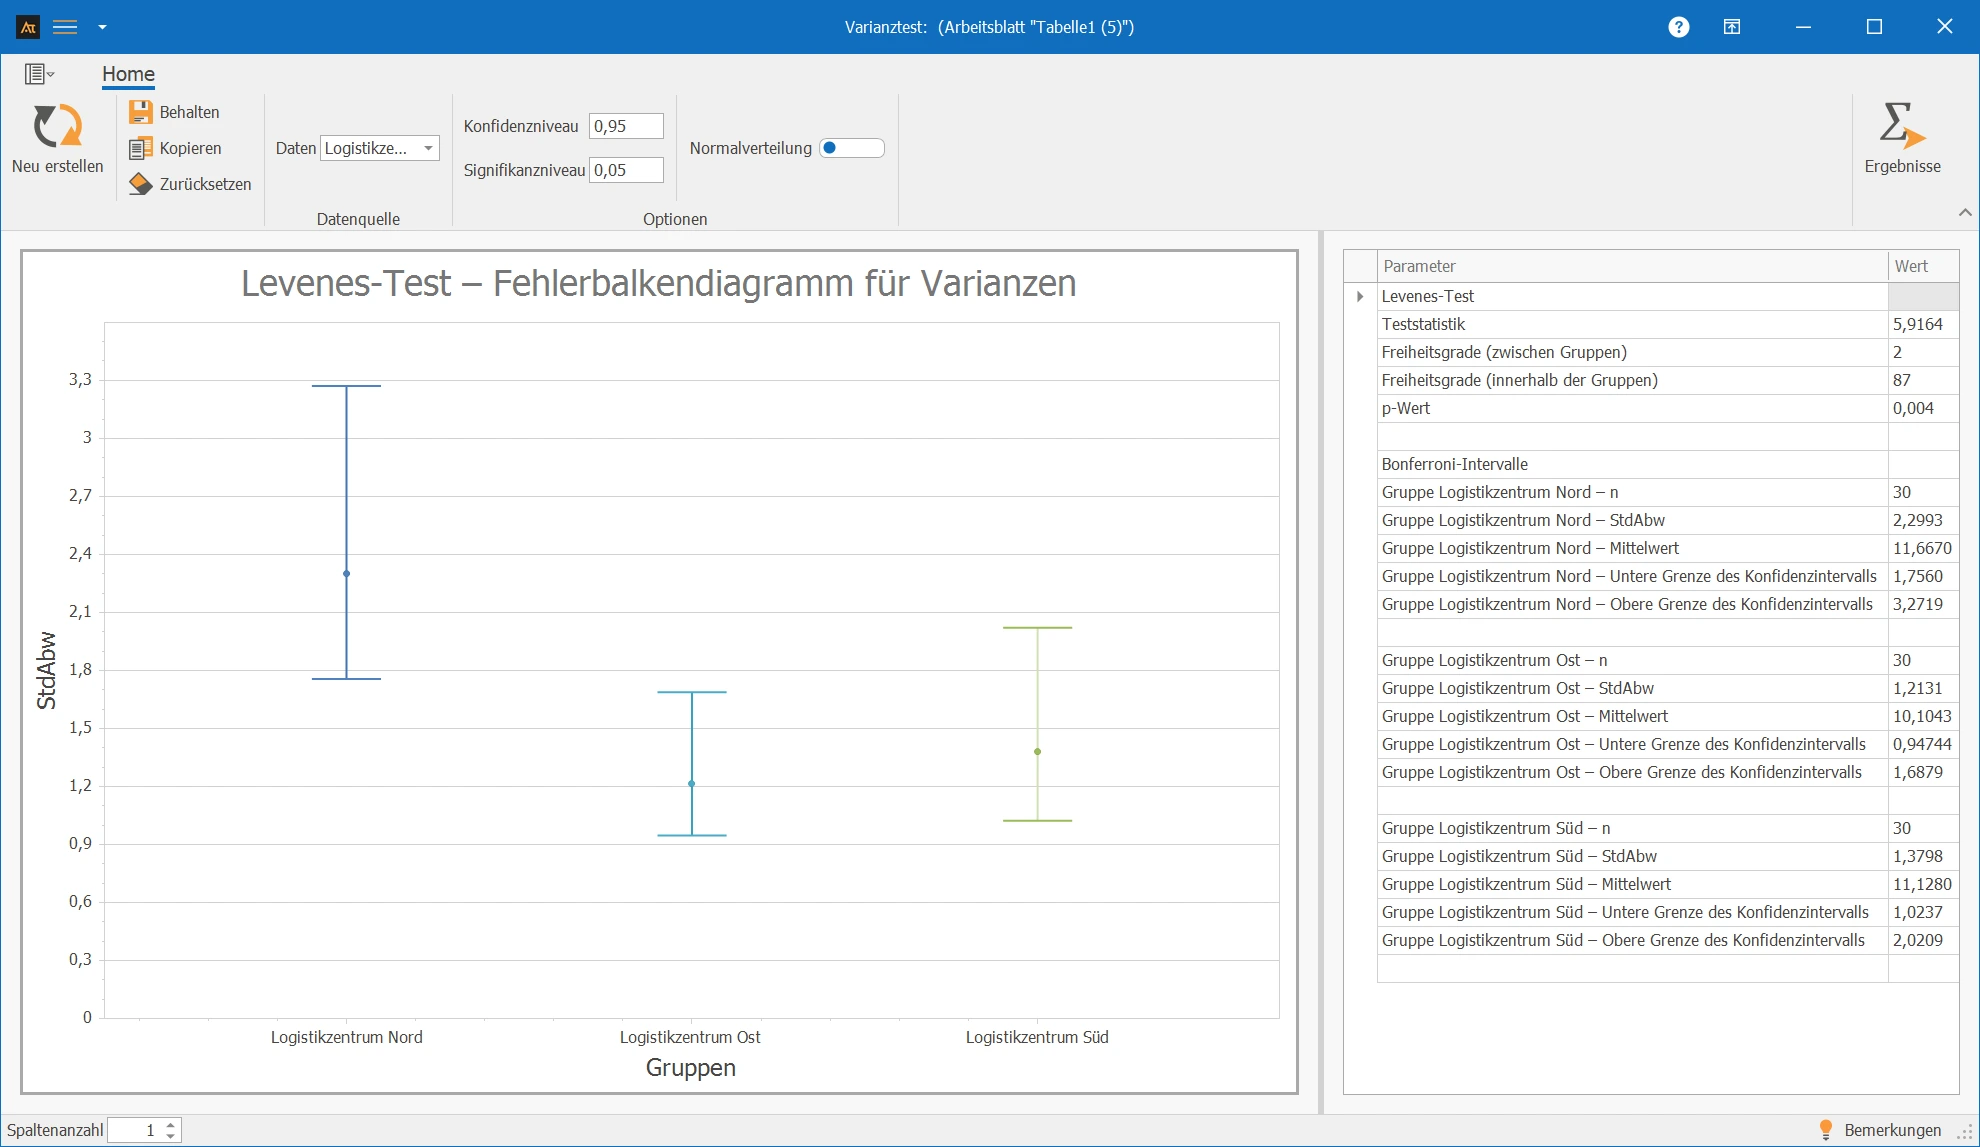
In der Logistikabteilung werden Kundenaufträge kommissioniert und versendet. Es soll untersucht werden, ob die Lieferzeiten in den Logistikzentren unterschiedlich stark streuen.
- H₀: σ²_Zentrum A = σ²_Zentrum B = σ²_Zentrum C
- H₁: Mindestens eine Varianz unterscheidet sich.
Interpretation
Der p-Wert liegt unter 0,05. Die Nullhypothese gleicher Varianzen wird verworfen.
Die Lieferzeiten streuen zwischen den Logistikzentren statistisch signifikant unterschiedlich. Mindestens ein Zentrum liefert also weniger gleichmäßig. Das kann auf Unterschiede in Auslastung, Prozessen oder Transportbedingungen hinweisen.
Lieferantenvergleich
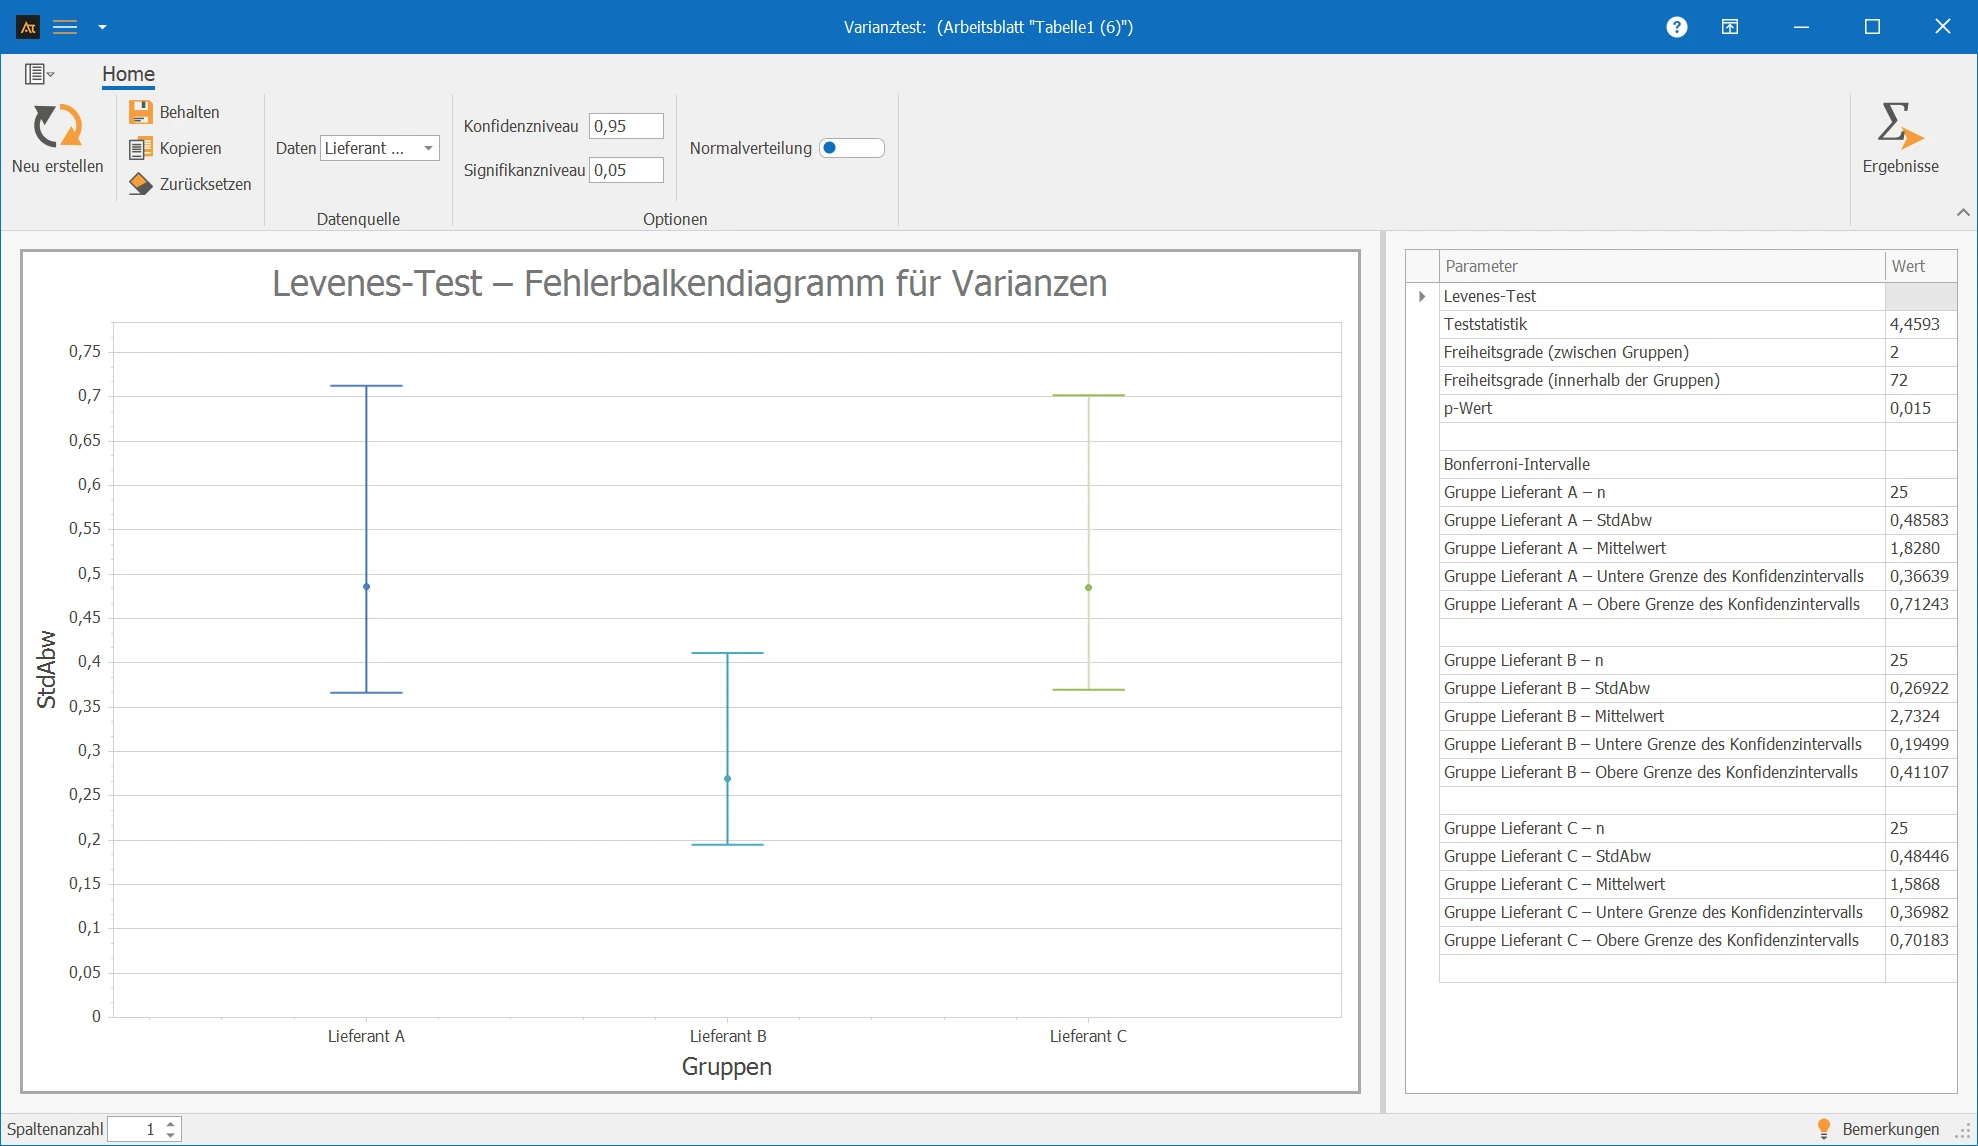
Im Einkauf werden Bauteile von drei Lieferanten bezogen. Es soll untersucht werden, ob die Ausschussanteile je Lieferung bei einzelnen Lieferanten stärker schwanken als bei anderen.
Hinweis:
Prozentwerte wie die Ausschussquote können diskret sein, da sie aus Zählwerten entstehen. Bei kleinen Liefermengen entstehen nur wenige mögliche Prozentwerte. In solchen Fällen sollte die Eignung des Tests fachlich geprüft werden.
Interpretation
Der p-Wert liegt unter 0,05. Die Nullhypothese gleicher Varianzen wird verworfen.
Die Ausschussanteile streuen zwischen den Lieferanten statistisch signifikant unterschiedlich. Ein Lieferant kann damit zwar im Mittel akzeptabel sein, aber unzuverlässiger liefern, weil die Qualität stärker schwankt.
Prognoseabweichung
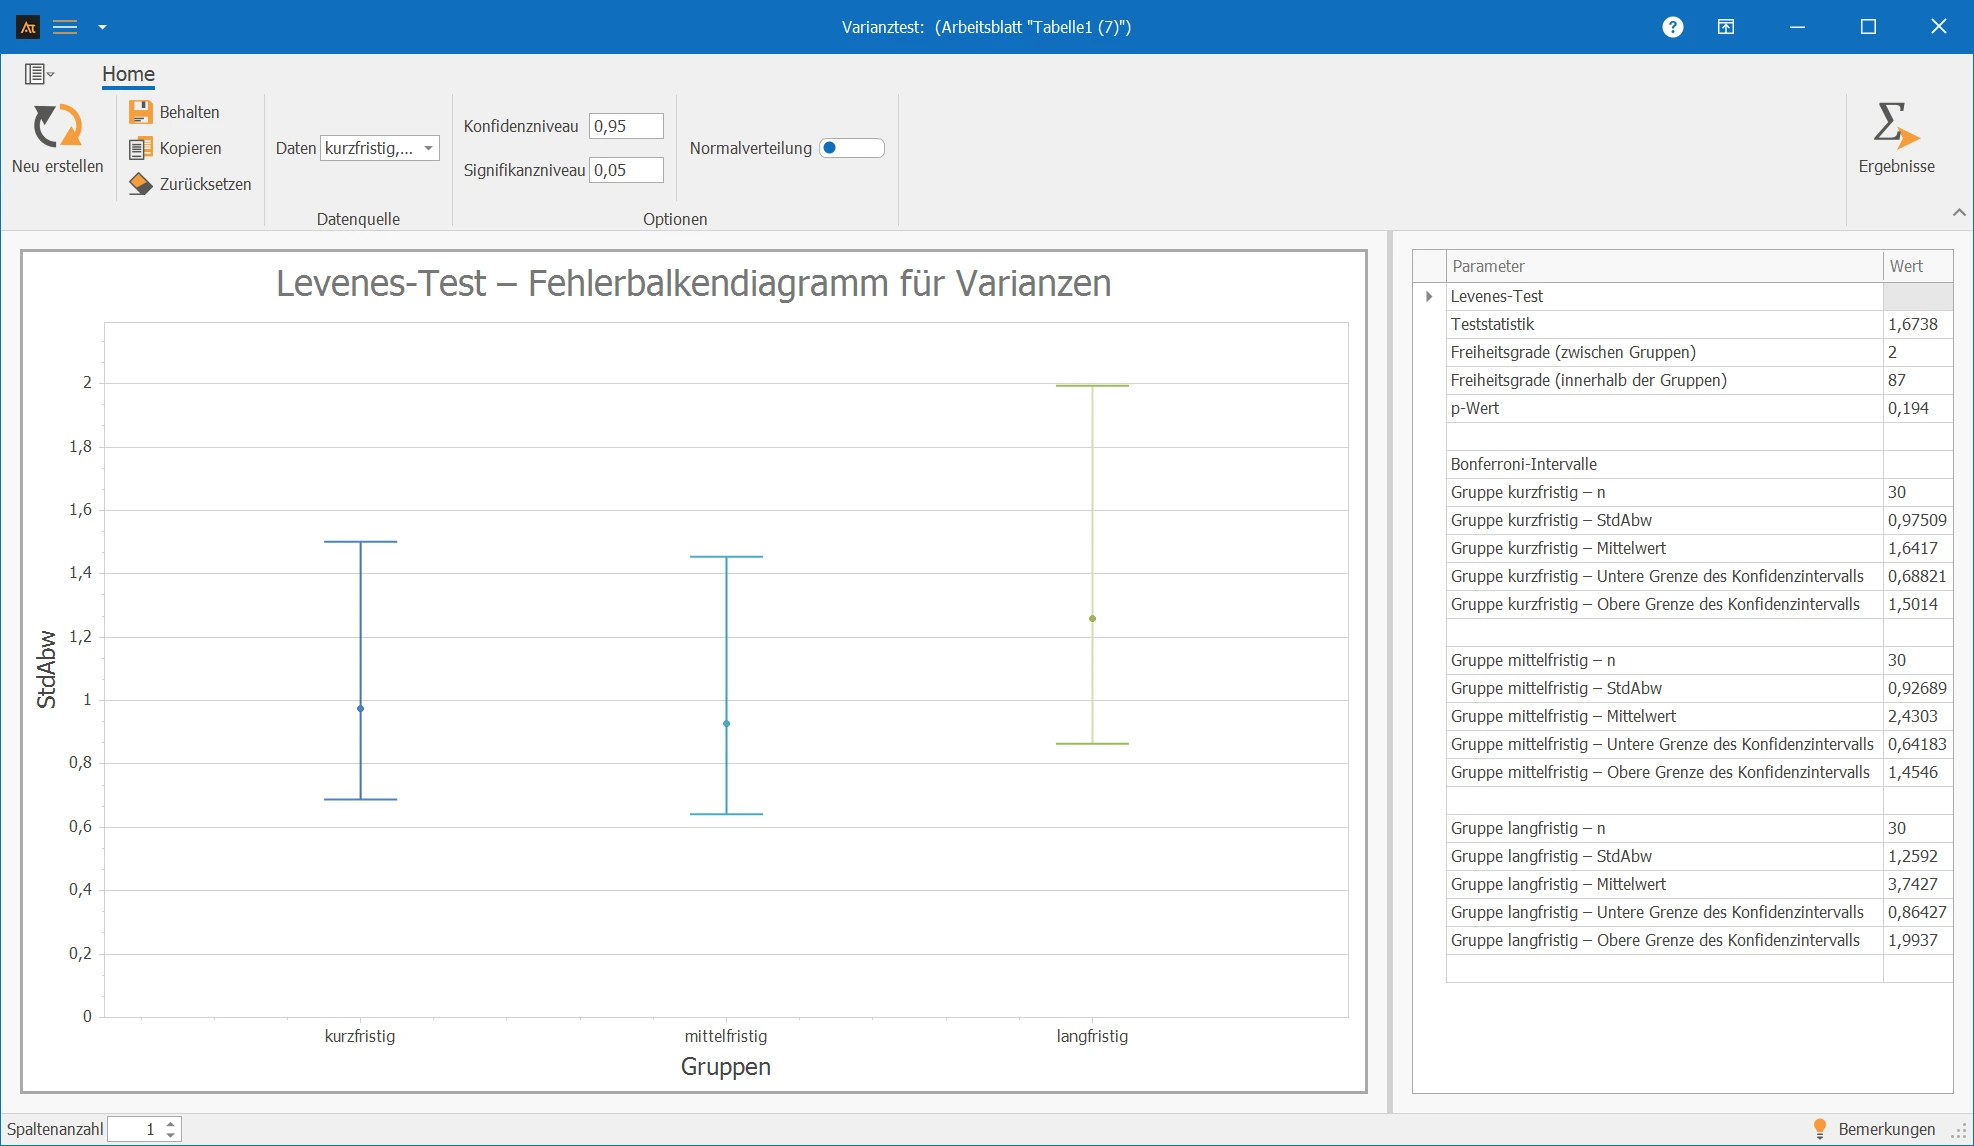
In der Produktionsplanung werden Bedarfsprognosen für unterschiedliche Planungszeiträume erstellt. Es soll untersucht werden, ob die Prognoseabweichungen bei kurzfristigem, mittelfristigem und langfristigem Planungshorizont unterschiedlich stark streuen.
Interpretation
Der p-Wert liegt mit 0,194 über dem Signifikanzniveau von 0,05. Die Nullhypothese gleicher Varianzen wird daher nicht verworfen.
Es gibt somit keinen statistisch signifikanten Hinweis darauf, dass sich die Streuung der Prognoseabweichungen zwischen den Planungshorizonten unterscheidet. Unterschiede in der Schwankungsbreite können in der Stichprobe zwar sichtbar sein, sind auf Basis dieses Tests jedoch nicht statistisch abgesichert.
Stetige Daten: Daten, die mit einem Messmittel erfasst werden und sowohl Einheiten als auch Nachkommastellen besitzen können.
Normalverteilte Daten: Daten, die sich gut durch eine Normalverteilung beschreiben lassen. Dies kann z. B. über einen Test auf Normalverteilung oder über geeignete Diagramme überprüft werden.
s: Standardabweichung der Stichprobe. Sie beschreibt die Streuung der Messwerte um den Mittelwert.
s²: Varianz der Stichprobe. Sie ist das Quadrat der Standardabweichung.
n: Stichprobenumfang. Anzahl der Beobachtungen innerhalb einer Stichprobe.
α: Signifikanzniveau. Vorgegebene Irrtumswahrscheinlichkeit, mit der die Nullhypothese fälschlicherweise verworfen wird.
p-Wert: Ergebnis des Hypothesentestes, mit dem eine Entscheidung zwischen Nullhypothese und Alternativhypothese getroffen wird.
F-Wert: Prüfgröße beim F-Test bzw. beim Levene-Test. Beim F-Test beschreibt er das Verhältnis zweier Stichprobenvarianzen.
Chi-Quadrat-Wert: Prüfgröße beim Bartlett-Test für mehr als zwei Gruppen unter Normalverteilungsannahme.
df: Freiheitsgrade. Werte, die sich aus der Anzahl der Gruppen und Beobachtungen ergeben und die Form der Testverteilung bestimmen.
Konfidenzniveau: Wahrscheinlichkeit, mit der das berechnete Konfidenzintervall den wahren Parameterwert überdeckt (z. B. 95 %).
Konfidenzintervall: Wertebereich, der mit dem gewählten Konfidenzniveau die wahre Standardabweichung oder Varianz enthält.
Nullhypothese: Ausgangshypothese, die beim Test auf Varianzen von gleichen Varianzen aller Gruppen ausgeht.
Alternativhypothese: Gegenhypothese zur Nullhypothese. Sie beschreibt, dass mindestens eine Varianz von den anderen abweicht.
Levene-Test: Robuster Test auf Gleichheit der Varianzen. Im Tool werden die absoluten Abweichungen vom Gruppenmedian verwendet.
F-Test: Test auf Gleichheit zweier Varianzen unter Normalverteilungsannahme.
Bartlett-Test: Test auf Gleichheit mehrerer Varianzen unter Normalverteilungsannahme.
Bonferroni-Intervalle: Angepasste Konfidenzintervalle, die beim gleichzeitigen Vergleich mehrerer Gruppen die Gesamtfehlerwahrscheinlichkeit berücksichtigen.
Der Test auf Varianzgleichheit prüft, ob sich die Streuungen mehrerer Gruppen statistisch signifikant unterscheiden.
Bei aktivierter Normalverteilungsannahme verwendet das Tool bei genau zwei Gruppen den F-Test und bei mehr als zwei Gruppen den Bartlett-Test. Ohne aktivierte Normalverteilungsannahme wird ein medianbasierter Levene-Test verwendet.
Die benötigten Verteilungs- und Quantilsfunktionen der F-, Chi-Quadrat- und Normalverteilung werden über CenterSpace NMath ausgewertet.
Hypothesen
F-Test für zwei normalverteilte Gruppen
Sind genau zwei Gruppen vorhanden und ist die Option Normalverteilung aktiviert, verwendet das Tool einen zweiseitigen F-Test.
Der p-Wert wird zweiseitig aus der F-Verteilung bestimmt. Die Verteilungsfunktion der F-Verteilung wird über CenterSpace NMath ausgewertet.
F < 1: p = 2 · Fdf1,df2(F)
Bartlett-Test für mehrere normalverteilte Gruppen
Sind mehr als zwei Gruppen vorhanden und ist die Option Normalverteilung aktiviert, verwendet das Tool den Bartlett-Test.
Zunächst wird die gepoolte Varianz berechnet:
Die im Tool verwendete Bartlett-Prüfgröße lautet:
Unter der Nullhypothese wird die Prüfgröße näherungsweise mit einer Chi-Quadrat-Verteilung mit k − 1 Freiheitsgraden ausgewertet. Die Chi-Quadrat-Verteilungsfunktion wird über CenterSpace NMath berechnet.
Levene-Test ohne Normalverteilungsannahme
Ist die Option Normalverteilung nicht aktiviert, verwendet das Tool eine medianbasierte Variante des Levene-Tests. Dabei werden zunächst für jede Gruppe die absoluten Abweichungen vom jeweiligen Gruppenmedian berechnet.
Auf die absoluten Abweichungen wird anschließend eine einfaktorielle ANOVA angewendet. Die Prüfgröße ergibt sich aus dem Verhältnis der mittleren Quadratsummen zwischen und innerhalb der Gruppen.
dfinnerhalb = N − k
Der p-Wert wird aus dem rechten Rand der F-Verteilung bestimmt. Die F-Verteilungsfunktion wird über CenterSpace NMath ausgewertet.
Bonferroni-Konfidenzintervalle
Zusätzlich zum Varianztest berechnet das Tool für jede Gruppe ein simultanes Konfidenzintervall der Standardabweichung. Das globale Fehlerniveau wird dazu nach Bonferroni auf die Gruppen aufgeteilt.
Intervalle bei Normalverteilungsannahme
Bei aktivierter Normalverteilungsannahme werden Chi-Quadrat-basierte Konfidenzintervalle für die Varianz berechnet. Die benötigten Quantile der Chi-Quadrat-Verteilung werden über CenterSpace NMath bestimmt.
Die Grenzen für die Standardabweichung ergeben sich durch Ziehen der Quadratwurzel:
SDoben = √(Varoben)
Bonett-Intervalle ohne Normalverteilungsannahme
Ohne aktivierte Normalverteilungsannahme verwendet das Tool Bonett-Intervalle. Dabei werden Stichprobengröße und Kurtosis der jeweiligen Gruppe berücksichtigt.
Für größere Stichproben wird zunächst ein getrimmter Mittelwert bestimmt. Für Stichproben mit höchstens fünf Beobachtungen wird der gewöhnliche Mittelwert verwendet.
Aus den Abweichungen vom getrimmten Mittelwert wird eine Exzess-Kurtosis bestimmt:
Daraus wird der Standardfehler berechnet:
Das benötigte Quantil der Standardnormalverteilung wird über CenterSpace NMath bestimmt:
Der im Tool verwendete Bonett-Korrekturfaktor lautet:
Die Varianzgrenzen werden anschließend berechnet als:
Die Grenzen für die Standardabweichung ergeben sich wiederum aus den Quadratwurzeln der Varianzgrenzen.
SDoben = √(Varoben)