Der F-Test dient dazu, zu prüfen, ob sich die Streuungen bzw. Varianzen zweier Gruppen statistisch signifikant unterscheiden. Er wird eingesetzt, um zu beurteilen, ob eine beobachtete Differenz der Variabilität über zufällige Schwankungen hinausgeht.
Die Entscheidung erfolgt über den Vergleich des p-Wertes mit dem festgelegten Signifikanzniveau (in der Regel α = 0,05):
In der Produktentwicklung wird eine neue Rezeptur für Tomatensoße getestet. Ziel ist es zu prüfen, ob die Streuung der Viskosität der neuen Rezeptur von der bisherigen Rezeptur abweicht.
Interpretation der Ergebnisse:
Der ermittelte p-Wert liegt deutlich unter dem Signifikanzniveau von 0,05, sodass die Nullhypothese verworfen wird. Die Streuung der Viskosität der alten und der neuen Rezeptur ist nicht gleich. Die neue Rezeptur streut deutlich stärker als die alte.
Erklärungen zur Grafik:
Die Punkte markieren die Standardabweichungen der Viskosität für die alte und neue Rezeptur.
Die Fehlerbalken stellen das 95-%-Konfidenzintervall für die jeweilige Standardabweichung dar.
Die nicht überlappenden Konfidenzintervalle zeigen, dass ein Unterschied in der Standardabweichung vorhanden ist.
Vorgehensweise
Vorarbeit
Eine geeignete Messgröße auswählen, deren Streuung verglichen werden soll.
Zwei Gruppen festlegen, deren Varianzen verglichen werden sollen.
Signifikanzniveau festlegen (in der Regel α = 0,05).
Prüfen, ob die Daten keine Hinweise auf starke Abweichungen von der Normalverteilung zeigen.
Nutzung in AlphadiTab
In der Analyze-Phase das Tool 2-Stichproben-F auswählen.
Bei Stichprobe 1 die erste Gruppe auswählen.
Bei Stichprobe 2 die zweite Gruppe auswählen.
Die Analyze durch Neu erstellen durchführen.
Interpretation
Prüfen, ob der p-Wert kleiner oder gleich dem Signifikanzniveau ist.
p ≤ α → statistisch signifikanter Unterschied der Varianzen.
p > α → kein statistisch signifikanter Unterschied der Varianzen.
Die Interpretation bezieht sich ausschließlich auf die Streuung, nicht auf den Mittelwert.
Einstellmöglichkeiten
Der F-Test bietet zwei zentrale Einstellungen: die Art der Dateneingabe und die Richtung der Hypothese.
Daten
Manuelle Eingabe: Der Vergleich erfolgt auf Basis von manuell eingegebenen Standardabweichungen und Stichprobengrößen zweier Stichproben.
Nicht-manuelle Eingabe (Datensatz): Der Vergleich erfolgt auf Basis der ausgewählten Datenspalten.
Richtung: Zweiseitig
H₀: σ₁² / σ₂² = 1 | H₁: σ₁² / σ₂² ≠ 1
Wählen Sie zweiseitig, wenn Sie prüfen möchten, ob sich die Varianzen der beiden Stichproben unterscheiden, ohne eine bestimmte Richtung vorzugeben. Sinnvoll, wenn keine konkrete Erwartung über die Richtung des Unterschieds besteht. Beispiel: Unterscheiden sich die Streuungen der Reaktionszeiten von Gruppe A und Gruppe B?
Richtung: Größer
H₀: σ₁² / σ₂² ≤ 1 | H₁: σ₁² / σ₂² > 1
Wählen Sie größer, wenn Sie prüfen möchten, ob die Varianz der ersten Stichprobe größer ist als die der zweiten. Unterschiede in die andere Richtung werden nicht berücksichtigt. Beispiel: Ist die Streuung der Lieferzeit vor einer Maßnahme größer als danach?
Richtung: Kleiner
H₀: σ₁² / σ₂² ≥ 1 | H₁: σ₁² / σ₂² < 1
Wählen Sie kleiner, wenn Sie prüfen möchten, ob die Varianz der ersten Stichprobe kleiner ist als die der zweiten. Unterschiede in die entgegengesetzte Richtung werden nicht berücksichtigt. Beispiel: Ist die Streuung der Viskosität der alten Rezeptur kleiner als die der neuen?
Voraussetzungen
Zwei Gruppen
Es müssen genau zwei Gruppen vorliegen, deren Varianzen miteinander verglichen werden sollen.
Warum ist das wichtig? Der F-Test ist ein Verfahren zum Vergleich von zwei Varianzen.
Unabhängige Stichproben
Die Messwerte der beiden Gruppen dürfen sich nicht gegenseitig beeinflussen.
Warum ist das wichtig? Der Test setzt voraus, dass die Gruppen unabhängig voneinander erhoben wurden.
Stetige Messdaten
Die Messwerte müssen stetig sein.
Warum ist das wichtig? Der F-Test vergleicht Varianzen numerischer Messdaten.
Normalverteilte Daten
Die Messwerte sollten keine Hinweise auf eine relevante Abweichung von der Normalverteilung zeigen.
Warum ist das wichtig? Der F-Test reagiert empfindlicher auf Abweichungen von der Normalverteilung als der t-Test. Bei Verdacht auf nicht-normalverteilte Daten sollte der Levene-Test als robustere Alternative erwogen werden.
Wann sind andere Werkzeuge besser geeignet?
Mehr als zwei Gruppen gleichzeitig hinsichtlich ihrer Varianzen verglichen werden sollen
Levene-Test (mehrere Gruppen)
Die Daten stark schief verteilt sind oder ausgeprägte Ausreißer enthalten
Robusteres Verfahren
Mittelwerte statt Varianzen verglichen werden sollen
t-Test
ANOVA
Anteile statt Varianzen verglichen werden sollen
Anteils-Test
Beispiel in Produktion
Abfüllmenge Tomatensoße – Maschine A vs. Maschine B
In der Produktion werden zwei Abfüllmaschinen eingesetzt. Es soll untersucht werden, ob sich die Streuung der Abfüllmenge zwischen Maschine A und Maschine B unterscheidet. Für beide Maschinen liegen die Messdaten in zusammengefasster Form vor:
Maschine A: n = 25, Mittelwert = 500,2 ml, Standardabweichung = 1,1 ml
Maschine B: n = 25, Mittelwert = 498,9 ml, Standardabweichung = 1,0 ml
Der Vergleich der Streuungen erfolgt mithilfe eines F-Tests (2 Stichproben).
Interpretation
Der F-Test zeigt keinen statistisch signifikanten Unterschied der Streuung der Abfüllmenge zwischen den beiden Maschinen. Der p-Wert liegt mit 0,644 über 0,05, sodass die Nullhypothese beibehalten wird.
→ Beide Maschinen arbeiten hinsichtlich der Abfüllmenge gleich gleichmäßig.
Beispiel in IT-Helpdesks
Reaktionszeit
Im IT-Service-Desk werden Tickets an mehreren Standorten bearbeitet. Die Reaktionszeiten werden regelmäßig ausgewertet, um Unterschiede in der Prozessstabilität zu erkennen. Im Beispiel liegen Daten von drei Standorten vor. Der F-Test (2 Stichproben) ist grundsätzlich nur für den Vergleich von zwei Gruppen geeignet. Bei mehr als zwei Standorten gibt es zwei Vorgehensweisen:
Paarweise Vergleiche mit dem F-Test: Jeder Standort kann paarweise mit den anderen verglichen werden (z. B. A vs. B, A vs. C, B vs. C).
Alternative – Levene-Test über mehrere Gruppen: Sollen alle Standorte gleichzeitig betrachtet werden, ist ein robuster Varianzvergleich über mehrere Gruppen in der Regel das geeignetere Werkzeug.
Hinweis: Bei mehreren paarweisen F-Tests steigt das Risiko von Zufallstreffern.
Der F-Test zeigt einen statistisch signifikanten Unterschied zwischen den Streuungen der Standorte DLZ Nord und DLZ Ost (p = 0,000). Die Durchlaufzeiten am Standort Ost streuen deutlich stärker als am Standort Nord.
→ Bei mehr als zwei Standorten ist ein Verfahren für mehrere Gruppen vorzuziehen.
Beispiel in Vertrieb
Durchlaufzeit nach Team
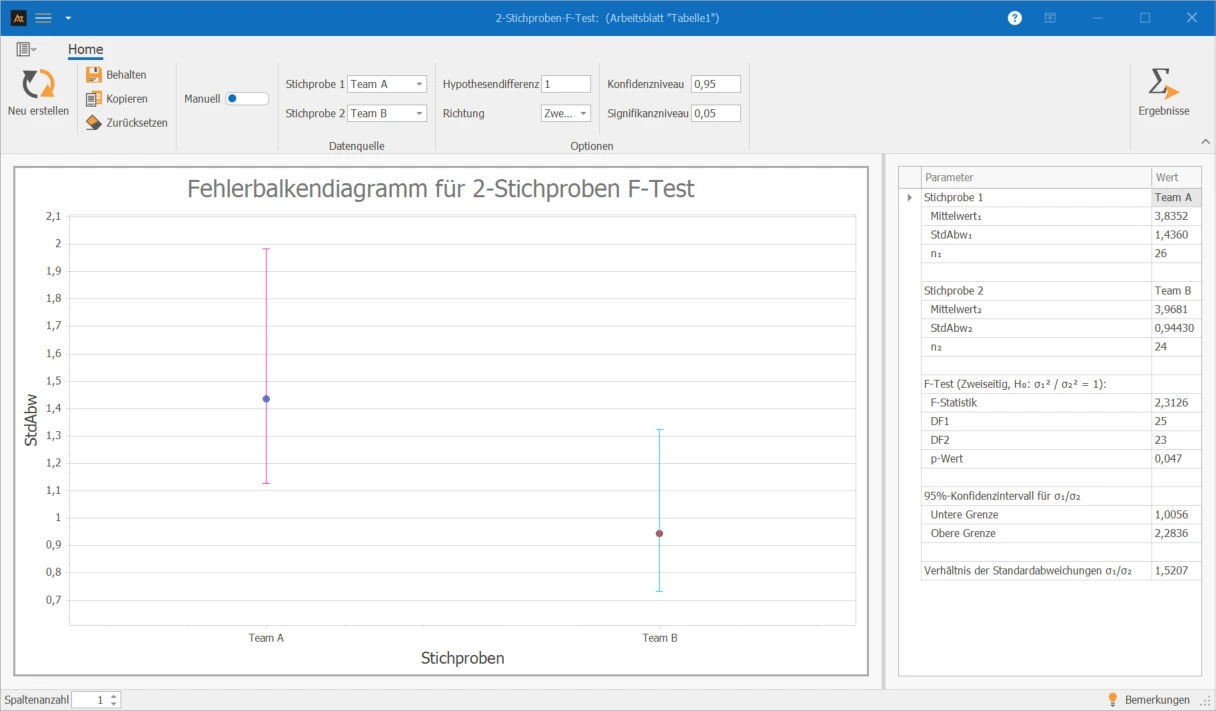
Im Vertrieb werden Kundenangebote von zwei Teams bearbeitet. Es soll untersucht werden, ob sich die Streuung der Durchlaufzeit zwischen Team A und Team B unterscheidet.
Der F-Test zeigt einen statistisch signifikanten Unterschied in der Streuung der Durchlaufzeit zwischen den beiden Teams. Der p-Wert liegt mit 0,047 knapp unter 0,05, sodass die Nullhypothese verworfen wird.
→ Team A streut stärker und arbeitet weniger gleichmäßig als Team B.
Beispiel in Logistik
Lieferzeit nach Logistikzentrum
In der Logistikabteilung werden Kundenaufträge kommissioniert und versendet. Zur Effizienzsteigerung wurden neue Stapler eingeführt. Es soll untersucht werden, ob sich die Streuung der Lieferzeit (in Stunden) nach der Einführung verringert hat. Die Analyse erfolgt als einseitiger F-Test (Richtung „größer“).
Der einseitige F-Test zeigt einen statistisch signifikanten Unterschied (F = 3,5934; p = 0,000). Die Lieferzeiten vor der Einführung streuen signifikant stärker als danach.
→ Die neuen Stapler haben die Lieferzeit nicht nur verkürzt, sondern auch stabiler gemacht.
Beispiel in Einkauf
Lieferantenvergleich
Im Einkauf werden Bauteile von zwei Lieferanten bezogen. Es soll untersucht werden, ob sich die Streuung des Ausschussanteils pro Lieferung zwischen Lieferant A und Lieferant B unterscheidet (gemessen in %).
Hinweis: Der F-Test setzt annähernd normalverteilte, metrische Daten voraus. Prozentwerte können diskret sein; bei kleinen Liefermengen kann die Normalverteilungsannahme verletzt sein. Bei Zweifeln sollte ein robusteres Verfahren verwendet werden.
Der F-Test zeigt einen statistisch signifikanten Unterschied in der Streuung des Ausschussanteils zwischen den Lieferanten (p = 0,005). Die Nullhypothese wird verworfen.
→ Lieferant B arbeitet gleichmäßiger; Lieferant A streut beim Ausschussanteil stärker.
Beispiel in Planung
Prognoseabweichung
In der Produktionsplanung werden Bedarfsprognosen für unterschiedliche Planungszeiträume erstellt. Zur Bewertung der Prognosegüte wird die Prognoseabweichung berechnet. Untersucht wird, ob sich die Streuung zwischen kurz- und langfristigem Planungszeitraum unterscheidet:
Kurzfristiger Horizont: n = 30, Standardabweichung = 1,5 %
Langfristiger Horizont: n = 30, Standardabweichung = 3,8 %
Interpretation
Der F-Test zeigt, dass sich die Streuungen der kurz- und langfristigen Planungszeiträume statistisch signifikant unterscheiden (p = 0,000). Die Nullhypothese wird verworfen.
→ Langfristige Prognosen streuen deutlich stärker als kurzfristige.
Begriffe
F-Wert: Prüfgröße des F-Tests. Verhältnis der beiden Stichprobenvarianzen.
s₁², s₂²: Stichprobenvarianzen der Gruppen 1 und 2.
σ₁², σ₂²: Populationsvarianzen der Gruppen 1 und 2 (unbekannt, werden geschätzt).
α = Signifikanzniveau: Vorgegebene Irrtumswahrscheinlichkeit (in der Regel 0,05).
H₀ (Nullhypothese): Die Varianzen der beiden Gruppen sind gleich (σ₁² = σ₂²).
H₁ (Alternativhypothese): Die Varianzen der beiden Gruppen unterscheiden sich.
df = Freiheitsgrade: Ergeben sich aus den Stichprobengrößen beider Gruppen (n₁ − 1 und n₂ − 1).
Konfidenzintervall: Wertebereich, der das wahre Varianzverhältnis mit dem gewählten Konfidenzniveau enthält.
Formeln
F-Teststatistik
F = (s₁²/s₂²) / k²
Freiheitsgrade
df₁ = n₁ − 1
df₂ = n₂ − 1
Konfidenzintervall (untere Grenze)
untere Grenze = √((s₁²/s₂²)·Funten)
Konfidenzintervall (obere Grenze)
obere Grenze = √((s₁²/s₂²)·Foben)
Verhältnis der Standardabweichungen
s₁/s₂ = √(s₁²/s₂²)
Hinweis: Für die Berechnung der Stichproben-Standardabweichungen sowie der Verteilungs- und Quantilswerte der F- und Chi-Quadrat-Verteilung wurde auf NMath zurückgegriffen.
Eine kleine Winterpause
✳✦✳
Information für unsere Kunden
Frohe Weihnachten
und einen guten Start in 2027
Liebe Kunden,
das Jahr neigt sich dem Ende zu, und auch wir nutzen die besinnliche Weihnachtszeit für eine kurze Auszeit.
Unsere Betriebsferien21.12.2026 – 01.01.2027Ab dem 04.01.2027 sind wir wieder wie gewohnt für Sie da.
Wir wünschen Ihnen ein frohes und friedliches Weihnachtsfest, erholsame Feiertage und einen guten Start ins neue Jahr.
Bei dringenden Anliegen erreichen Sie uns unter
info@alphadi.de
.


 Nutzung in AlphadiTab