

A ferramenta de teste de distribuição é usada para comparar uma série de dados selecionada com várias distribuições teóricas. Ela ajuda a identificar qual distribuição descreve melhor as medições e se os dados são adequados para análises estatísticas adicionais com uma suposição de distribuição específica.
O resultado não é uma "prova" definitiva para uma distribuição. Um alto valor de p significa apenas que o teste de Anderson-Darling não encontra uma desvio estatisticamente significativo da distribuição escolhida. A plausibilidade técnica, a referência do processo e a rede de probabilidade devem sempre ser consideradas.

Durante a produção de molho de tomate, os valores de viscosidade são registrados regularmente. A viscosidade descreve quão espesso é o molho. É importante para que o produto possa ser preenchido uniformemente e sempre tenha a mesma consistência para o cliente.
Antes que análises adicionais sejam realizadas, deve-se verificar qual das distribuições selecionadas pode descrever de forma significativa os valores de viscosidade medidos. Para este fim, os dados são comparados com os testes de distribuição para as distribuições Normal, Lognormal, Loglogística e Logística.
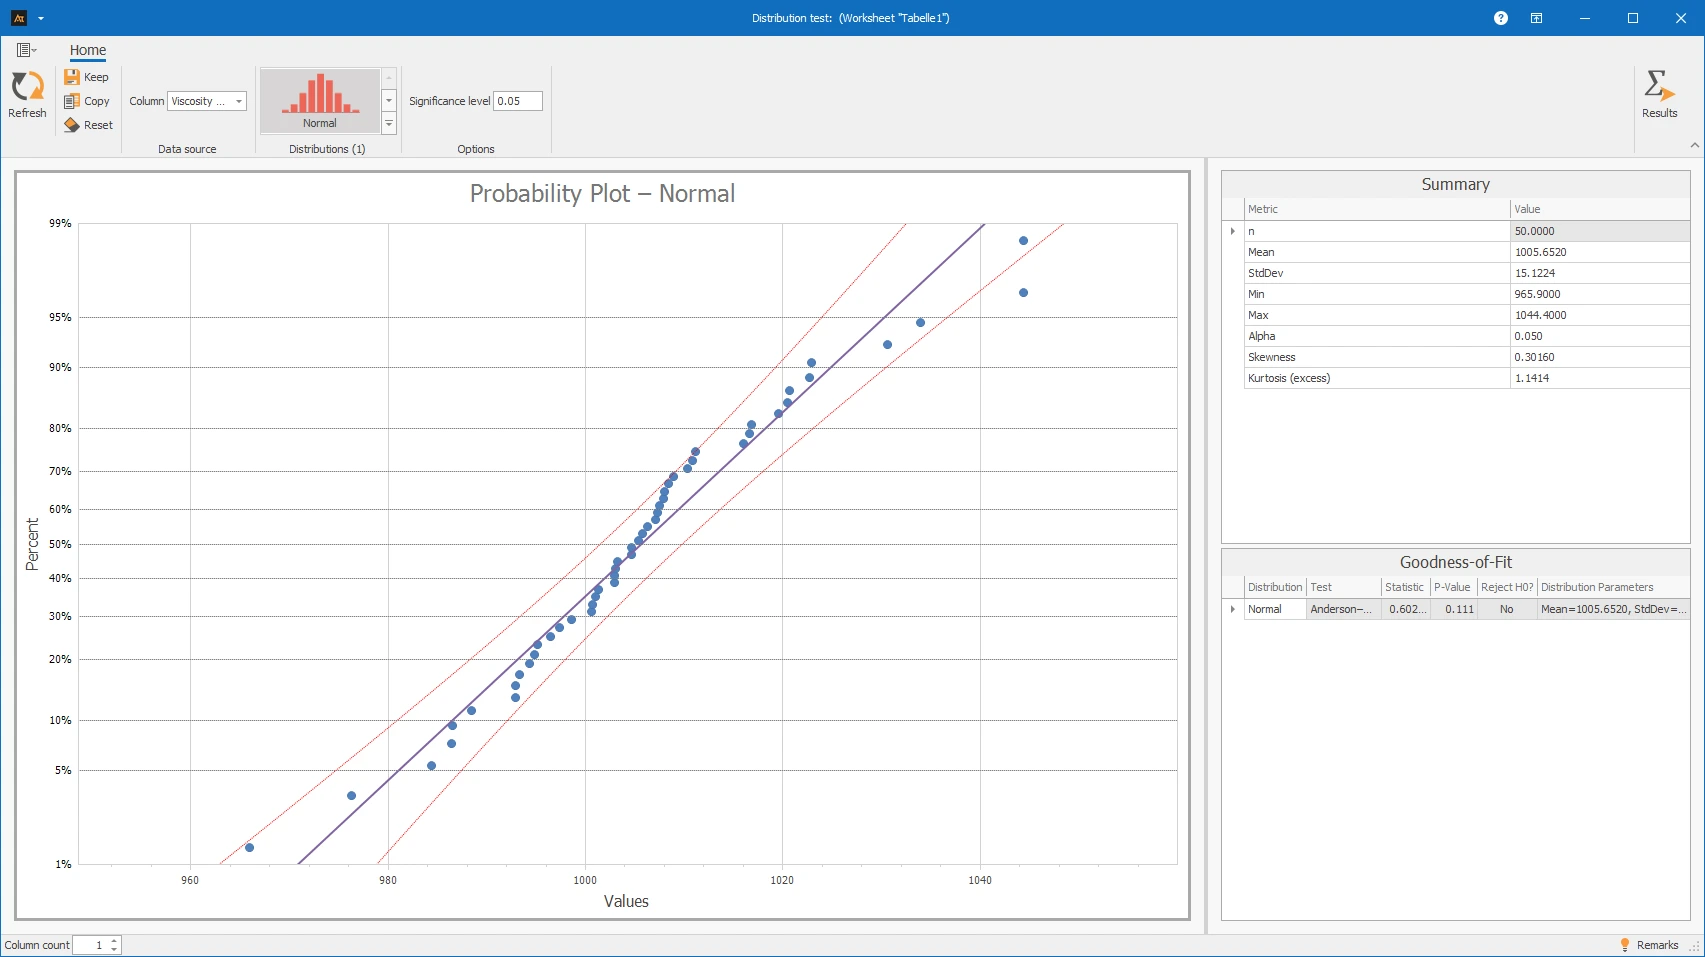
Explicações dos resultados:
Gráficos de probabilidade
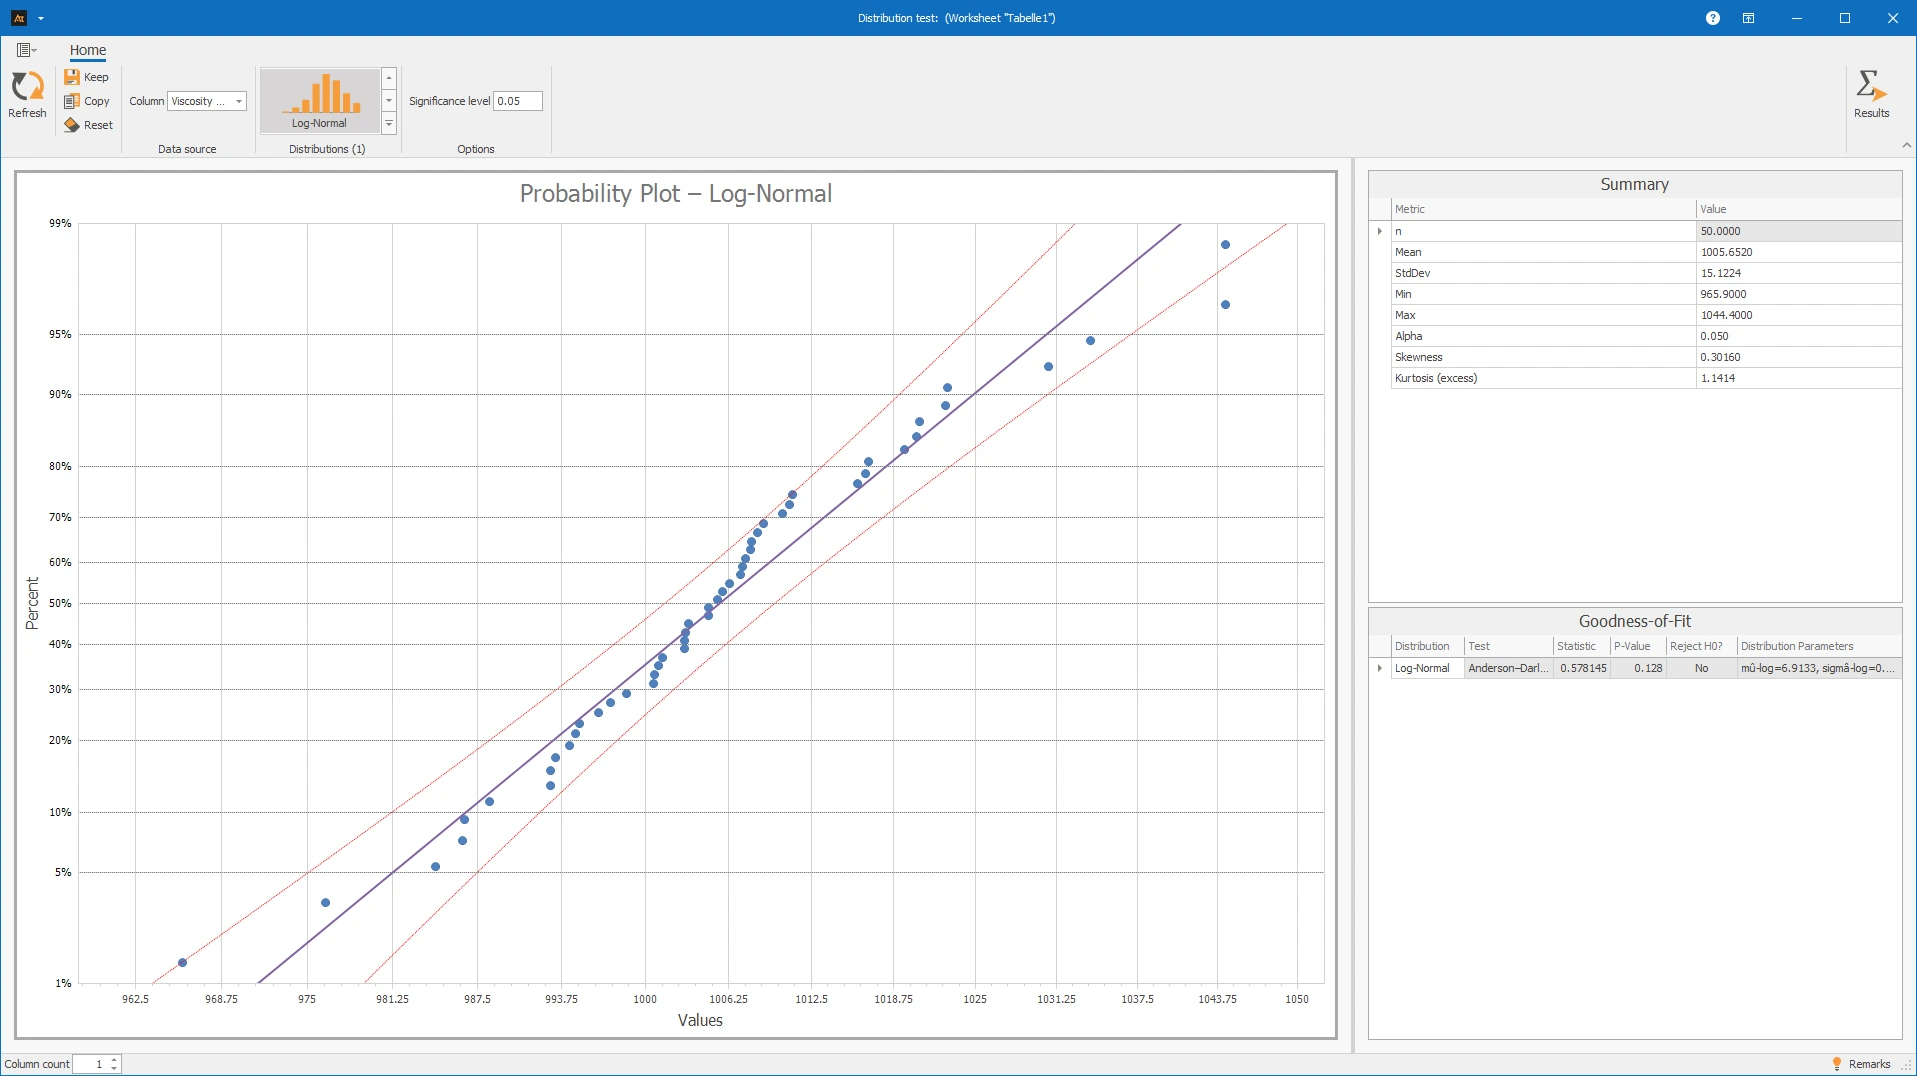
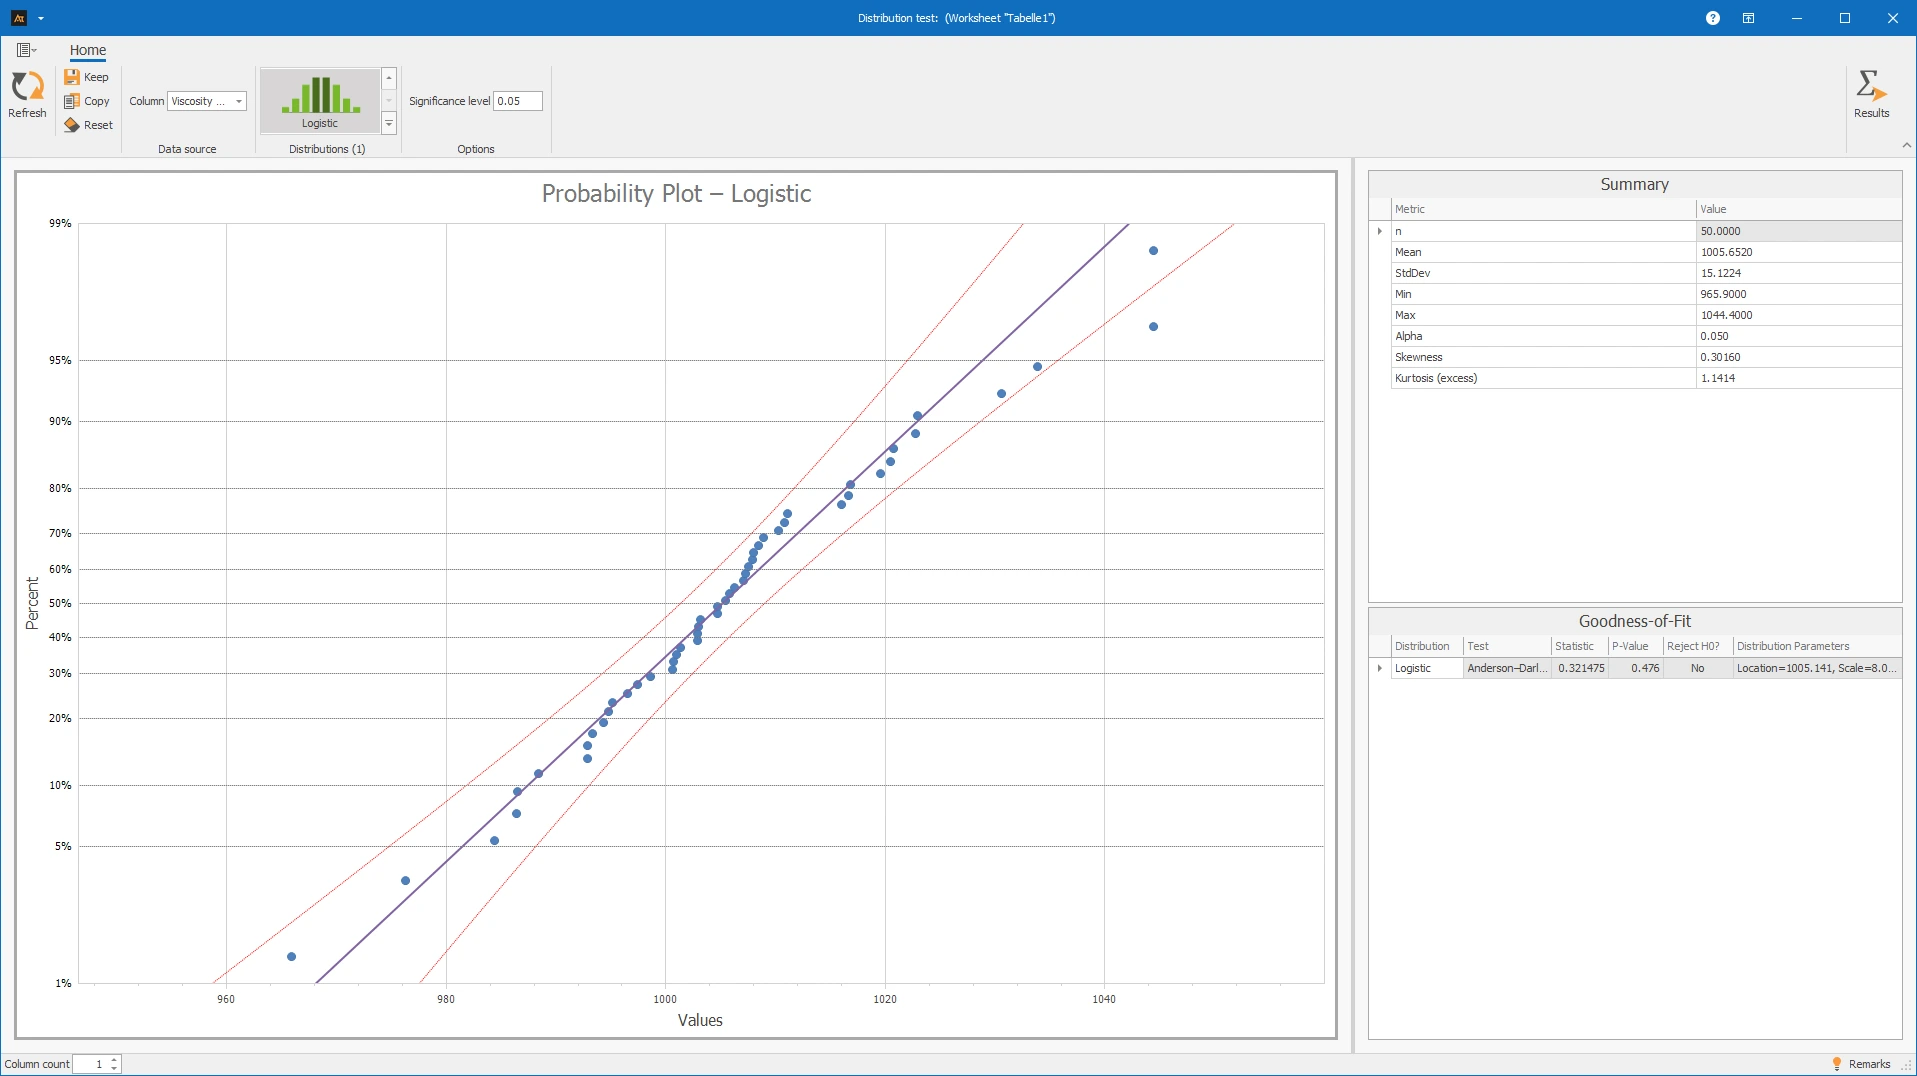
Para cada distribuição calculada com sucesso, o teste de distribuição gera seu próprio gráfico de probabilidade. Nele, os valores medidos ordenados são comparados com os valores que seriam esperados sob a respectiva distribuição teórica.
- Se os pontos estiverem próximos da linha desenhada, a distribuição escolhida se ajusta bem aos dados. Quanto mais os pontos se desviam da linha, pior essa distribuição descreve os dados.
- Padrões curvados, formas de S, outliers significativos ou desvios nas áreas de borda indicam que os dados não se ajustam bem à distribuição testada.
- Quando se comparam várias distribuições, não apenas o valor p deve ser considerado. Também é importante se o gráfico de probabilidade mostra um padrão plausível e calmo e se a distribuição se ajusta tecnicamente à característica.
A linha pode ser entendida como um modelo: Quanto melhor os pontos se ajustam ao modelo da distribuição, mais adequada essa distribuição é como um modelo para os dados.
Teste de Anderson-Darling
O teste de distribuição usa o teste de Anderson-Darling como um teste de bondade de ajuste computacional. O teste verifica se os valores medidos se ajustam à distribuição selecionada. É realizado para todas as distribuições suportadas que podem ser calculadas com os dados disponíveis.
O teste fornece uma estatística de teste e um valor p para cada distribuição:
- valor p maior que alfa: Não há evidência estatística de que os dados se desviem dessa distribuição. → A distribuição pode ser considerada um modelo possível.
- valor p menor ou igual a alfa: O teste encontra desvios significativos. → A hipótese nula é rejeitada; a distribuição testada não se ajusta estatisticamente aos dados de forma suficiente.
Por que o teste de Anderson-Darling é usado? Ele é particularmente sensível a desvios nas áreas de borda da distribuição. É onde outliers ou valores extremos frequentemente ocorrem, que são importantes para análises de qualidade, processo e vida útil.
Interpretação dos resultados:
OS valores de viscosidade foram comparados com as distribuições Normal, Lognormal, Loglogística e Logística. Para todas as quatro distribuições, o valor p é maior que 0,05. Portanto, a hipótese nula não é rejeitada para nenhuma distribuição. Não há evidência estatística de que os dados se desviem significativamente de qualquer uma das distribuições testadas.
OS gráficos de probabilidade também mostram que os pontos estão, na maioria das vezes, próximos das linhas. Assim, os valores de viscosidade podem ser aproximadamente descritos com as distribuições testadas.
No entanto, o resultado não permite uma conclusão definitiva de que uma dessas distribuições é claramente a melhor. A seleção da distribuição deve, portanto, também ser baseada na plausibilidade técnica e na análise futura planejada. Como a viscosidade é uma medida contínua e os dados são aproximadamente distribuídos simetricamente em torno da média, a distribuição normal pode ser uma escolha sensata e bem justificada para muitas avaliações padrão futuras.
As seguintes são as considerações e etapas necessárias para testar uma série de dados contra múltiplas distribuições com Best Fit.
Preparação
- Selecione uma medida numérica apropriada.
- Colete medições.
- Selecione distribuições, por exemplo, Weibull, Gamma, Lognormal.
 Usar no AlphadiTab
- Selecione a ferramenta Teste de Distribuição na Fase de Medição.
- Selecione a série de dados a ser testada e ative uma ou mais distribuições na galeria de distribuições.
- Verifique ou ajuste o nível de significância.
- Realize a análise com Atualizar.
Interpretação
Em seguida, verifique para cada distribuição selecionada se ela é adequada para descrever as medições.
- p-valor: Se o p-valor for maior que 0,05, não há evidência estatística de um desvio da distribuição. Portanto, os dados podem ser considerados aproximadamente ajustados à distribuição.
- Gráfico de probabilidade: Se os pontos estiverem principalmente próximos da linha desenhada, a distribuição escolhida é um modelo plausível para os dados.
As seguintes distribuições estão disponíveis na ferramenta:
Distribuição Normal
A distribuição normal é uma distribuição simétrica em forma de sino. Ela ocorre frequentemente em medições que surgem de muitas pequenas influências aleatórias. Exemplos incluem dimensões, pesos, quantidades de enchimento ou valores de processo.
Tipicamente, a maioria dos valores está próxima da média, e grandes desvios para cima ou para baixo tornam-se mais raros. Se os dados se ajustam bem à distribuição normal, muitos métodos estatísticos clássicos podem ser usados.
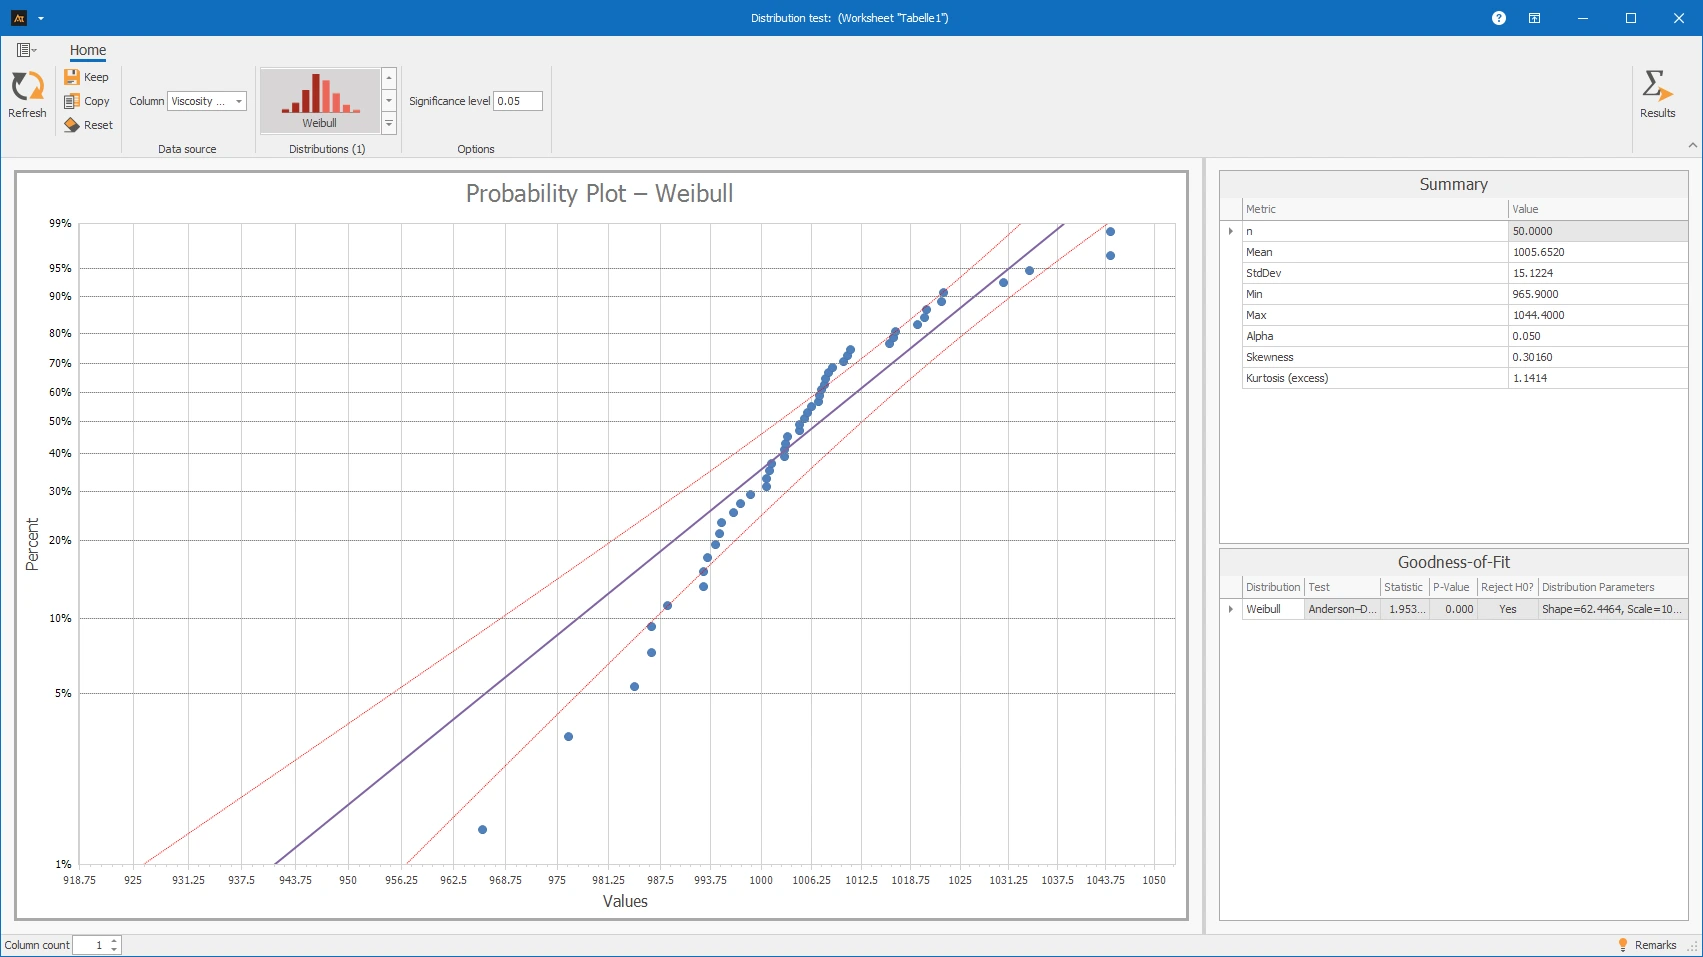
Distribuição Weibull
A distribuição Weibull é frequentemente usada para dados de vida útil, falha e confiabilidade. É particularmente adequada quando ocorrem apenas valores positivos, como tempos de operação até a falha.
Dependente do parâmetro de forma, a distribuição Weibull pode representar diferentes cursos. Isso a torna muito flexível e frequentemente usada para descrever vidas técnicas, comportamento de desgaste ou probabilidades de falha.
Distribuição Exponencial
A distribuição exponencial descreve tempos de espera ou tempos até o próximo evento. É frequentemente usada quando eventos ocorrem aleatoriamente e independentemente uns dos outros.
Exemplos típicos são tempos de espera, tempos de reação ou modelos simples de tempo de inatividade. A distribuição começa em zero e então diminui continuamente. É adequada apenas para valores maiores ou iguais a zero.
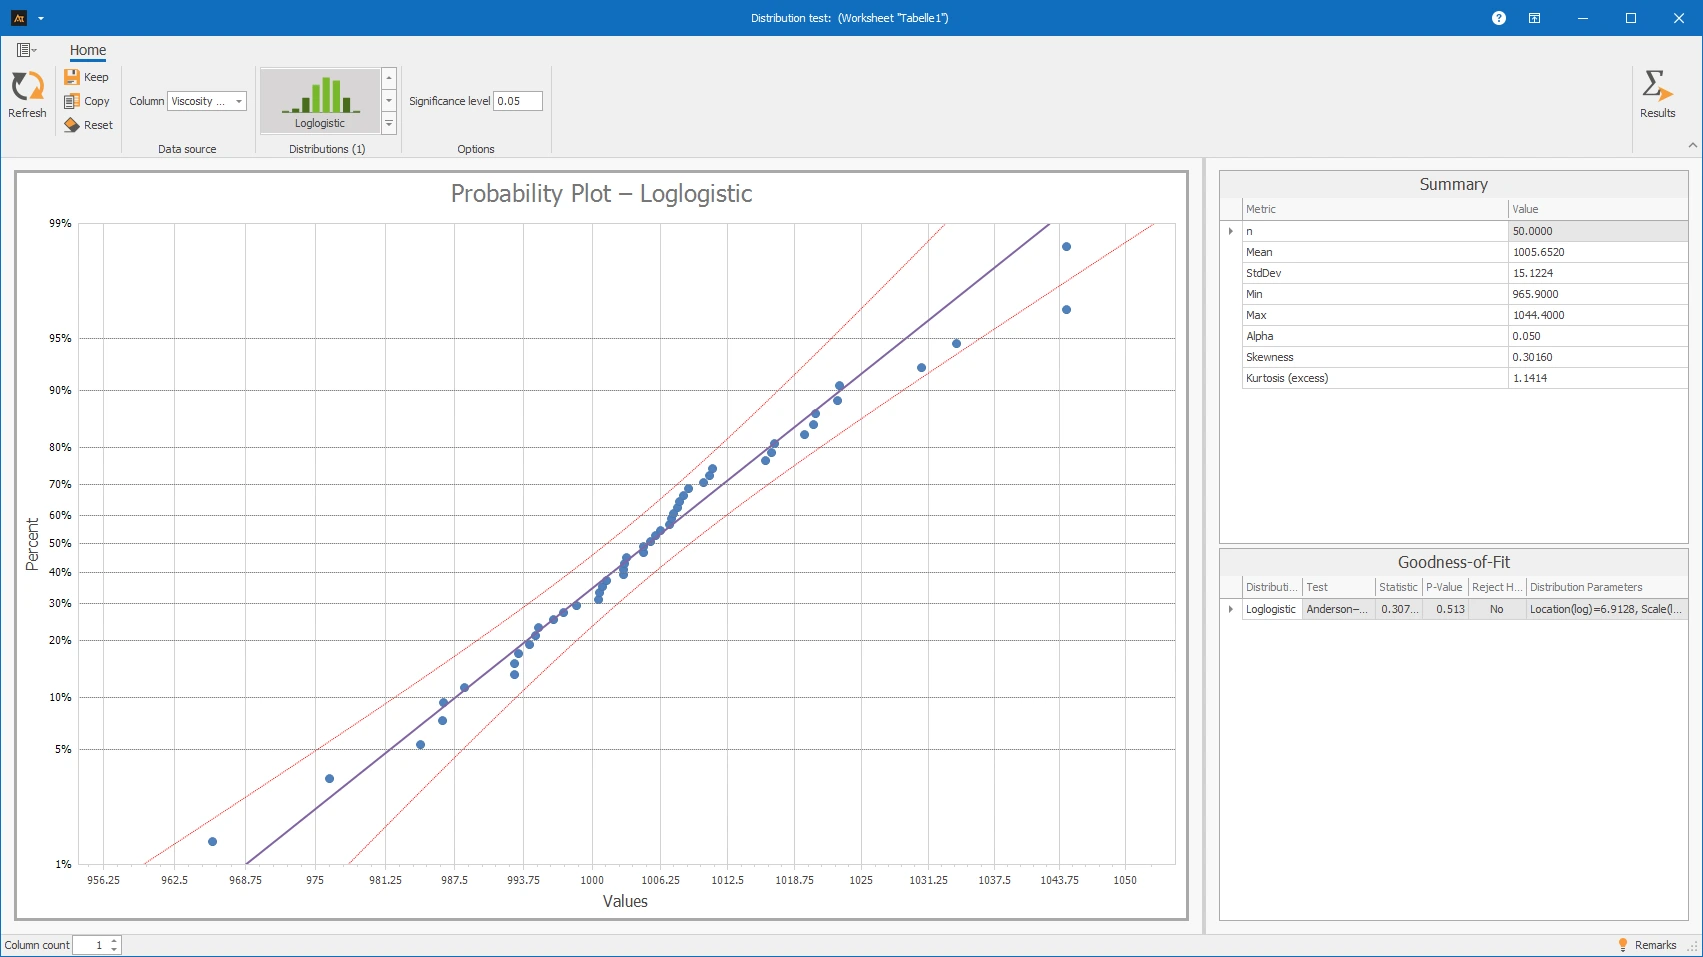
Distribuição Log-logística
A distribuição log-logística é adequada para dados positivos e assimétricos à direita. É frequentemente usada para dados de vida útil, tempo ou processo onde ocorrem muitos valores menores e alguns valores significativamente maiores.
Em alguns casos, ela se assemelha à distribuição lognormal, mas pode representar expressões mais fortes na cauda direita. Isso a torna útil quando longos tempos de processamento ou falhas tardias pesam mais.
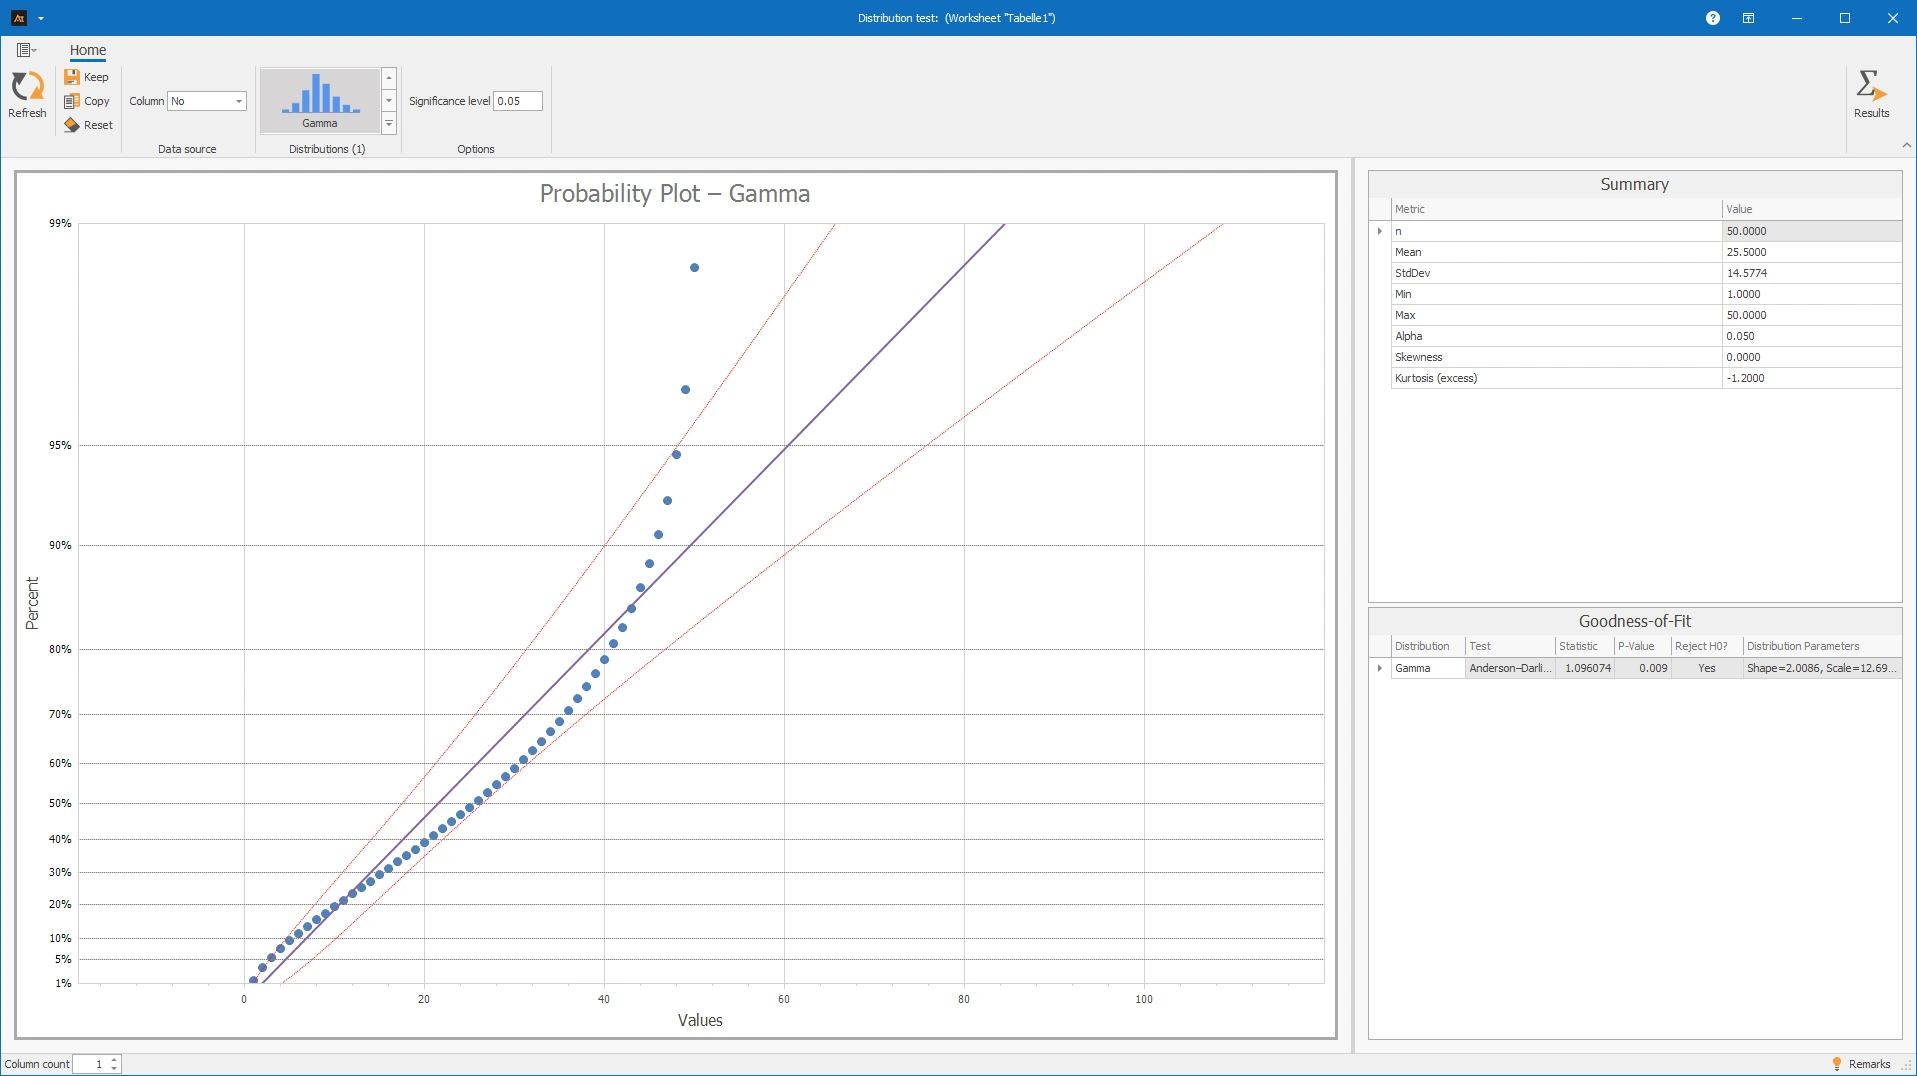
Distribuição Gama
A distribuição gama é usada para dados positivos e assimétricos à direita. É adequada para medições como tempos de espera, tempos de processamento, quantidades ou cargas, desde que não possam ocorrer valores negativos.
Ela é mais flexível do que a distribuição exponencial porque pode assumir diferentes formas. Isso permite descrever bem tanto dados altamente assimétricos quanto moderadamente assimétricos.
Distribuição Lognormal
A distribuição lognormal surge quando os valores logarítmicos são aproximadamente distribuídos normalmente. É usada para dados positivos que são assimétricos à direita.
Exemplos típicos são tempos, vidas úteis, concentrações, custos ou outras quantidades onde podem ocorrer valores individuais muito grandes. Se os dados não são distribuídos normalmente, uma distribuição lognormal pode muitas vezes se ajustar melhor.
Distribuição Logística
A distribuição logística é simétrica e se assemelha à distribuição normal. No entanto, ela tem caudas ligeiramente mais fortes, permitindo que valores extremos ocorram um pouco mais frequentemente do que na distribuição normal.
Ela pode ser usada quando os dados são geralmente distribuídos simetricamente, mas a distribuição normal não descreve bem as caudas.
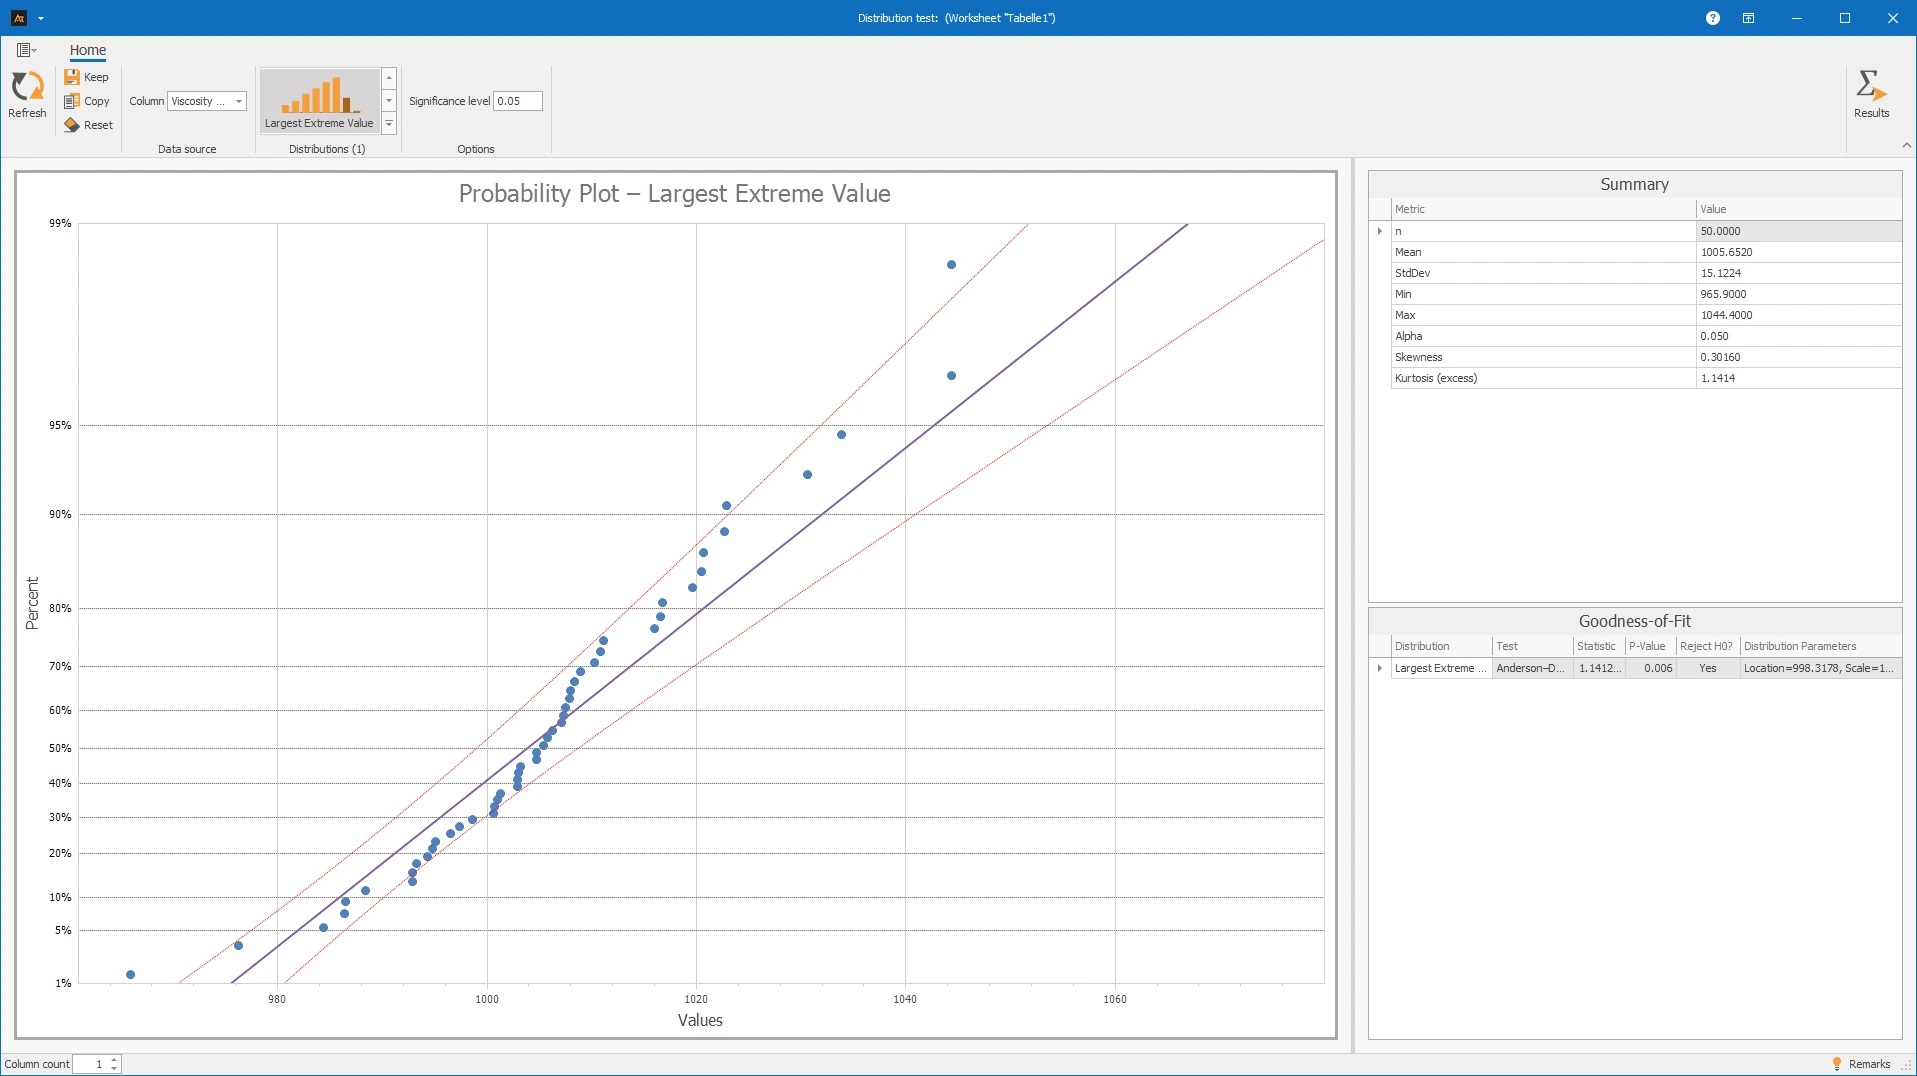
Distribuição de Gumbel
A distribuição de Gumbel descreve valores máximos. É usada quando valores particularmente altos são o foco, como cargas máximas, temperaturas de pico, tempos de espera máximos ou valores de pico.
Ela é adequada quando não é o valor médio típico, mas o comportamento das maiores observações que é importante.
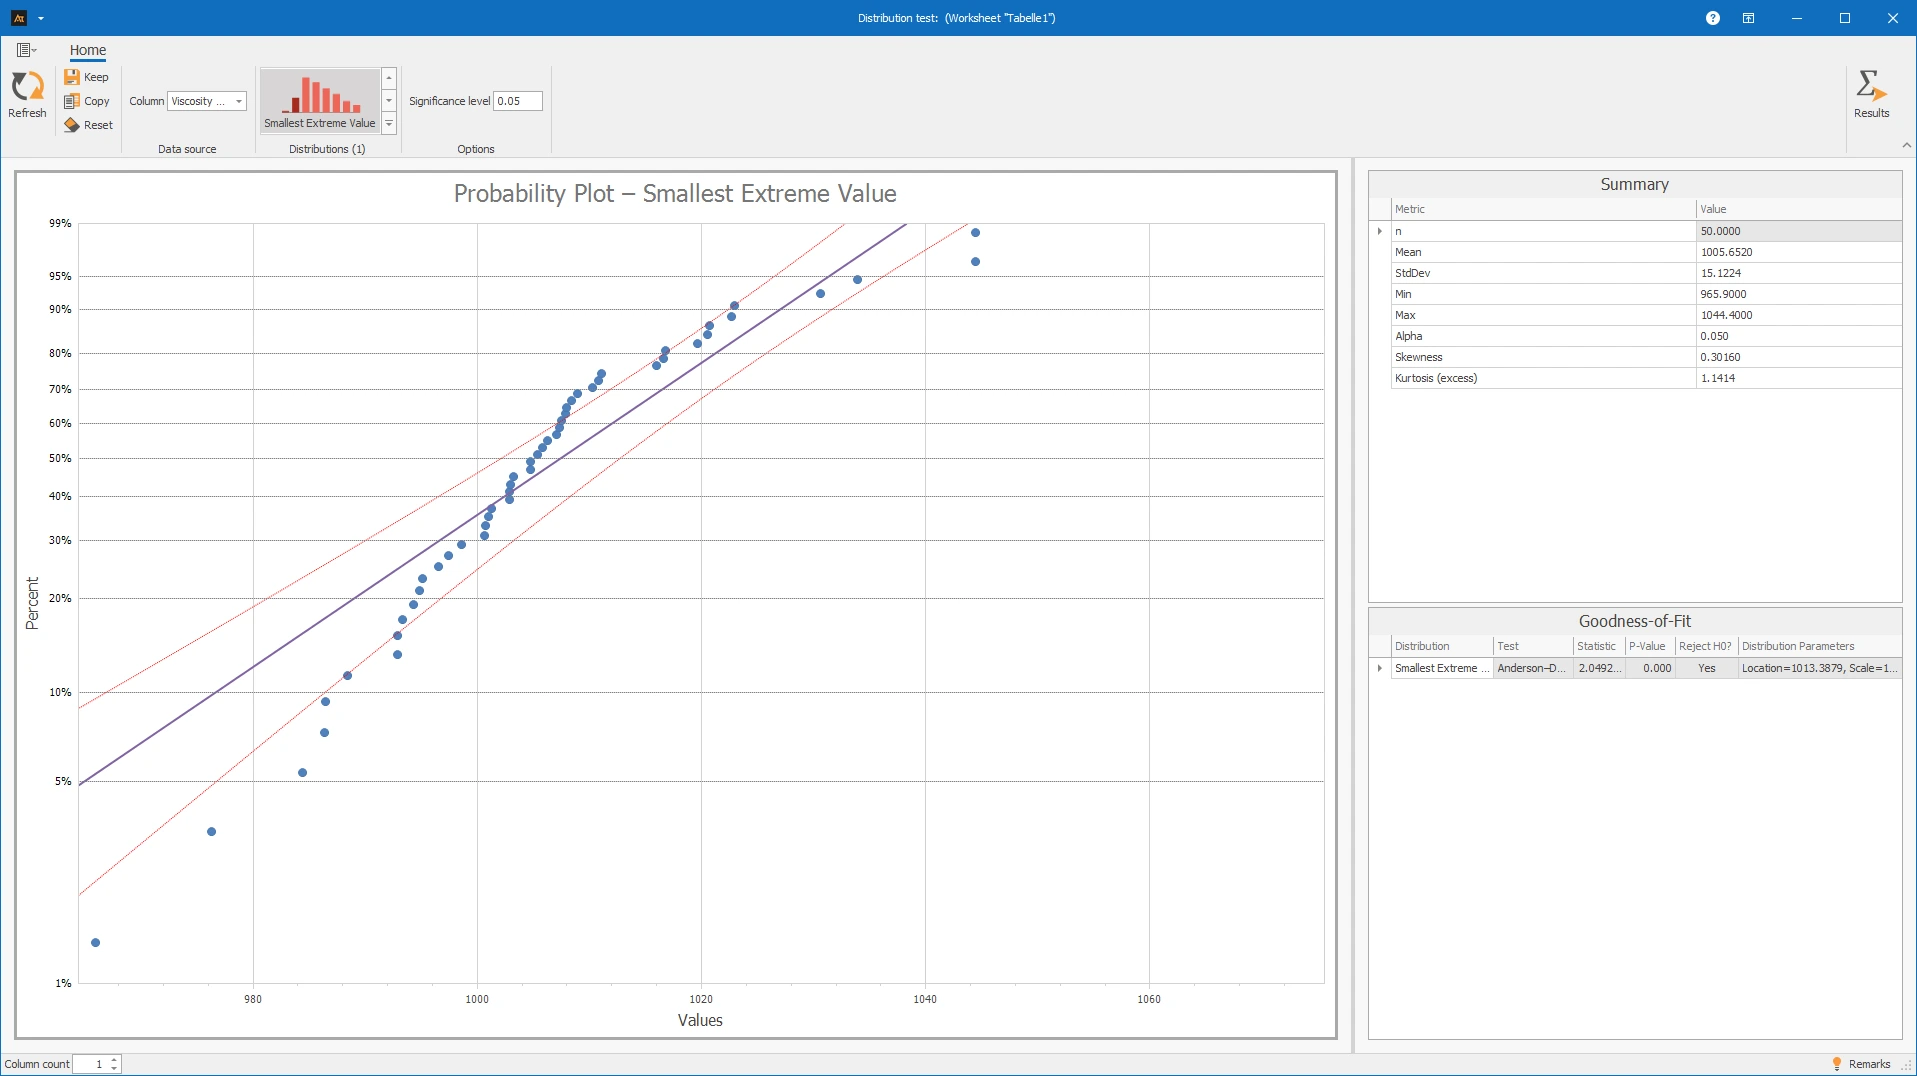
Distribuição de Valor Extremo Mínimo
A distribuição de valor extremo mínimo descreve valores mínimos. É usada quando valores particularmente pequenos são o foco, como resistências mínimas, menores vidas úteis ou falhas mais precoces.
Ela é útil quando o risco de medições muito pequenas precisa ser avaliado, por exemplo, em limites de segurança ou requisitos mínimos.
Para dados nominais ou ordinais, o teste de distribuição não é significativo, pois esses tipos de dados não podem ser descritos por distribuições contínuas como normal, Weibull ou gama.
Para dados de contagem pura ou eventos discretos, deve-se verificar se um método específico para distribuições discretas é mais adequado. O teste de distribuição é projetado para as distribuições contínuas suportadas na ferramenta.
O teste de distribuição é mais adequado quando várias distribuições possíveis devem ser comparadas entre si.
Quantidade de enchimento molho de tomate
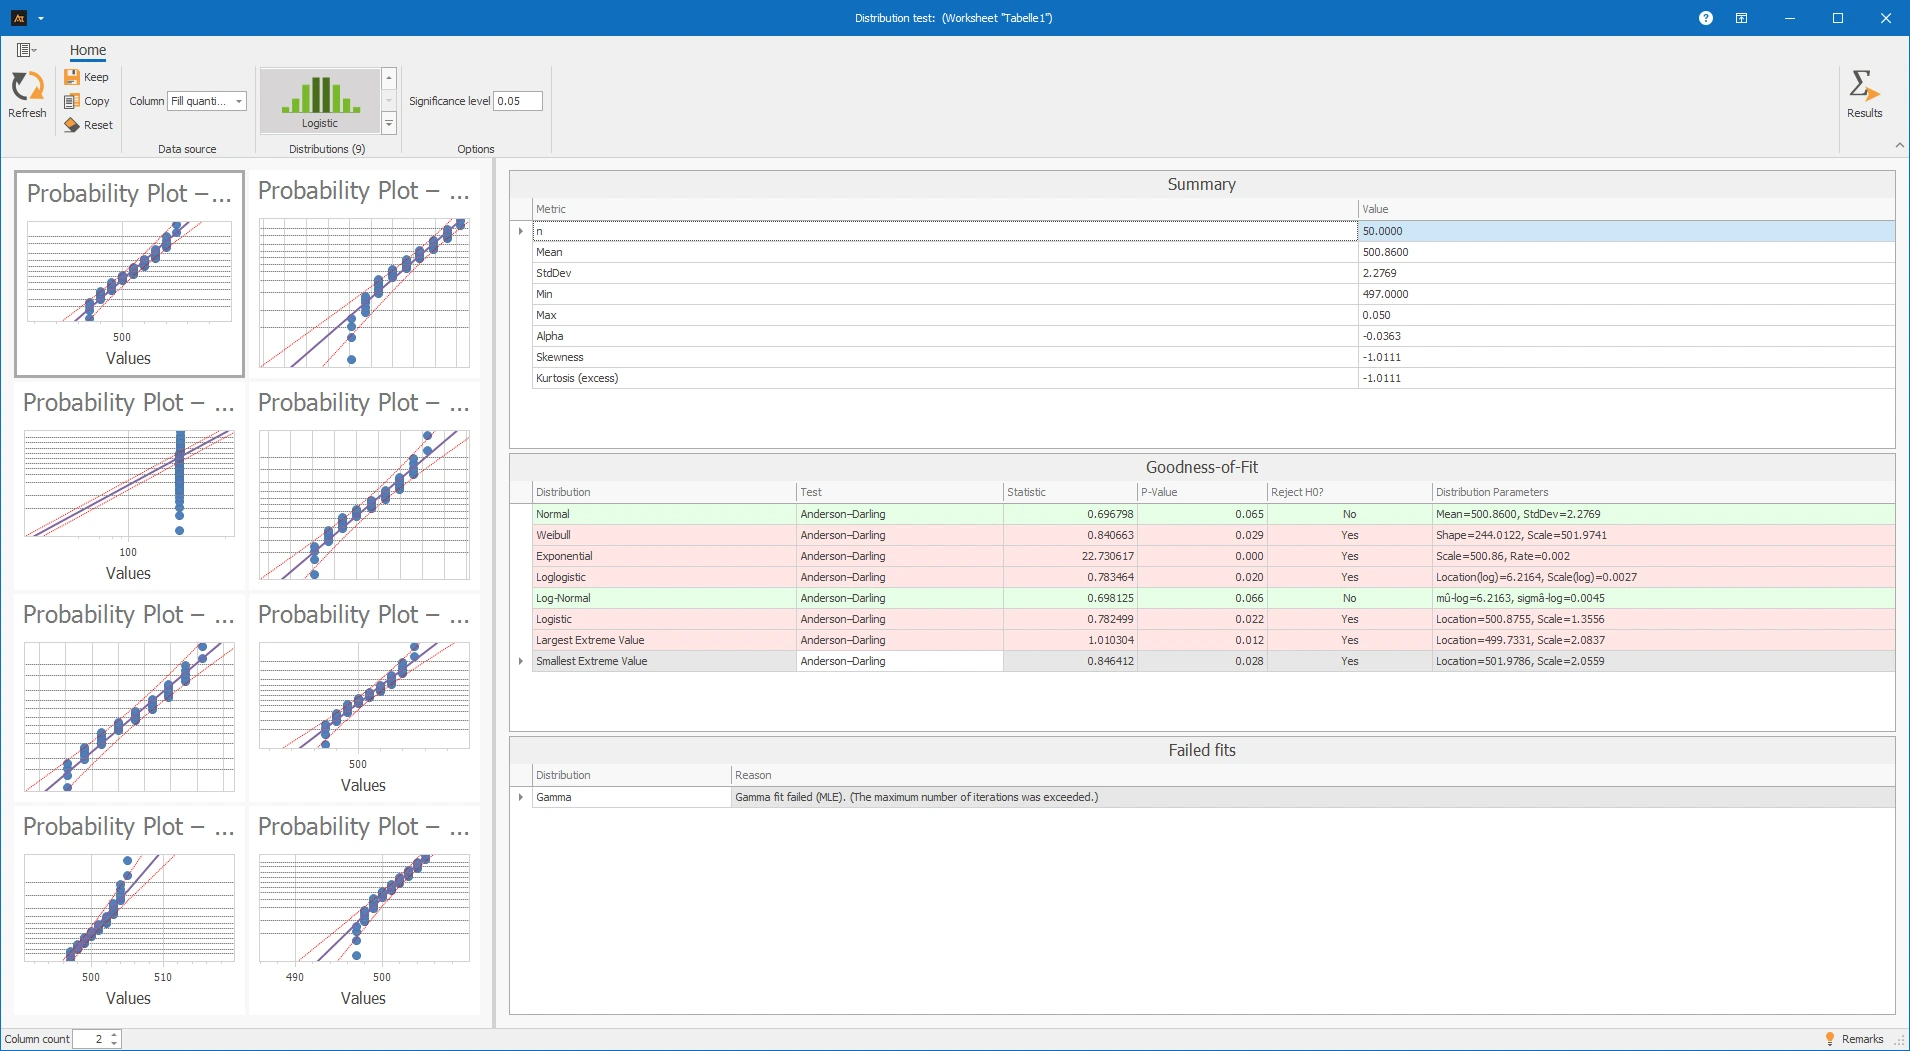
Neste exemplo, a quantidade de enchimento de um molho de tomate é examinada. Cada enchimento deve conter 500 ml. Devido a flutuações normais do processo, algumas quantidades de enchimento estão ligeiramente abaixo e outras ligeiramente acima do valor alvo. Como tais medições frequentemente se dispersam aproximadamente de forma simétrica em torno do valor alvo, verifica-se qual distribuição descreve sensivelmente os dados. Para este fim, as quantidades de enchimento são comparadas com várias distribuições, incluindo a distribuição normal.
Interpretação
As quantidades de enchimento foram comparadas com várias distribuições. Como resultado, a distribuição normal não é rejeitada porque o valor p de 0,065 é maior que o nível de significância de 0,05. Além disso, no gráfico de probabilidade, os pontos estão principalmente próximos à linha. Portanto, as quantidades de enchimento podem ser aproximadamente descritas por uma distribuição normal.
Várias outras distribuições, por outro lado, são rejeitadas porque seus valores p são menores ou iguais a 0,05. Estas incluem, entre outras, Weibull, Exponencial, Log-logística, Logística, e a maior distribuição de valor extremo. Há evidências estatísticas para essas distribuições de que elas não descrevem adequadamente os dados.
A distribuição log-normal também não é rejeitada. No entanto, em termos de quantidades de enchimento, a distribuição normal é frequentemente sensata porque é uma medição contínua que tipicamente se dispersa em torno de um valor alvo.
A distribuição gama não pôde ser calculada porque o ajuste falhou. Portanto, não é usada para interpretação.
Conclusão:
Para análise adicional, a distribuição normal pode ser usada porque não é estatisticamente rejeitada e se ajusta bem às quantidades de enchimento.
Tempo de Entrega de um Pedido em Recebimento de Mercadorias
No recebimento de mercadorias, os tempos de processamento frequentemente têm uma distribuição assimétrica à direita: Muitos pedidos são concluídos rapidamente, mas alguns processos demoram significativamente mais. Portanto, uma distribuição log-normal, gama, Weibull ou exponencial pode ser mais plausível do que uma distribuição normal.
Interpretação
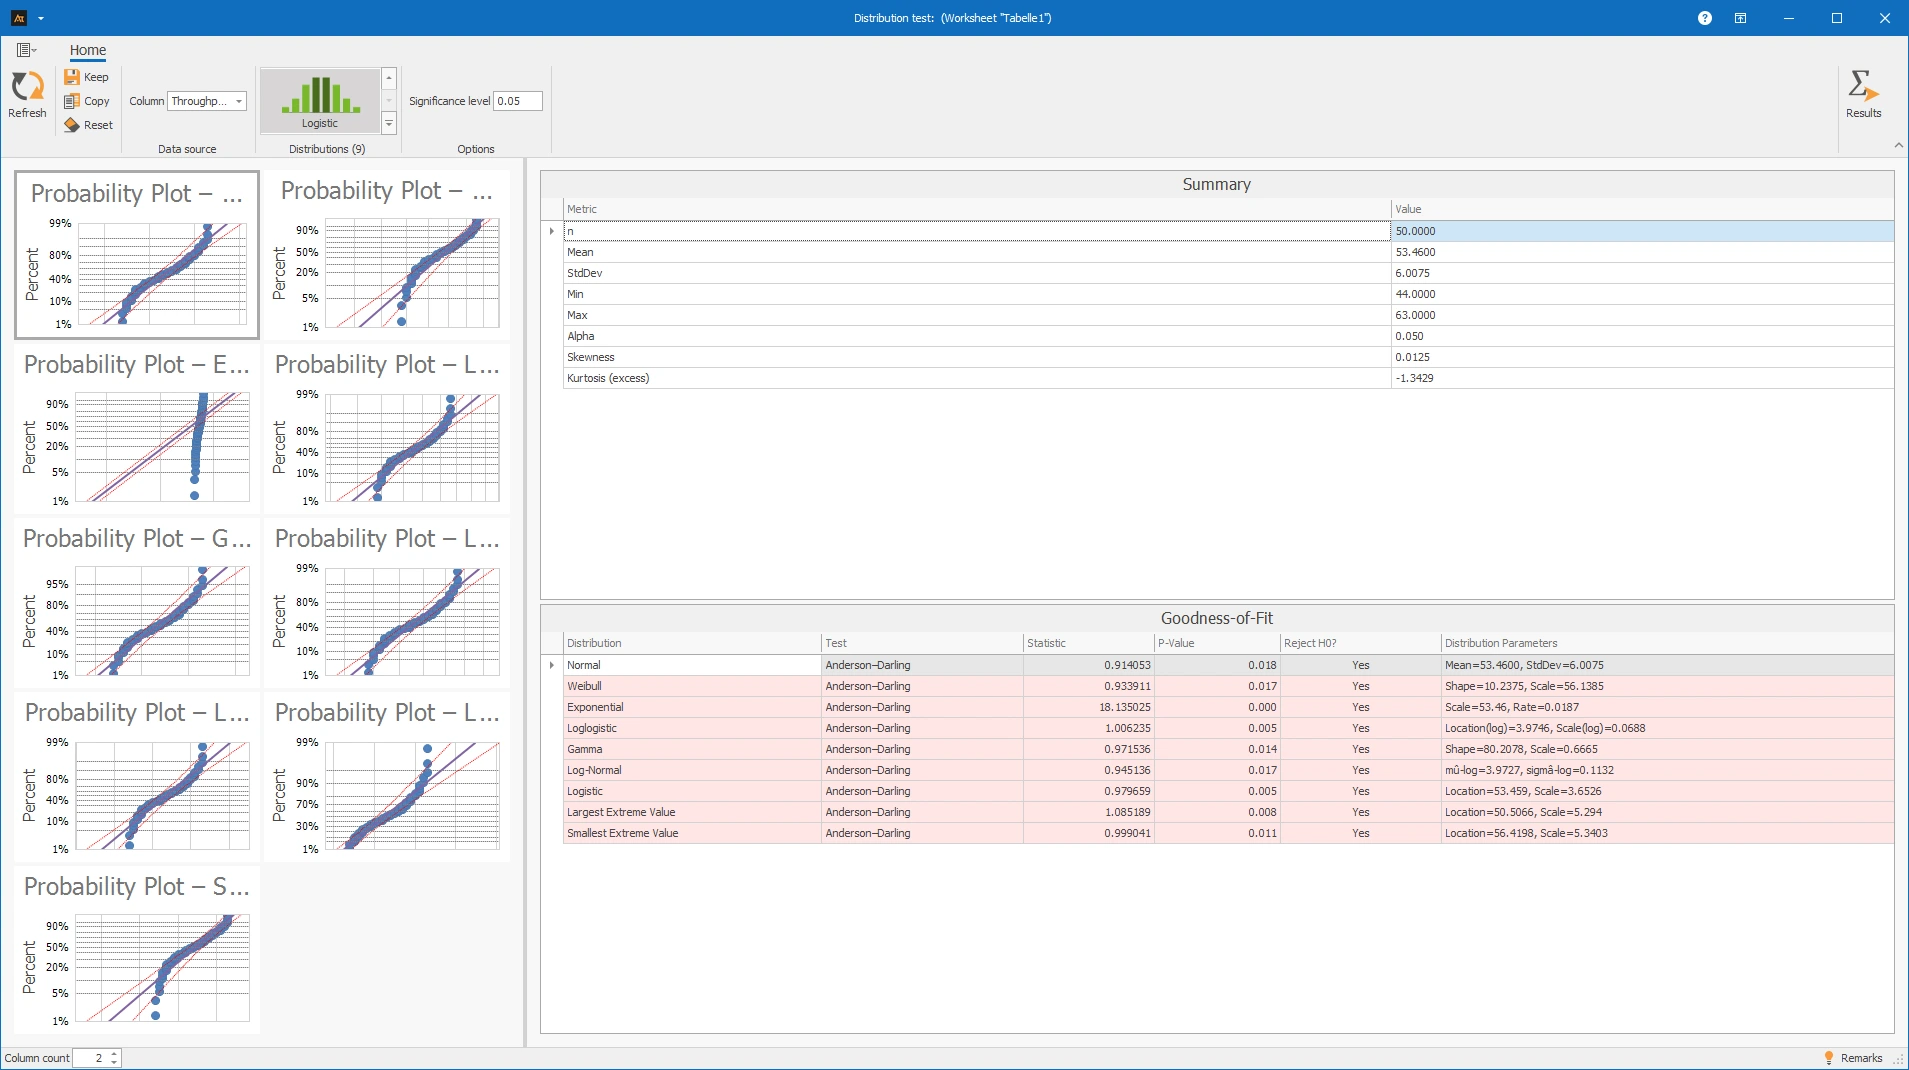
Os tempos de entrega foram comparados com várias distribuições. Para todas as distribuições testadas, o valor de p é inferior a 0,05. Portanto, todas as distribuições são rejeitadas.
Também, nos gráficos de probabilidade, os pontos não se alinham suficientemente bem nas linhas. Portanto, os dados não podem ser adequadamente descritos por nenhuma das distribuições testadas.
Conclusão:
Nenhuma das distribuições testadas deve ser usada para os tempos de entrega. Deve-se verificar se diferentes estados de processo ou tipos de pedidos causam a variação.
Tempo de resposta do helpdesk de TI (Especificação: máx. 35 minutos (OSG))
Dúvidas simples e complexas são recebidas no service desk de TI. Isso pode resultar em tempos de resposta que variam em torno de um valor típico, mas também têm longas caudas à direita. Best Fit ajuda a verificar qual distribuição melhor descreve esse comportamento.
Interpretação
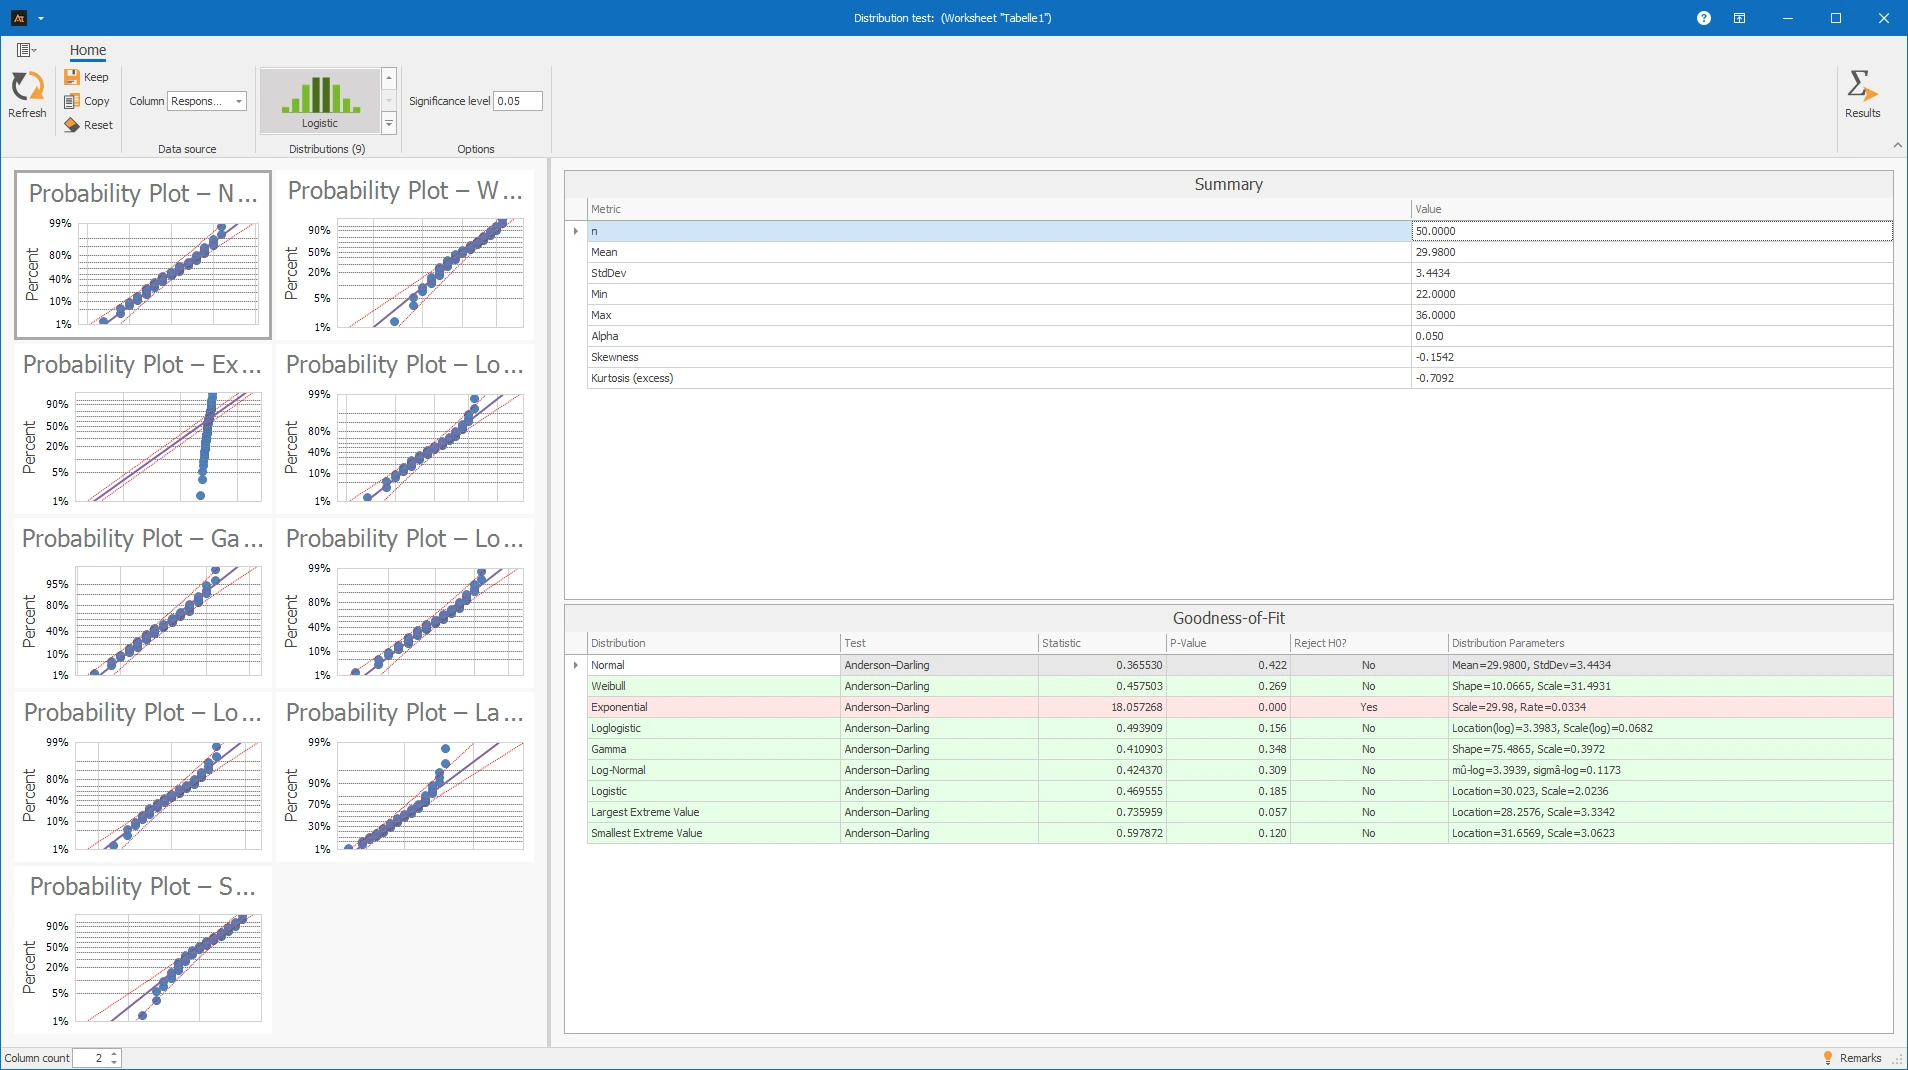
OS tempos de resposta foram comparados com várias distribuições. A maioria das distribuições testadas não é rejeitada porque seus valores de p são maiores que 0,05. Apenas a distribuição exponencial é rejeitada porque o valor de p é menor que 0,05.
Para essa distribuição, os dados não se ajustam suficientemente bem. Os gráficos de probabilidade também mostram predominantemente pontos próximos à linha para as distribuições não rejeitadas.
Conclusão:
OS tempos de resposta podem ser descritos aproximadamente por várias distribuições. Para uma análise mais aprofundada, deve-se escolher uma distribuição apropriada para o assunto; a distribuição exponencial não deve ser usada.
Vida útil dos rolamentos
Para um novo tipo de máquina, os rolamentos são testados em operação contínua. Cada rolamento permanece no banco de testes até que não seja mais funcional. Tais dados de vida útil são tipicamente positivos e muitas vezes não são distribuídos normalmente.
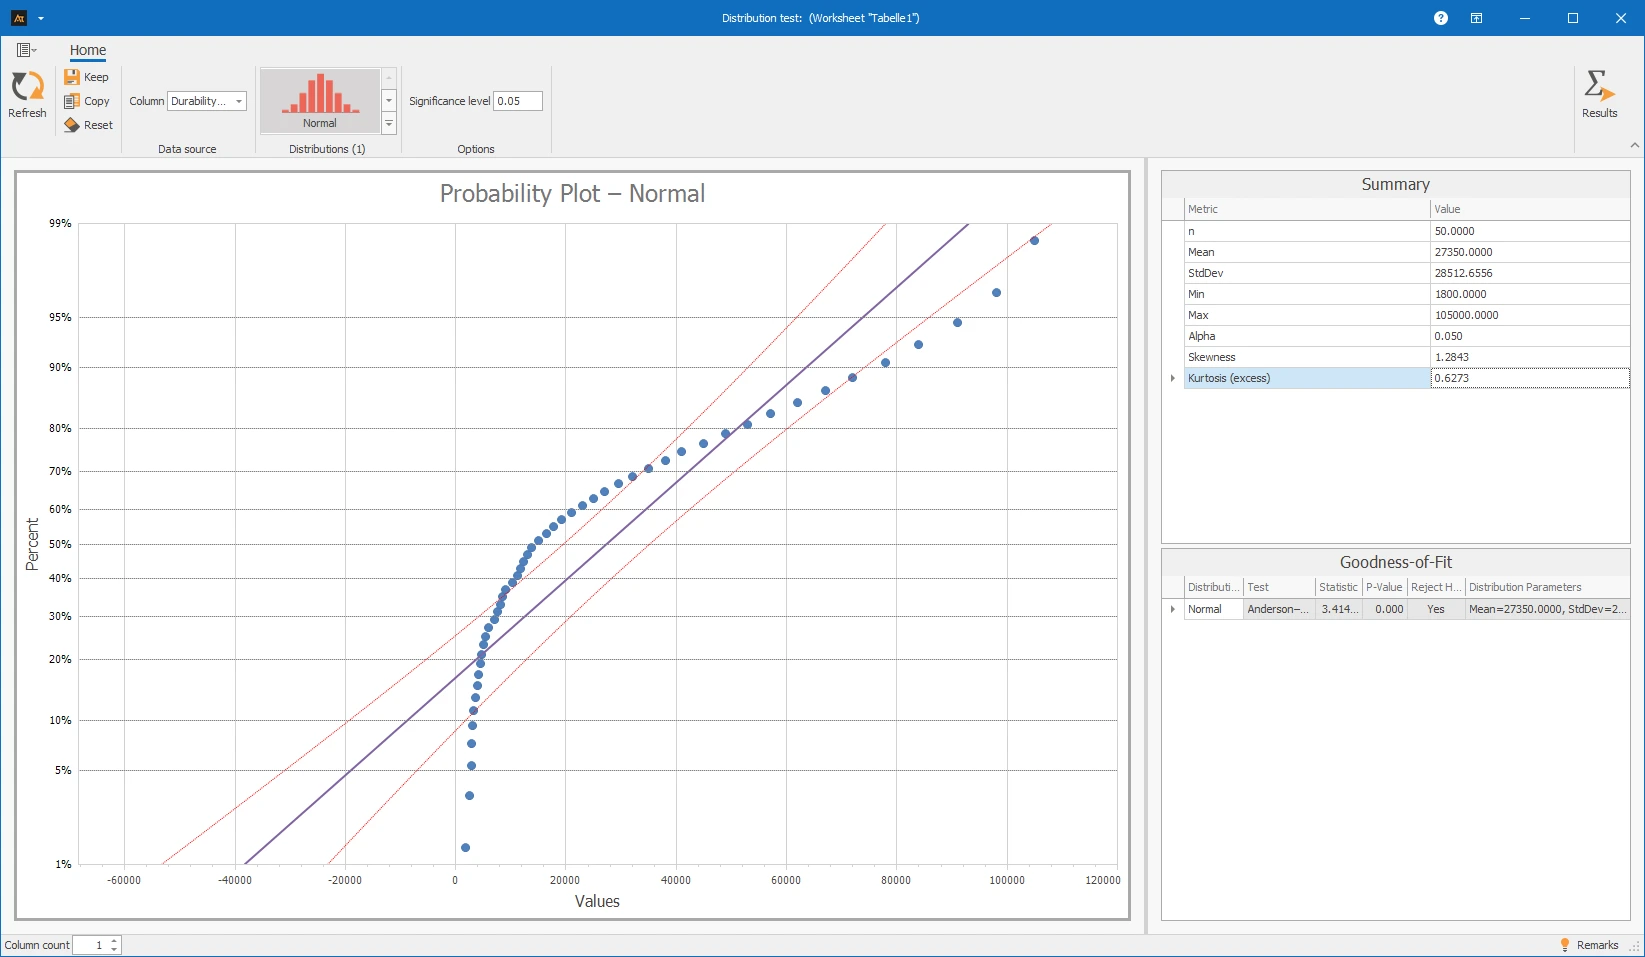
No gráfico de probabilidade da distribuição normal, os pontos podem desviar-se significativamente da linha. Isso argumenta contra uma distribuição normal das vidas úteis.
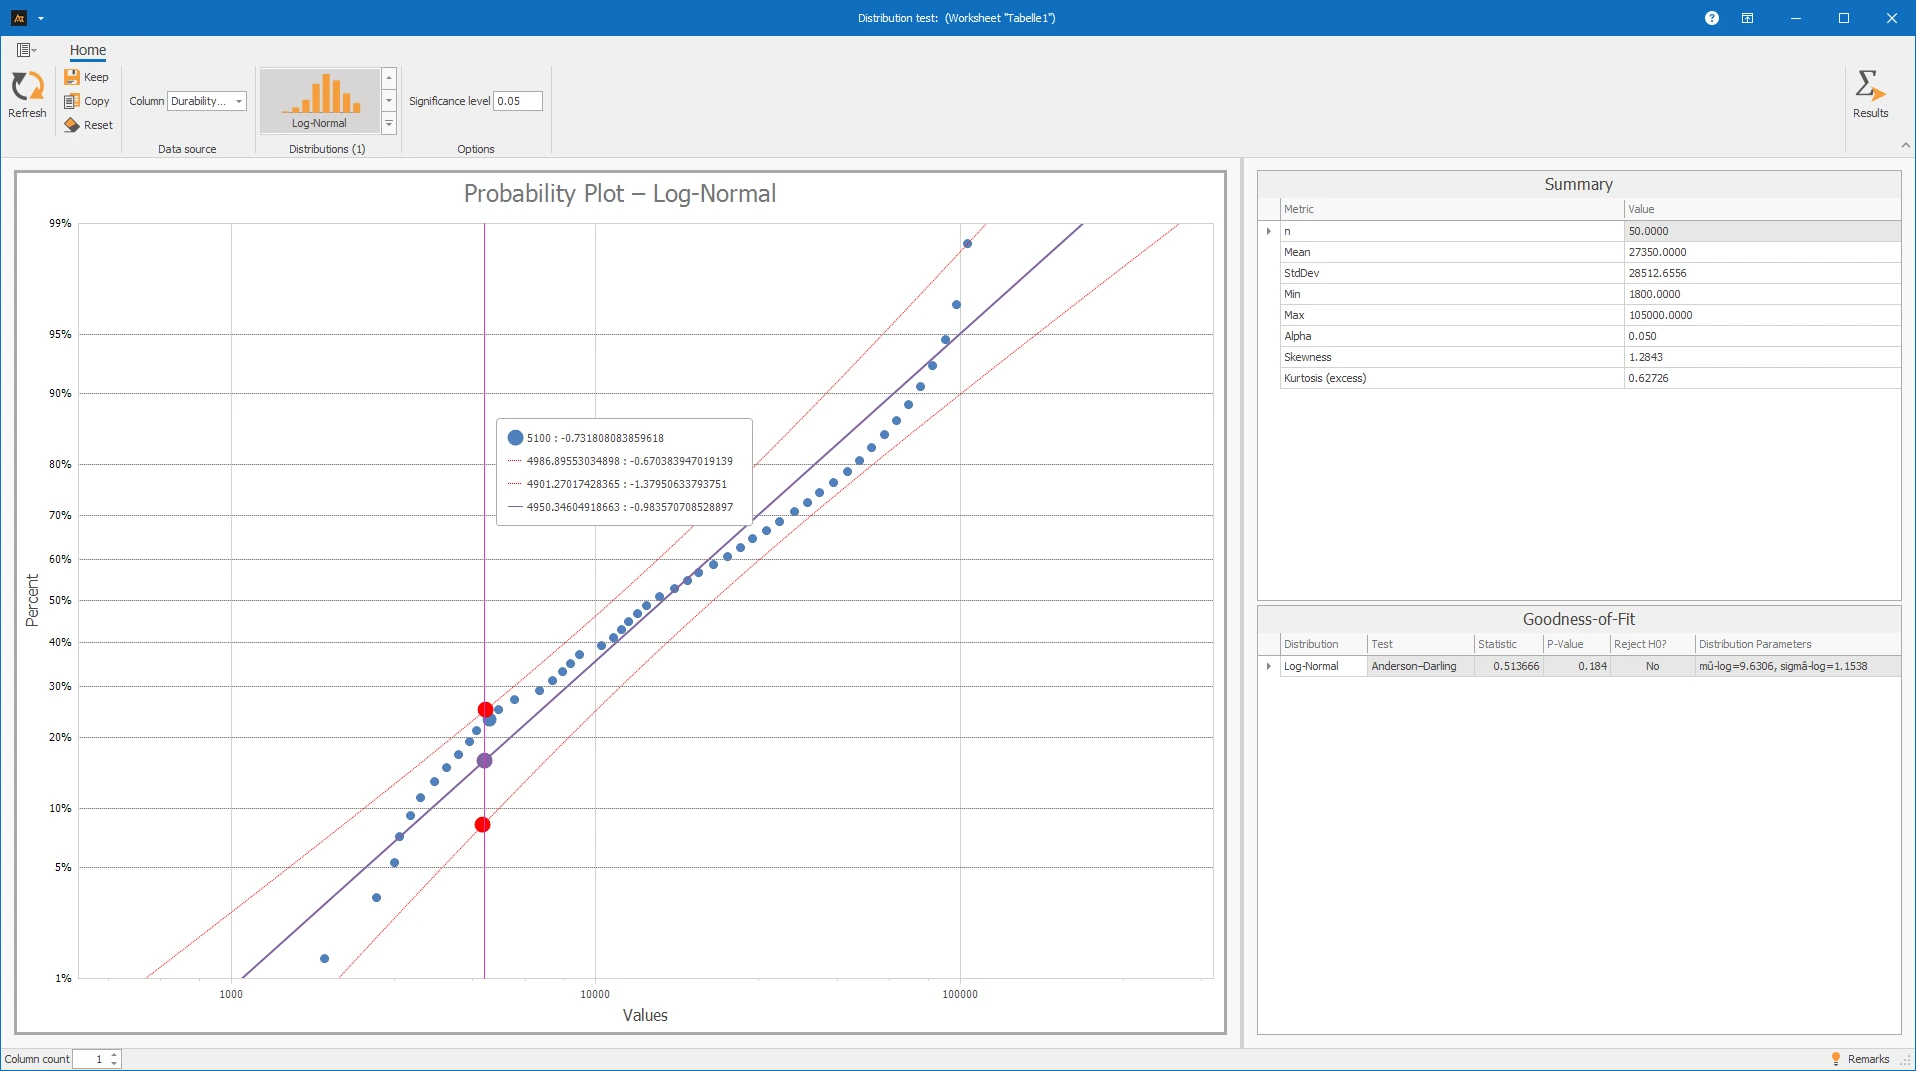
A vida útil dos rolamentos foi testada com a distribuição lognormal. O valor p é 0,190 e, portanto, é maior que 0,05. A distribuição lognormal, portanto, não é rejeitada.
Também no gráfico de probabilidade, os pontos estão principalmente próximos da linha. Os dados de vida útil podem, portanto, ser aproximadamente descritos por uma distribuição lognormal.
Dados contínuos: Dados coletados com um instrumento de medição que podem ter unidades e casas decimais.
Distribuição: Modelo matemático que descreve como as medições geralmente se espalham.
Teste de Anderson-Darling: Teste estatístico para verificar se os dados se ajustam a uma distribuição selecionada.
Valor p: Métrica para avaliar o resultado do teste. Quanto menor o valor p, mais forte os dados falam contra a distribuição testada.
Estatística A²: Medida da desvio dos dados em relação à distribuição testada. Valores menores tendem a indicar menos desvio da distribuição testada.
H0: Hipótese nula do teste. Afirma: Os dados seguem a distribuição testada.
n = Tamanho da amostra: Número de medições válidas na amostra.
Média: Média de todas as medições. Descreve a localização central dos dados.
Desvio padrão: Medida de quanto as medições se espalham em torno da média. Um desvio padrão pequeno significa pouca dispersão, um desvio padrão grande significa maior dispersão.
Mínimo: Menor medição dentro da amostra considerada.
Máximo: Maior medição dentro da amostra considerada.
Alfa (α): Define o nível de significância e o limiar de decisão para o valor p. Muitas vezes α = 0,05 é usado. Se o valor p for menor que Alfa, a hipótese nula H0 é rejeitada.
Assimetria: Métrica para a simetria de uma distribuição. Um valor próximo de 0 indica uma distribuição aproximadamente simétrica. Valores positivos ou negativos indicam uma expressão mais forte da distribuição para a direita ou esquerda, respectivamente.
Curto-circuito: Métrica que descreve a forma de uma distribuição, particularmente como as medições se concentram fortemente no centro e nas caudas. Pode fornecer pistas sobre se uma distribuição é mais pontiaguda ou achatada em comparação com uma distribuição normal.
O teste de distribuição calcula os parâmetros correspondentes, a estatística do teste e o valor p para as distribuições selecionadas. Funções da biblioteca Numerics.NET são usadas para calcular a estatística do teste.