


O poder indica a probabilidade com que um teste estatístico detecta um efeito realmente existente.
É usado para avaliar se a base de dados existente é suficiente para detectar de forma confiável diferenças, variações ou mudanças em taxas relevantes.
Ao contrário do teste de hipótese clássico, o poder não se concentra na decisão entre a hipótese alternativa e a hipótese nula, mas sim em quão poderoso é o teste sob as suposições dadas:
- poder alto → um efeito relevante é detectado com alta probabilidade
- poder baixo → um efeito existente pode permanecer não detectado apesar da investigação
Importante: Ao calcular o poder, os dados resumidos no AlphadiTab são inseridos. Portanto, dados brutos não são necessários, mas métricas como tamanho da amostra, média, desvio padrão ou número de eventos.
No desenvolvimento de produtos, uma nova formulação de molho de tomate está sendo testada. O objetivo é determinar se a viscosidade da nova formulação difere em média da formulação anterior.
Para este propósito, medições de viscosidade são realizadas em amostras da formulação antiga e da nova formulação.
Usando o teste t (2 amostras), verificou-se se a diferença observada nas médias é estatisticamente significativa ou pode ser explicada por variação aleatória.
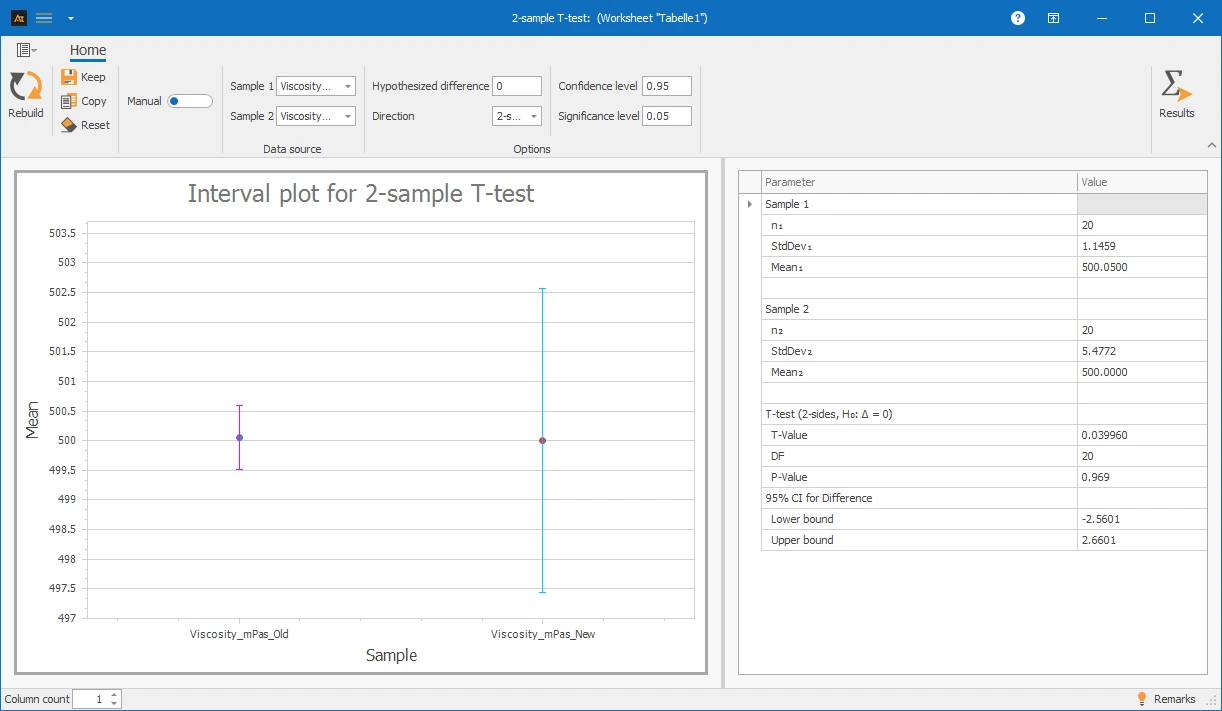
O valor p calculado está significativamente acima do nível de significância de 0,05, portanto, a hipótese nula é mantida. Com base neste teste, não foi encontrada diferença significativa entre a viscosidade média da formulação antiga e da nova. Com o cálculo do poder, agora queremos avaliar quão confiavelmente uma diferença real pode ser detectada.
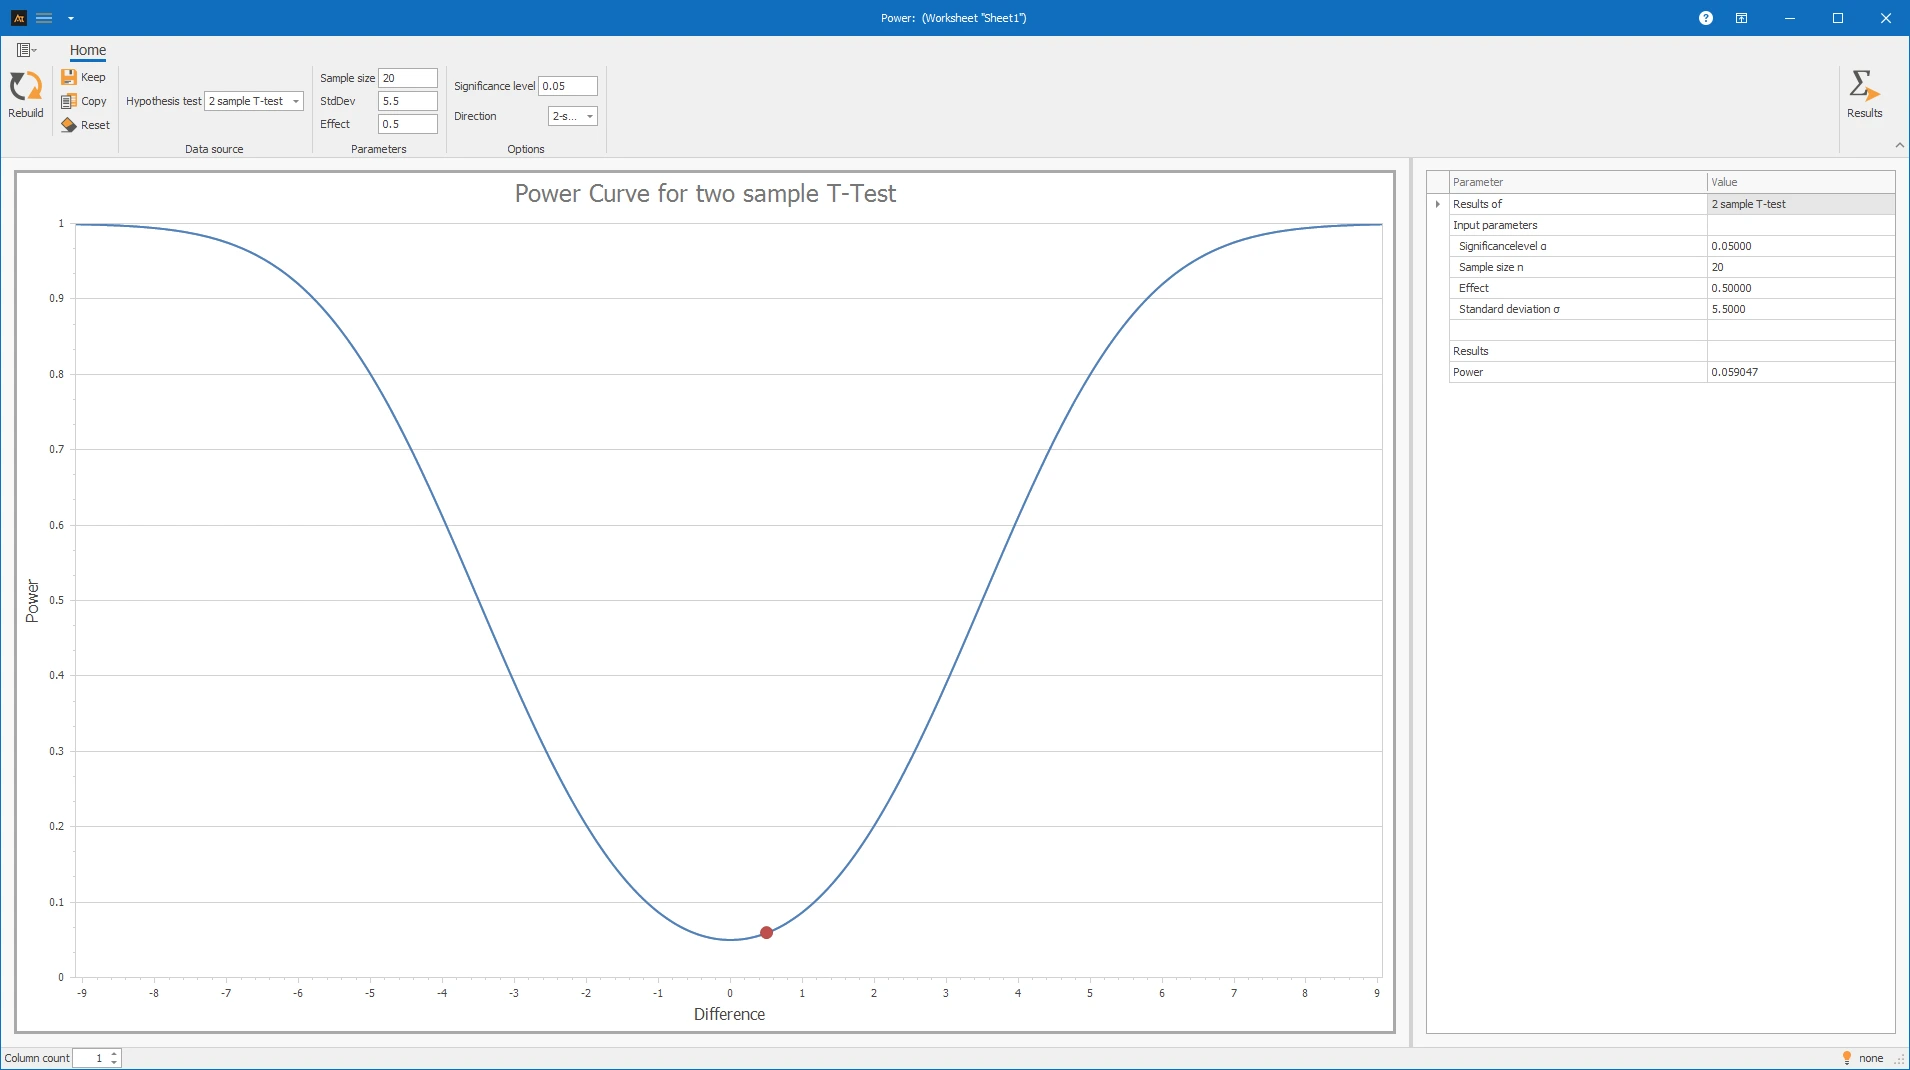
Para isso, precisamos determinar qual diferença na viscosidade média queremos detectar. A chave é qual diferença é praticamente relevante. Neste exemplo, uma diferença nas médias de 0,5 MPa deve ser detectada. Esta diferença corresponde ao efeito. Podemos obter o tamanho da amostra e o desvio padrão do teste realizado. O desvio padrão foi arredondado para 5,5; o menos favorável dos dois desvios padrão é usado aqui.
Interpretação dos resultados:
O poder é 0,059. Isso corresponde a um erro β de 94,1%. Nessas condições, o teste não pode detectar de forma confiável uma diferença real de 0,5 MPa. A partir da curva de poder, é evidente que um efeito de cerca de 5 MPa pode ser detectado com este teste com aproximadamente 80% de poder. O erro β seria então de cerca de 20%.
Explicações do gráfico:
- A curva mostra o poder para diferentes efeitos (diferenças)
- O ponto representa a entrada atual.
As seguintes são as considerações e etapas necessárias para calcular o poder para vários testes estatísticos.
Preparação
- Selecione o teste apropriado (por exemplo, teste t, teste F, teste de proporções ou ANOVA).
- Determine qual diferença, razão de variância ou mudança nas proporções é praticamente relevante.
- Defina o nível de significância (geralmente α = 0,05).
- Determine o poder desejado ou erro beta.
- Determine a direção da hipótese (bicaudal, maior ou menor), se o método suportar essa escolha.
 Uso no AlphadiTab
- Na Fase de Análise, selecione a ferramenta Poder.
- Selecione o tipo apropriado de teste, por exemplo, teste t, teste F, teste de proporções ou ANOVA.
- Insira as métricas resumidas nos campos de entrada.
- Conduza a análise por “Criar Novo”.
Interpretação
- Verifique se o poder calculado é suficientemente alto.
- Na prática, 80% ou 90% de poder é frequentemente usado como diretriz.
- Se o poder for baixo, verifique se é necessário um tamanho de amostra maior ou um design de estudo mais focado.
Importante: O poder não é uma confirmação retrospectiva de um valor p. Ele descreve quão provável é que um teste detecte um efeito assumido sob as entradas escolhidas.
Tipos de teste
- Teste t: Sensibilidade para comparar médias.
- Teste F: Sensibilidade para comparar variâncias ou dispersões.
- Teste de proporções: Sensibilidade para comparar razões ou eventos binários.
- ANOVA: Sensibilidade para comparar médias de dois ou mais grupos.
- Teste de variâncias: Sensibilidade para comparar variâncias ou dispersões de duas ou mais amostras, opcionalmente não paramétrico.
Em testes de hipótese com 2 amostras, a direção para a hipótese alternativa pode ser selecionada.
Escolha dois lados se uma diferença deve ser detectada sem especificar uma direção particular.
- Esta configuração é útil quando tanto valores mais altos quanto mais baixos seriam relevantes.
Exemplo:
O tempo médio de entrega é diferente entre dois processos?
Escolha maior se um efeito for relevante apenas na direção de valores mais altos.
- Esta configuração é útil, por exemplo, se for necessário testar se uma taxa de sucesso aumenta.
Exemplo:
A taxa de vendas é maior com uma nova abordagem de vendas do que antes?
Escolha menor se um efeito for relevante apenas na direção de valores mais baixos.
- Esta configuração é útil, por exemplo, se for necessário testar se o tempo de processamento ou a taxa de defeitos diminui.
Exemplo:
O tempo médio de processamento após uma otimização é menor do que antes?
Quantidade de enchimento molho de tomate – Máquina A vs. Máquina B
Na produção, várias máquinas de enchimento são usadas. Deve-se avaliar se os dados disponíveis são suficientes para detectar de forma confiável uma diferença entre a Máquina A e a Máquina B.
Teste t:
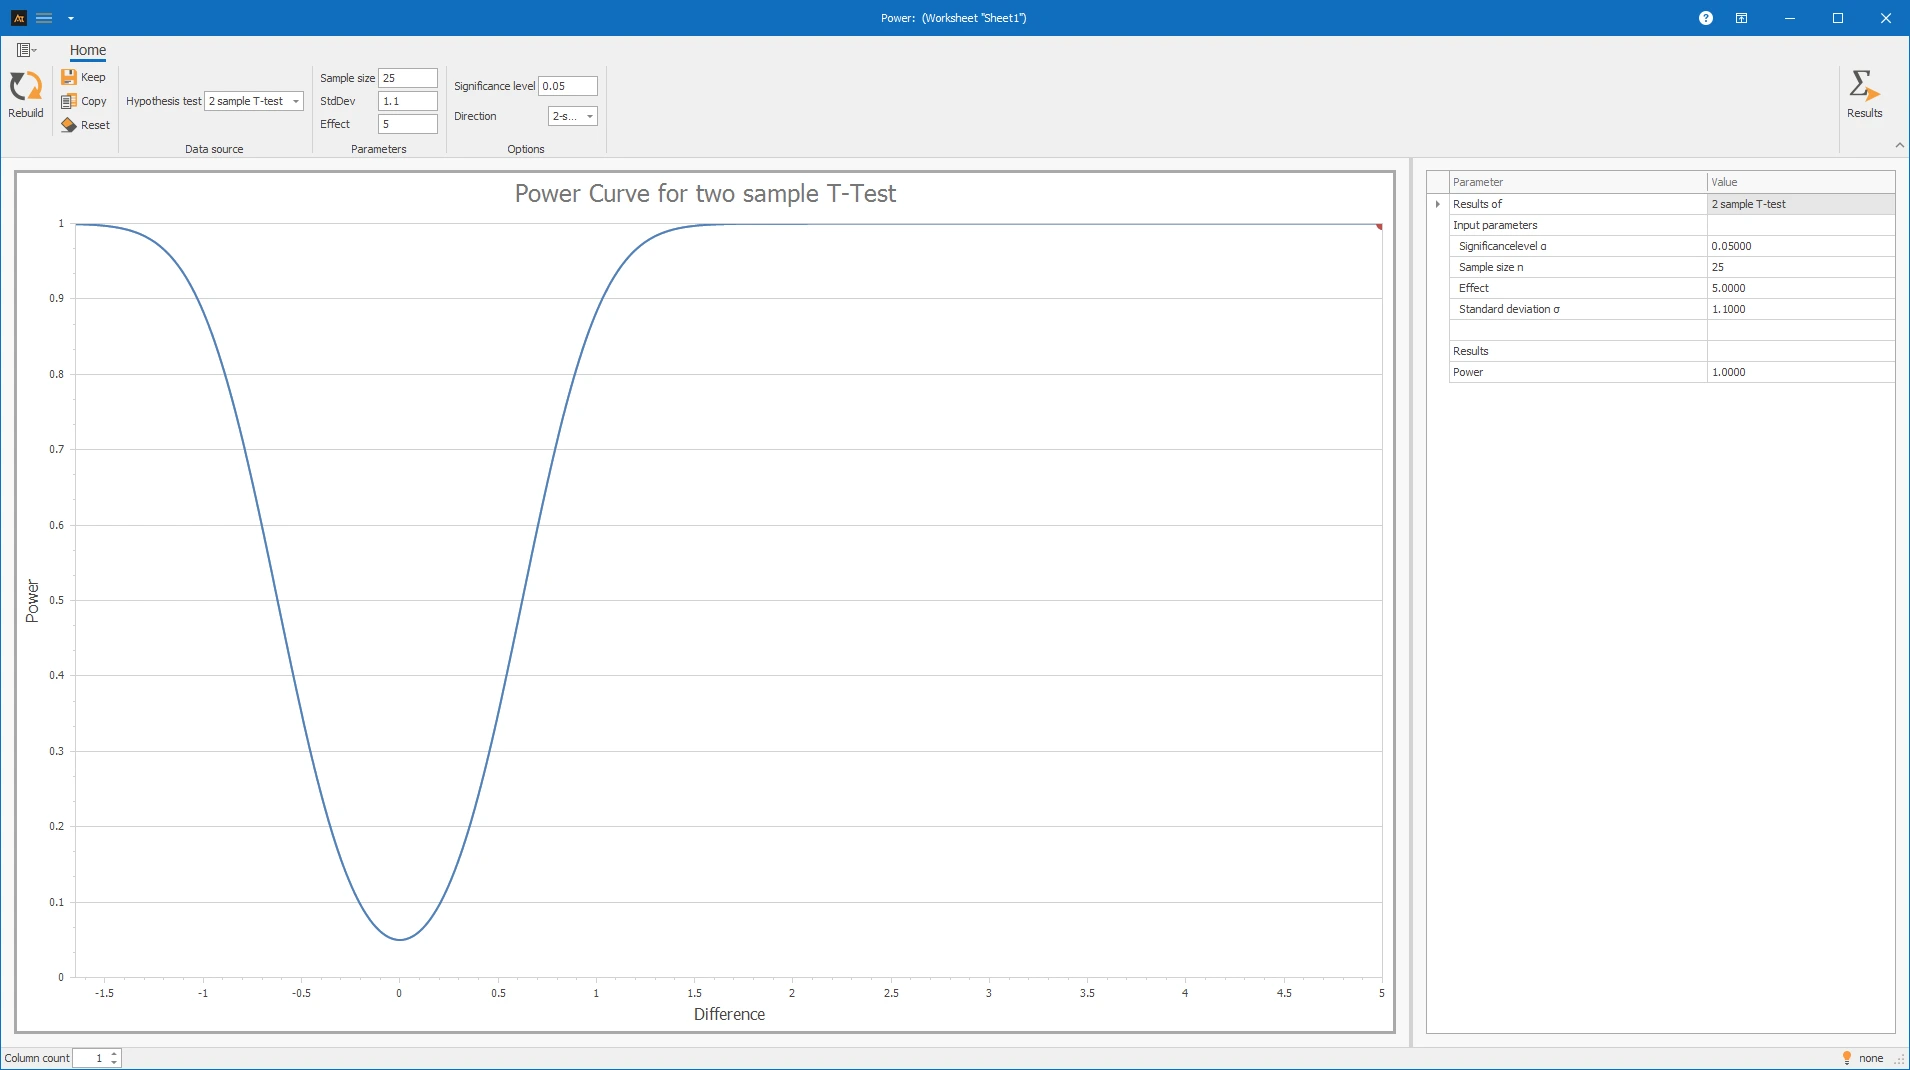
Diferenças nas médias: O poder é suficiente para detectar uma diferença de 5 ml na quantidade média de enchimento?
Interpretação
Para o teste t, o poder mostra a probabilidade com que uma diferença na quantidade média de enchimento é detectada. O poder é 1.000. Assim, o teste pode detectar a diferença assumida com probabilidade muito alta sob as entradas escolhidas. O erro β está correspondentemente próximo de 0%.
Teste F:
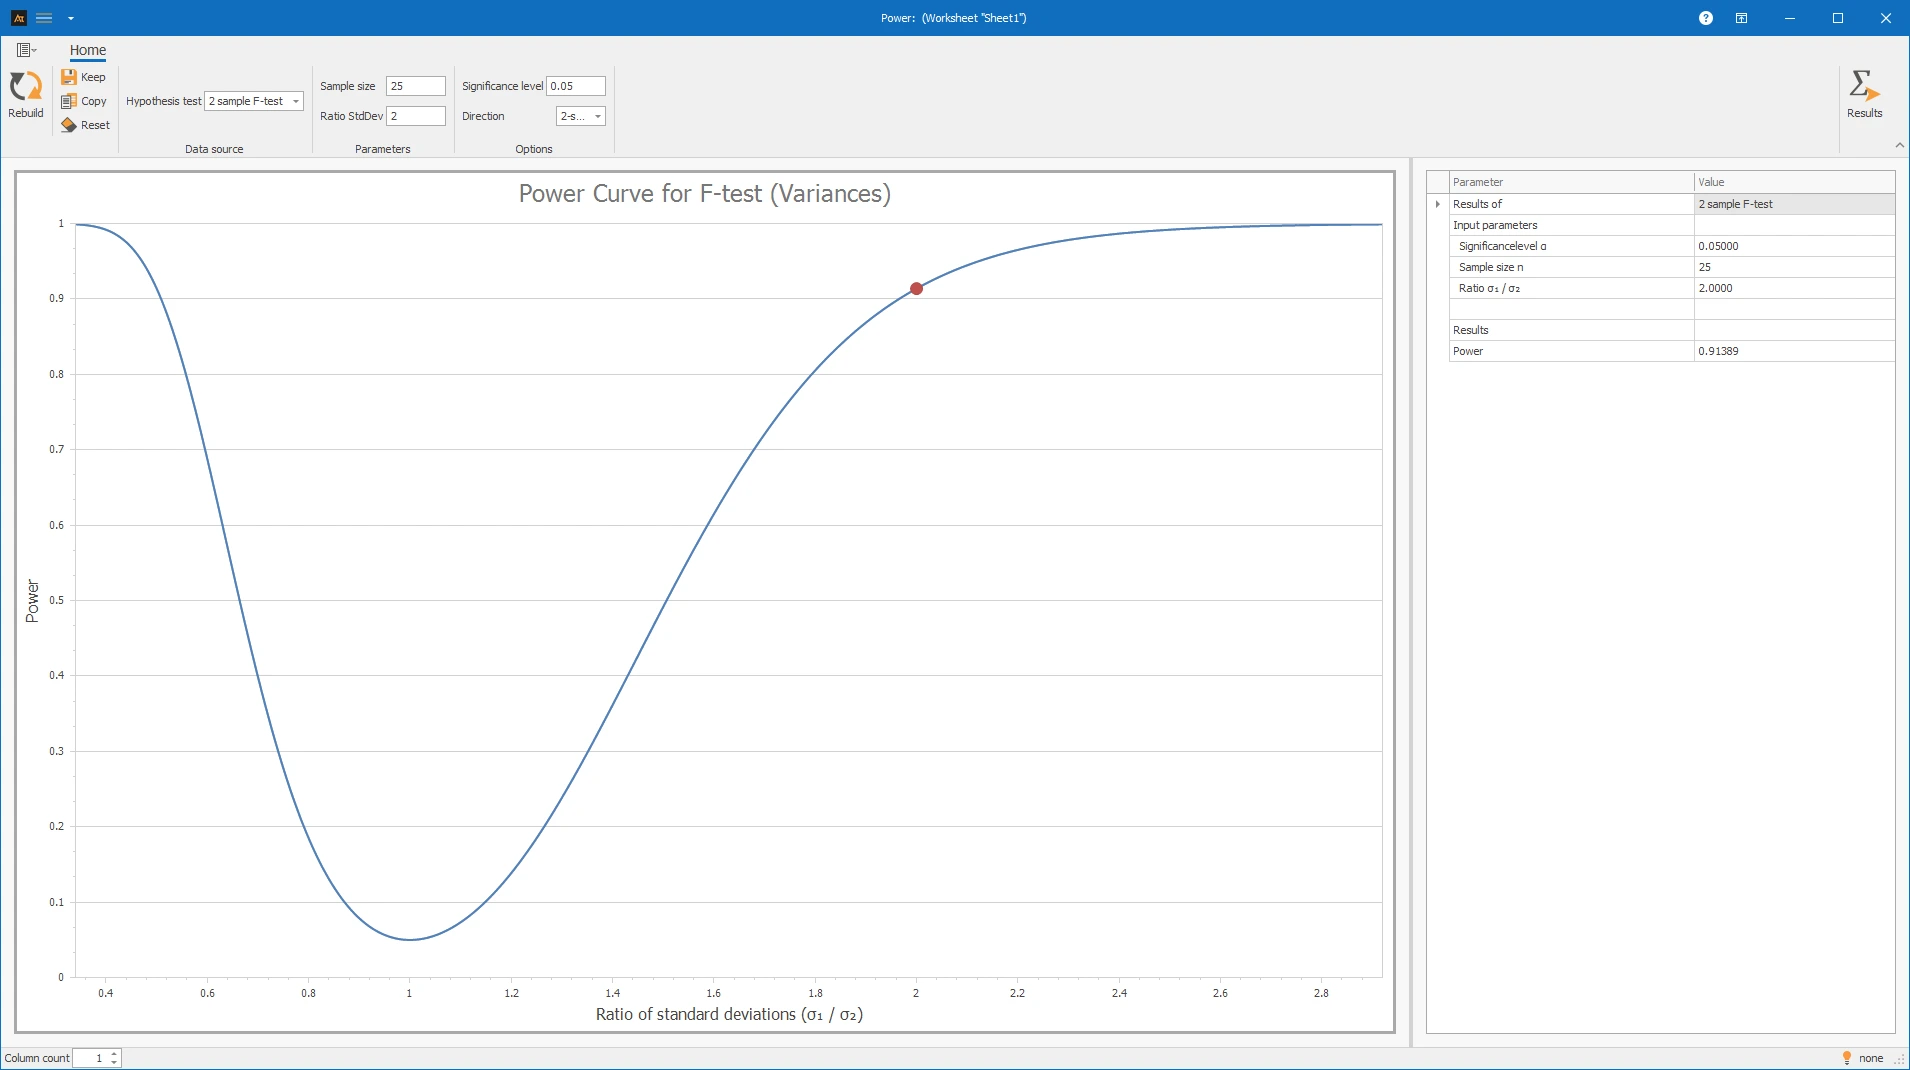
Diferenças nas variâncias: O poder é suficiente para detectar uma duplicação da variância da quantidade de enchimento?
Interpretação
Para o teste F, o poder mostra a probabilidade com que uma diferença na variância é detectada. O poder é 0.91389. Uma duplicação do desvio padrão pode, portanto, ser detectada com aproximadamente 91,4% de poder. O erro β é aproximadamente 8,6%.
Tempo de resposta do helpdesk de TI vs. localização ANOVA
No service desk de TI, os tickets são processados em vários locais. Os tempos de resposta são regularmente avaliados para identificar diferenças na qualidade do serviço.
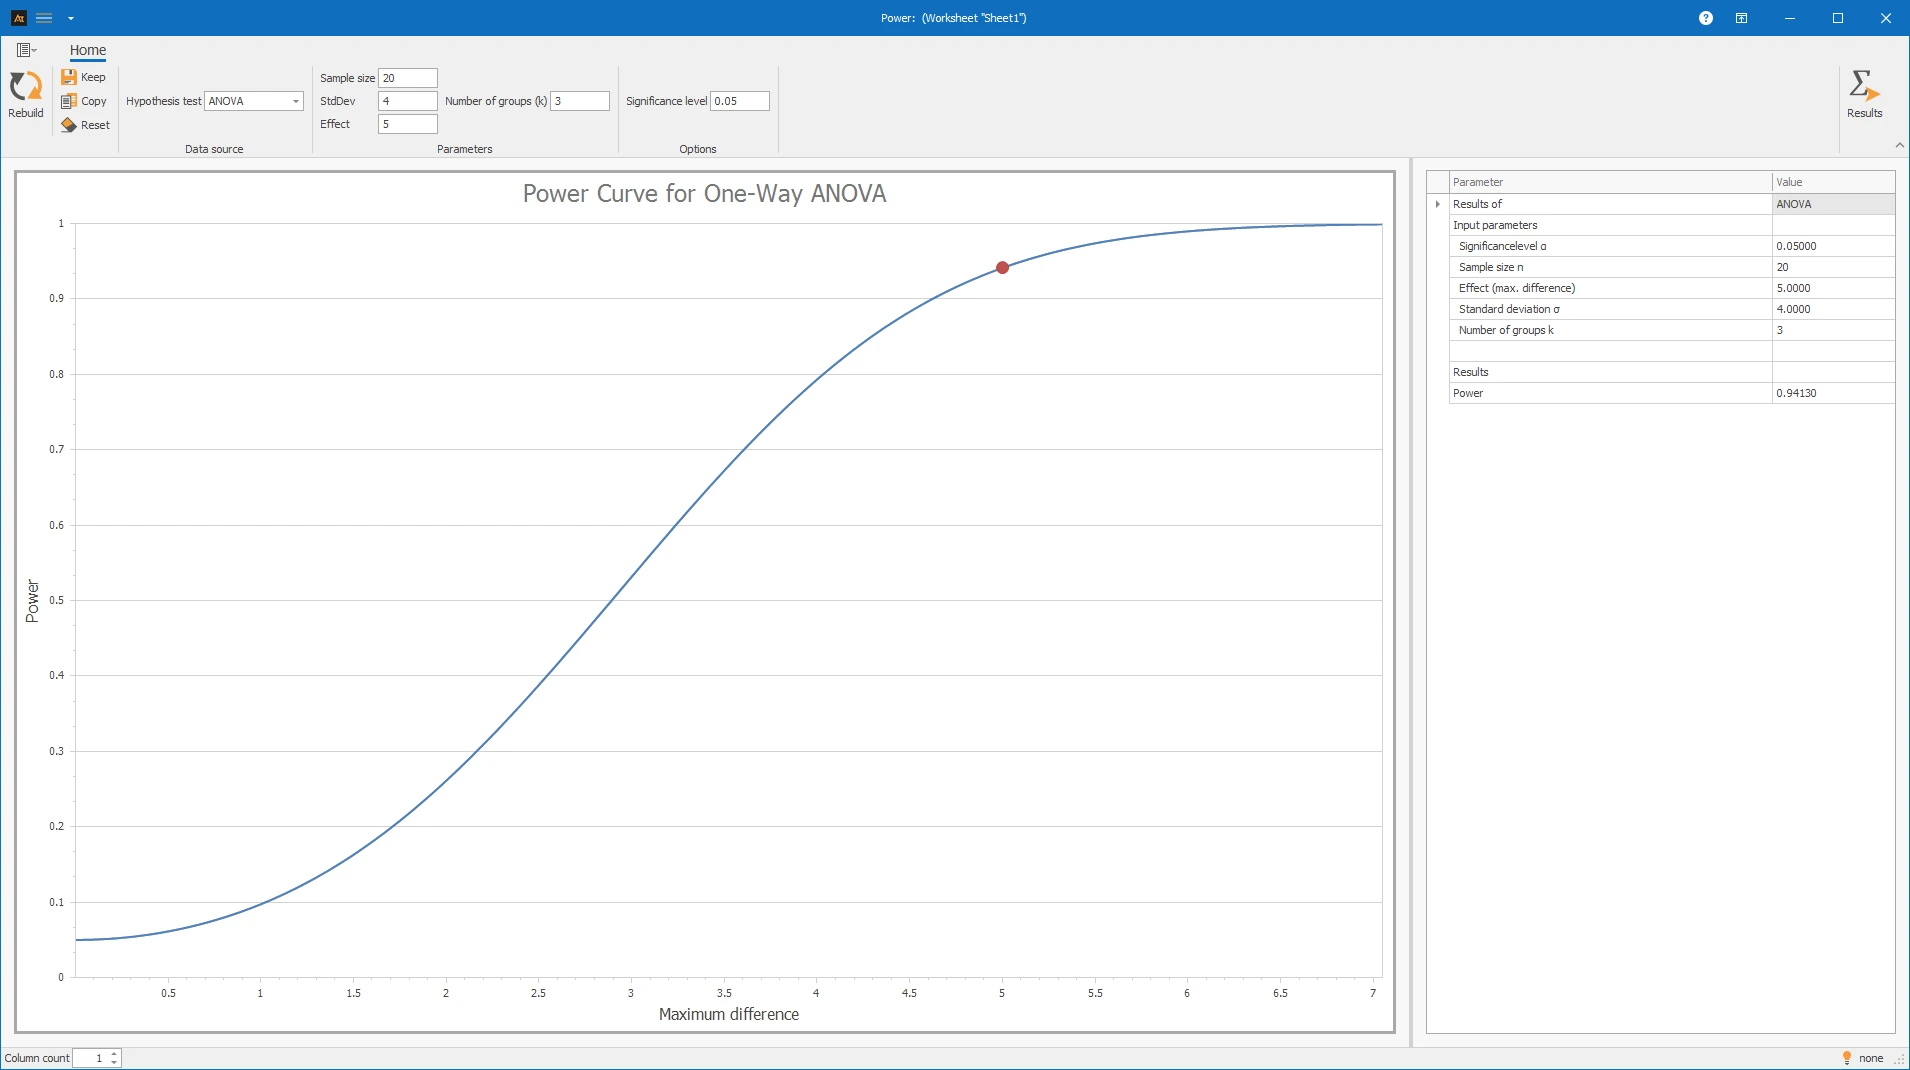
No exemplo de tickets de TI, estão disponíveis dados de três locais. A sensibilidade é usada para avaliar se uma diferença de 5 minutos no tempo de resposta seria detectada com a ANOVA.
Interpretação dos resultados
A configuração do teste é adequada para detectar uma diferença de 5 minutos com três níveis e um desvio padrão de 4. A sensibilidade é suficientemente alta; o erro β é correspondentemente baixo.
Teste de Proporções - Taxa de Perda por Abordagem de Vendas
Nas vendas, duas abordagens de vendas são comparadas. Deve-se avaliar se os números de ofertas existentes são suficientes para detectar de forma confiável uma mudança relevante na taxa de perda. O teste de proporções mostrou que os métodos de vendas não diferem significativamente.
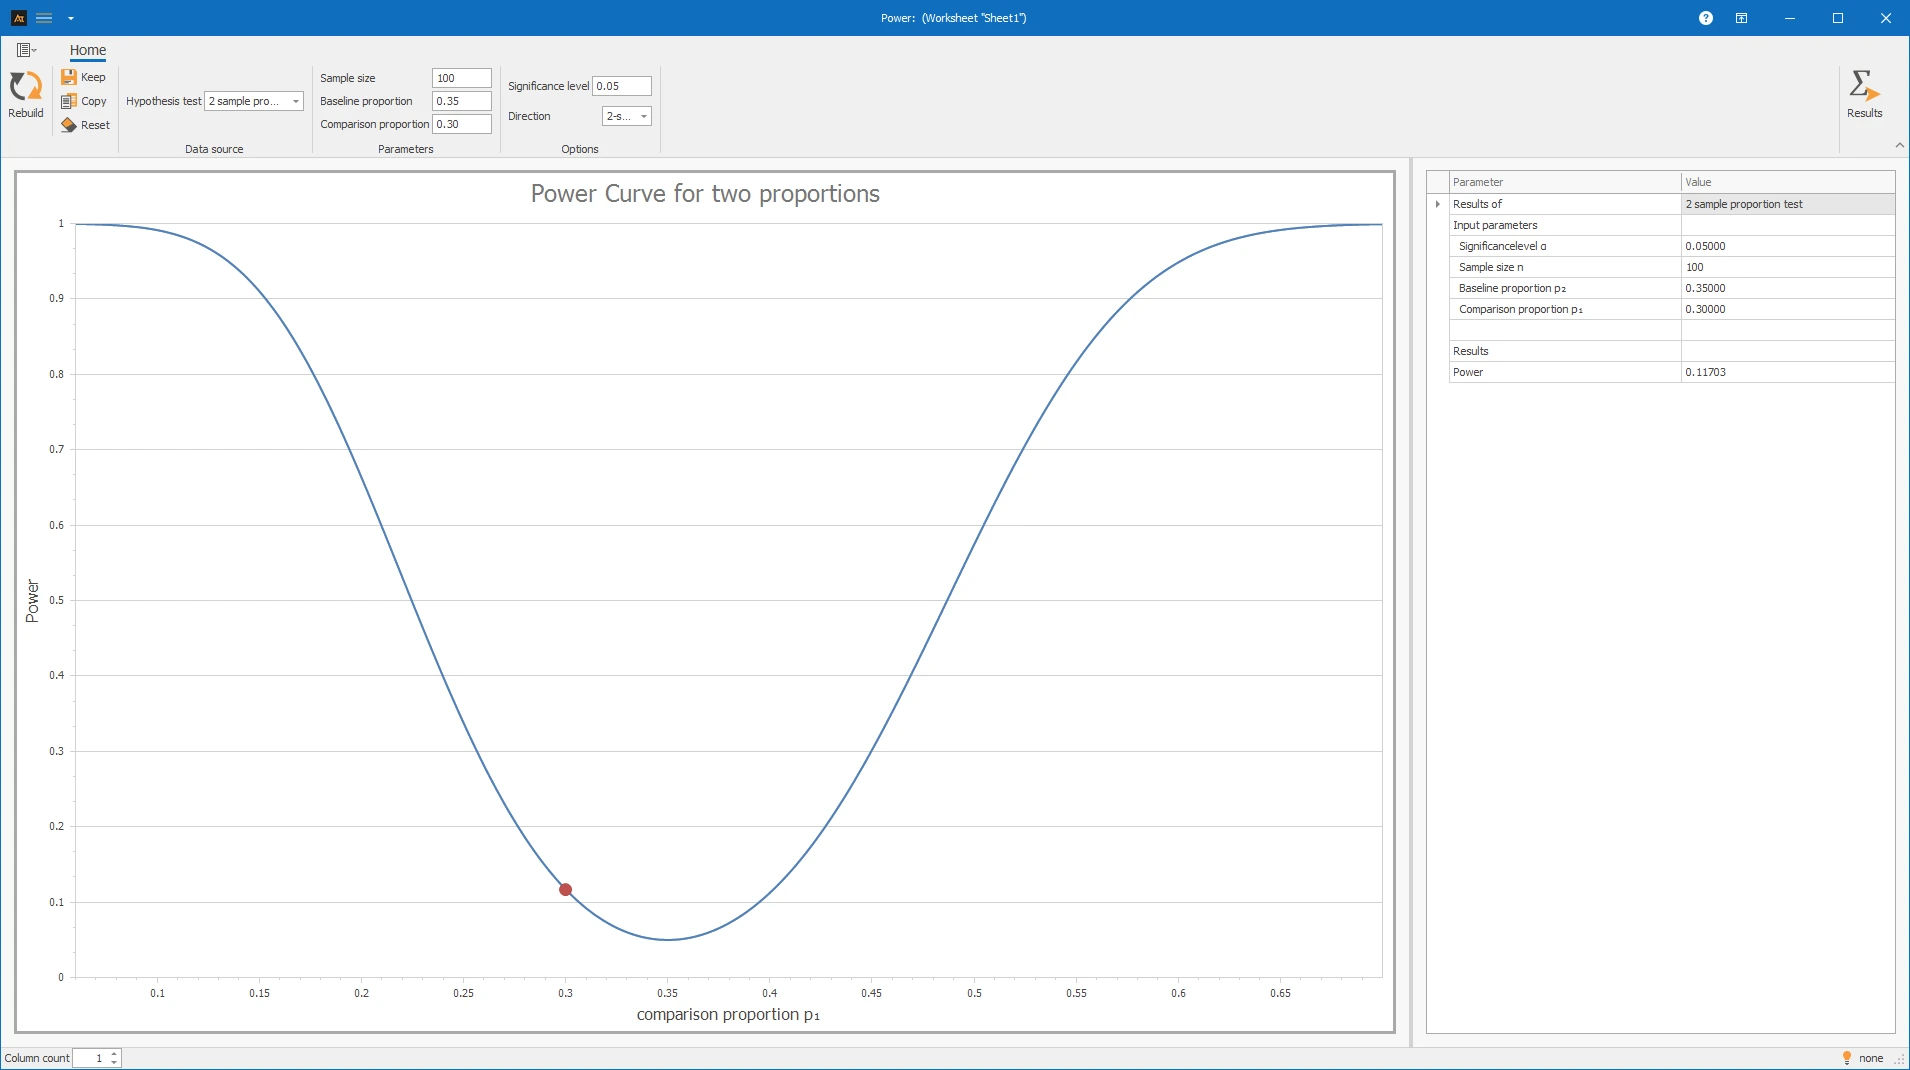
Agora, usando o cálculo de poder, deve-se determinar se uma mudança de 35% para 30% seria detectada.
Interpretação
O poder indica a probabilidade com que o teste detecta uma mudança relevante na taxa de perda. O poder é baixo em 0.11703. Isso corresponde a um erro β de aproximadamente 88,3%. O fato de que nenhuma diferença significativa pôde ser detectada com o teste de proporções pode ser devido ao fato de que poucas ofertas foram avaliadas.
Tempo de entrega após o centro logístico
No departamento de logística, os pedidos dos clientes são separados e enviados. Para aumentar a eficiência, novos empilhadores foram introduzidos.
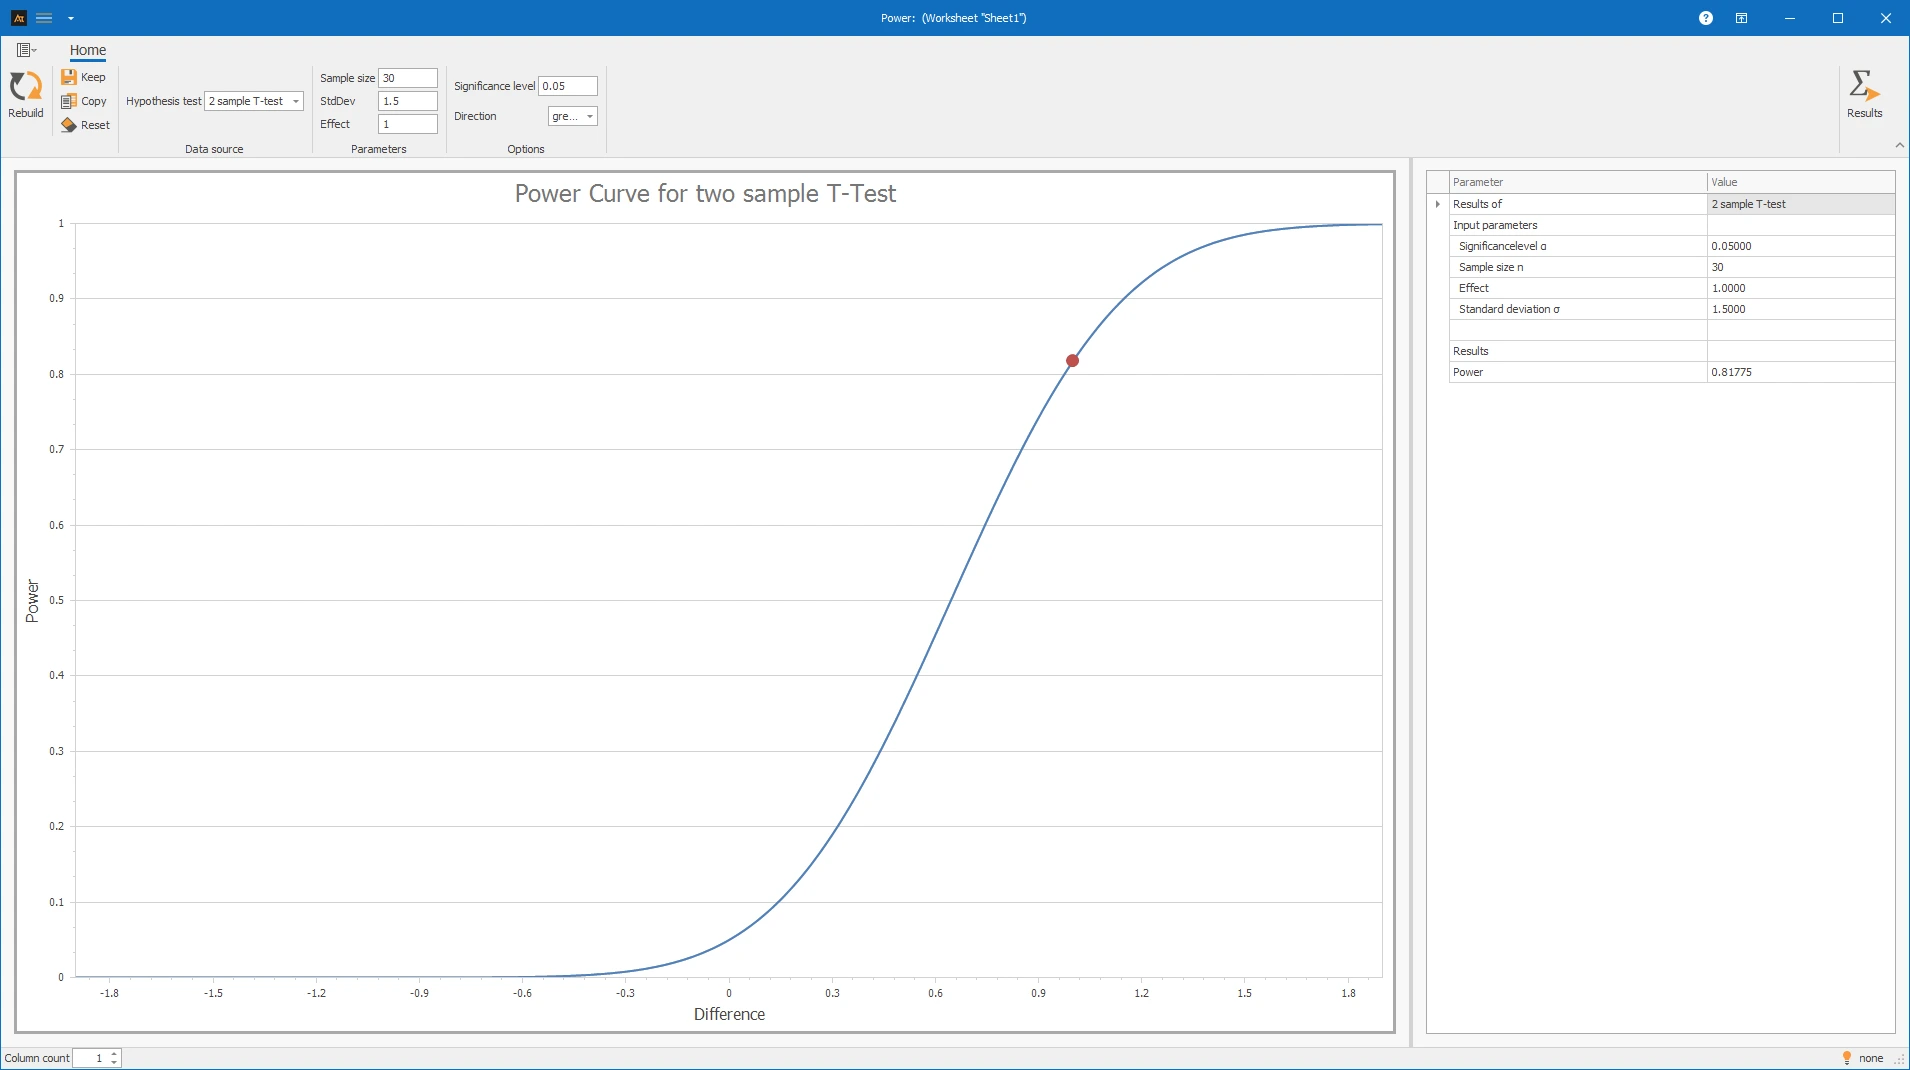
Deve-se investigar se uma melhoria no tempo de entrega em 1 dia pode ser detectada com um teste t unilateral. A variação no tempo de entrega é estimada em 2,5 dias. Serão feitas 30 medições.
Interpretação
O poder é de 81,775%. Assim, uma diferença de 1 dia pode ser detectada com aproximadamente 81,8% de poder. O erro β é de aproximadamente 18,2%. Um poder de pelo menos 80% é frequentemente usado como diretriz. No entanto, deve-se determinar com antecedência qual poder mínimo deve ser alcançado.
Comparação de Fornecedores
Nas compras, os componentes são adquiridos de vários fornecedores. Deve-se avaliar se os testes existentes são suficientes para detectar uma diferença de 1,5 vezes no desvio padrão entre os fornecedores. Existem 50 conjuntos de dados por fornecedor.
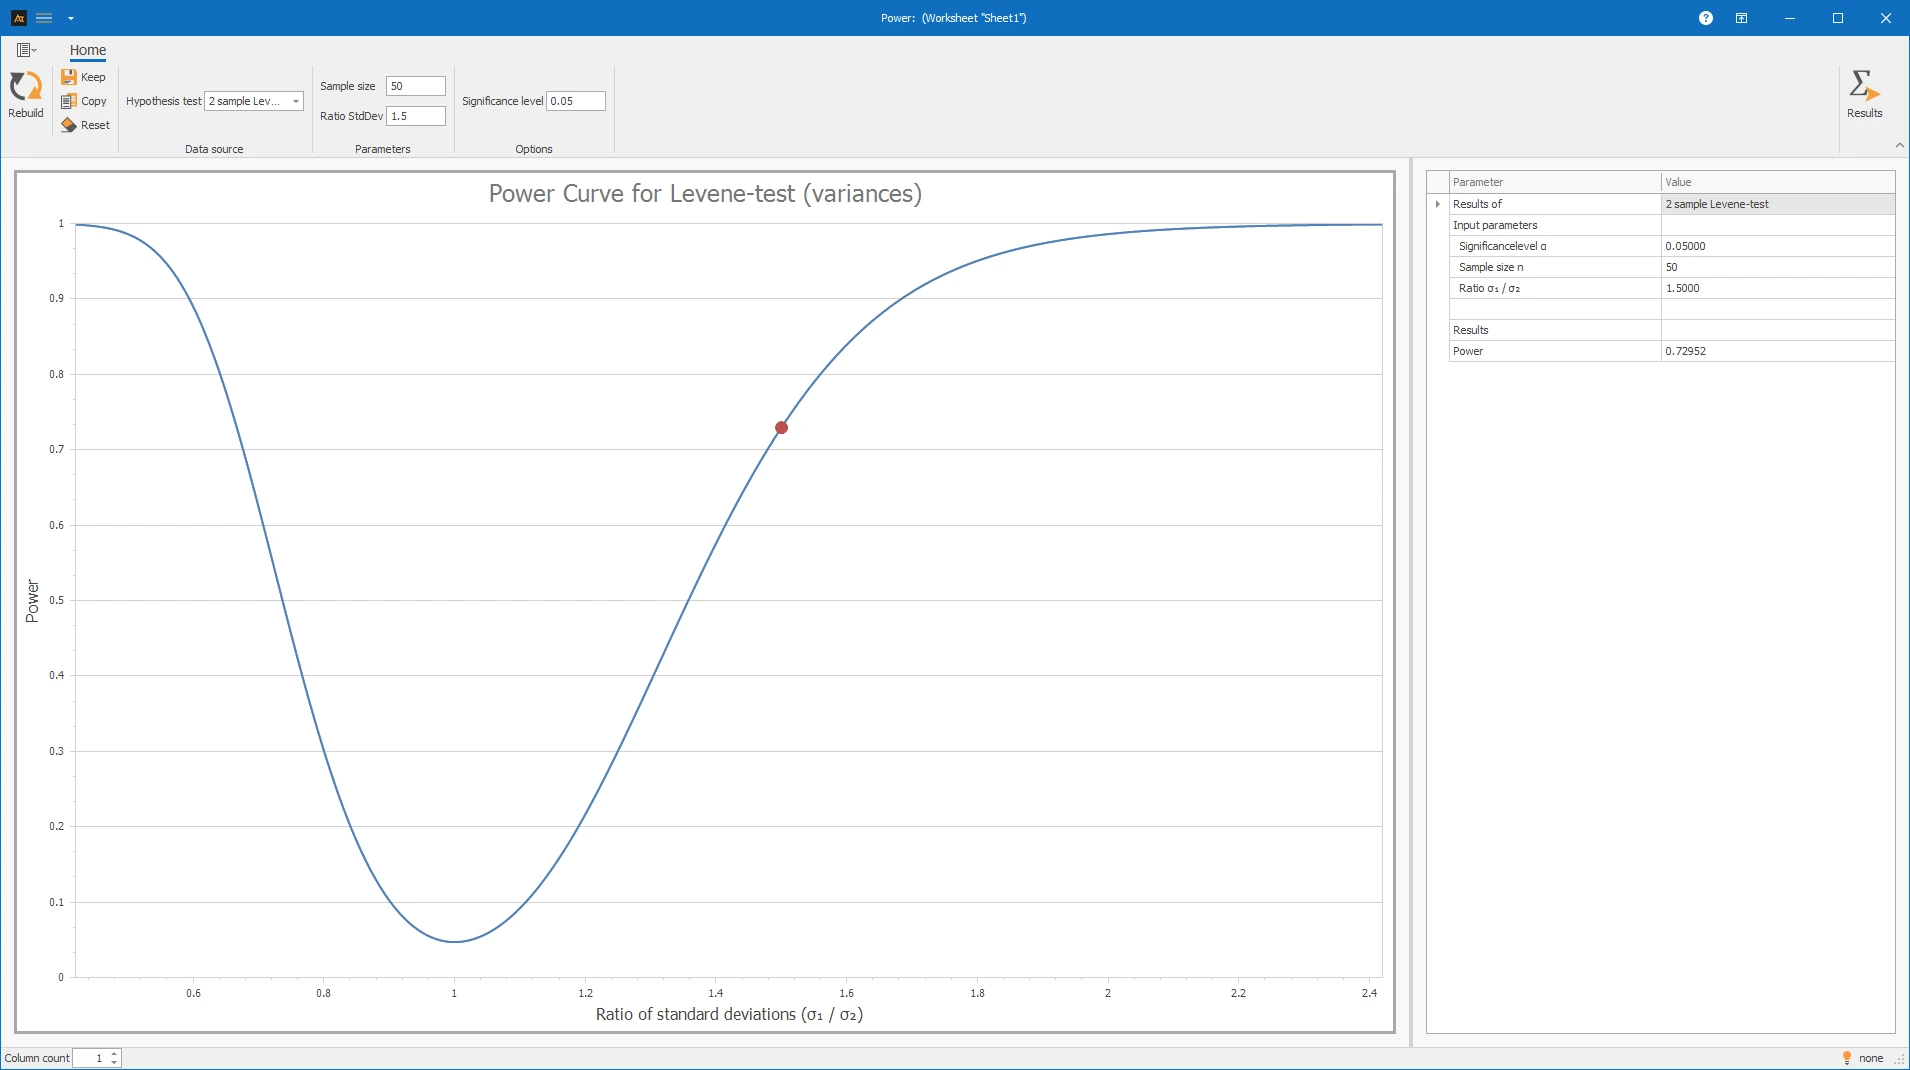
Interpretação
A sensibilidade ajuda a avaliar se o número existente de entregas é suficiente para detectar de forma confiável diferenças relevantes entre fornecedores. Com baixa sensibilidade, o erro β seria alto; uma diferença realmente existente poderia então permanecer não detectada.
Desvio de previsão
No planejamento de produção, previsões de demanda são criadas para diferentes períodos de planejamento. Para avaliar a qualidade da previsão, o desvio de previsão é calculado.
Deve-se avaliar se a amostra existente é suficiente para detectar diferenças entre horizontes de planejamento de curto e longo prazo com um teste t. Deve-se detectar uma diferença de 2%. O desvio padrão é conhecido a partir de análises anteriores e é de 0,9%. Para cada horizonte, 10 previsões devem ser criadas e comparadas.
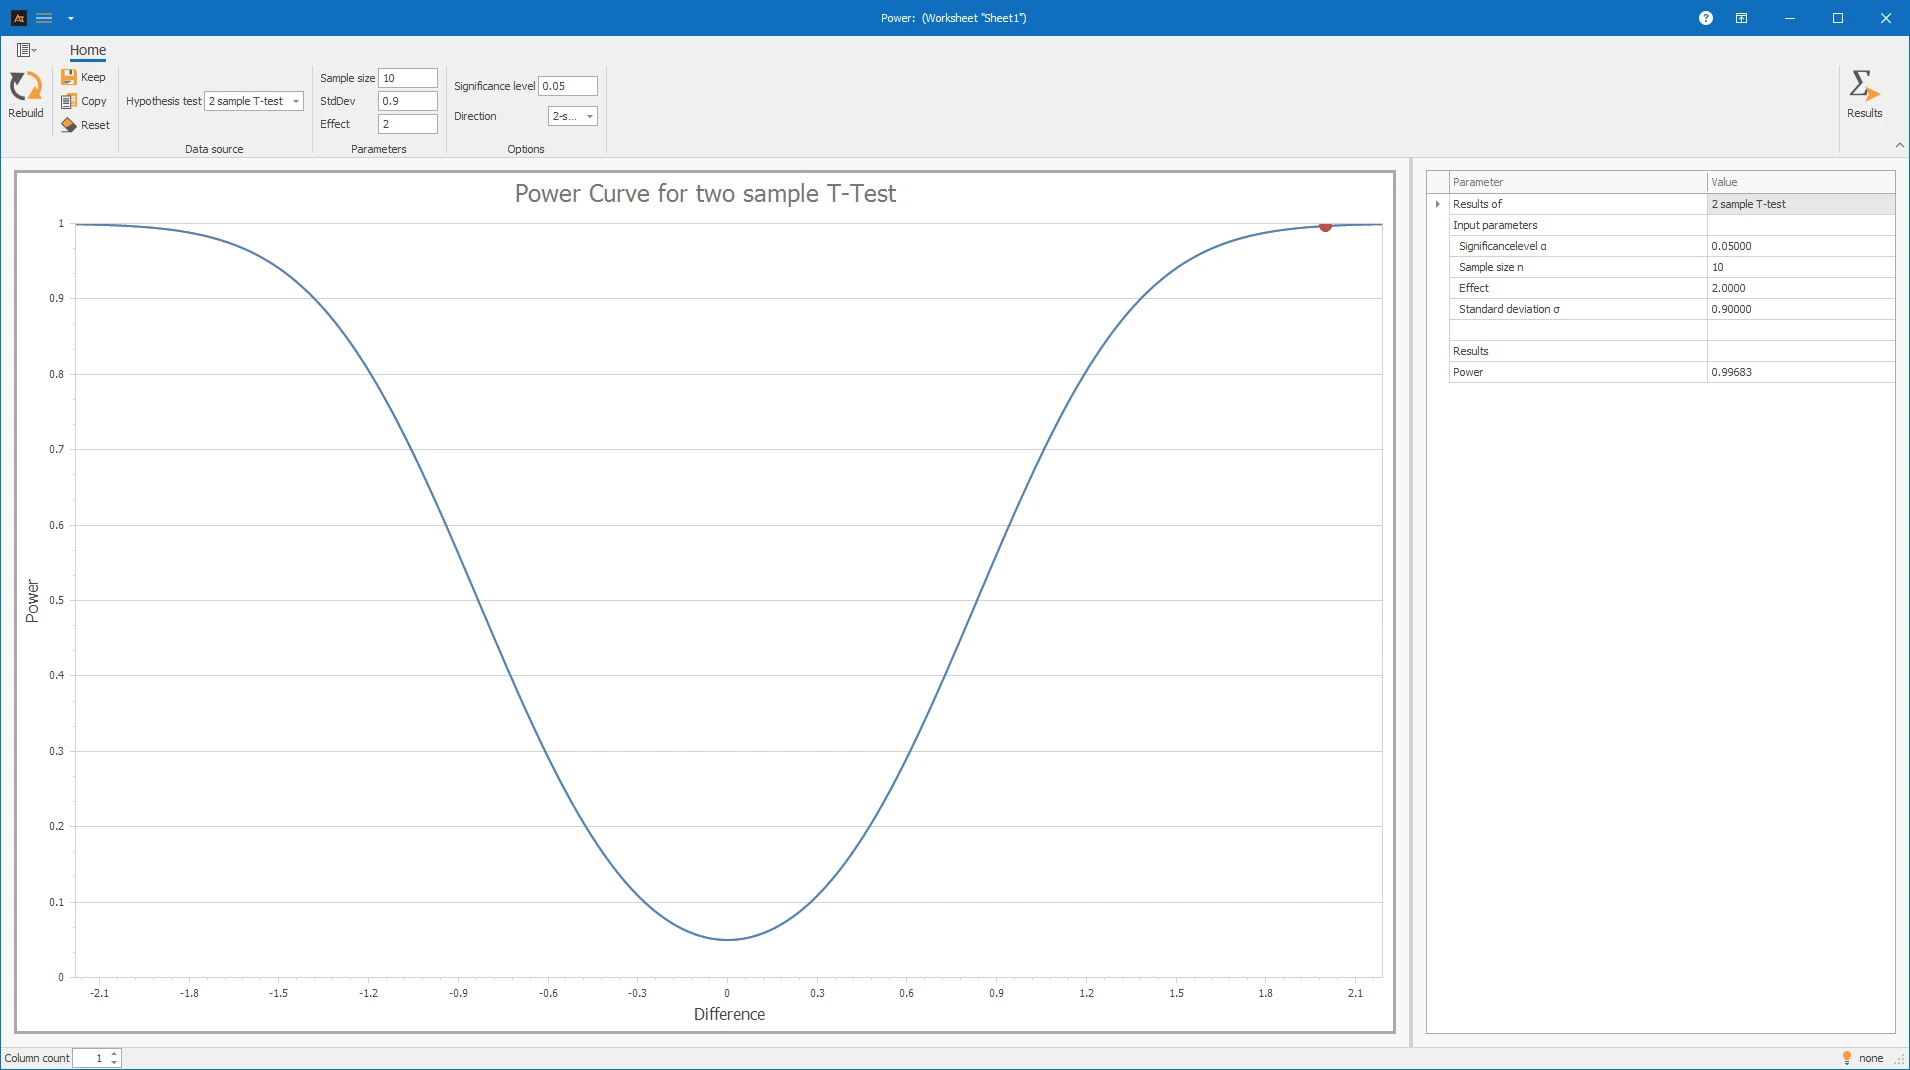
Interpretação
Com o teste t, uma diferença de 2% pode ser detectada de forma confiável se o desvio padrão for de 0,9%. O poder é de 99,68%. O erro β é, portanto, aproximadamente 0,32%.
Poder Discriminatório / Poder: Probabilidade com a qual um teste detecta um efeito realmente existente.
Efeito: Diferença praticamente relevante, por exemplo, diferença média, razão de variância ou mudança nas probabilidades.
n = Tamanho da amostra: Número de observações, partes, ofertas ou ensaios dentro de um grupo.
α = Nível de significância: Probabilidade de erro pré-definida com a qual a hipótese nula é incorretamente rejeitada.
β = Erro Tipo II: Probabilidade de não detectar um efeito realmente existente.
Poder = 1 - β: Contra-probabilidade ao erro Tipo II.
x̄ = Média da amostra: Valor médio dos dados de medição coletados.
s = Desvio padrão da amostra: Medida da dispersão dos dados em torno da média.
p̂ = Proporção da amostra: Proporção de eventos em uma amostra; calculada como eventos / número de ensaios.
Evento: O caso de interesse em uma análise de proporção, por exemplo, vazamento, perdido, no prazo ou aprovado.
Fator: Variável categórica de influência na ANOVA, por exemplo, centro logístico, fornecedor ou formulação.
Grupos / Níveis: Manifestações do fator, por exemplo, Centro A, Centro B e Centro C.
Bilateral: Verifica-se se uma diferença pode ser detectada em ambas as direções.
Maior: Verifica-se se um efeito pode ser detectado na direção de valores maiores.
Menor: Verifica-se se um efeito pode ser detectado na direção de valores menores.
As seguintes fórmulas descrevem a lógica de cálculo do poder de discriminação usado na ferramenta. As funções de distribuição e quantil necessárias não são implementadas manualmente, mas são avaliadas usando as bibliotecas estatísticas CenterSpace NMath e – conforme especificado – Numerics.NET.
Princípio Básico
O poder de discriminação, também chamado de poder, descreve a probabilidade de que um teste estatístico detecte um efeito realmente existente.
Um alto poder de discriminação significa que um efeito existente é detectado com alta probabilidade. Um baixo poder de discriminação significa que o erro β é correspondentemente maior.
Teste t para Duas Amostras
No teste t para duas amostras, a probabilidade de detectar uma diferença assumida entre duas médias é calculada. A ferramenta assume amostras de tamanho igual.
O parâmetro de não centralidade é:
Os graus de liberdade são:
Para o cálculo, são usados quantis da distribuição t central e a função de distribuição da distribuição t não central. Essas funções são avaliadas usando CenterSpace NMath. Ft,v,λ(x) denota a função de distribuição da distribuição t não central.
Poder = 1 − Ft,v,λ(t1−α,v)
Poder = Ft,v,λ(tα,v)
Poder = Ft,v,λ(tα/2,v) + 1 − Ft,v,λ(t1−α/2,v)
Teste F para Duas Variâncias
No teste F, o poder de discriminação para uma diferença assumida entre as variâncias de dois grupos é determinado. A ferramenta usa a razão dos desvios padrão como entrada:
Para o cálculo, a razão das variâncias é formada:
Para amostras de tamanho igual, aplicam-se os seguintes graus de liberdade:
OS quantis e funções de distribuição necessários da distribuição F são avaliados usando CenterSpace NMath. Fk1,k2(x) denota a função de distribuição da distribuição F.
Poder = 1 − Fk1,k2 (F1−α,k1,k2 / ρ²)
Poder = Fk1,k2 (Fα,k1,k2 / ρ²)
Poder = Fk1,k2 (Fα/2,k1,k2 / ρ²) + 1 − Fk1,k2 (F1−α/2,k1,k2 / ρ²)
Teste de Levene para Duas Variâncias
Para o cálculo do poder do teste de Levene, a ferramenta usa uma aproximação baseada na razão dos desvios padrão.
OS graus de liberdade da distribuição t usada são:
O valor crítico t é determinado usando a função quantil da distribuição t:
Além disso, o cálculo usa as seguintes quantidades auxiliares:
c = √(π/2 − 1)
SE = c·√(ρ²/n₁ + 1/n₂)
Disso, os dois valores z são determinados:
z₂ = −tkrit/θ − (ρ−1)/SE
O poder é então determinado usando a distribuição normal padrão. As funções de distribuição t e normal são avaliadas usando CenterSpace NMath.
Teste de Proporções para Duas Amostras
No teste de proporções, a probabilidade de detectar uma diferença real entre duas proporções é calculada.
A diferença nas proporções é:
A proporção comum para o cálculo sob a hipótese nula é:
O erro padrão sob a hipótese nula é:
O erro padrão sob a hipótese alternativa é:
OS quantis e a função de distribuição da distribuição normal padrão são avaliados usando CenterSpace NMath.
Poder = Φ((d − z1−α·SE₀) / SE₁)
Poder = 1 − Φ((d + z1−α·SE₀) / SE₁)
Poder = 1 − Φ((d + z1−α/2·SE₀) / SE₁) + Φ((d − z1−α/2·SE₀) / SE₁)
ANOVA de Uma Via
A ANOVA de uma via testa se as médias de vários grupos diferem.
H₁: Pelo menos uma média de grupo difere.
Na ferramenta, a diferença máxima entre as médias dos grupos é usada como o efeito:
Para o cálculo do parâmetro de não centralidade, assume-se que dois grupos formam a distância máxima Δ. O parâmetro de não centralidade usado na ferramenta é:
OS graus de liberdade são:
O quantil F crítico é determinado usando CenterSpace NMath:
Para a avaliação da distribuição F não central, a ferramenta Numerics.NET é usada.
Teste t de uma amostra
No teste t de uma amostra, a potência é calculada para um efeito dado, um tamanho de amostra e um desvio padrão assumido.
O parâmetro de não-centralidade é:
Os graus de liberdade são:
OS quantis necessários da distribuição t e a função de distribuição da distribuição t não-central são avaliados usando CenterSpace NMath.
Potência = 1 − Ft,v,λ (t1−α,v)
Potência = Ft,v,λ (tα,v)
Potência = Ft,v,λ (tα/2,v) + 1 − Ft,v,λ (t1−α/2,v)
Teste de variância de uma amostra
No teste de variância de uma amostra, a potência é determinada para uma razão assumida entre o desvio padrão real e o desvio padrão hipotético.
A razão ao quadrado é usada para o cálculo:
OS graus de liberdade da distribuição qui-quadrado são:
OS quantis necessários e as funções de distribuição da distribuição qui-quadrado são avaliados usando CenterSpace NMath.
Potência = 1 − Fχ²,v (χ²1−α,v / r²)
Potência = Fχ²,v (χ²α,v / r²)
Potência = Fχ²,v (χ²α/2,v / r²) + 1 − Fχ²,v (χ²1−α/2,v / r²)
Teste de proporção de uma amostra
No teste de proporção, a potência é calculada para uma proporção de comparação real p contra uma proporção hipotética p₀.
O erro padrão sob a hipótese nula é:
O erro padrão sob a hipótese alternativa é:
OS quantis necessários e as funções de distribuição da distribuição normal padrão são avaliados usando CenterSpace NMath.
Potência = Φ((d − z1−α·SE₀) / SE₁)
Potência = Φ((−d − z1−α·SE₀) / SE₁)
Potência = Φ((d − z1−α/2·SE₀) / SE₁) + Φ((−d − z1−α/2·SE₀) / SE₁)