


La herramienta de prueba de distribución se utiliza para comparar una serie de datos seleccionada con varias distribuciones teóricas. Ayuda a identificar qué distribución describe mejor las mediciones y si los datos son adecuados para análisis estadísticos adicionales con una suposición de distribución específica.
El resultado no es una "prueba" definitiva para una distribución. Un valor p alto simplemente significa que la prueba de Anderson-Darling no encuentra una desviación estadísticamente significativa de la distribución elegida. Siempre se deben considerar la plausibilidad técnica, la referencia del proceso y la red de probabilidad.

Durante la producción de salsa de tomate, se registran regularmente los valores de viscosidad. La viscosidad describe qué tan espesa es la salsa. Es importante para que el producto pueda ser llenado de manera uniforme y siempre tenga la misma consistencia para el cliente.
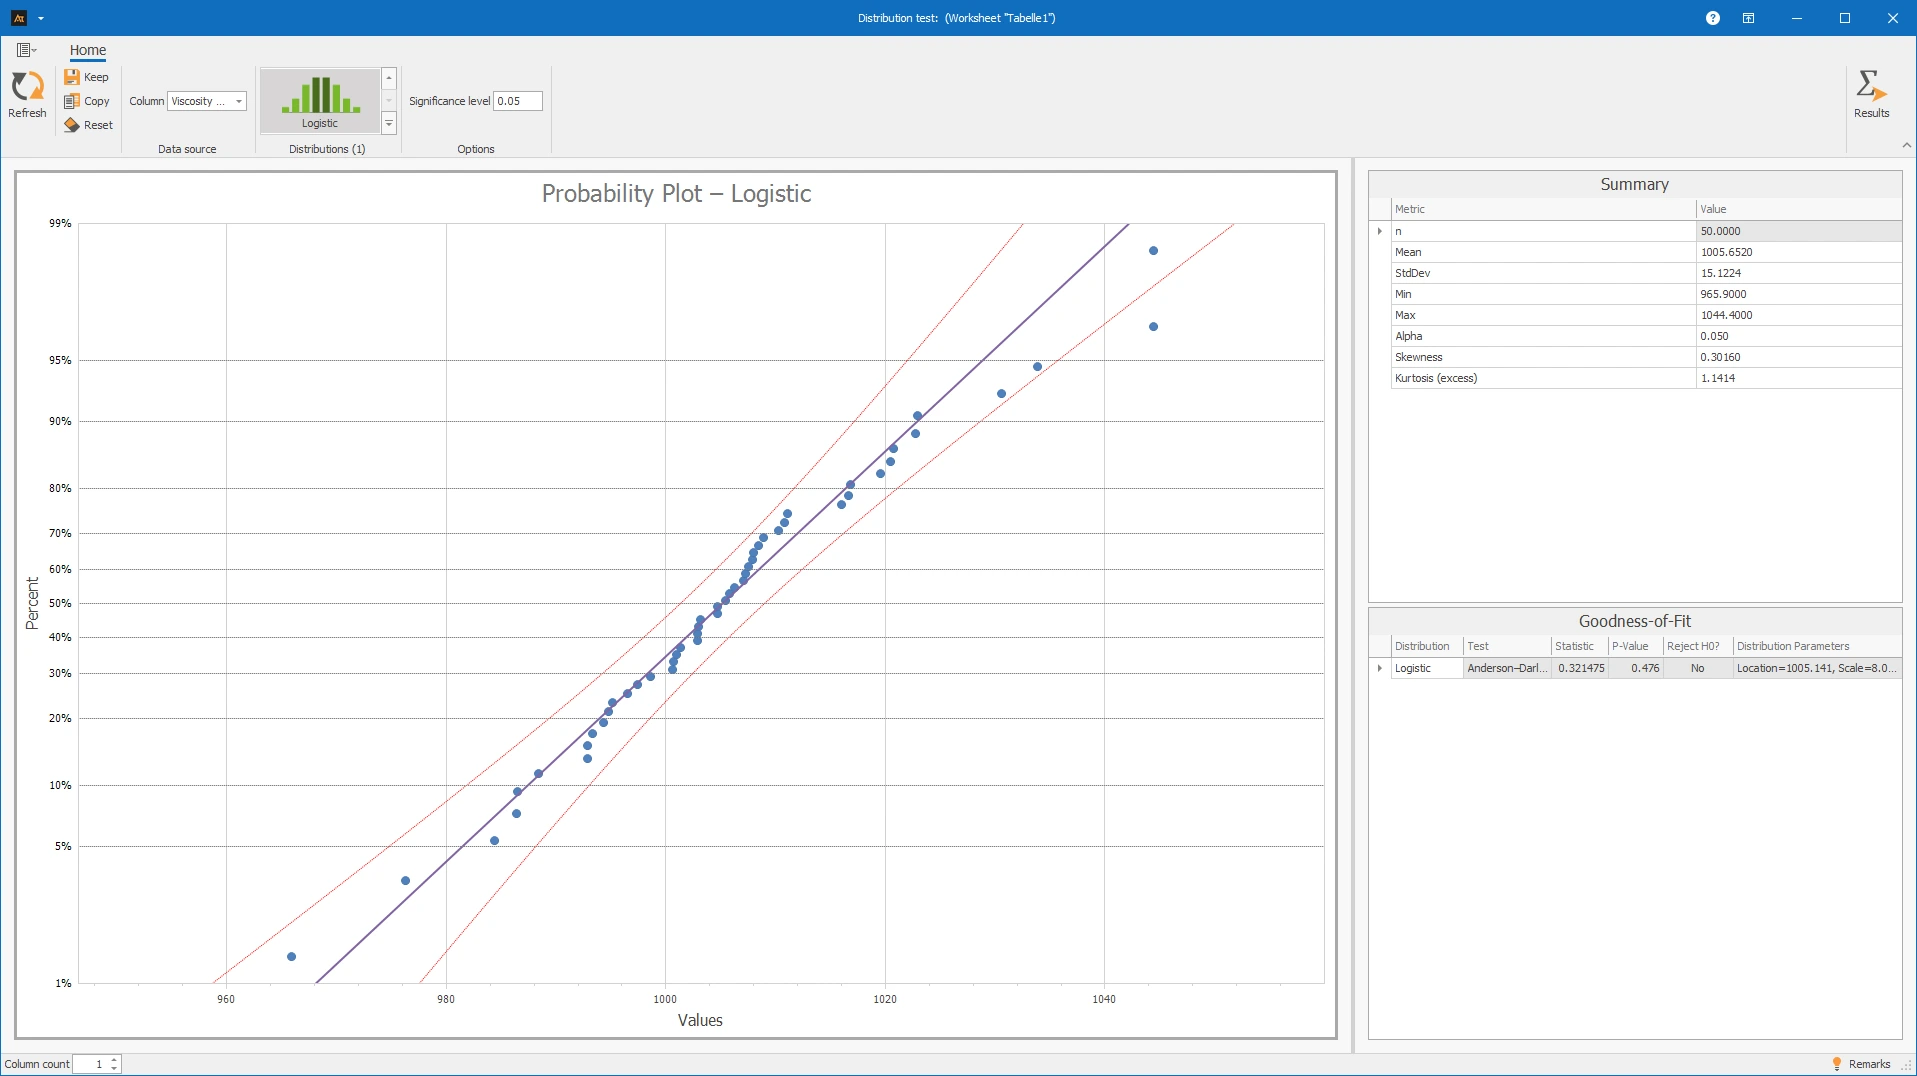
Antes de realizar más análisis, se debe verificar cuál de las distribuciones seleccionadas puede describir de manera significativa los valores de viscosidad medidos. Para este propósito, los datos se comparan con las pruebas de distribución para las distribuciones Normal, Lognormal, Loglogística y Logística.
Explicaciones de los resultados:
Gráficos de probabilidad
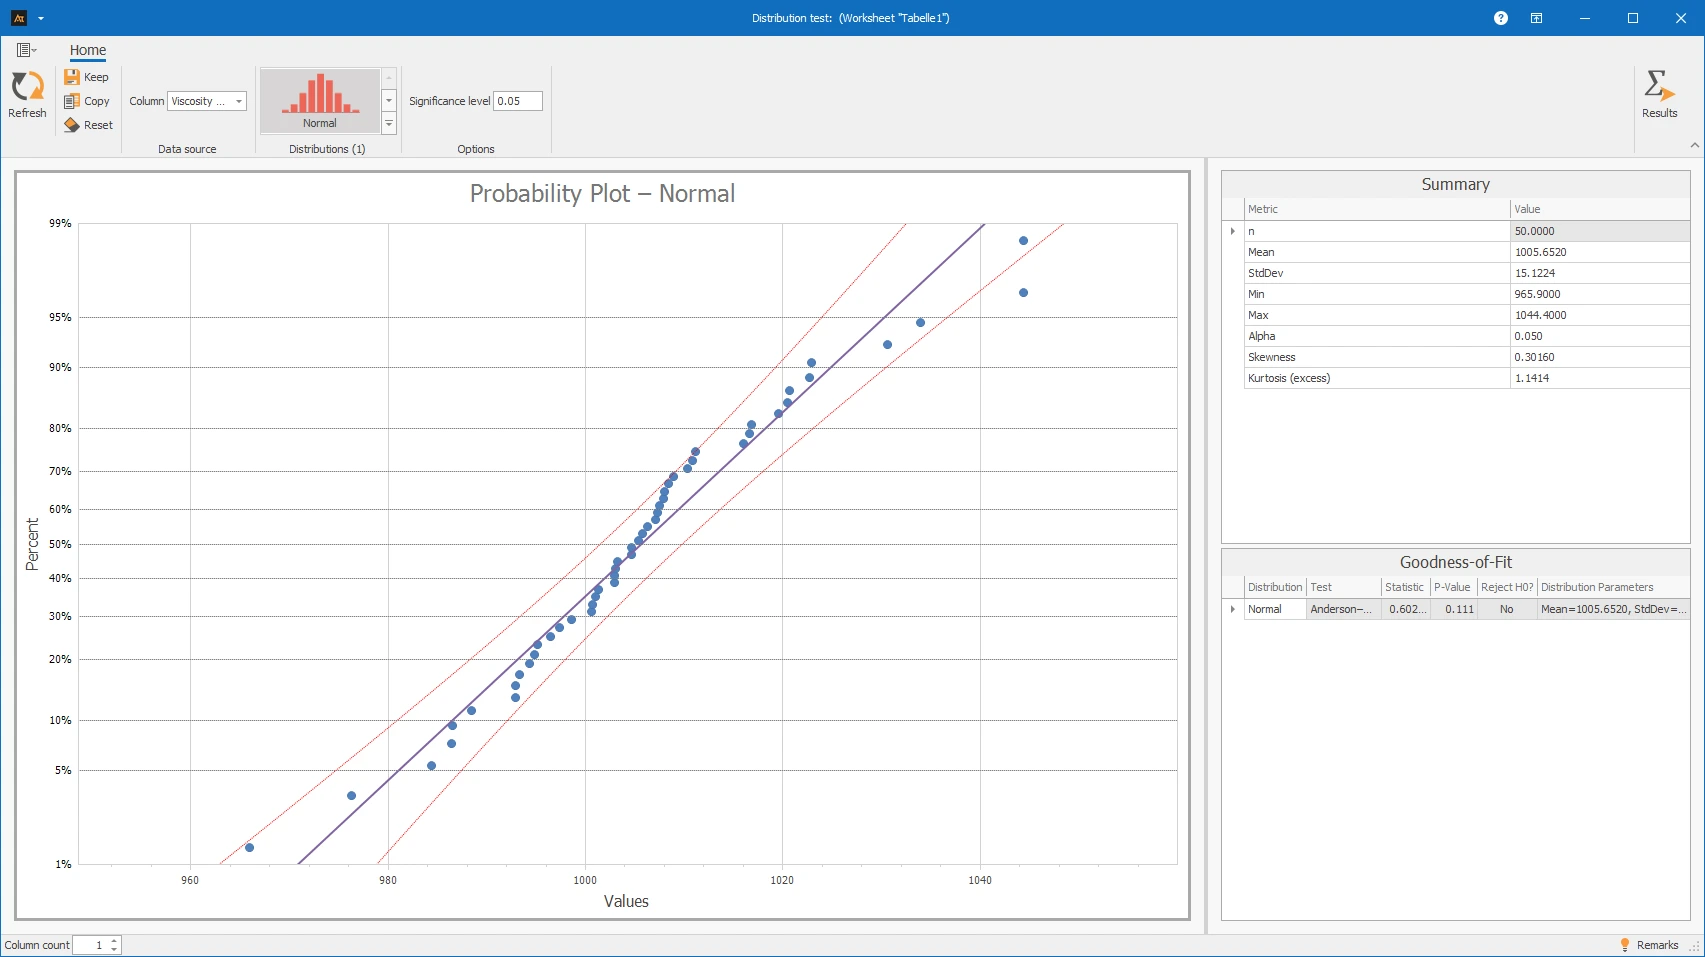
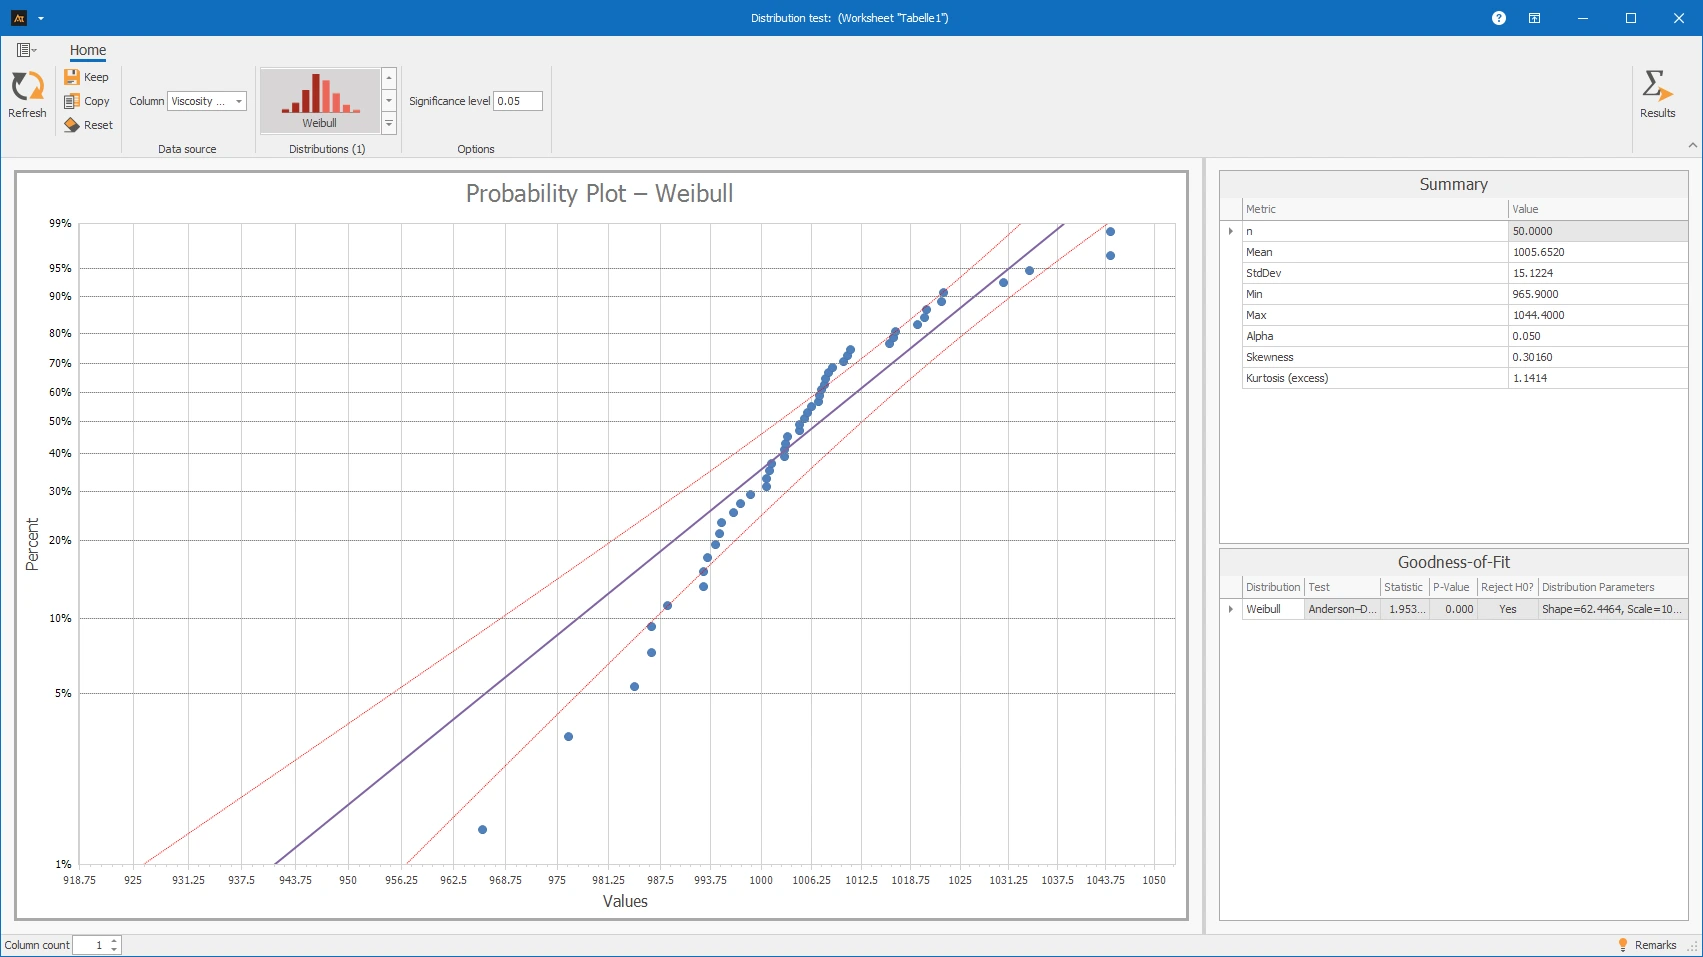
Para cada distribución calculada con éxito, la prueba de distribución genera su propio gráfico de probabilidad. En él, los valores medidos ordenados se comparan con los valores que se esperarían bajo la respectiva distribución teórica.
- Si los puntos están cerca de la línea dibujada, la distribución elegida se ajusta bien a los datos. Cuanto más se desvíen los puntos de la línea, peor describe esta distribución los datos.
- Patrones curvados, formas de S, valores atípicos significativos o desviaciones en las áreas de borde indican que los datos no se ajustan bien a la distribución probada.
- Al comparar múltiples distribuciones, no solo se debe considerar el valor p. También es importante si el gráfico de probabilidad muestra un patrón plausible y tranquilo y si la distribución se ajusta técnicamente a la característica.
La línea puede entenderse como una plantilla: Cuanto mejor se ajusten los puntos a la plantilla de la distribución, más adecuada es esta distribución como modelo para los datos.
Prueba de Anderson-Darling
La prueba de distribución utiliza la prueba de Anderson-Darling como una prueba de bondad de ajuste computacional. La prueba verifica si los valores medidos se ajustan a la distribución seleccionada. Se realiza para todas las distribuciones compatibles que se pueden calcular con los datos disponibles.
La prueba proporciona una estadística de prueba y un valor p para cada distribución:
- valor p mayor que alfa: No hay evidencia estadística de que los datos se desvíen de esta distribución. → La distribución puede considerarse un modelo posible.
- valor p menor o igual a alfa: La prueba encuentra desviaciones significativas. → Se rechaza la hipótesis nula; la distribución probada no se ajusta estadísticamente a los datos de manera suficiente.
¿Por qué se utiliza la prueba de Anderson-Darling? Es particularmente sensible a las desviaciones en las áreas de borde de la distribución. Aquí es donde a menudo ocurren valores atípicos o extremos, que son importantes para los análisis de calidad, proceso y vida útil.
Interpretación de los resultados:
Los valores de viscosidad se compararon con las distribuciones Normal, Lognormal, Loglogística y Logística. Para las cuatro distribuciones, el valor p es mayor que 0.05. Por lo tanto, no se rechaza la hipótesis nula para ninguna distribución. No hay evidencia estadística de que los datos se desvíen significativamente de alguna de las distribuciones probadas.
Los gráficos de probabilidad también muestran que los puntos se encuentran mayormente cerca de las líneas. Por lo tanto, los valores de viscosidad pueden describirse aproximadamente con las distribuciones probadas.
Sin embargo, el resultado no permite una conclusión definitiva de que una de estas distribuciones sea claramente la mejor. La selección de la distribución también debe basarse en la plausibilidad técnica y el análisis posterior planificado. Dado que la viscosidad es una medida continua y los datos están distribuidos aproximadamente de manera simétrica alrededor de la media, la distribución normal puede ser una elección sensata y bien justificada para muchas evaluaciones estándar posteriores.
Las siguientes son las consideraciones y pasos necesarios para probar una serie de datos contra múltiples distribuciones con Best Fit.
Preparación
- Seleccionar una medida numérica apropiada.
- Recoger mediciones.
- Seleccionar distribuciones, por ejemplo, Weibull, Gamma, Lognormal.
 Usar en AlphadiTab
- Seleccionar la herramienta Prueba de Distribución en la Fase de Medición.
- Seleccionar la serie de datos a probar y activar una o más distribuciones en la galería de distribuciones.
- Verificar o ajustar el nivel de significancia.
- Realizar el análisis con Actualizar.
Interpretación
Luego verificar para cada distribución seleccionada si es adecuada para describir las mediciones.
- p-valor: Si el p-valor es mayor que 0.05, no hay evidencia estadística de una desviación de la distribución. Por lo tanto, se puede considerar que los datos se ajustan aproximadamente a la distribución.
- Gráfico de probabilidad: Si los puntos están mayormente cerca de la línea dibujada, la distribución elegida es un modelo plausible para los datos.
Las siguientes distribuciones están disponibles en la herramienta:
Distribución normal
La distribución normal es una distribución simétrica en forma de campana. A menudo ocurre en mediciones que surgen de muchas pequeñas influencias aleatorias. Ejemplos incluyen dimensiones, pesos, cantidades de llenado o valores de proceso.
Típicamente, la mayoría de los valores están cerca de la media, y las grandes desviaciones hacia arriba o hacia abajo se vuelven más raras. Si los datos se ajustan bien a la distribución normal, se pueden utilizar muchos métodos estadísticos clásicos.
Distribución de Weibull
La distribución de Weibull se utiliza a menudo para datos de vida útil, fallos y fiabilidad. Es particularmente adecuada cuando solo ocurren valores positivos, como tiempos de operación hasta el fallo.
Dependiendo del parámetro de forma, la distribución de Weibull puede representar diferentes cursos. Esto la hace muy flexible y a menudo se utiliza para describir vidas técnicas, comportamiento de desgaste o probabilidades de fallo.
Distribución exponencial
La distribución exponencial describe tiempos de espera o tiempos hasta el próximo evento. Se utiliza a menudo cuando los eventos ocurren de manera aleatoria e independiente entre sí.
Ejemplos típicos son tiempos de espera, tiempos de reacción o modelos simples de inactividad. La distribución comienza en cero y luego disminuye constantemente. Solo es adecuada para valores mayores o iguales a cero.
Distribución log-logística
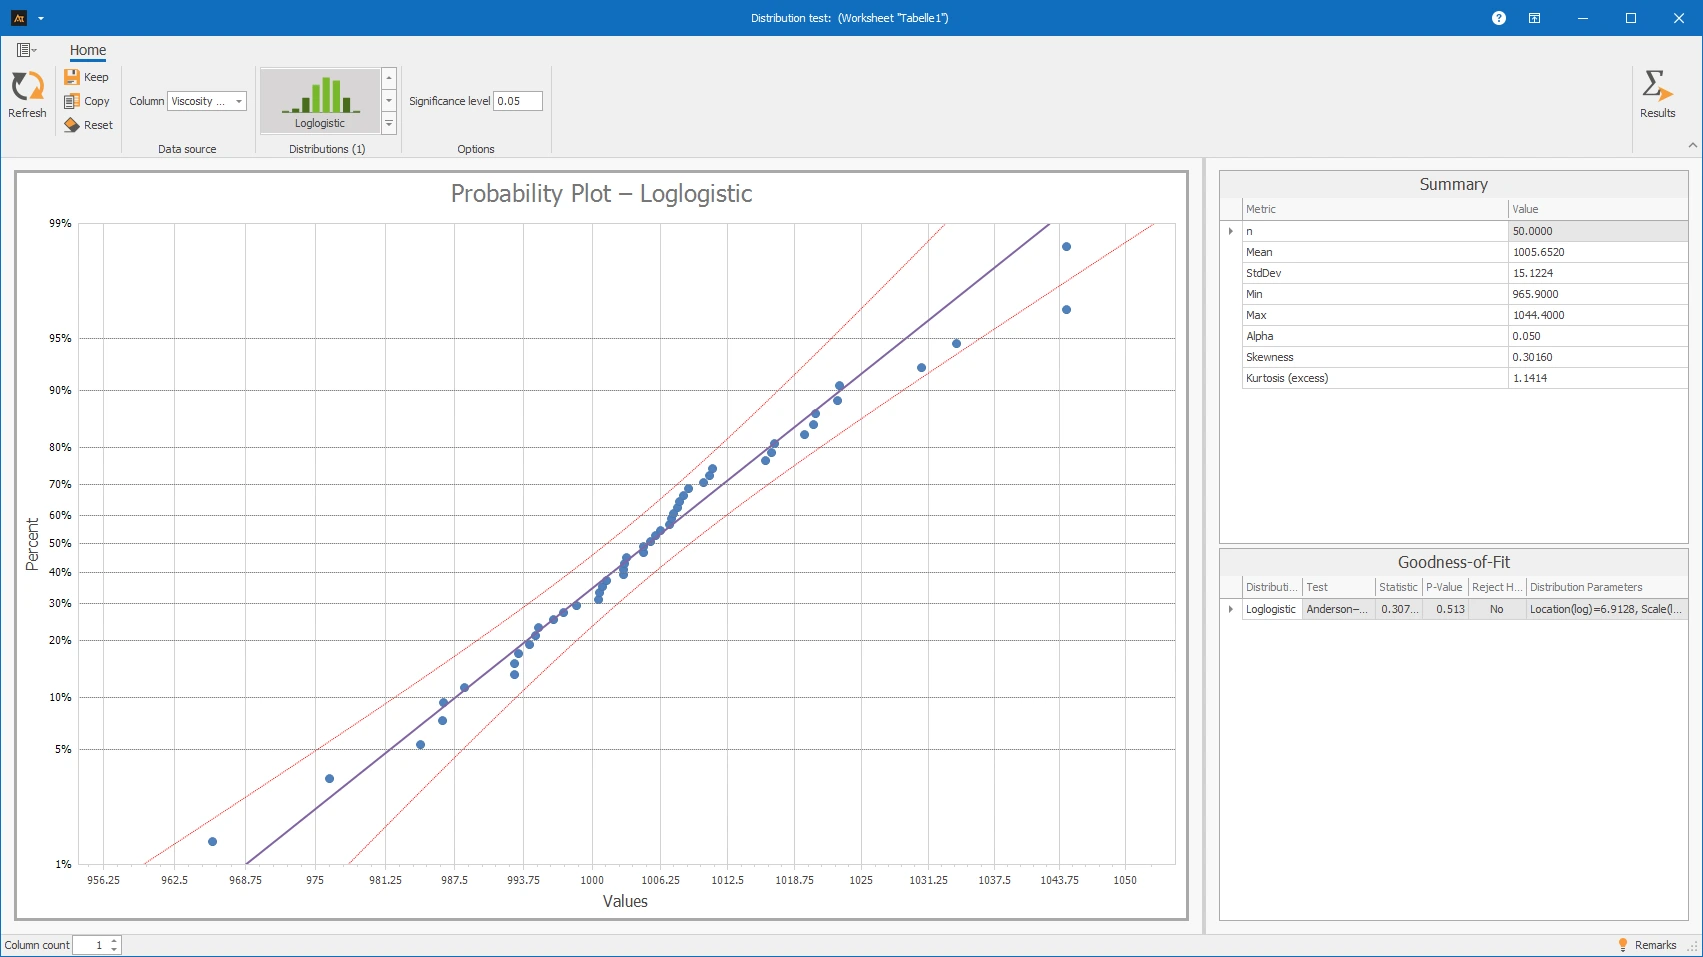
La distribución log-logística es adecuada para datos positivos y sesgados a la derecha. Se utiliza a menudo para datos de vida útil, tiempo o proceso donde ocurren muchos valores más pequeños y algunos valores significativamente más grandes.
En algunos casos, se asemeja a la distribución lognormal pero puede representar expresiones más fuertes en la cola derecha. Esto la hace útil cuando los tiempos de procesamiento largos o los fallos tardíos pesan más.
Distribución gamma
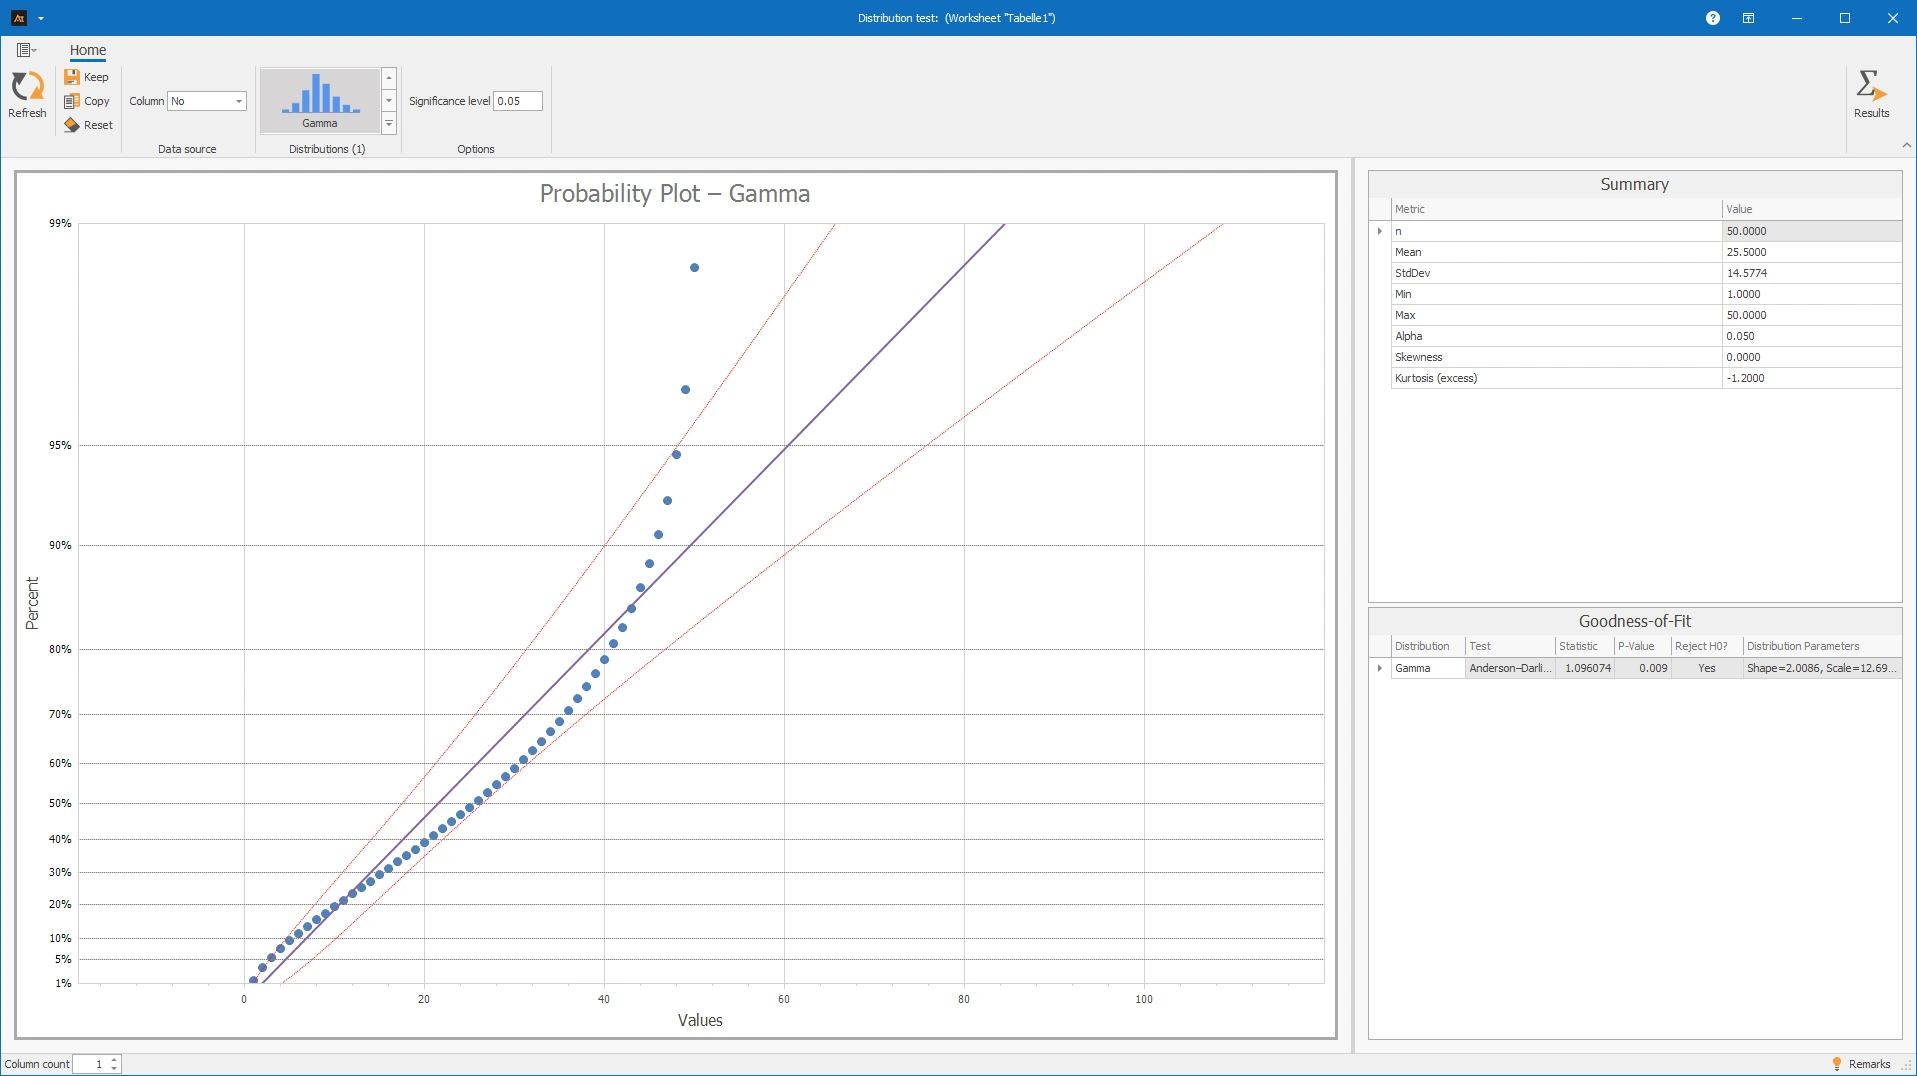
La distribución gamma se utiliza para datos positivos y sesgados a la derecha. Es adecuada para mediciones como tiempos de espera, tiempos de procesamiento, cantidades o cargas, siempre que no puedan ocurrir valores negativos.
Es más flexible que la distribución exponencial porque puede tomar diferentes formas. Esto le permite describir bien tanto datos altamente sesgados como moderadamente sesgados.
Distribución lognormal
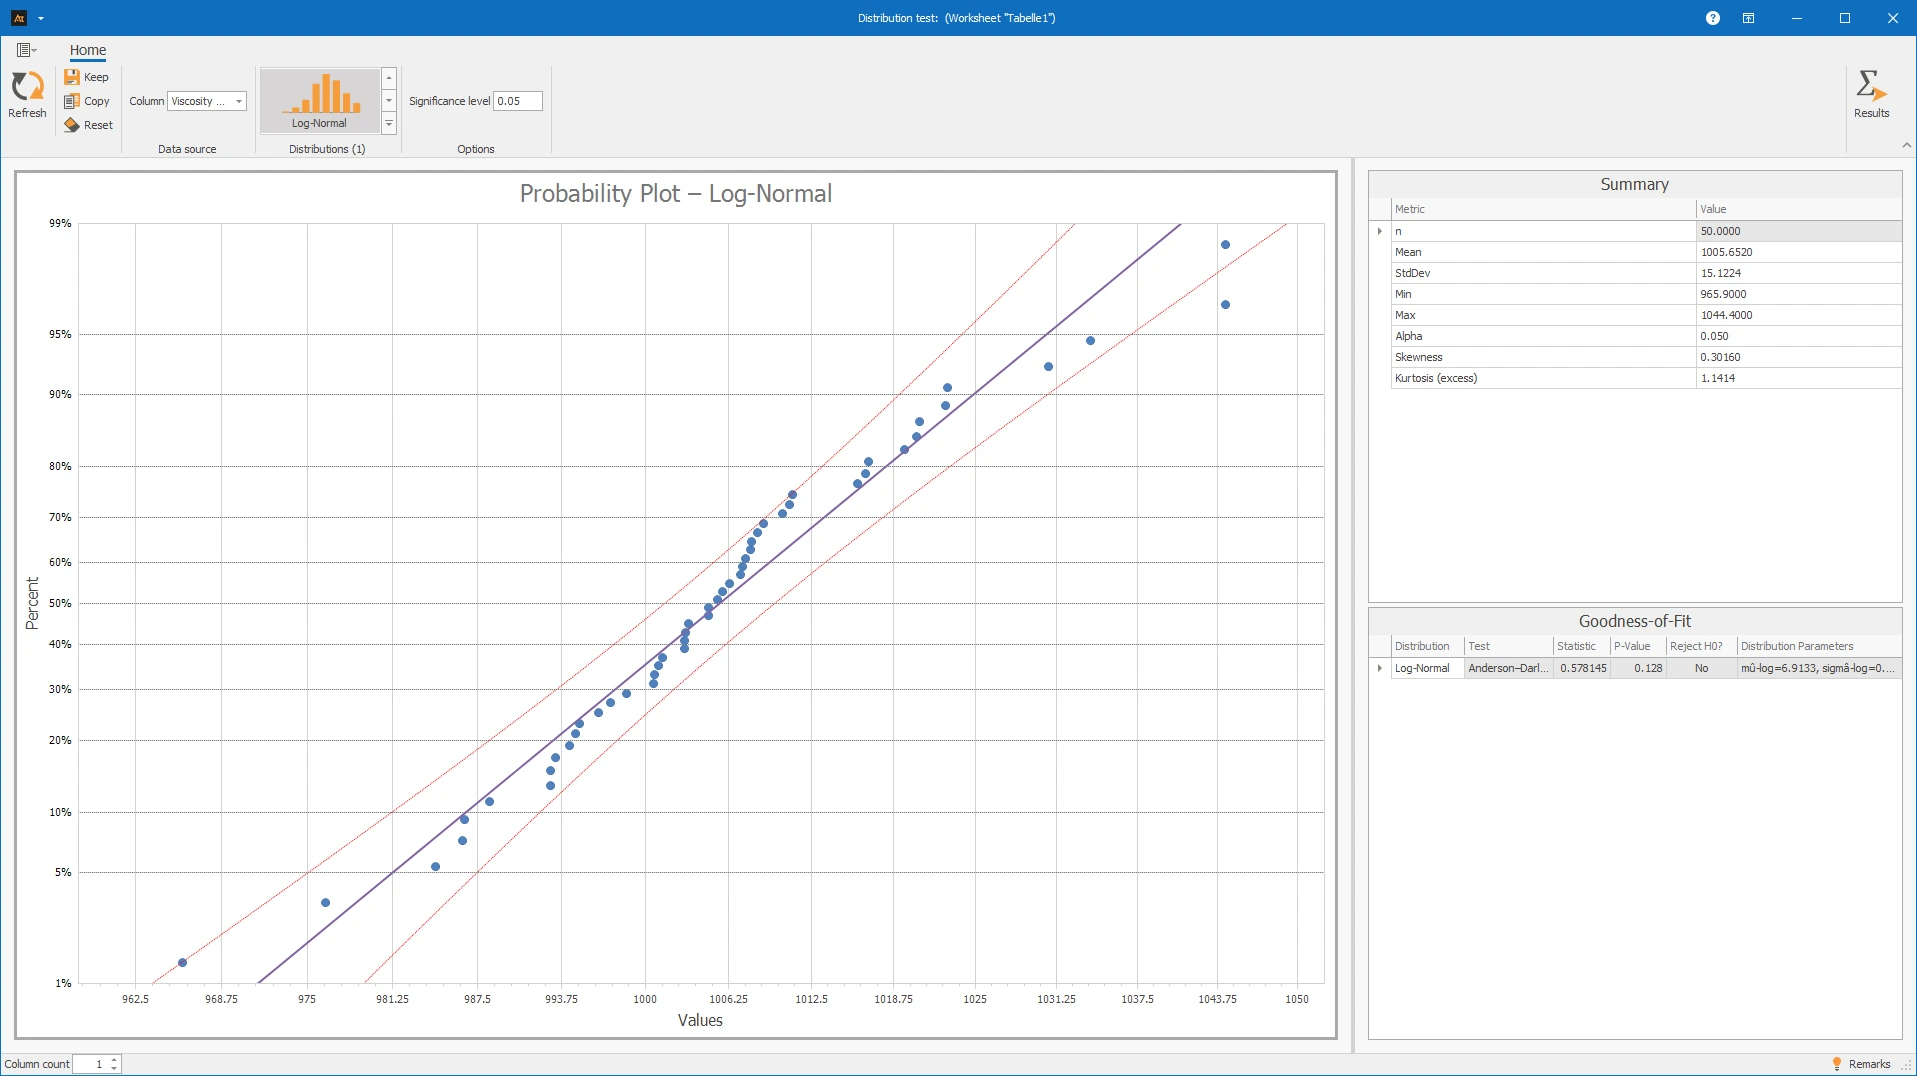
La distribución lognormal surge cuando los valores logarítmicos están aproximadamente distribuidos normalmente. Se utiliza para datos positivos que están sesgados a la derecha.
Ejemplos típicos son tiempos, vidas útiles, concentraciones, costos u otras cantidades donde pueden ocurrir valores individuales muy grandes. Si los datos no están distribuidos normalmente, una distribución lognormal puede ajustarse mejor.
Distribución logística
La distribución logística es simétrica y se asemeja a la distribución normal. Sin embargo, tiene colas ligeramente más fuertes, lo que permite que los valores extremos ocurran con algo más de frecuencia que en la distribución normal.
Se puede utilizar cuando los datos están generalmente distribuidos de manera simétrica, pero la distribución normal no describe bien las colas.
Distribución de Gumbel
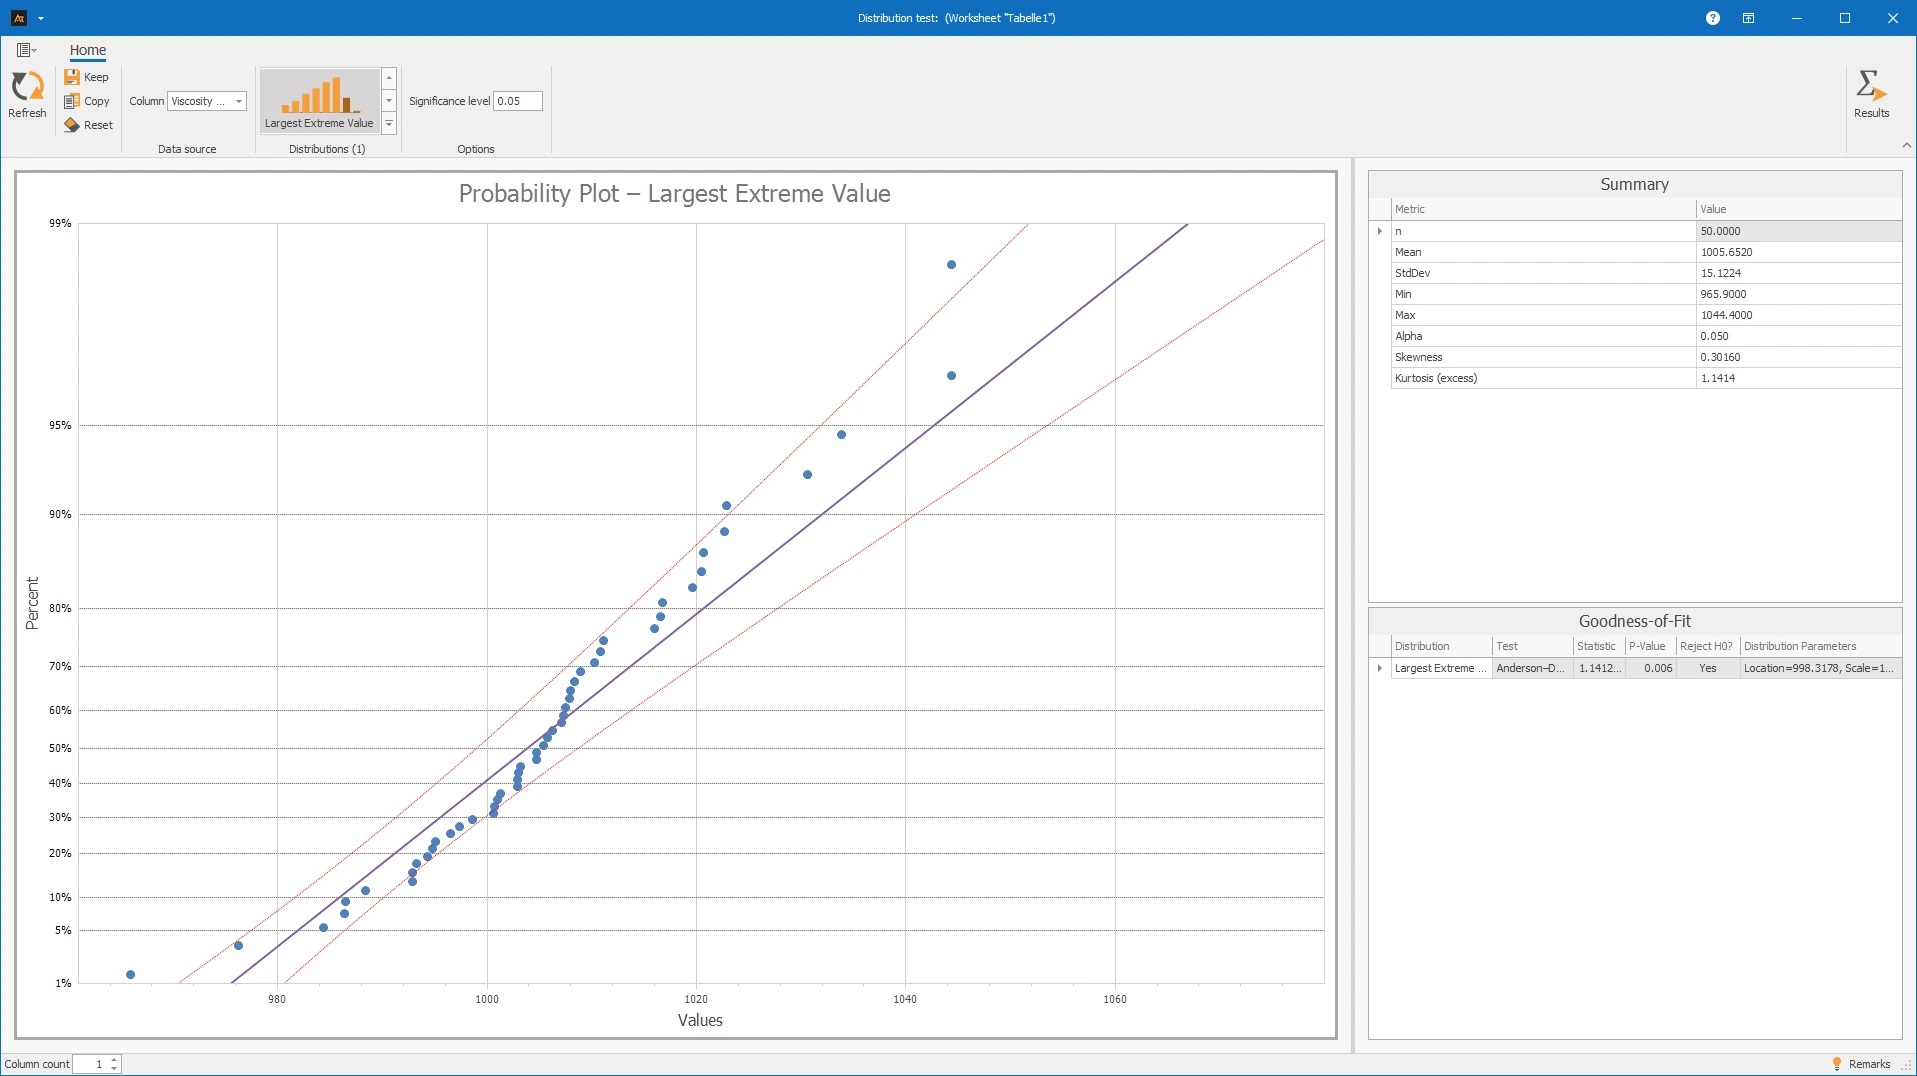
La distribución de Gumbel describe valores máximos. Se utiliza cuando los valores particularmente altos son el foco, como cargas máximas, temperaturas pico, tiempos de espera máximos o valores pico.
Es adecuada cuando no es el valor promedio típico, sino el comportamiento de las observaciones más grandes lo que es importante.
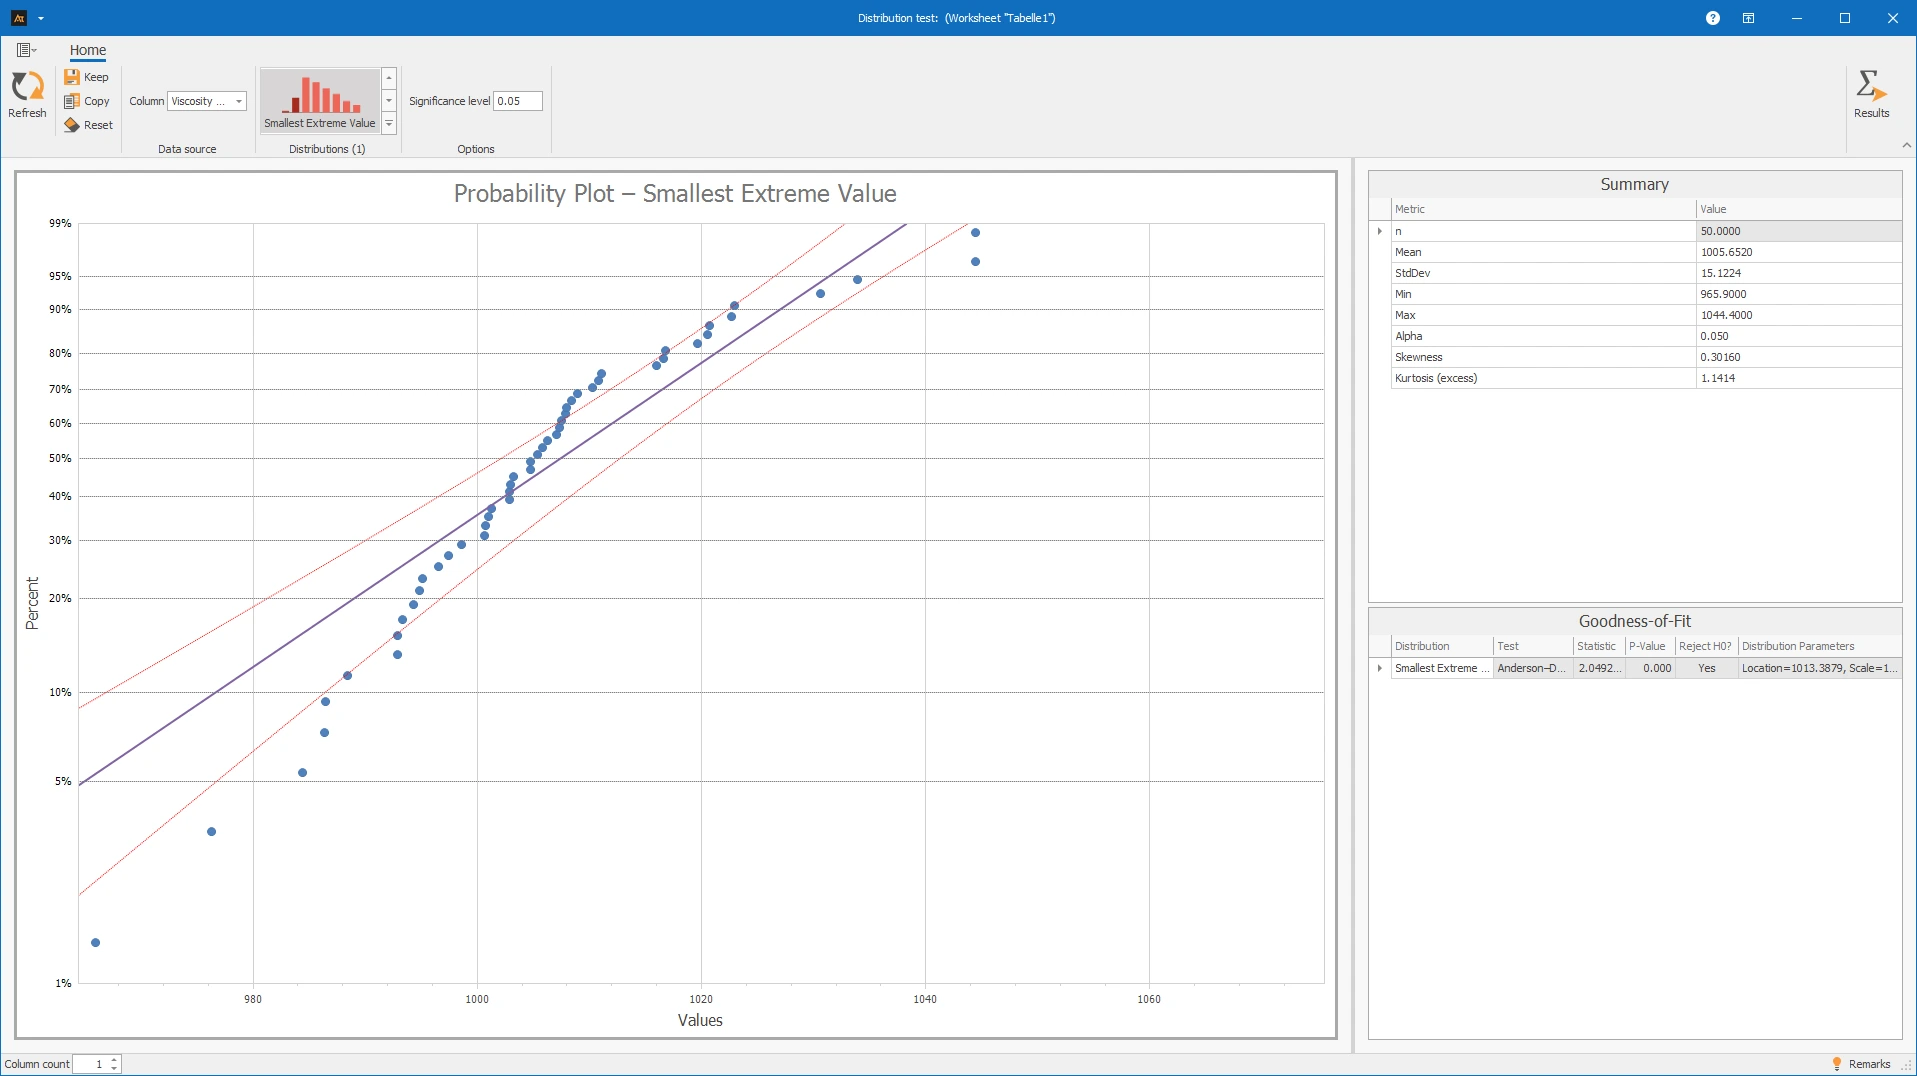
Distribución de valor extremo mínimo
La distribución de valor extremo mínimo describe valores mínimos. Se utiliza cuando los valores particularmente pequeños son el foco, como resistencias mínimas, vidas útiles más bajas o fallos más tempranos.
Es útil cuando se necesita evaluar el riesgo de mediciones muy pequeñas, por ejemplo, en límites de seguridad o requisitos mínimos.
Para datos nominales u ordinales, la prueba de distribución no es significativa, ya que estos tipos de datos no pueden describirse mediante distribuciones continuas como la normal, Weibull o gamma.
Para datos de conteo puro o eventos discretos, se debe verificar si un método específico para distribuciones discretas es más adecuado. La prueba de distribución está diseñada para las distribuciones continuas soportadas en la herramienta.
La prueba de distribución es más adecuada cuando se desea comparar varias distribuciones posibles entre sí.
Cantidad de llenado de salsa de tomate
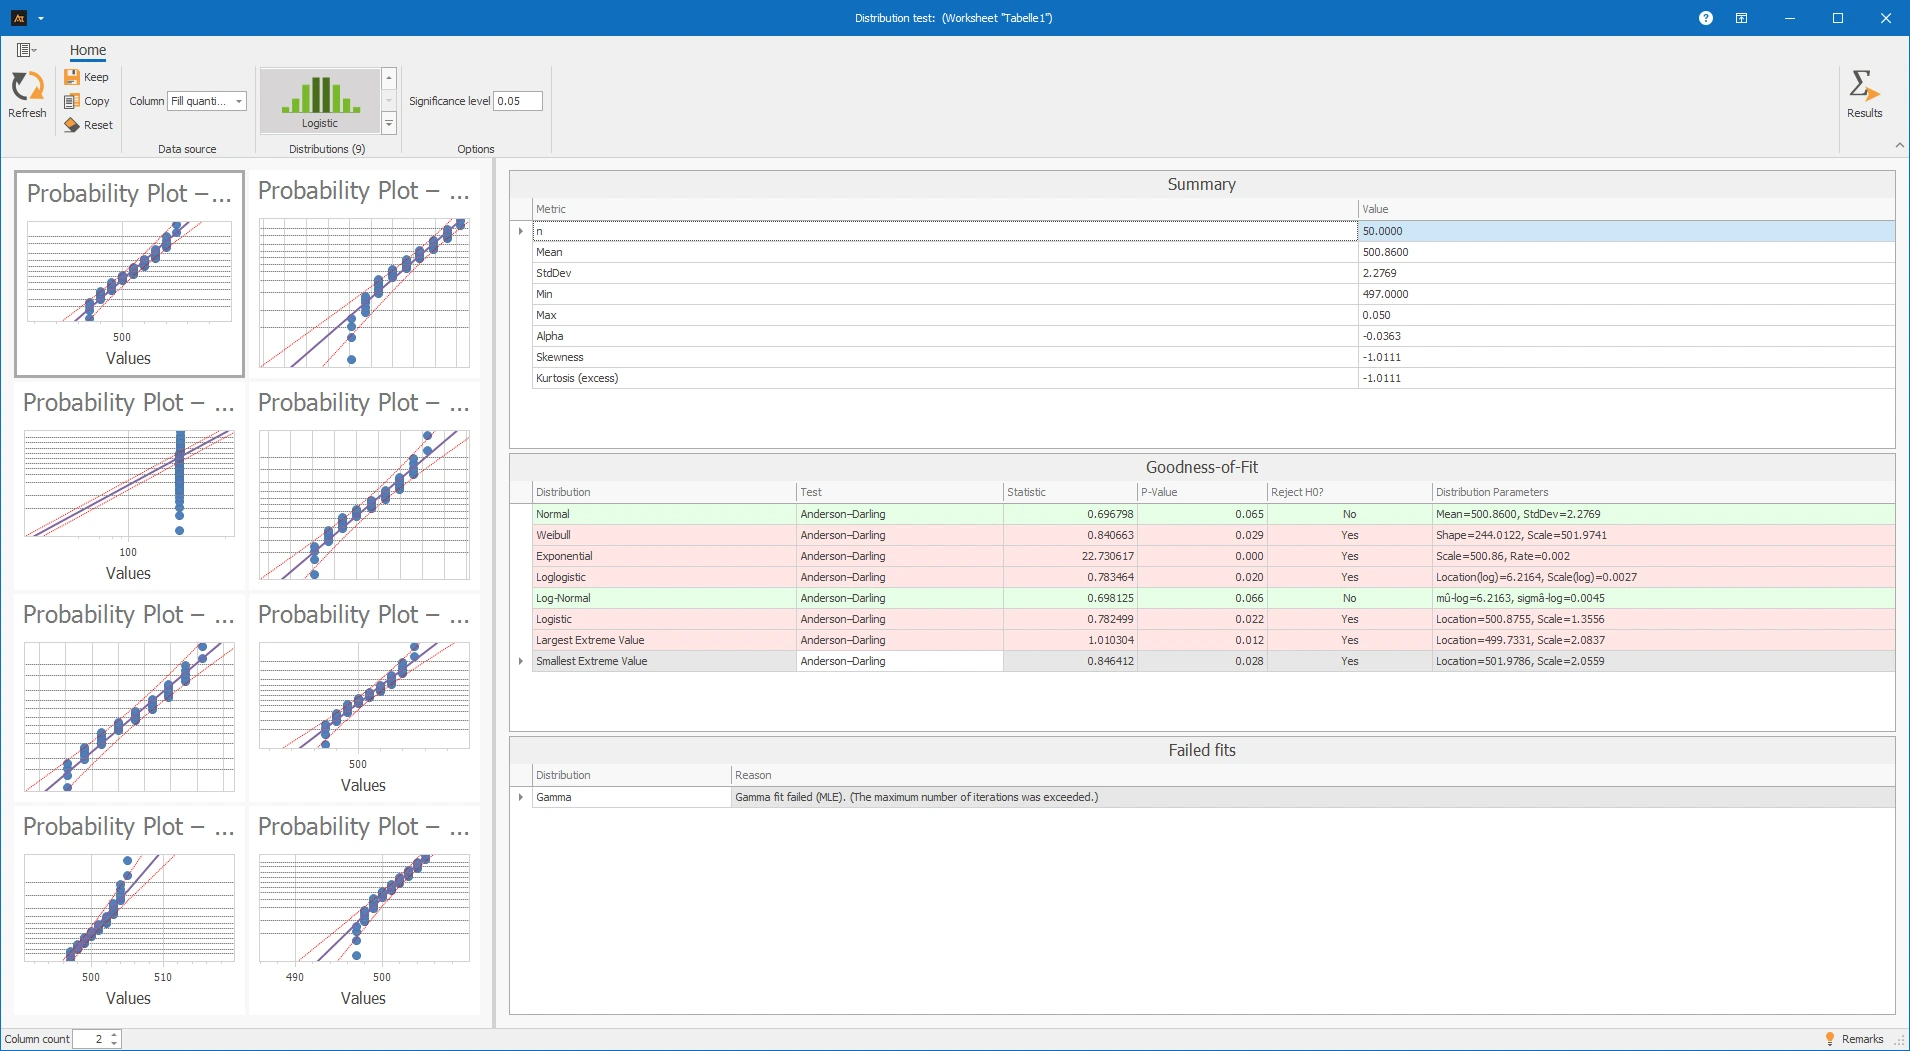
En este ejemplo, se examina la cantidad de llenado de una salsa de tomate. Cada llenado debe contener 500 ml. Debido a las fluctuaciones normales del proceso, algunas cantidades de llenado están ligeramente por debajo y otras ligeramente por encima del valor objetivo. Dado que tales mediciones a menudo se dispersan aproximadamente de manera simétrica alrededor del valor objetivo, se verifica qué distribución describe sensiblemente los datos. Para este propósito, las cantidades de llenado se comparan con varias distribuciones, incluida la distribución normal.
Interpretación
Las cantidades de llenado se compararon con varias distribuciones. Como resultado, la distribución normal no se rechaza porque el valor p de 0.065 es mayor que el nivel de significancia de 0.05. Además, en el gráfico de probabilidad, los puntos se encuentran mayormente cerca de la línea. Por lo tanto, las cantidades de llenado pueden describirse aproximadamente mediante una distribución normal.
Varias otras distribuciones, por otro lado, se rechazan porque sus valores p son menores o iguales a 0.05. Estas incluyen, entre otras, Weibull, Exponencial, Log-logística, Logística, y la distribución de valor extremo más grande. Hay evidencia estadística para estas distribuciones de que no describen adecuadamente los datos.
La distribución log-normal tampoco se rechaza. Sin embargo, en términos de cantidades de llenado, la distribución normal es a menudo sensata porque es una medición continua que típicamente se dispersa alrededor de un valor objetivo.
La distribución gamma no pudo ser calculada porque el ajuste falló. Por lo tanto, no se utiliza para la interpretación.
Conclusión:
Para un análisis más detallado, se puede utilizar la distribución normal porque no se rechaza estadísticamente y se ajusta bien a las cantidades de llenado.
Tiempo de Entrega de un Pedido en Recepción de Mercancías
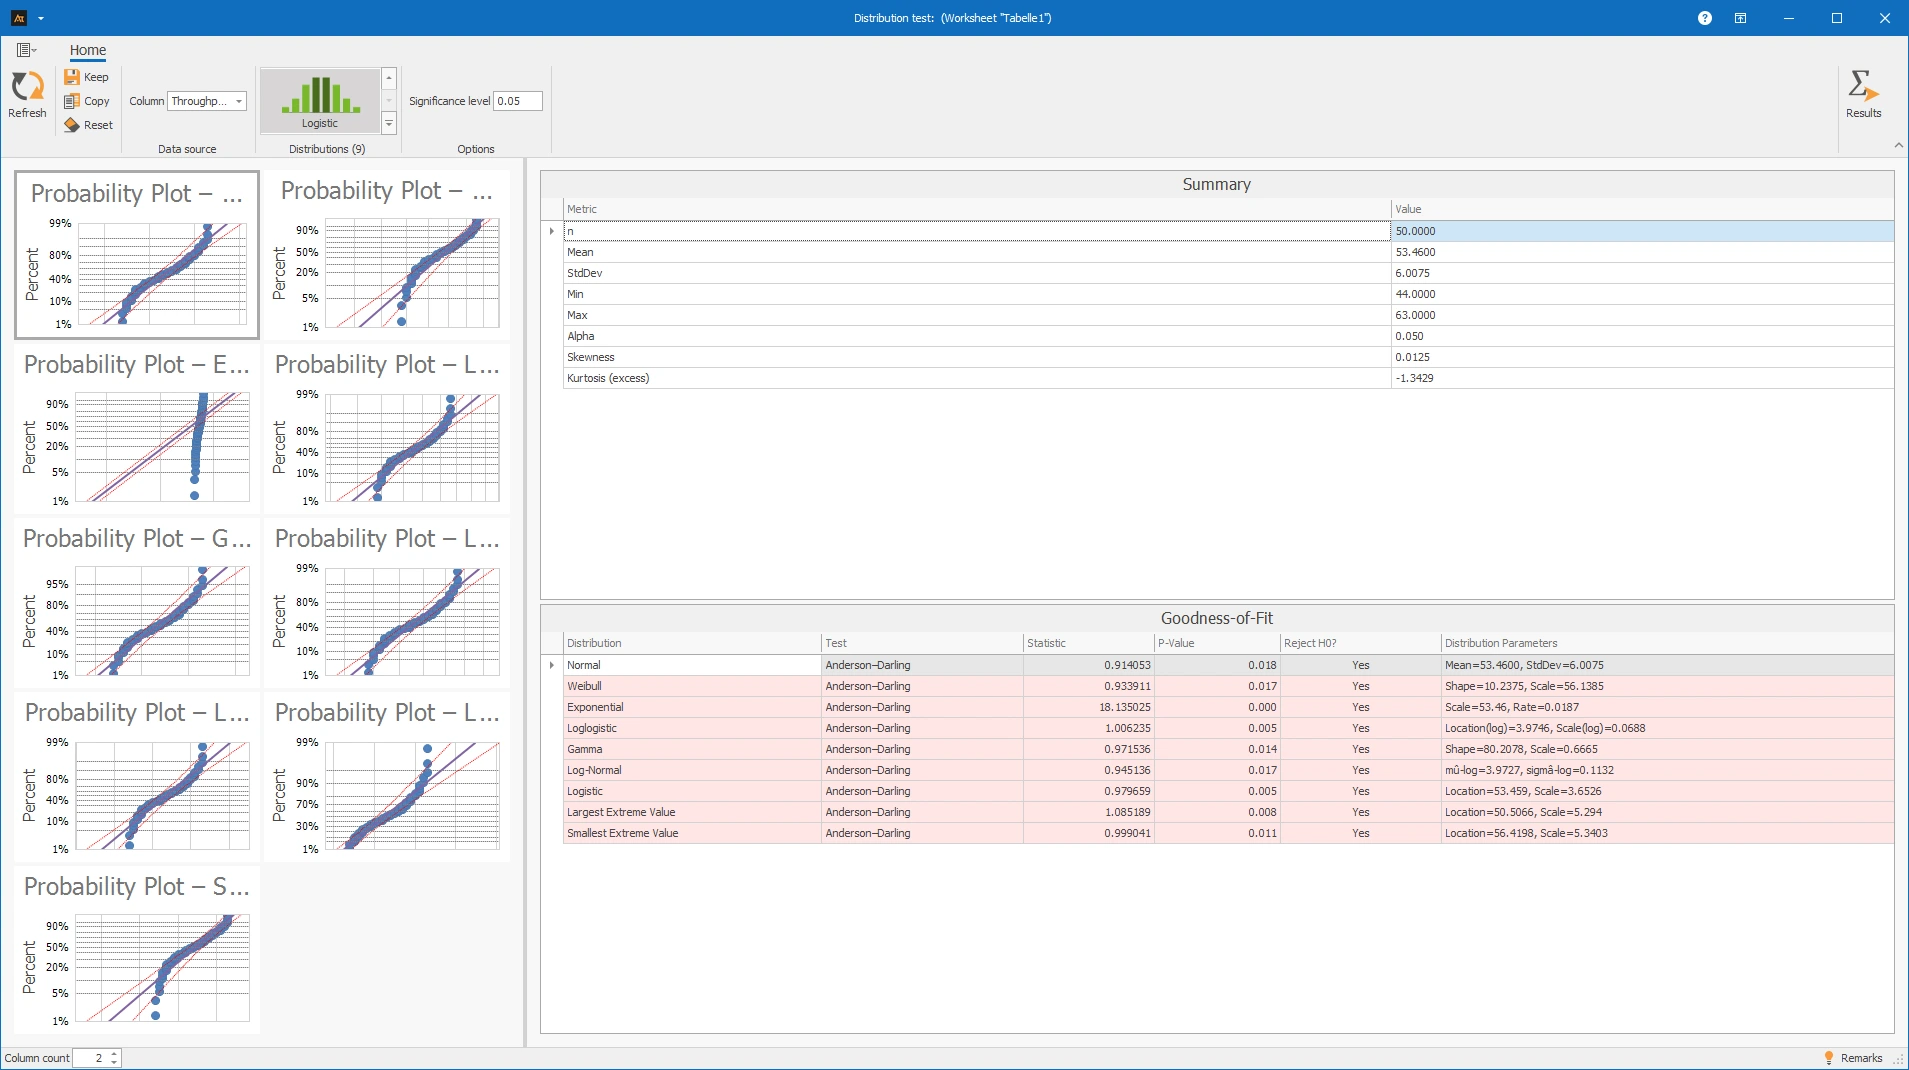
En la recepción de mercancías, los tiempos de procesamiento a menudo tienen una distribución sesgada a la derecha: muchos pedidos se completan rápidamente, pero algunos procesos tardan significativamente más. Por lo tanto, una distribución log-normal, gamma, Weibull o exponencial puede ser más plausible que una distribución normal.
Interpretación
Los tiempos de entrega se compararon con varias distribuciones. Para todas las distribuciones probadas, el valor p es menor que 0.05. Por lo tanto, todas las distribuciones son rechazadas.
También, en los gráficos de probabilidad, los puntos no se encuentran suficientemente bien en las líneas. Por lo tanto, los datos no pueden ser descritos adecuadamente por ninguna de las distribuciones probadas.
Conclusión:
Ninguna de las distribuciones probadas debe ser utilizada para los tiempos de entrega. Se debe verificar si diferentes estados de proceso o tipos de pedidos causan la variación.
Tiempo de respuesta de la mesa de ayuda de TI (Especificación: máx. 35 minutos (OSG))
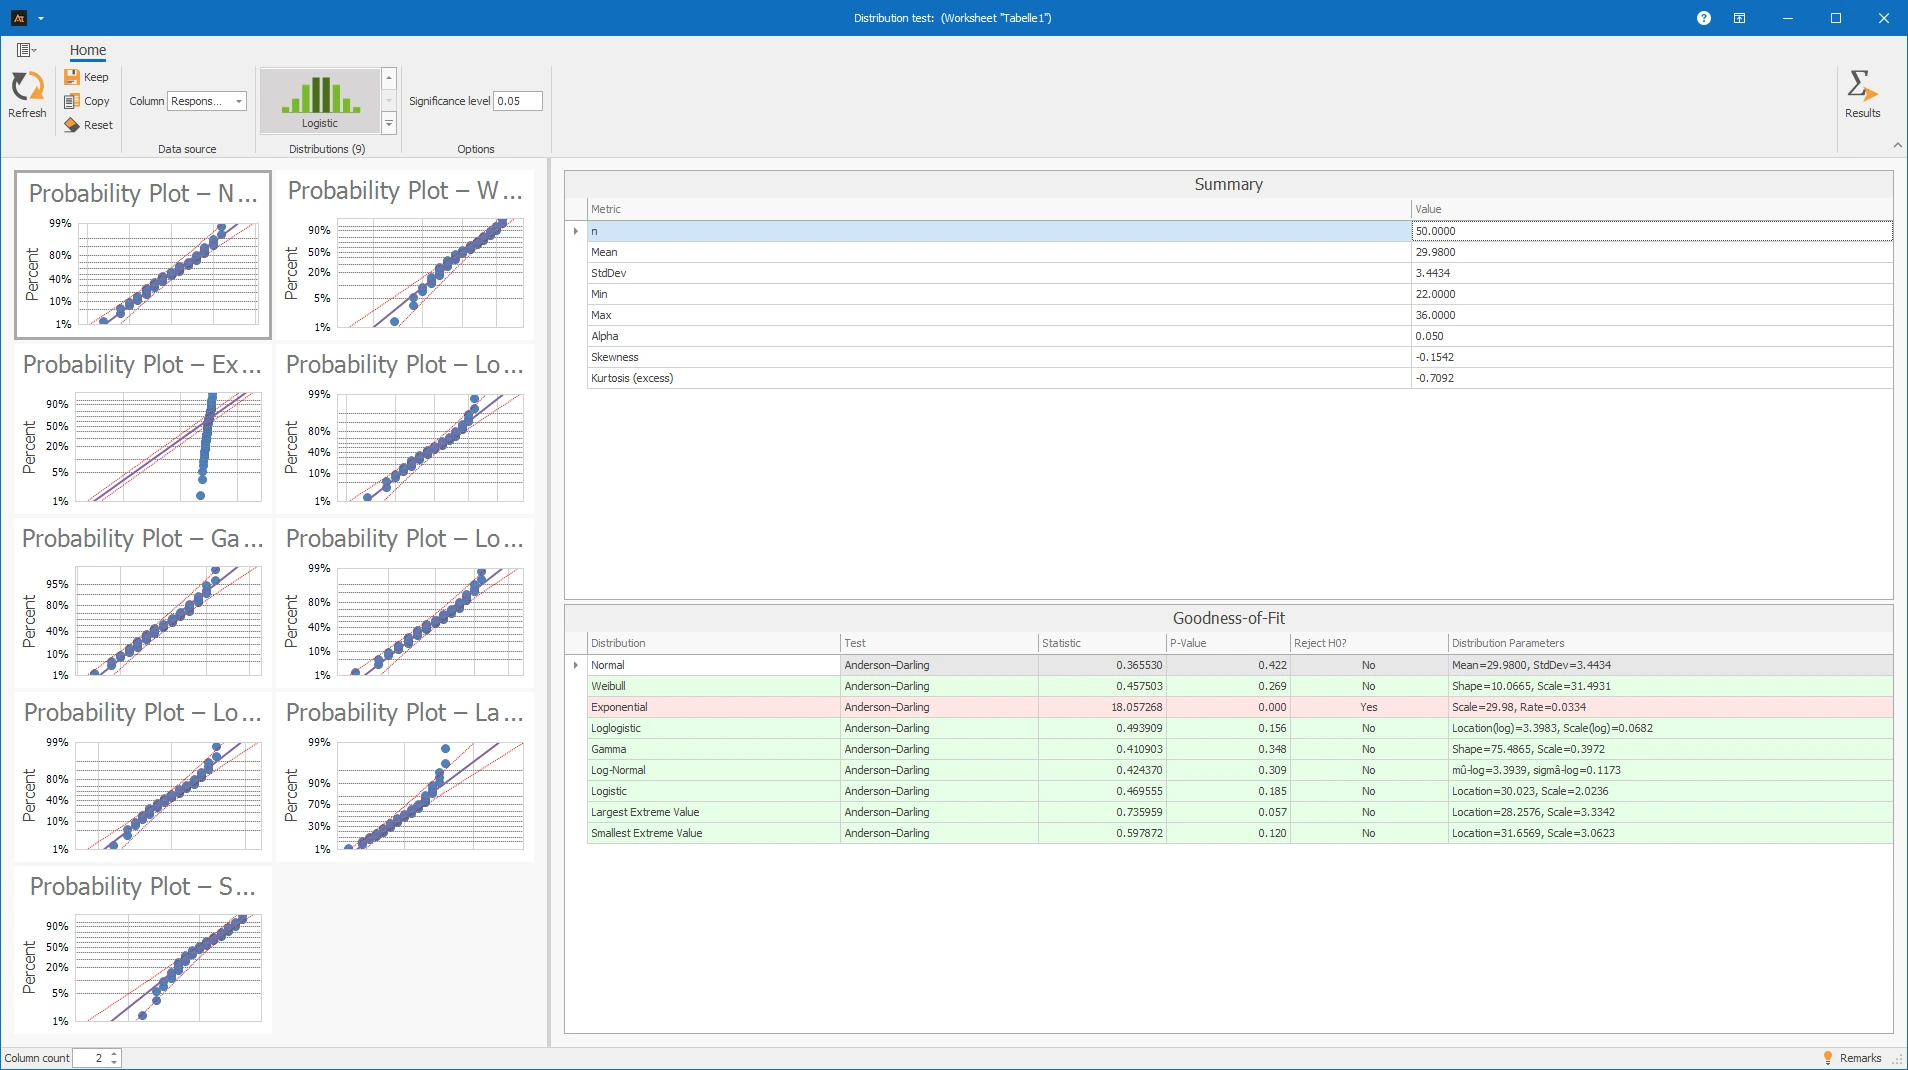
Se reciben consultas simples y complejas en el servicio de asistencia de TI. Esto puede resultar en tiempos de respuesta que varían alrededor de un valor típico pero también tienen colas largas a la derecha. Best Fit ayuda a verificar qué distribución describe mejor este comportamiento.
Interpretación
Los tiempos de respuesta se compararon con varias distribuciones. La mayoría de las distribuciones probadas no son rechazadas porque sus valores p son mayores que 0.05. Solo la distribución exponencial es rechazada porque el valor p es menor que 0.05.
Para esta distribución, los datos no se ajustan suficientemente bien. Los gráficos de probabilidad también muestran predominantemente puntos cercanos a la línea para las distribuciones no rechazadas.
Conclusión:
Los tiempos de respuesta pueden describirse aproximadamente por varias distribuciones. Para un análisis más detallado, se debe elegir una distribución adecuada para el tema; no se debe usar la distribución exponencial.
Vida útil de los rodamientos
Para un nuevo tipo de máquina, los rodamientos se prueban en operación continua. Cada rodamiento permanece en el banco de pruebas hasta que deja de ser funcional. Dichos datos de vida útil son típicamente positivos y a menudo no están distribuidos normalmente.
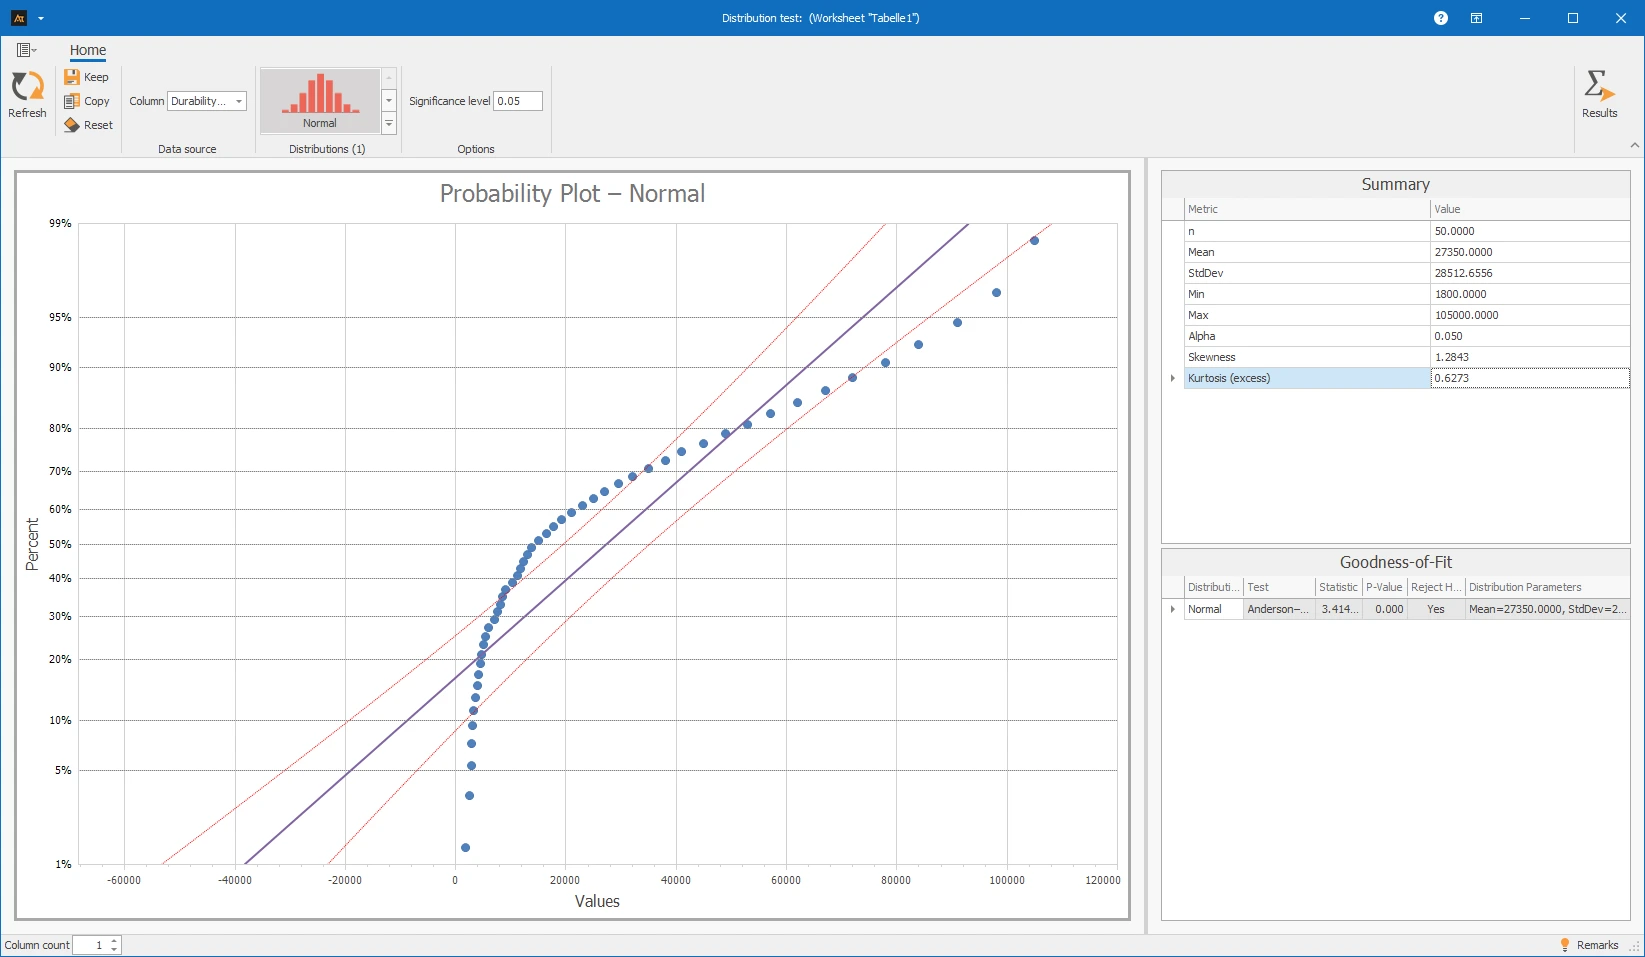
En el gráfico de probabilidad de la distribución normal, los puntos pueden desviarse significativamente de la línea. Esto argumenta en contra de una distribución normal de las vidas útiles.
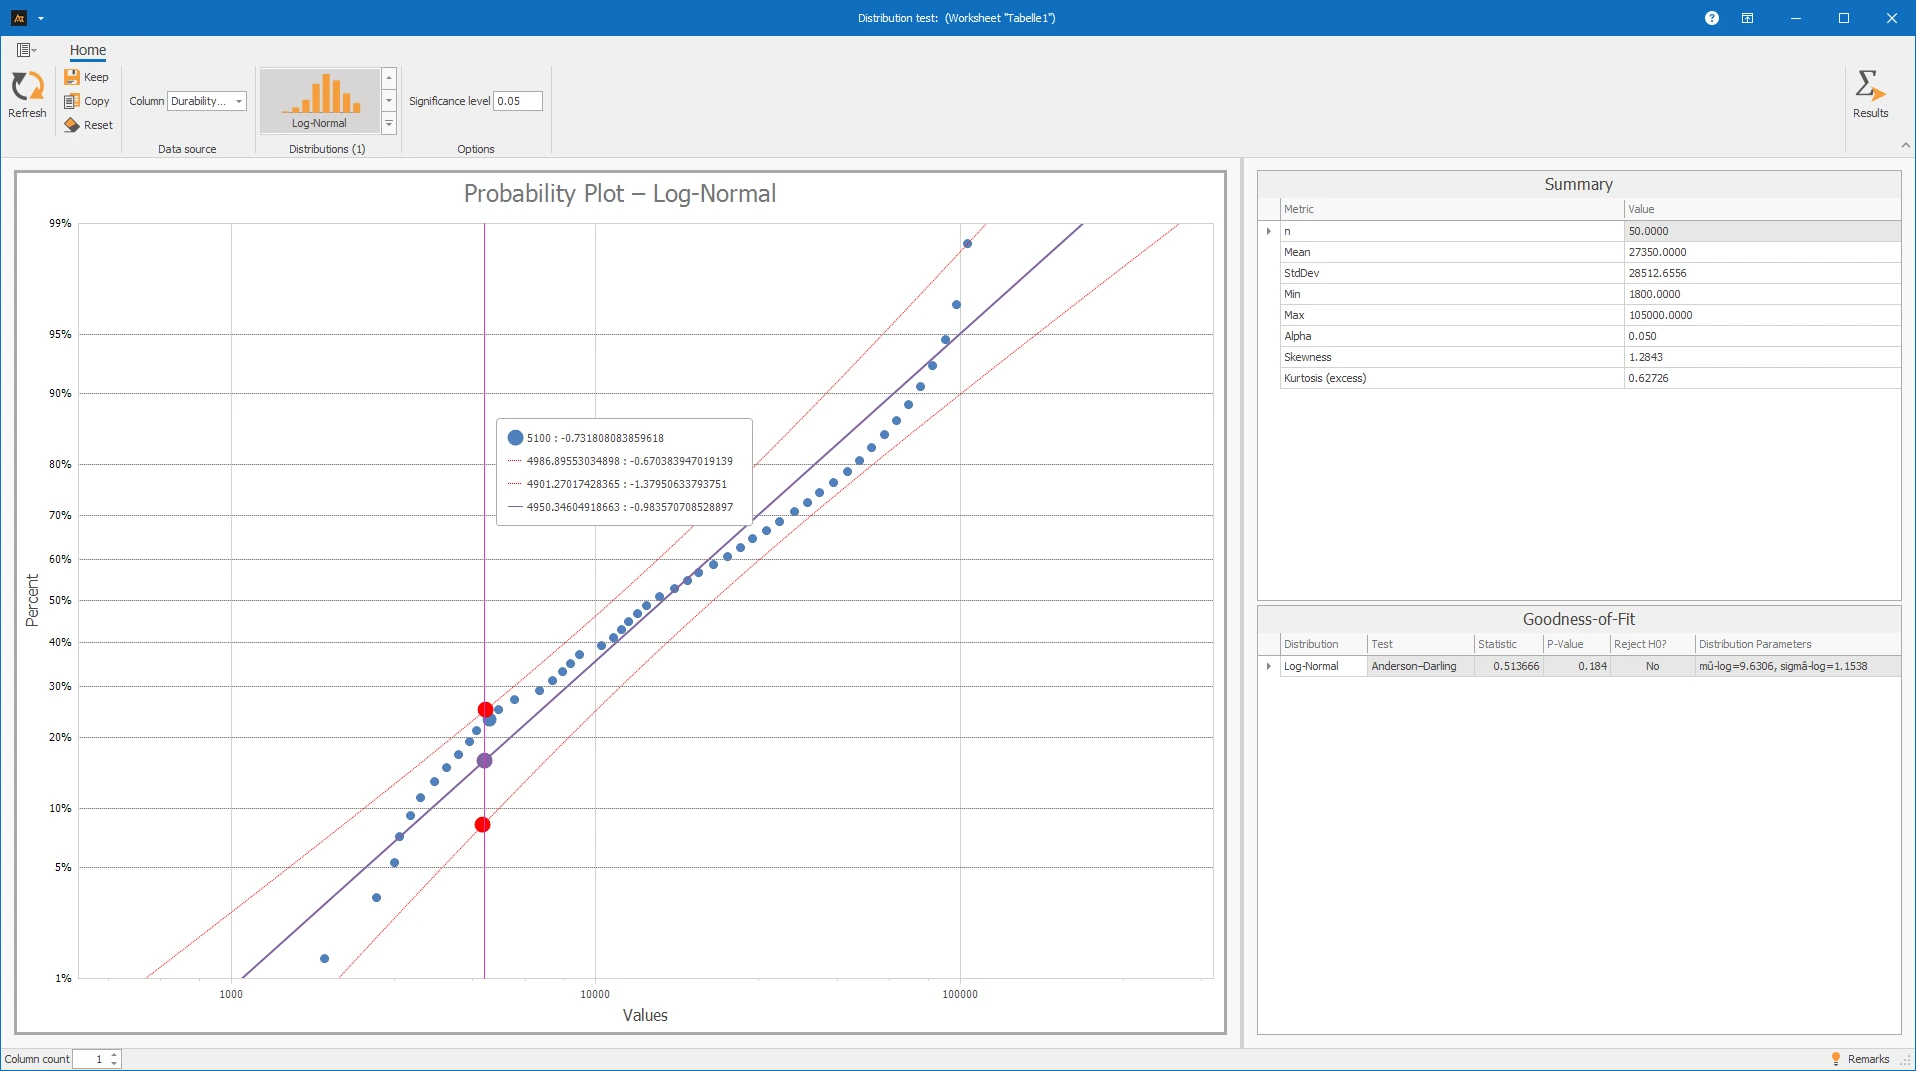
La vida útil de los rodamientos se probó con la distribución lognormal. El valor p es 0.190 y, por lo tanto, es mayor que 0.05. Por lo tanto, no se rechaza la distribución lognormal.
También en el gráfico de probabilidad, los puntos están mayormente cerca de la línea. Por lo tanto, los datos de vida útil pueden describirse aproximadamente mediante una distribución lognormal.
Datos continuos: Datos recopilados con un instrumento de medición que pueden tener unidades y decimales.
Distribución: Modelo matemático que describe cómo se distribuyen típicamente las mediciones.
Prueba de Anderson-Darling: Prueba estadística para verificar si los datos se ajustan a una distribución seleccionada.
Valor p: Métrica para evaluar el resultado de la prueba. Cuanto más pequeño es el valor p, más fuerte es la evidencia contra la distribución probada.
Estadístico A²: Medida de la desviación de los datos respecto a la distribución probada. Valores más pequeños tienden a indicar menos desviación de la distribución probada.
H0: Hipótesis nula de la prueba. Afirma: Los datos siguen la distribución probada.
n = Tamaño de la muestra: Número de mediciones válidas en la muestra.
Media: Promedio de todas las mediciones. Describe la ubicación central de los datos.
Desviación estándar: Medida de cuánto se dispersan las mediciones alrededor de la media. Una desviación estándar pequeña significa poca dispersión, una desviación estándar grande significa mayor dispersión.
Mínimo: La medición más pequeña dentro de la muestra considerada.
Máximo: La medición más grande dentro de la muestra considerada.
Alfa (α): Nivel de significancia establecido y umbral de decisión para el valor p. A menudo se usa α = 0.05. Si el valor p es menor que Alfa, se rechaza la hipótesis nula H0.
Asimetría: Métrica para la simetría de una distribución. Un valor cercano a 0 indica una distribución aproximadamente simétrica. Valores positivos o negativos indican una expresión más fuerte de la distribución hacia la derecha o izquierda, respectivamente.
Curtosis: Métrica que describe la forma de una distribución, particularmente cómo se concentran las mediciones en el centro y en las colas. Puede proporcionar pistas sobre si una distribución es más pronunciada o plana en comparación con una distribución normal.
El test de distribución calcula los parámetros correspondientes, la estadística de prueba y el valor p para las distribuciones seleccionadas. Se utilizan funciones de la biblioteca Numerics.NET para calcular la estadística de prueba.