


L'outil de test de distribution est utilisé pour comparer une série de données sélectionnée avec plusieurs distributions théoriques. Il aide à identifier quelle distribution décrit le mieux les mesures et si les données sont adaptées à des analyses statistiques ultérieures avec une hypothèse de distribution spécifique.
Le résultat n'est pas une "preuve" définitive pour une distribution. Une valeur p élevée signifie simplement que le test d'Anderson-Darling ne trouve pas de déviation statistiquement significative par rapport à la distribution choisie. La plausibilité technique, la référence de processus et le réseau de probabilité doivent toujours être pris en compte.

Pendant la production de sauce tomate, les valeurs de viscosité sont régulièrement enregistrées. La viscosité décrit l'épaisseur de la sauce. Elle est importante pour que le produit puisse être rempli uniformément et ait toujours la même consistance pour le client.
Avant de procéder à d'autres analyses, il convient de vérifier laquelle des distributions sélectionnées peut décrire de manière significative les valeurs de viscosité mesurées. À cette fin, les données sont comparées avec les tests de distribution pour les distributions Normale, Lognormale, Loglogistique et Logistique.
Explications des résultats :
Graphiques de probabilité
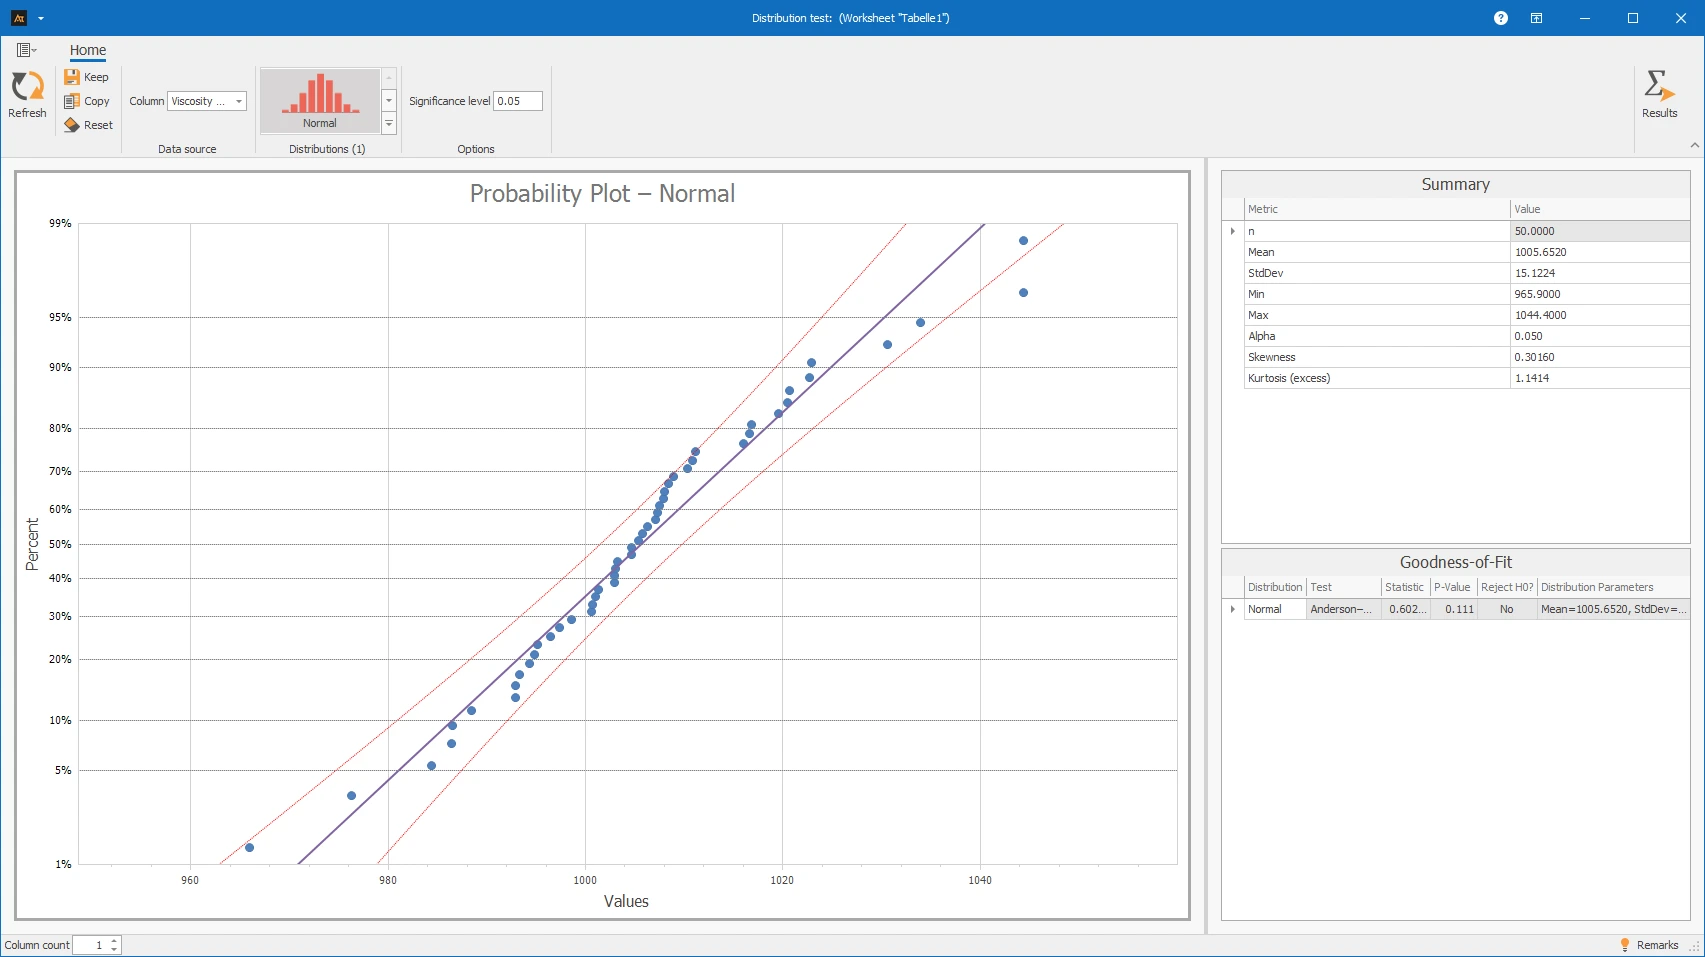
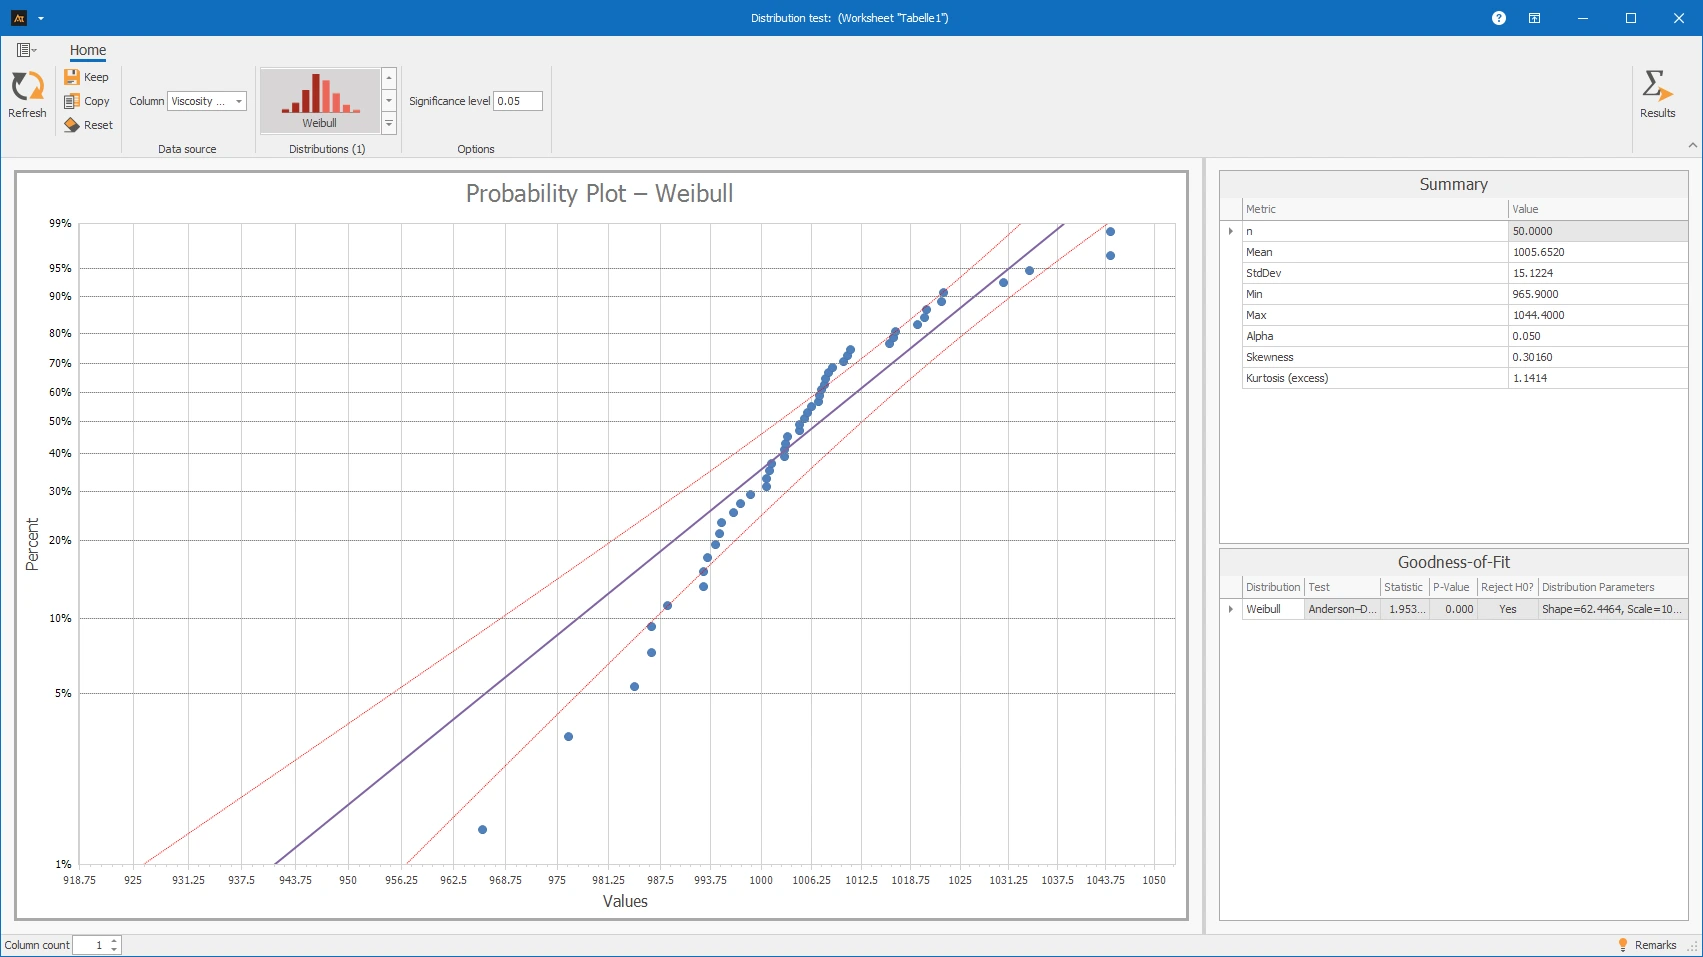
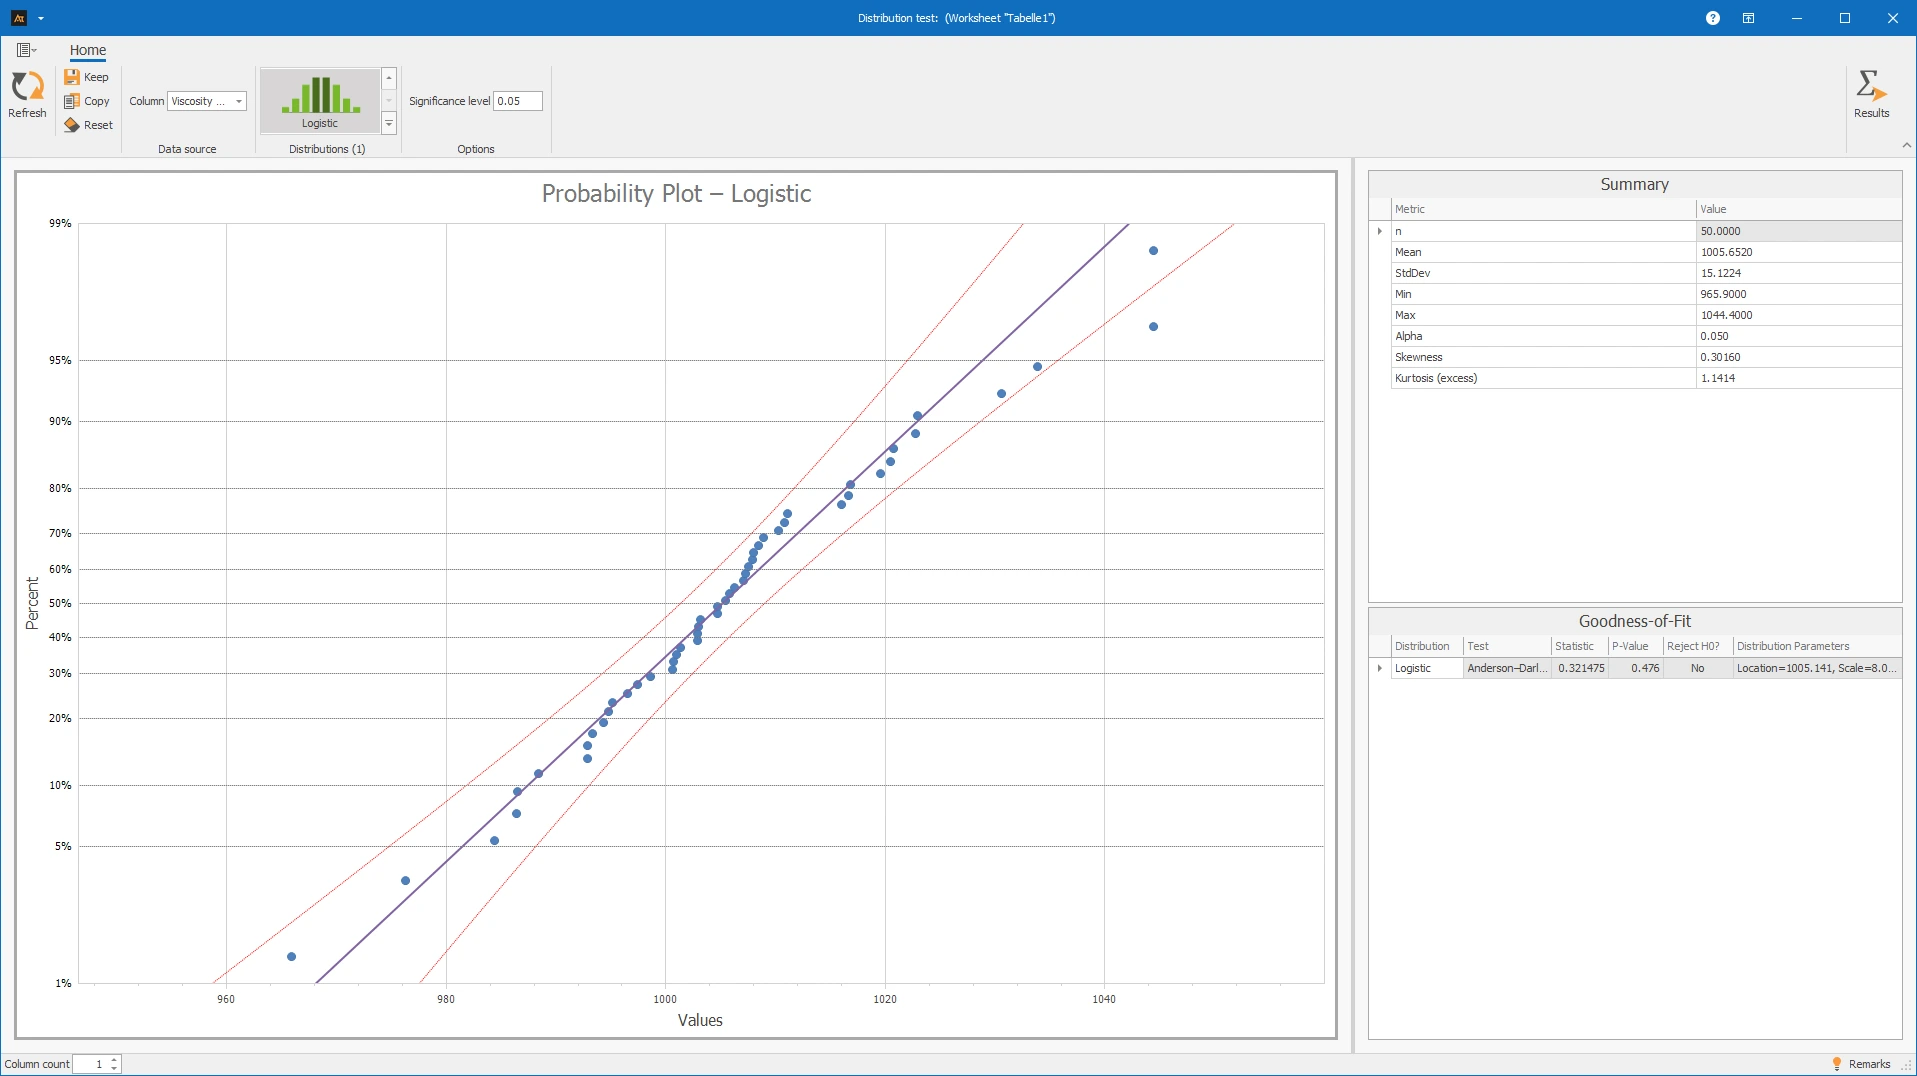
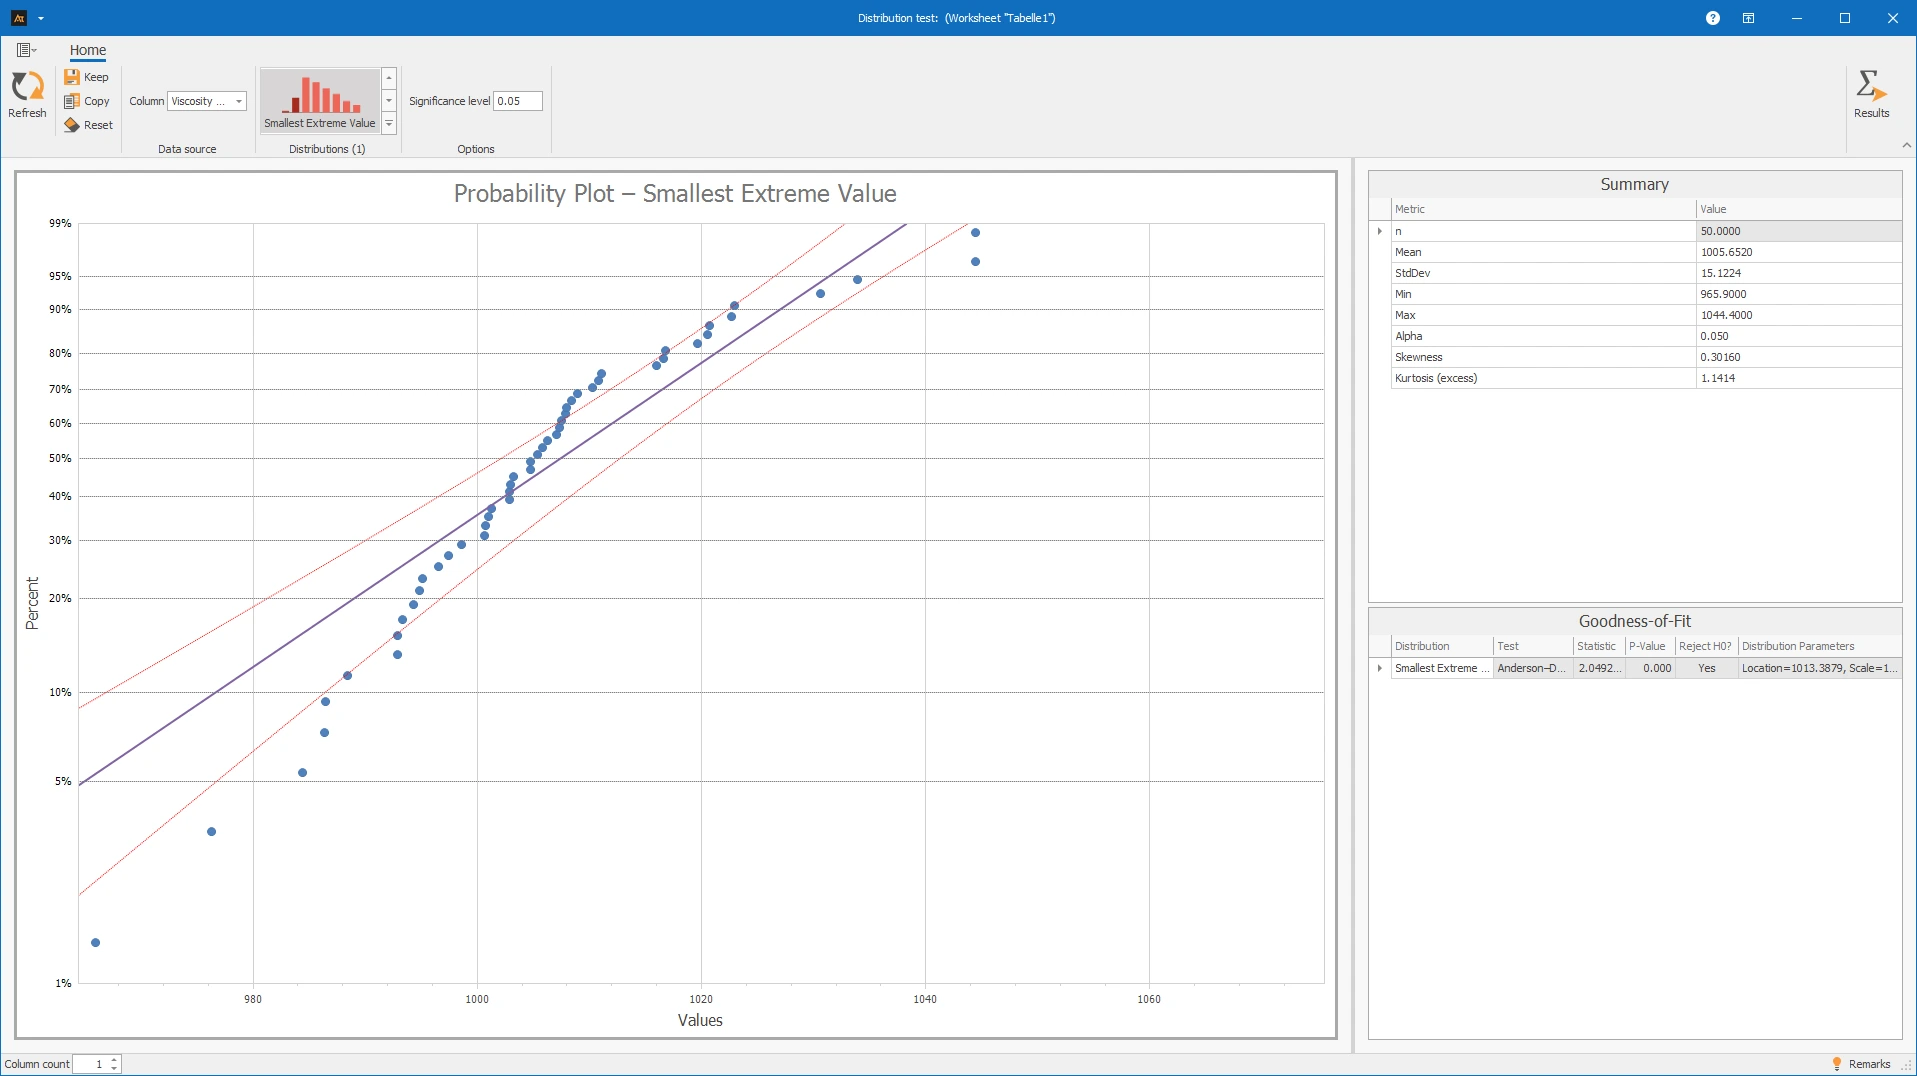
Pour chaque distribution calculée avec succès, le test de distribution génère son propre graphique de probabilité. Dans celui-ci, les valeurs mesurées triées sont comparées aux valeurs qui seraient attendues sous la distribution théorique respective.
- Si les points sont proches de la ligne tracée, la distribution choisie s'adapte bien aux données. Plus les points s'écartent de la ligne, moins cette distribution décrit bien les données.
- Des motifs courbés, des formes en S, des valeurs aberrantes significatives ou des écarts dans les zones de bord indiquent que les données ne s'adaptent pas bien à la distribution testée.
- Lors de la comparaison de plusieurs distributions, il ne faut pas seulement considérer la valeur p. Il est également important de savoir si le graphique de probabilité montre un motif plausible et calme et si la distribution s'adapte techniquement à la caractéristique.
La ligne peut être comprise comme un modèle : Plus les points s'adaptent au modèle de la distribution, plus cette distribution est adaptée comme modèle pour les données.
Test d'Anderson-Darling
Le test de distribution utilise le test d'Anderson-Darling comme test de qualité d'ajustement calculatoire. Le test vérifie si les valeurs mesurées s'adaptent à la distribution sélectionnée. Il est effectué pour toutes les distributions prises en charge qui peuvent être calculées avec les données disponibles.
Le test fournit une statistique de test et une valeur p pour chaque distribution :
- valeur p supérieure à alpha : Il n'y a pas de preuve statistique que les données s'écartent de cette distribution. → La distribution peut être considérée comme un modèle possible.
- valeur p inférieure ou égale à alpha : Le test trouve des écarts significatifs. → L'hypothèse nulle est rejetée ; la distribution testée ne s'adapte pas statistiquement suffisamment aux données.
Pourquoi le test d'Anderson-Darling est-il utilisé ? Il est particulièrement sensible aux écarts dans les zones de bord de la distribution. C'est là que se produisent souvent des valeurs aberrantes ou extrêmes, qui sont importantes pour les analyses de qualité, de processus et de durée de vie.
Interprétation des résultats :
Les valeurs de viscosité ont été comparées aux distributions Normale, Lognormale, Loglogistique et Logistique. Pour les quatre distributions, la valeur p est supérieure à 0,05. Par conséquent, l'hypothèse nulle n'est rejetée pour aucune distribution. Il n'y a pas de preuve statistique que les données s'écartent significativement de l'une des distributions testées.
Les graphiques de probabilité montrent également que les points se situent principalement près des lignes. Ainsi, les valeurs de viscosité peuvent être approximativement décrites avec les distributions testées.
Cependant, le résultat ne permet pas de conclure de manière définitive qu'une de ces distributions est clairement la meilleure. La sélection de la distribution doit donc également être basée sur la plausibilité technique et l'analyse ultérieure prévue. Étant donné que la viscosité est une mesure continue et que les données sont approximativement distribuées de manière symétrique autour de la moyenne, la distribution normale peut être un choix judicieux et bien justifié pour de nombreuses évaluations standard ultérieures.
Les considérations et étapes suivantes sont nécessaires pour tester une série de données contre plusieurs distributions avec Best Fit.
Préparation
- Sélectionnez une mesure numérique appropriée.
- Collectez les mesures.
- Sélectionnez les distributions, par exemple, Weibull, Gamma, Lognormale.
 Utiliser dans AlphadiTab
- Sélectionnez l'outil Test de Distribution dans la Phase de Mesure.
- Sélectionnez la série de données à tester et activez une ou plusieurs distributions dans la galerie de distributions.
- Vérifiez ou ajustez le niveau de signification.
- Effectuez l'analyse avec Mettre à jour.
Interprétation
Ensuite, vérifiez pour chaque distribution sélectionnée si elle est adaptée pour décrire les mesures.
- p-valeur : Si la p-valeur est supérieure à 0,05, il n'y a pas de preuve statistique d'une déviation par rapport à la distribution. Les données peuvent donc être considérées comme approximativement adaptées à la distribution.
- Graphique de probabilité : Si les points sont principalement proches de la ligne tracée, la distribution choisie est un modèle plausible pour les données.
Les distributions suivantes sont disponibles dans l'outil :
Distribution normale
La distribution normale est une distribution symétrique en forme de cloche. Elle se produit souvent dans les mesures résultant de nombreuses petites influences aléatoires. Les exemples incluent les dimensions, les poids, les quantités de remplissage ou les valeurs de processus.
Typiquement, la plupart des valeurs sont proches de la moyenne, et les grandes déviations vers le haut ou vers le bas deviennent plus rares. Si les données s'ajustent bien à la distribution normale, de nombreuses méthodes statistiques classiques peuvent être utilisées.
Distribution de Weibull
La distribution de Weibull est souvent utilisée pour les données de durée de vie, de défaillance et de fiabilité. Elle est particulièrement adaptée lorsque seules des valeurs positives se produisent, comme les temps de fonctionnement jusqu'à la défaillance.
Selon le paramètre de forme, la distribution de Weibull peut représenter différents parcours. Cela la rend très flexible et souvent utilisée pour décrire les durées de vie techniques, le comportement d'usure ou les probabilités de défaillance.
Distribution exponentielle
La distribution exponentielle décrit les temps d'attente ou les temps jusqu'au prochain événement. Elle est souvent utilisée lorsque les événements se produisent de manière aléatoire et indépendamment les uns des autres.
Les exemples typiques sont les temps d'attente, les temps de réaction ou les modèles simples de temps d'arrêt. La distribution commence à zéro et diminue ensuite régulièrement. Elle n'est adaptée que pour les valeurs supérieures ou égales à zéro.
Distribution log-logistique
La distribution log-logistique est adaptée aux données positives et asymétriques à droite. Elle est souvent utilisée pour les données de durée de vie, de temps ou de processus où de nombreuses petites valeurs et quelques valeurs significativement plus grandes se produisent.
Dans certains cas, elle ressemble à la distribution lognormale mais peut représenter des expressions plus fortes dans la queue droite. Cela la rend utile lorsque les temps de traitement longs ou les défaillances tardives pèsent plus lourd.
Distribution gamma
La distribution gamma est utilisée pour les données positives et asymétriques à droite. Elle est adaptée aux mesures telles que les temps d'attente, les temps de passage, les quantités ou les charges, à condition qu'aucune valeur négative ne puisse se produire.
Elle est plus flexible que la distribution exponentielle car elle peut prendre différentes formes. Cela lui permet de bien décrire à la fois les données très asymétriques et modérément asymétriques.
Distribution lognormale
La distribution lognormale se produit lorsque les valeurs logarithmiques sont approximativement normalement distribuées. Elle est utilisée pour les données positives qui sont asymétriques à droite.
Les exemples typiques sont les temps, les durées de vie, les concentrations, les coûts ou d'autres quantités où de très grandes valeurs individuelles peuvent se produire. Si les données ne sont pas normalement distribuées, une distribution lognormale peut souvent mieux convenir.
Distribution logistique
La distribution logistique est symétrique et ressemble à la distribution normale. Cependant, elle a des queues légèrement plus fortes, permettant aux valeurs extrêmes de se produire un peu plus fréquemment que dans la distribution normale.
Elle peut être utilisée lorsque les données sont généralement distribuées de manière symétrique, mais que la distribution normale ne décrit pas suffisamment bien les queues.
Distribution de Gumbel
La distribution de Gumbel décrit les valeurs maximales. Elle est utilisée lorsque des valeurs particulièrement élevées sont au centre de l'attention, telles que les charges maximales, les températures de pointe, les temps d'attente maximum ou les valeurs de pointe.
Elle est adaptée lorsque ce n'est pas la valeur moyenne typique, mais le comportement des plus grandes observations qui est important.
Distribution des valeurs extrêmes minimales
La distribution des valeurs extrêmes minimales décrit les valeurs minimales. Elle est utilisée lorsque des valeurs particulièrement petites sont au centre de l'attention, telles que les résistances minimales, les durées de vie les plus courtes ou les premières défaillances.
Elle est utile lorsque le risque de très petites mesures doit être évalué, par exemple, dans les limites de sécurité ou les exigences minimales.
Pour les données nominales ou ordinales, le test de distribution n'est pas significatif, car ces types de données ne peuvent pas être décrits par des distributions continues telles que normale, Weibull ou gamma.
Pour les données de comptage pur ou les événements discrets, il convient de vérifier si une méthode spécifique pour les distributions discrètes est plus appropriée. Le test de distribution est conçu pour les distributions continues prises en charge dans l'outil.
Le test de distribution est plus adapté lorsque plusieurs distributions possibles doivent être comparées entre elles.
Quantité de remplissage sauce tomate
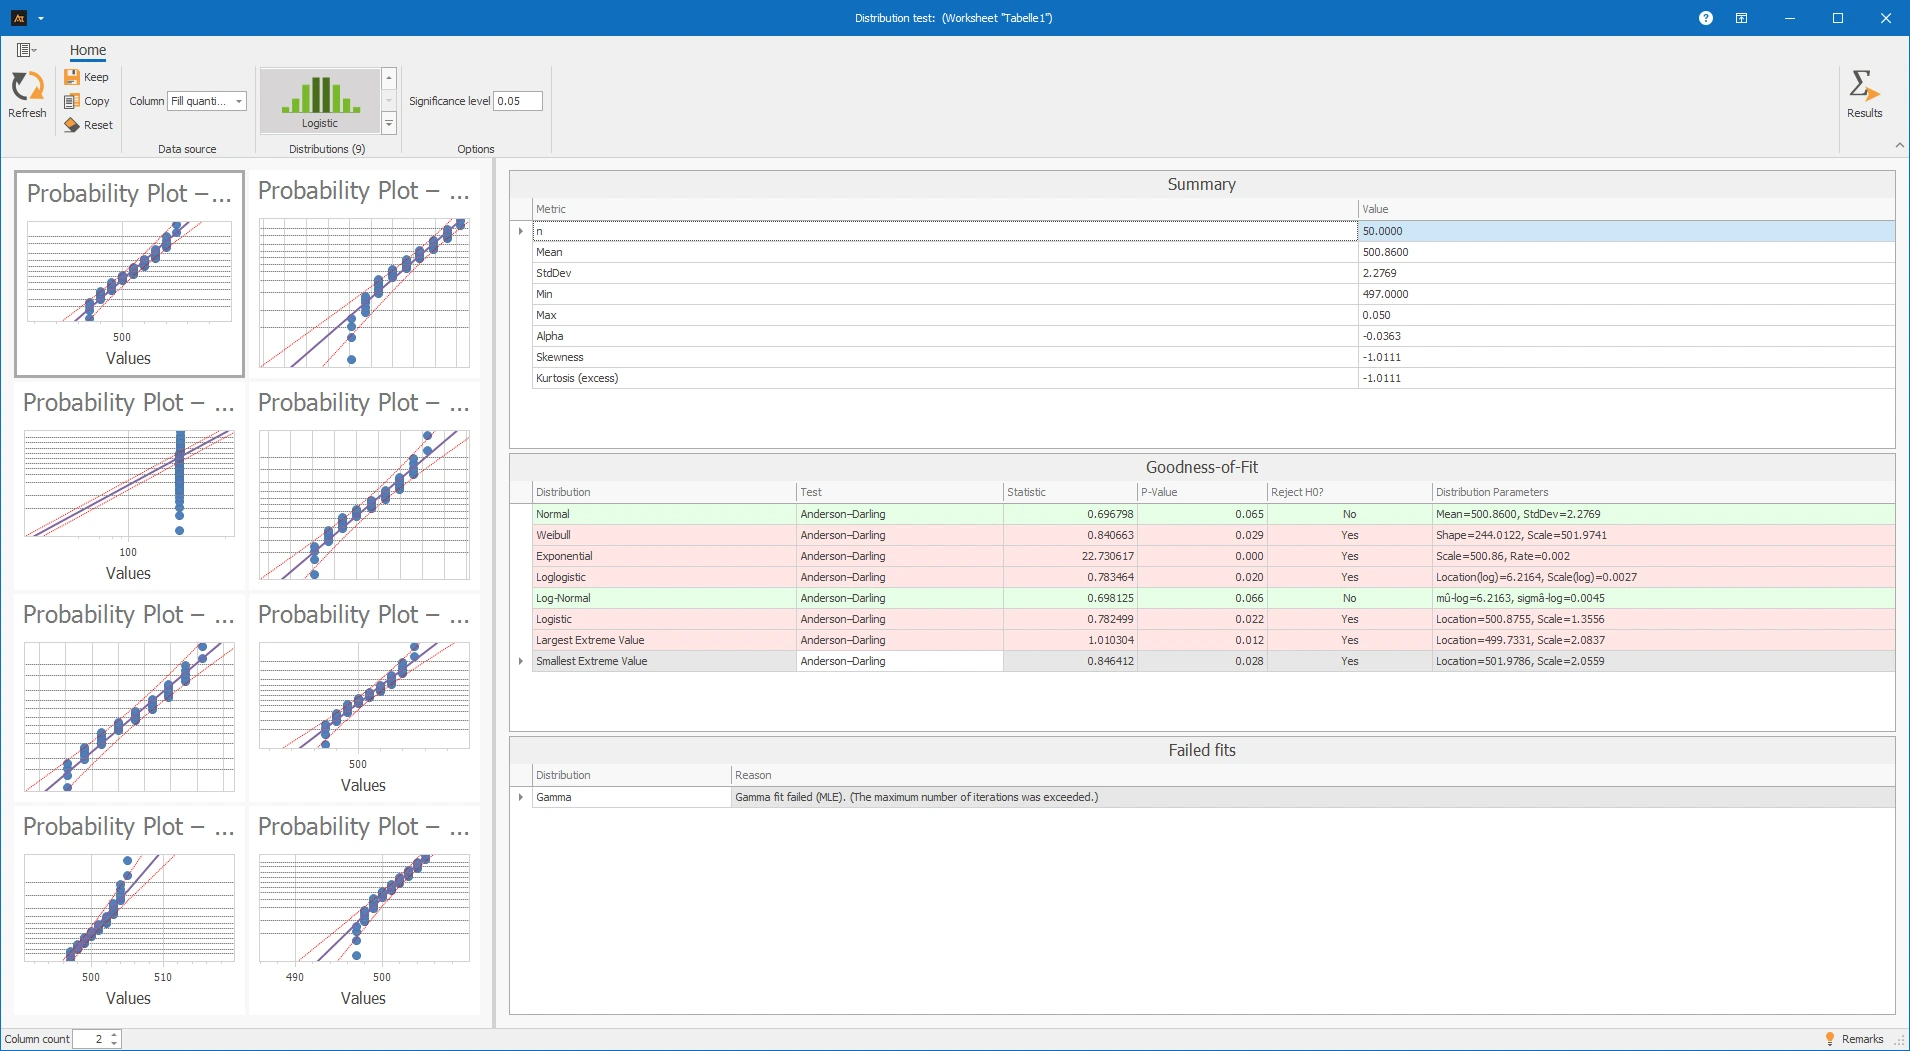
Dans cet exemple, la quantité de remplissage d'une sauce tomate est examinée. Chaque remplissage doit contenir 500 ml. En raison des fluctuations normales du processus, certaines quantités de remplissage sont légèrement en dessous et d'autres légèrement au-dessus de la valeur cible. Étant donné que de telles mesures se dispersent souvent de manière approximativement symétrique autour de la valeur cible, il est vérifié quelle distribution décrit sensiblement les données. À cette fin, les quantités de remplissage sont comparées à plusieurs distributions, y compris la distribution normale.
Interprétation
Les quantités de remplissage ont été comparées à plusieurs distributions. En conséquence, la distribution normale n'est pas rejetée car la p-valeur de 0,065 est supérieure au niveau de signification de 0,05. De plus, dans le graphique de probabilité, les points se situent principalement près de la ligne. Par conséquent, les quantités de remplissage peuvent être approximativement décrites par une distribution normale.
Plusieurs autres distributions, en revanche, sont rejetées car leurs p-valeurs sont inférieures ou égales à 0,05. Celles-ci incluent, entre autres, Weibull, Exponentielle, Log-logistique, Logistique, et la distribution de la plus grande valeur extrême. Il existe des preuves statistiques pour ces distributions qu'elles ne décrivent pas adéquatement les données.
La distribution log-normale n'est pas non plus rejetée. Cependant, en termes de quantités de remplissage, la distribution normale est souvent sensée car il s'agit d'une mesure continue qui se disperse typiquement autour d'une valeur cible.
La distribution gamma n'a pas pu être calculée car l'ajustement a échoué. Par conséquent, elle n'est pas utilisée pour l'interprétation.
Conclusion :
Pour une analyse plus approfondie, la distribution normale peut être utilisée car elle n'est pas statistiquement rejetée et s'adapte bien aux quantités de remplissage.
Délai de Traitement d'une Commande en Réception de Marchandises
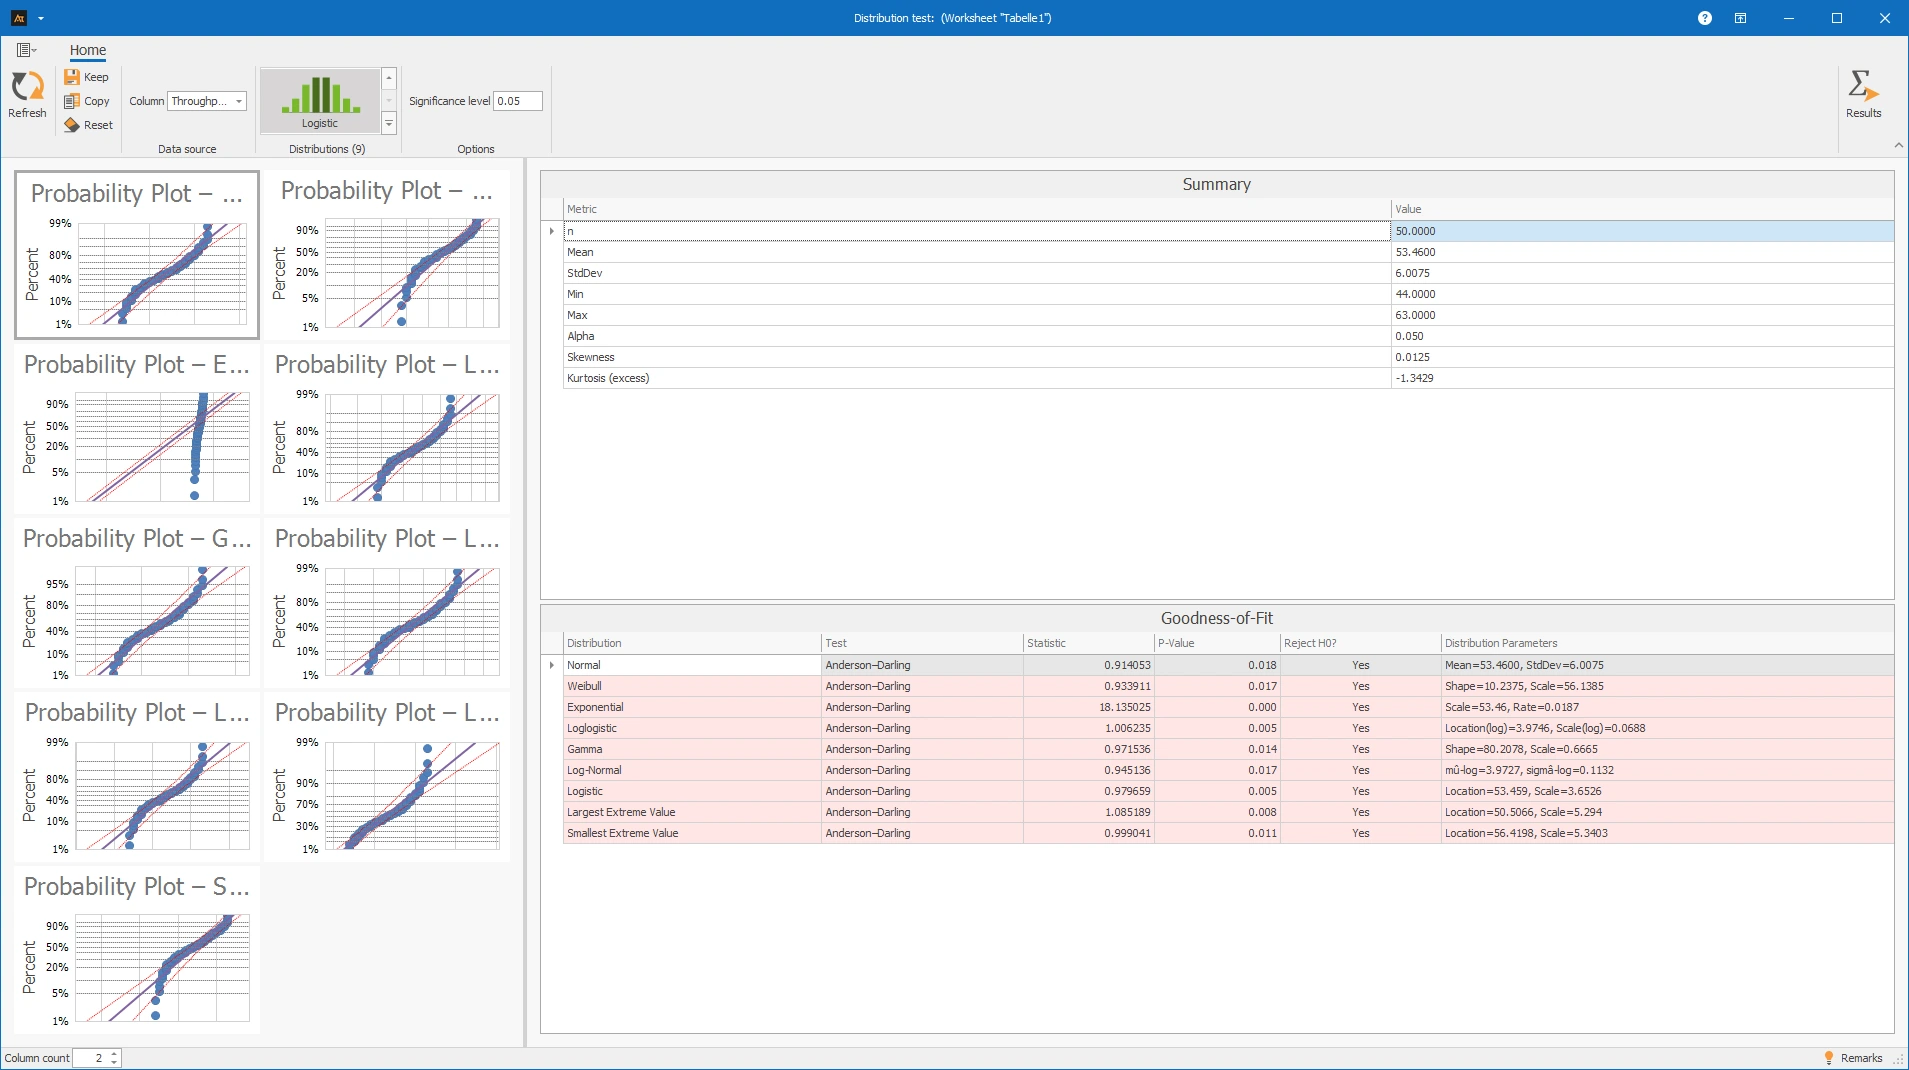
Dans la réception de marchandises, les temps de traitement ont souvent une distribution asymétrique à droite : de nombreuses commandes sont complétées rapidement, mais certains processus prennent beaucoup plus de temps. Par conséquent, une distribution log-normale, gamma, Weibull ou exponentielle peut être plus plausible qu'une distribution normale.
Interprétation
Les délais ont été comparés avec plusieurs distributions. Pour toutes les distributions testées, la valeur p est inférieure à 0,05. Par conséquent, toutes les distributions sont rejetées.
De plus, dans les graphiques de probabilité, les points ne se situent pas suffisamment bien sur les lignes. Par conséquent, les données ne peuvent pas être décrites de manière adéquate par l'une des distributions testées.
Conclusion :
Aucune des distributions testées ne doit être utilisée pour les délais. Il convient de vérifier si différents états de processus ou types de commandes causent la variation.
Temps de réponse du service d'assistance informatique (Spécification : max. 35 minutes (OSG))
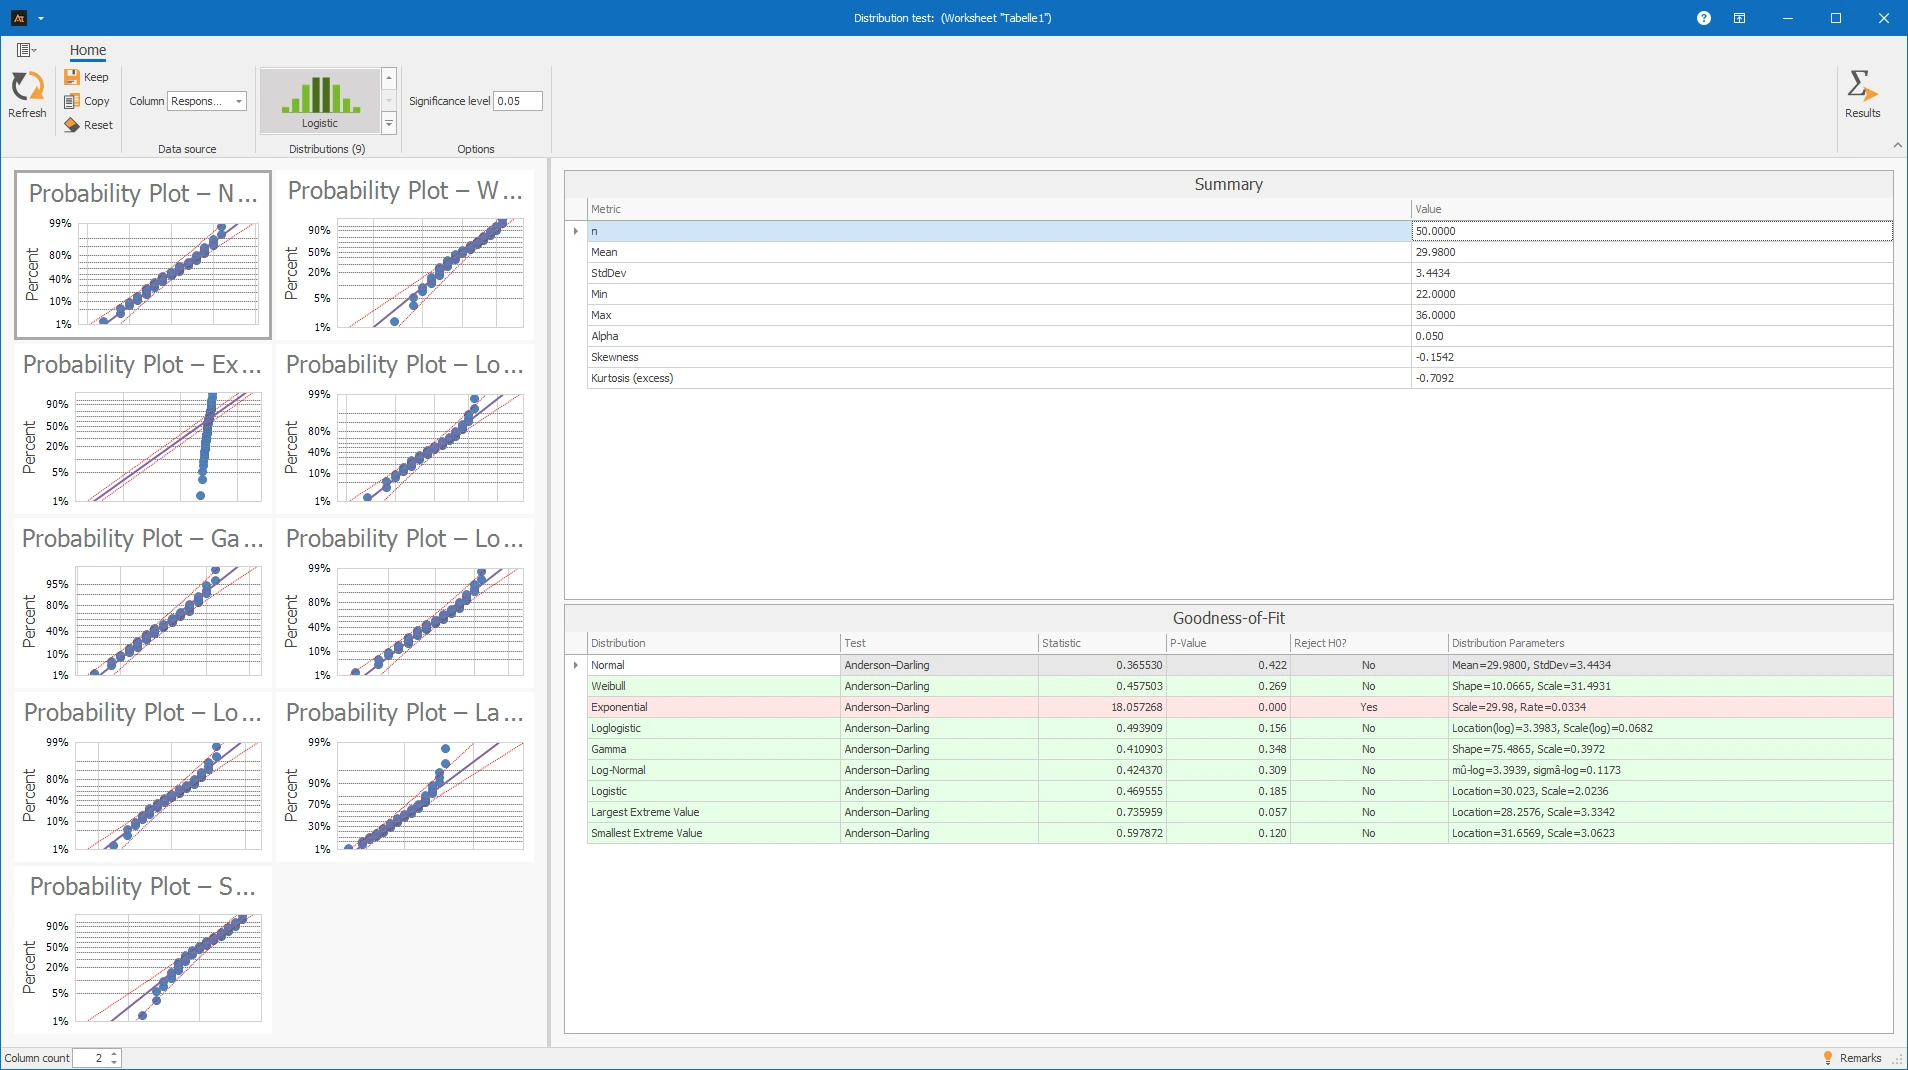
Des demandes simples et complexes sont reçues au service d'assistance informatique. Cela peut entraîner des temps de réponse qui varient autour d'une valeur typique mais qui ont également de longues queues à droite. Best Fit aide à vérifier quelle distribution décrit le mieux ce comportement.
Interprétation
Les temps de réponse ont été comparés à plusieurs distributions. La plupart des distributions testées ne sont pas rejetées car leurs valeurs p sont supérieures à 0,05. Seule la distribution exponentielle est rejetée car la valeur p est inférieure à 0,05.
Pour cette distribution, les données ne s'ajustent pas suffisamment bien. Les graphiques de probabilité montrent également principalement des points proches de la ligne pour les distributions non rejetées.
Conclusion :
Les temps de réponse peuvent être approximativement décrits par plusieurs distributions. Pour une analyse plus approfondie, une distribution appropriée pour le sujet doit être choisie ; la distribution exponentielle ne doit pas être utilisée.
Durée de vie des roulements à billes
Pour un nouveau type de machine, les roulements à billes sont testés en fonctionnement continu. Chaque roulement reste sur le banc d'essai jusqu'à ce qu'il ne soit plus fonctionnel. Ces données de durée de vie sont généralement positives et souvent non distribuées normalement.
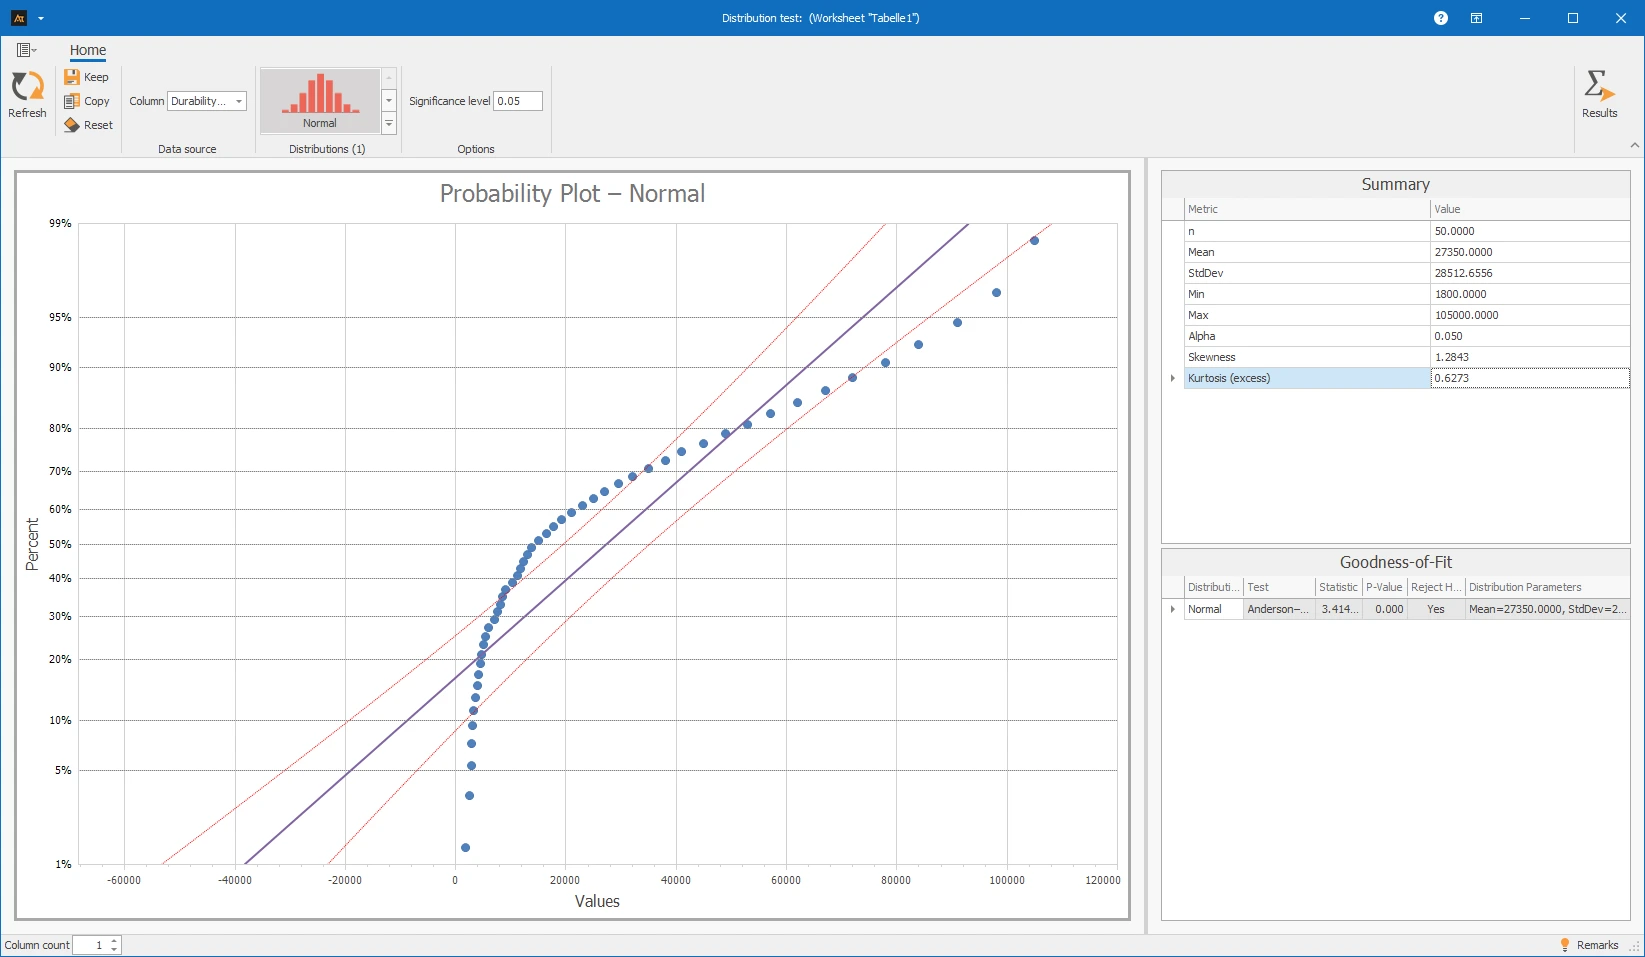
Dans le graphique de probabilité de la distribution normale, les points peuvent s'écarter significativement de la ligne. Cela va à l'encontre d'une distribution normale des durées de vie.
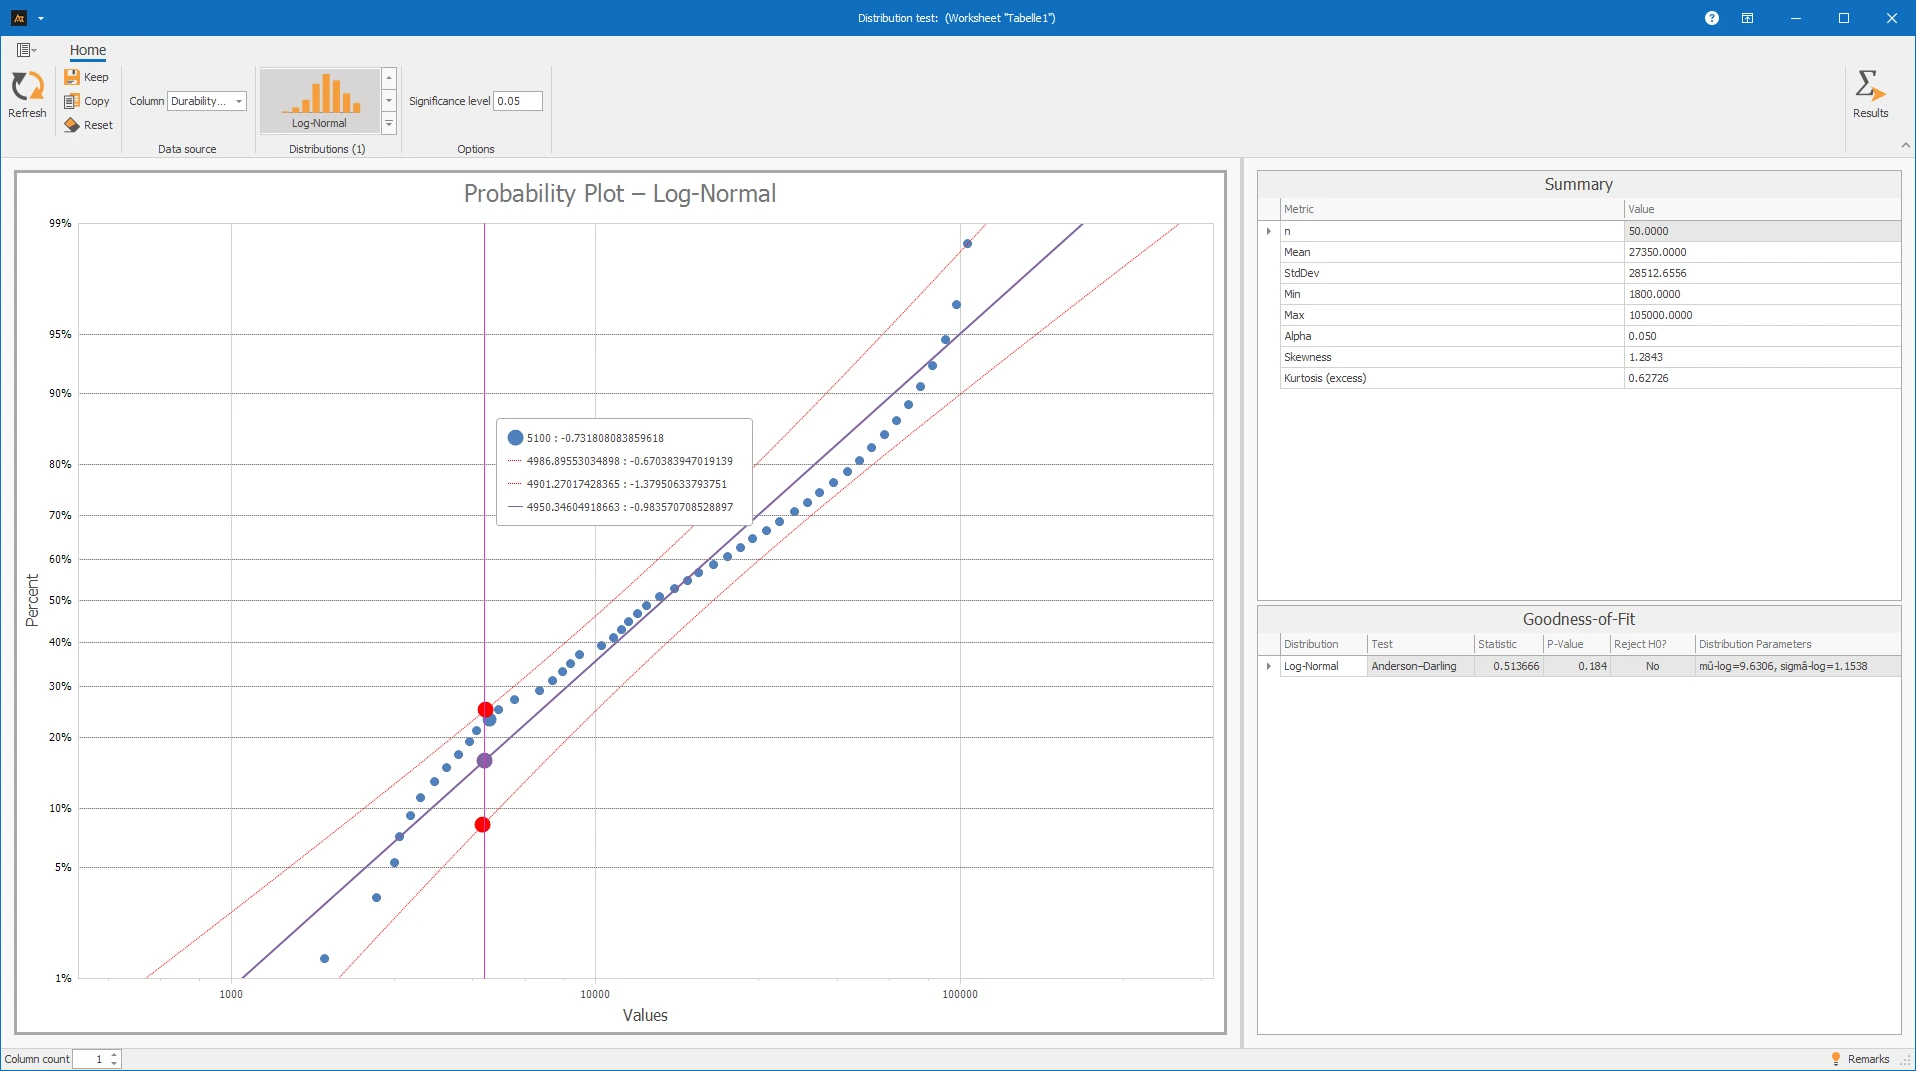
La durée de vie des roulements à billes a été testée avec la distribution lognormale. La valeur p est 0,190 et est donc supérieure à 0,05. La distribution lognormale n'est donc pas rejetée.
Aussi dans le graphique de probabilité, les points sont majoritairement proches de la ligne. Les données de durée de vie peuvent donc être approximativement décrites par une distribution lognormale.
Données continues : Données collectées avec un instrument de mesure qui peuvent avoir des unités et des décimales.
Distribution : Modèle mathématique qui décrit comment les mesures se répartissent généralement.
Test d'Anderson-Darling : Test statistique pour vérifier si les données correspondent à une distribution sélectionnée.
p-value : Indicateur pour évaluer le résultat du test. Plus la p-value est petite, plus les données s'opposent à la distribution testée.
Statistique A² : Mesure de la déviation des données par rapport à la distribution testée. Des valeurs plus petites tendent à indiquer moins de déviation par rapport à la distribution testée.
H0 : Hypothèse nulle du test. Elle stipule : Les données suivent la distribution testée.
n = Taille de l'échantillon : Nombre de mesures valides dans l'échantillon.
Moyenne : Moyenne de toutes les mesures. Elle décrit la position centrale des données.
Écart-type : Mesure de la dispersion des mesures autour de la moyenne. Un petit écart-type signifie peu de dispersion, un grand écart-type signifie une plus grande dispersion.
Minimum : Plus petite mesure dans l'échantillon considéré.
Maximum : Plus grande mesure dans l'échantillon considéré.
Alpha (α) : Niveau de signification fixé et seuil de décision pour la p-value. Souvent α = 0,05 est utilisé. Si la p-value est inférieure à Alpha, l'hypothèse nulle H0 est rejetée.
Asymétrie : Indicateur de la symétrie d'une distribution. Une valeur proche de 0 indique une distribution approximativement symétrique. Des valeurs positives ou négatives indiquent une expression plus forte de la distribution vers la droite ou la gauche, respectivement.
Kurtosis : Indicateur qui décrit la forme d'une distribution, en particulier comment les mesures se concentrent fortement au centre et dans les queues. Il peut fournir des indices sur le fait qu'une distribution est plus pointue ou aplatie par rapport à une distribution normale.
La vérification de la distribution calcule les paramètres correspondants, la statistique de test et la valeur p pour les distributions sélectionnées. Les fonctions de la bibliothèque Numerics.NET sont utilisées pour calculer la statistique de test.