


La puissance indique la probabilité avec laquelle un test statistique détecte un effet réellement existant.
Elle est utilisée pour évaluer si la base de données existante est suffisante pour détecter de manière fiable les différences, variances ou changements de taux pertinents.
Contrairement au test d'hypothèse classique, la puissance ne se concentre pas sur la décision entre l'hypothèse alternative et l'hypothèse nulle, mais plutôt sur la puissance du test dans les conditions données :
- haute puissance → un effet pertinent est détecté avec une haute probabilité
- faible puissance → un effet existant peut rester non détecté malgré l'investigation
Important : Lors du calcul de la puissance, les données résumées dans AlphadiTab sont saisies. Par conséquent, les données brutes ne sont pas requises, mais des métriques telles que la taille de l'échantillon, la moyenne, l'écart type ou le nombre d'événements.
Dans le développement de produits, une nouvelle formulation de sauce tomate est en cours de test. L'objectif est de déterminer si la viscosité de la nouvelle formulation diffère en moyenne de la formulation précédente.
Pour cela, des mesures de viscosité sont effectuées sur des échantillons de l'ancienne formulation et de la nouvelle formulation.
À l'aide du test t (2 échantillons), il a été vérifié si la différence observée des moyennes est statistiquement significative ou peut être expliquée par une variation aléatoire.
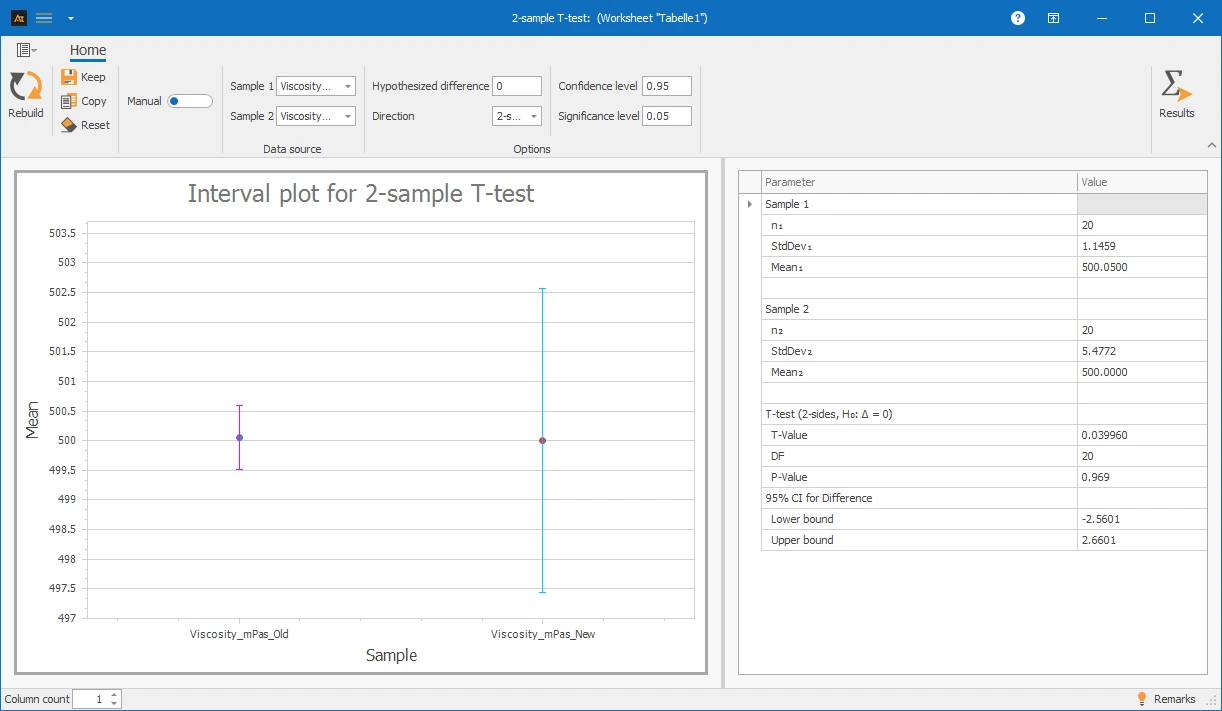
La valeur p calculée est significativement au-dessus du niveau de signification de 0,05, donc l'hypothèse nulle est retenue. Sur la base de ce test, aucune différence significative entre la viscosité moyenne de l'ancienne et de la nouvelle formulation n'est trouvée. Avec le calcul de la puissance, nous voulons maintenant évaluer à quel point une différence réelle peut être détectée de manière fiable.
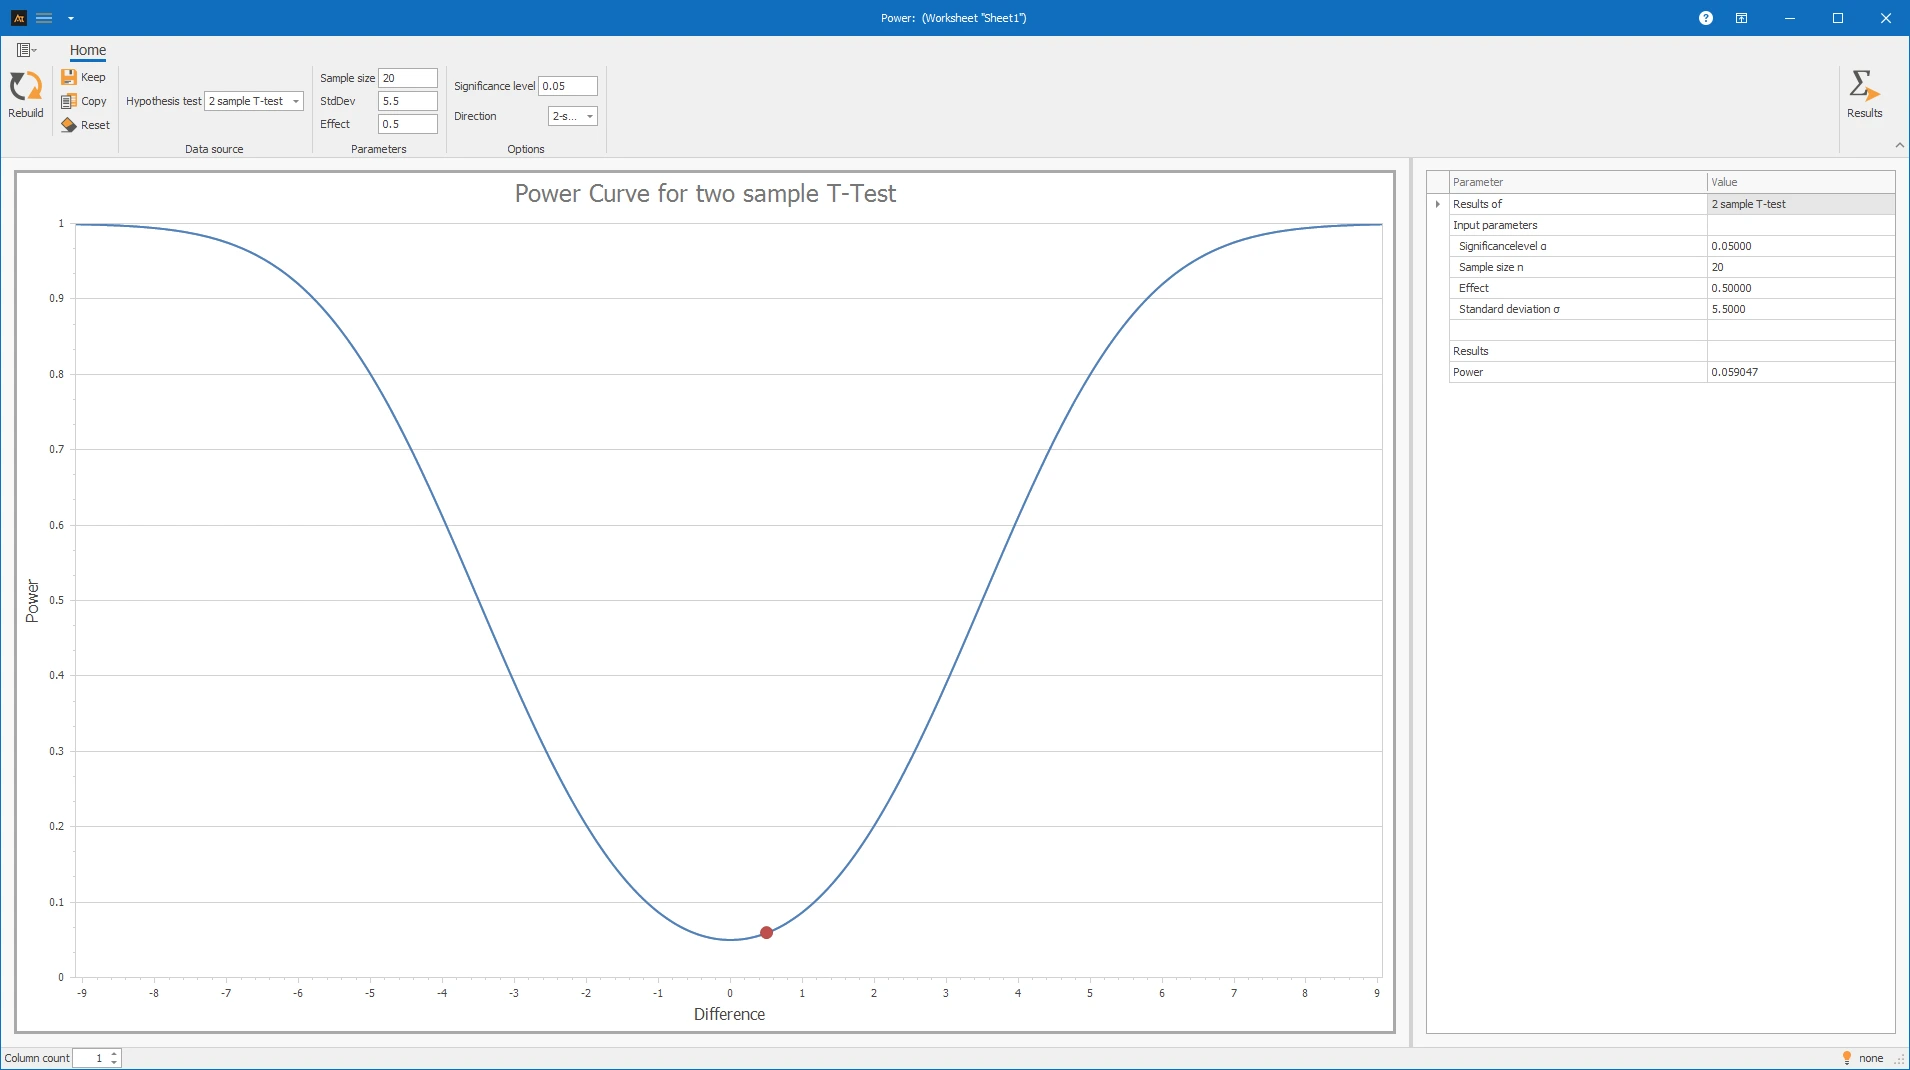
Pour cela, nous devons déterminer quelle différence de viscosité moyenne nous voulons détecter. L'essentiel est de savoir quelle différence est pratiquement pertinente. Dans cet exemple, une différence de moyennes de 0,5 MPa doit être détectée. Cette différence correspond à l'effet. Nous pouvons prendre la taille de l'échantillon et l'écart-type du test effectué. L'écart-type a été arrondi à 5,5 ; le moins favorable des deux écarts-types est utilisé ici.
Interprétation des résultats :
La puissance est de 0,059. Cela correspond à une erreur β de 94,1 %. Dans ces conditions, le test ne peut pas détecter de manière fiable une différence réelle de 0,5 MPa. D'après la courbe de puissance, il est évident qu'un effet d'environ 5 MPa peut être détecté avec ce test avec environ 80 % de puissance. L'erreur β serait alors d'environ 20 %.
Explications du graphique :
- La courbe montre la puissance pour différents effets (différences)
- Le point représente l'entrée actuelle.
Les considérations et étapes suivantes sont nécessaires pour calculer la puissance pour divers tests statistiques.
Préparation
- Sélectionnez le test approprié (par exemple, test t, test F, test de proportions ou ANOVA).
- Déterminez quelle différence, quel rapport de variance ou quel changement de proportions est pratiquement pertinent.
- Fixez le niveau de signification (généralement α = 0,05).
- Déterminez la puissance souhaitée ou l'erreur bêta.
- Déterminez la direction de l'hypothèse (bilatérale, supérieure ou inférieure), si la méthode prend en charge ce choix.
 Utilisation dans AlphadiTab
- Dans la Phase d'analyse, sélectionnez l'outil Puissance.
- Sélectionnez le type de test approprié, par exemple, test t, test F, test de proportions ou ANOVA.
- Saisissez les métriques résumées dans les champs de saisie.
- Réalisez l'analyse en “Créer Nouveau”.
Interprétation
- Vérifiez si la puissance calculée est suffisamment élevée.
- Dans la pratique, une puissance de 80 % ou 90 % est souvent utilisée comme ligne directrice.
- Si la puissance est faible, vérifiez si une taille d'échantillon plus grande ou un design d'étude plus ciblé est nécessaire.
Important : La puissance n'est pas une confirmation rétrospective d'une valeur p. Elle décrit la probabilité qu'un test détecte un effet supposé avec les entrées choisies.
Types de tests
- T-Test : Sensibilité pour comparer les moyennes.
- F-Test : Sensibilité pour comparer les variances ou dispersions.
- Test de proportions : Sensibilité pour comparer les ratios ou événements binaires.
- ANOVA : Sensibilité pour comparer les moyennes de deux groupes ou plus.
- Test sur les variances : Sensibilité pour comparer les variances ou dispersions pour deux échantillons ou plus, éventuellement non paramétrique.
Dans les tests d'hypothèse avec 2 échantillons, la direction pour l'hypothèse alternative peut être sélectionnée.
Choisissez bilatérale si une différence doit être détectée sans spécifier de direction particulière.
- Ce paramètre est utile lorsque des valeurs plus élevées et plus basses seraient pertinentes.
Exemple :
La durée moyenne de livraison est-elle différente entre deux processus ?
Choisissez plus grand si un effet n'est pertinent que dans la direction des valeurs plus élevées.
- Ce paramètre est utile, par exemple, s'il doit être testé si un taux de réussite augmente.
Exemple :
Le taux de vente est-il plus élevé avec une nouvelle approche de vente qu'avant ?
Choisissez plus petit si un effet n'est pertinent que dans la direction des valeurs plus basses.
- Ce paramètre est utile, par exemple, s'il doit être testé si un temps de traitement ou un taux de défaut diminue.
Exemple :
Le temps de traitement moyen après une optimisation est-il plus bas qu'avant ?
Quantité de remplissage sauce tomate – Machine A vs. Machine B
Dans la production, plusieurs machines de remplissage sont utilisées. Il convient d'évaluer si les données disponibles sont suffisantes pour détecter de manière fiable une différence entre la Machine A et la Machine B.
T-Test :
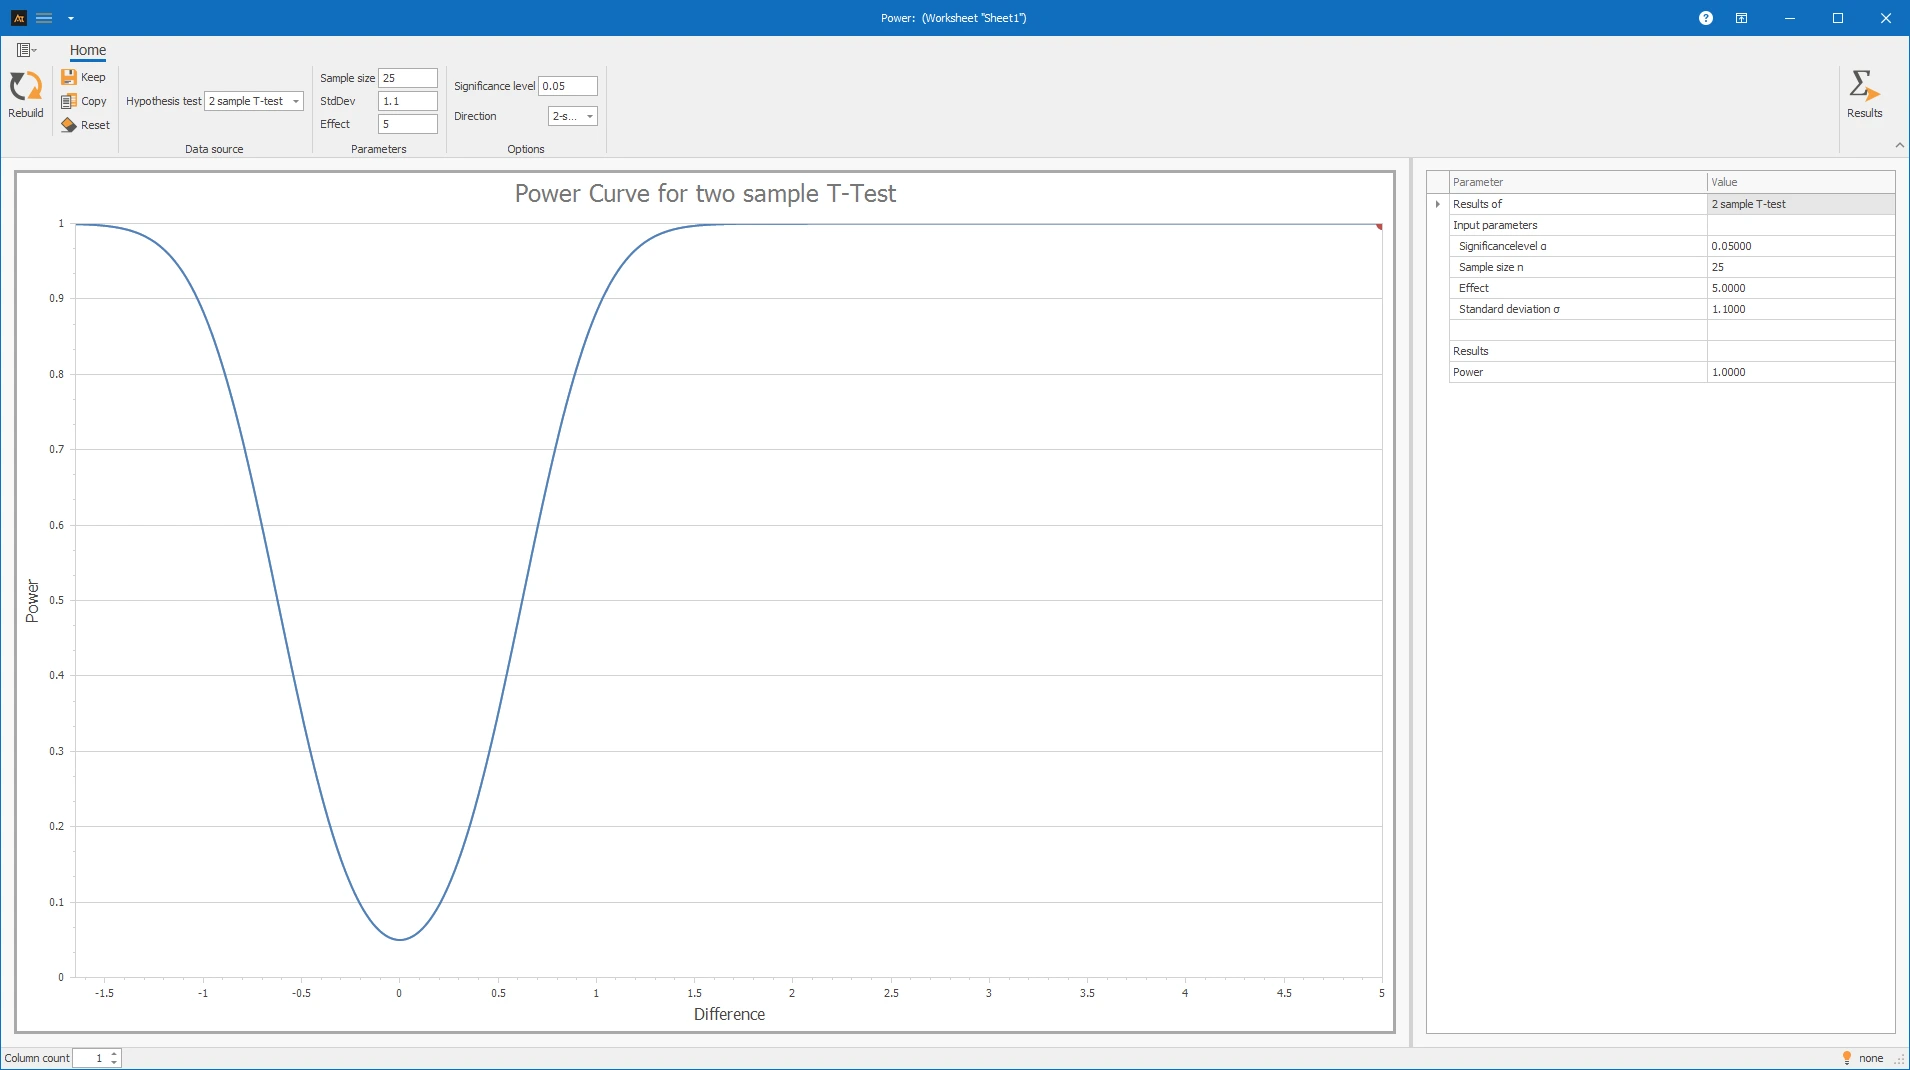
Différences de moyennes : La puissance est-elle suffisante pour détecter une différence de 5 ml dans la quantité moyenne de remplissage ?
Interprétation
Pour le t-test, la puissance montre la probabilité avec laquelle une différence dans la quantité moyenne de remplissage est détectée. La puissance est de 1.000. Ainsi, le test peut détecter la différence supposée avec une très haute probabilité sous les entrées choisies. L'erreur β est donc proche de 0%.
F-Test :
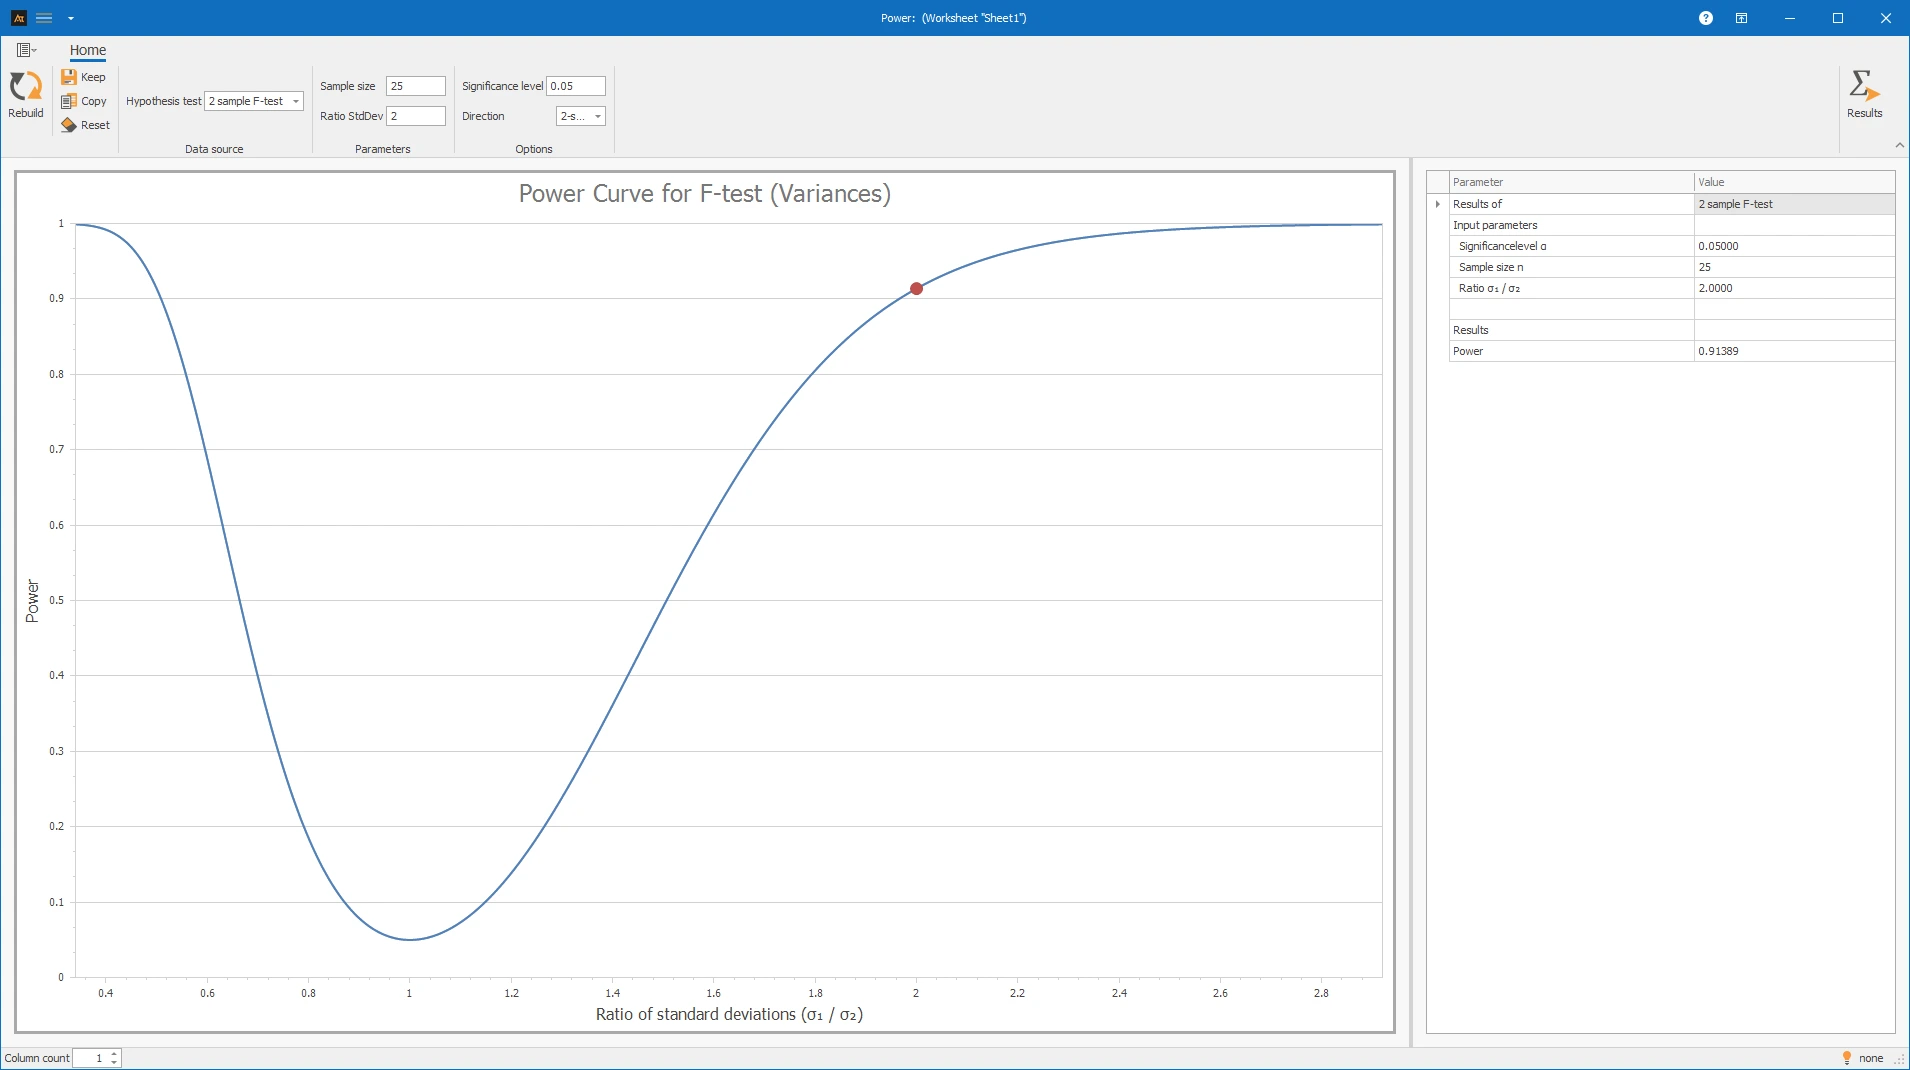
Différences de variances : La puissance est-elle suffisante pour détecter un doublement de la variance de la quantité de remplissage ?
Interprétation
Pour le F-test, la puissance montre la probabilité avec laquelle une différence de variance est détectée. La puissance est de 0.91389. Un doublement de l'écart-type peut donc être détecté avec une puissance d'environ 91,4%. L'erreur β est d'environ 8,6%.
Temps de réponse du service d'assistance informatique vs. ANOVA de localisation
Dans le service d'assistance informatique, les tickets sont traités à plusieurs endroits. Les temps de réponse sont régulièrement évalués pour identifier les différences de qualité de service.
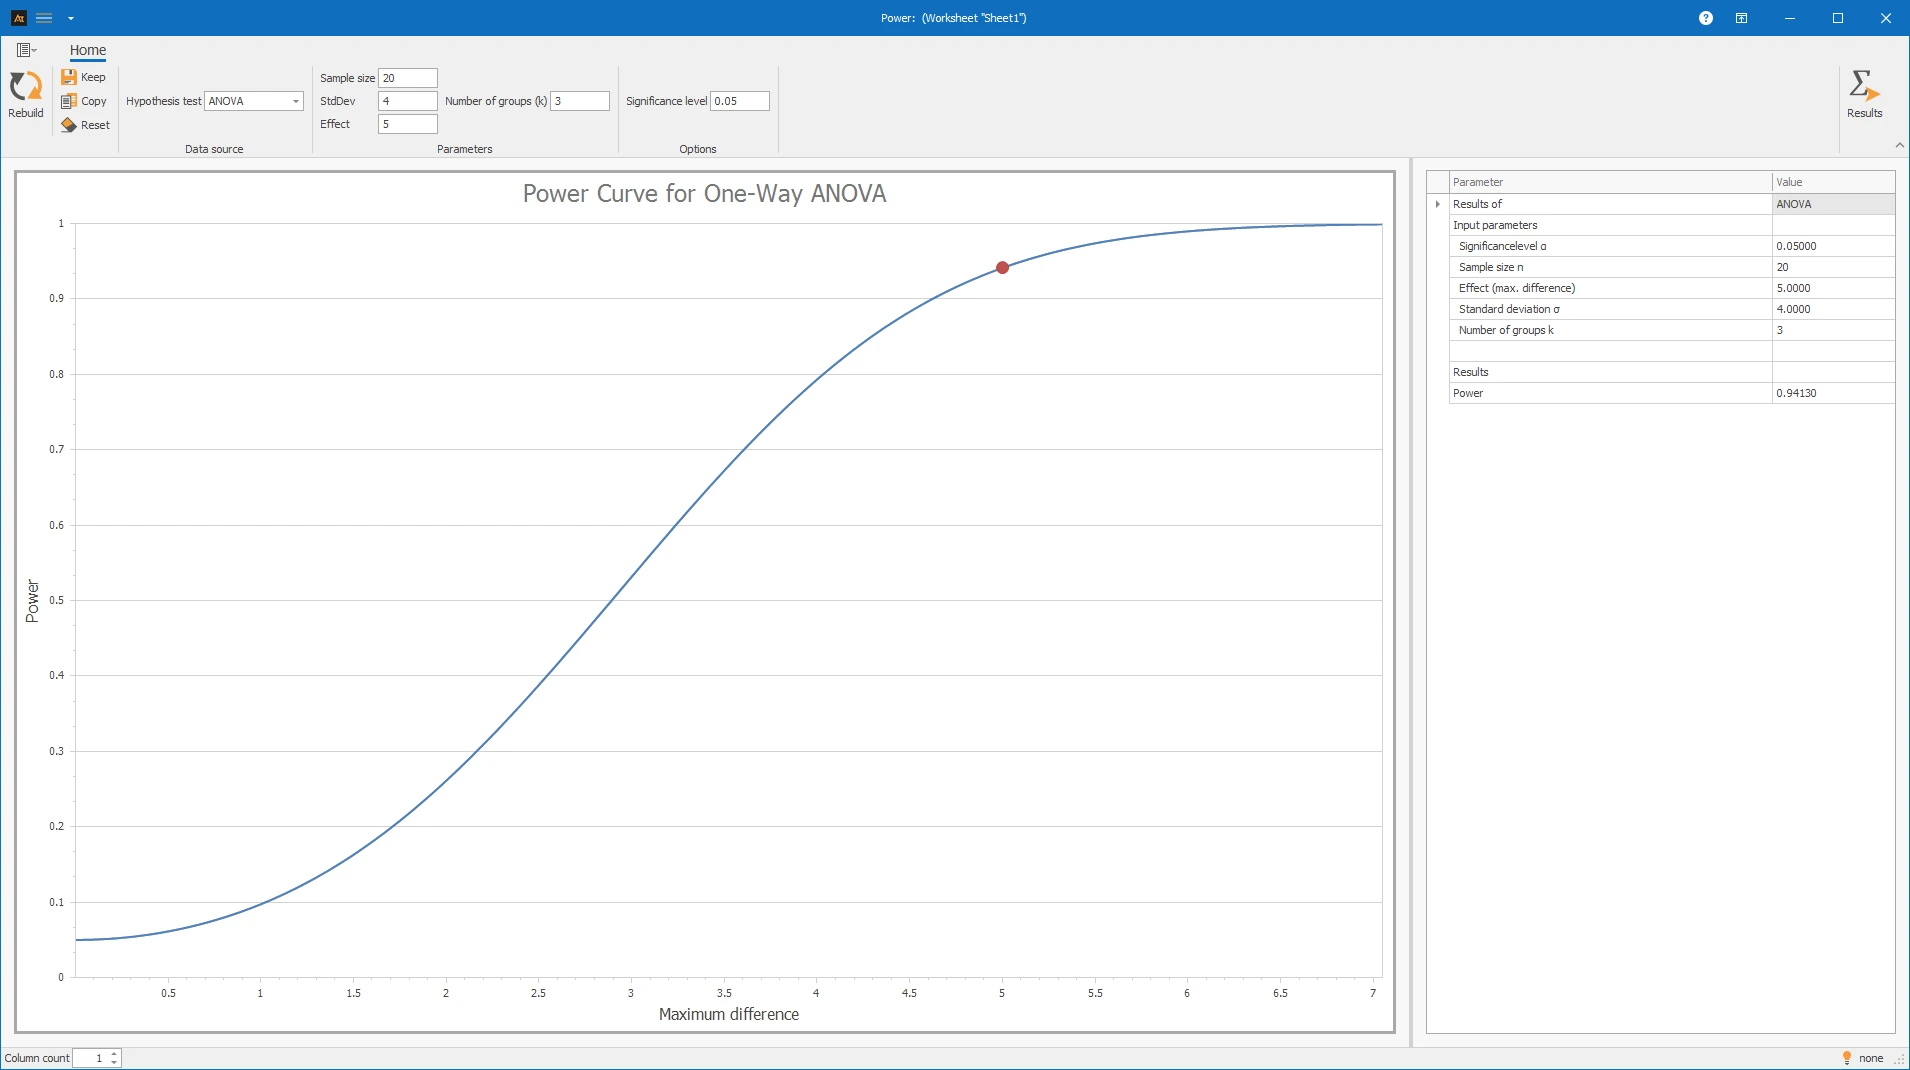
Dans l'exemple des tickets informatiques, des données de trois emplacements sont disponibles. La sensibilité est utilisée pour évaluer si une différence de 5 minutes dans le temps de réponse serait détectée avec l'ANOVA.
Interprétation des résultats
La configuration du test est adaptée pour détecter une différence de 5 minutes avec trois niveaux et un écart type de 4. La sensibilité est suffisamment élevée ; l'erreur β est correspondamment faible.
Test des proportions - Taux de perte par approche de vente
Dans les ventes, deux approches de vente sont comparées. Il convient d'évaluer si les chiffres d'offres existants sont suffisants pour détecter de manière fiable un changement pertinent du taux de perte. Le test des proportions a montré que les méthodes de vente ne diffèrent pas significativement.
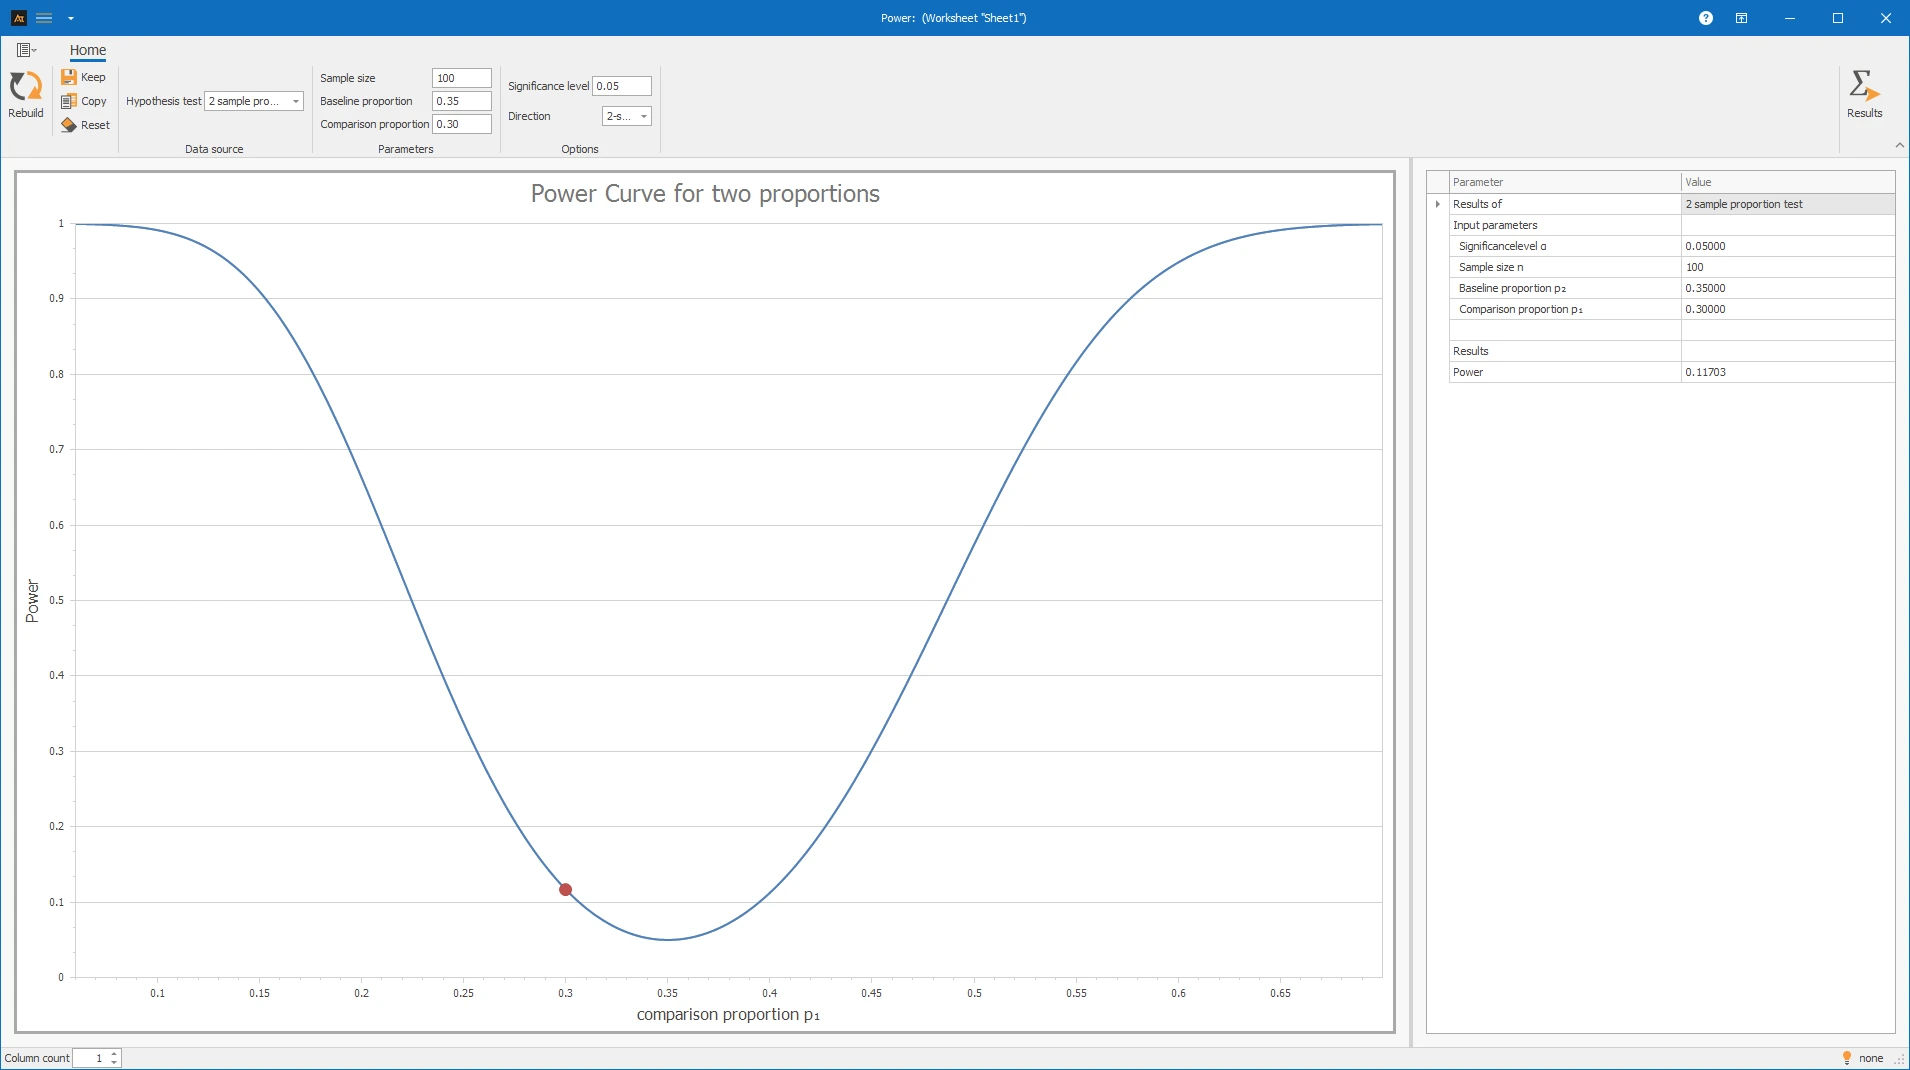
Maintenant, en utilisant le calcul de puissance, il convient de déterminer si un changement de 35% à 30% serait détecté.
Interprétation
La puissance indique la probabilité avec laquelle le test détecte un changement pertinent du taux de perte. La puissance est faible à 0,11703. Cela correspond à une erreur β d'environ 88,3%. Le fait qu'aucune différence significative n'ait pu être détectée avec le test des proportions peut être dû au fait que trop peu d'offres ont été évaluées.
Délai de livraison après le centre logistique
Dans le département logistique, les commandes des clients sont préparées et expédiées. Pour augmenter l'efficacité, de nouveaux chariots élévateurs ont été introduits.
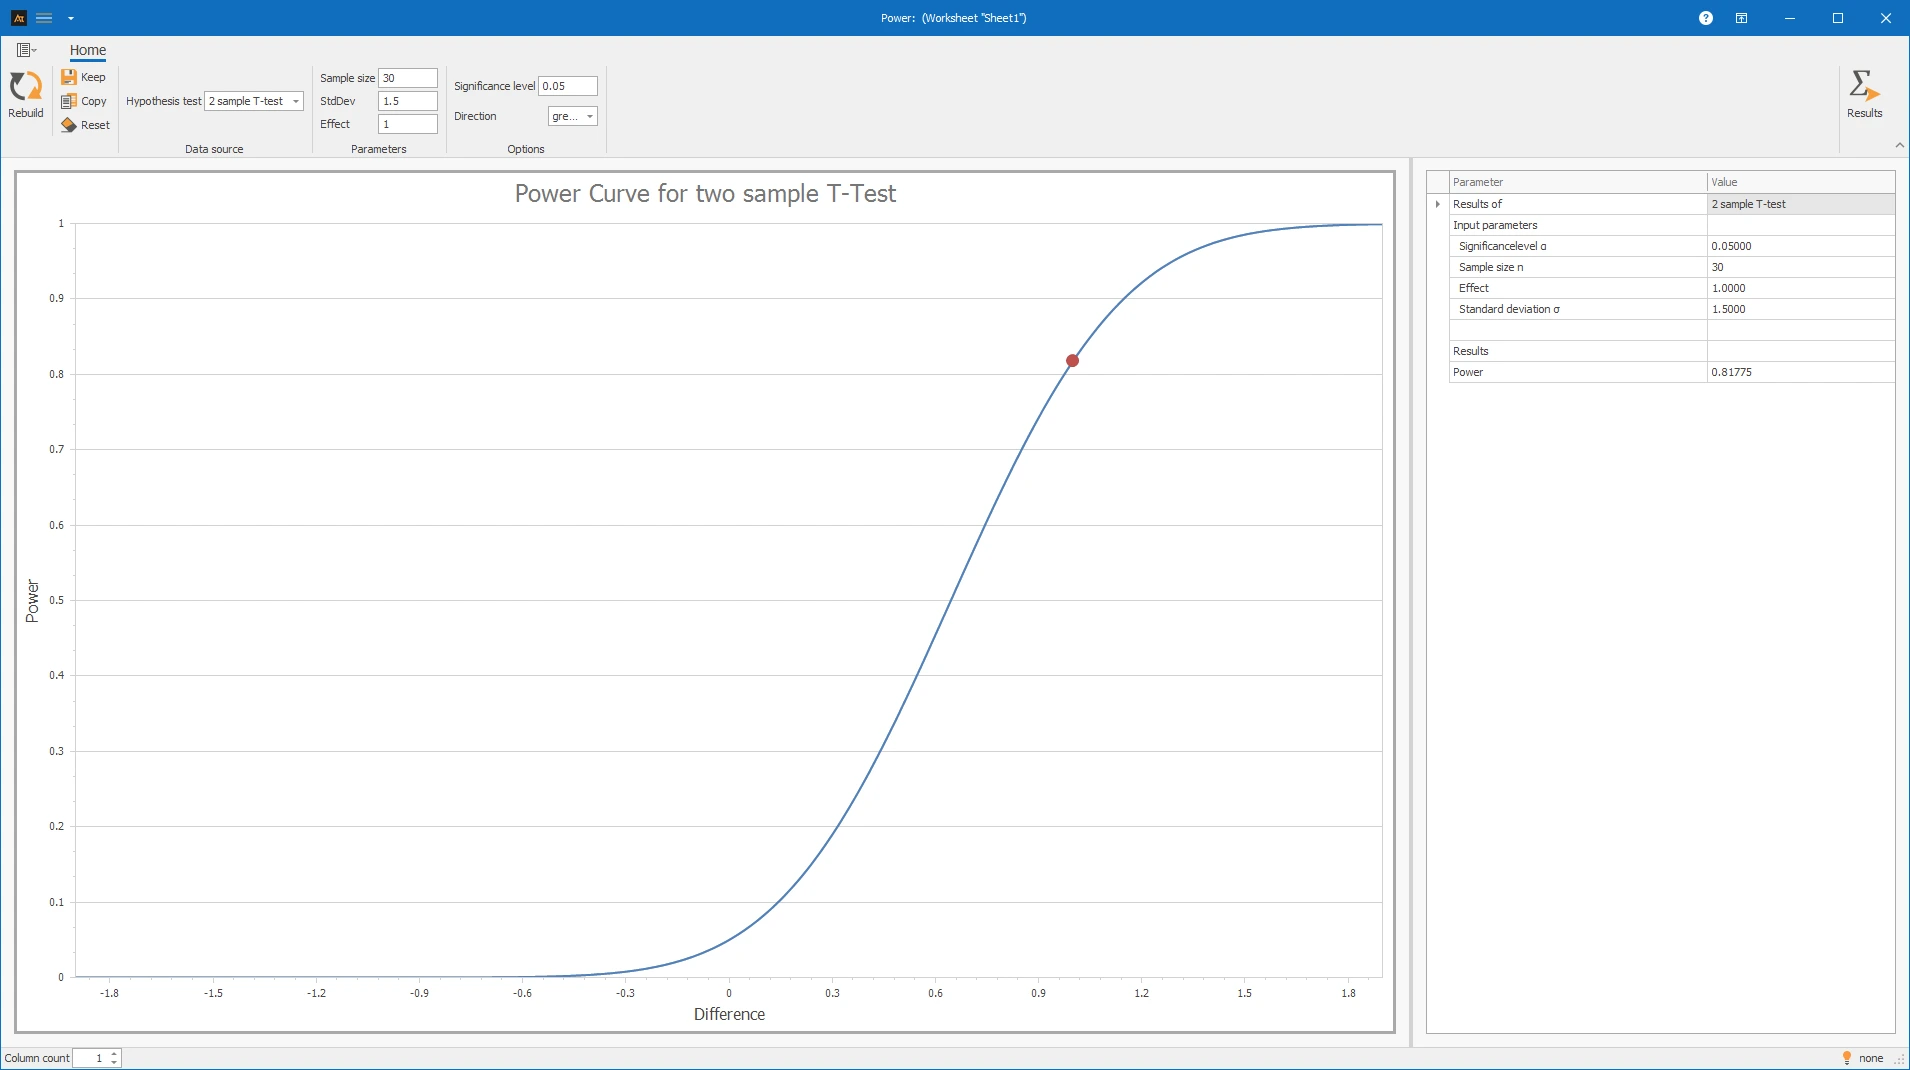
Il convient d'examiner si une amélioration du délai de livraison d'un jour peut être détectée avec un test t unilatéral. La variation du délai de livraison est estimée à 2,5 jours. 30 mesures doivent être prises.
Interprétation
La puissance est de 81,775 %. Ainsi, une différence d'un jour peut être détectée avec environ 81,8 % de puissance. L'erreur β est d'environ 18,2 %. Une puissance d'au moins 80 % est souvent utilisée comme ligne directrice. Néanmoins, il convient de déterminer à l'avance quelle puissance minimale doit être atteinte.
Comparaison des fournisseurs
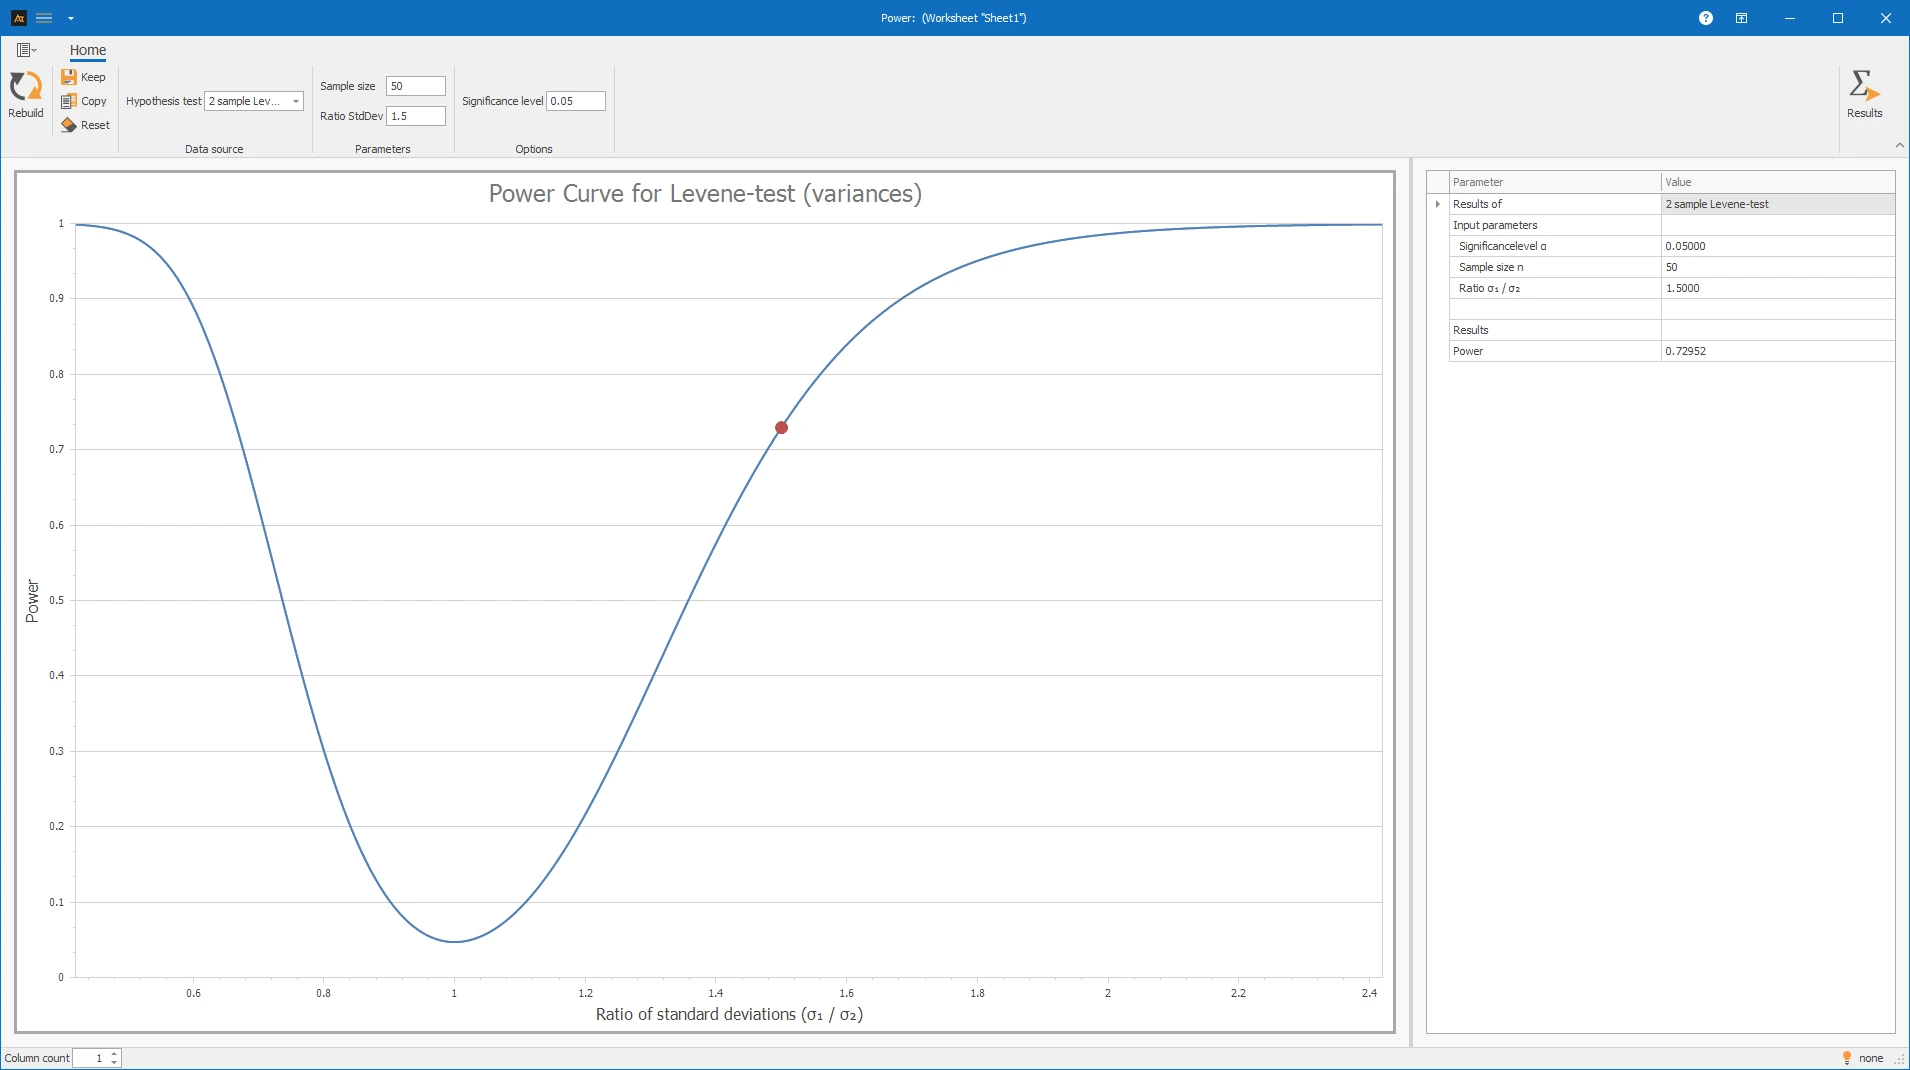
Dans l'achat, les composants sont achetés auprès de plusieurs fournisseurs. Il convient d'évaluer si les tests existants sont suffisants pour détecter une différence de 1,5 fois dans l'écart type entre les fournisseurs. Il y a 50 ensembles de données par fournisseur.
Interprétation
La sensibilité aide à évaluer si le nombre actuel de livraisons est suffisant pour détecter de manière fiable les différences pertinentes entre les fournisseurs. Avec une faible sensibilité, l'erreur β serait élevée ; une différence réellement existante pourrait alors rester non détectée.
Déviation de prévision
Dans la planification de la production, des prévisions de la demande sont créées pour différentes périodes de planification. Pour évaluer la qualité de la prévision, la déviation de prévision est calculée.
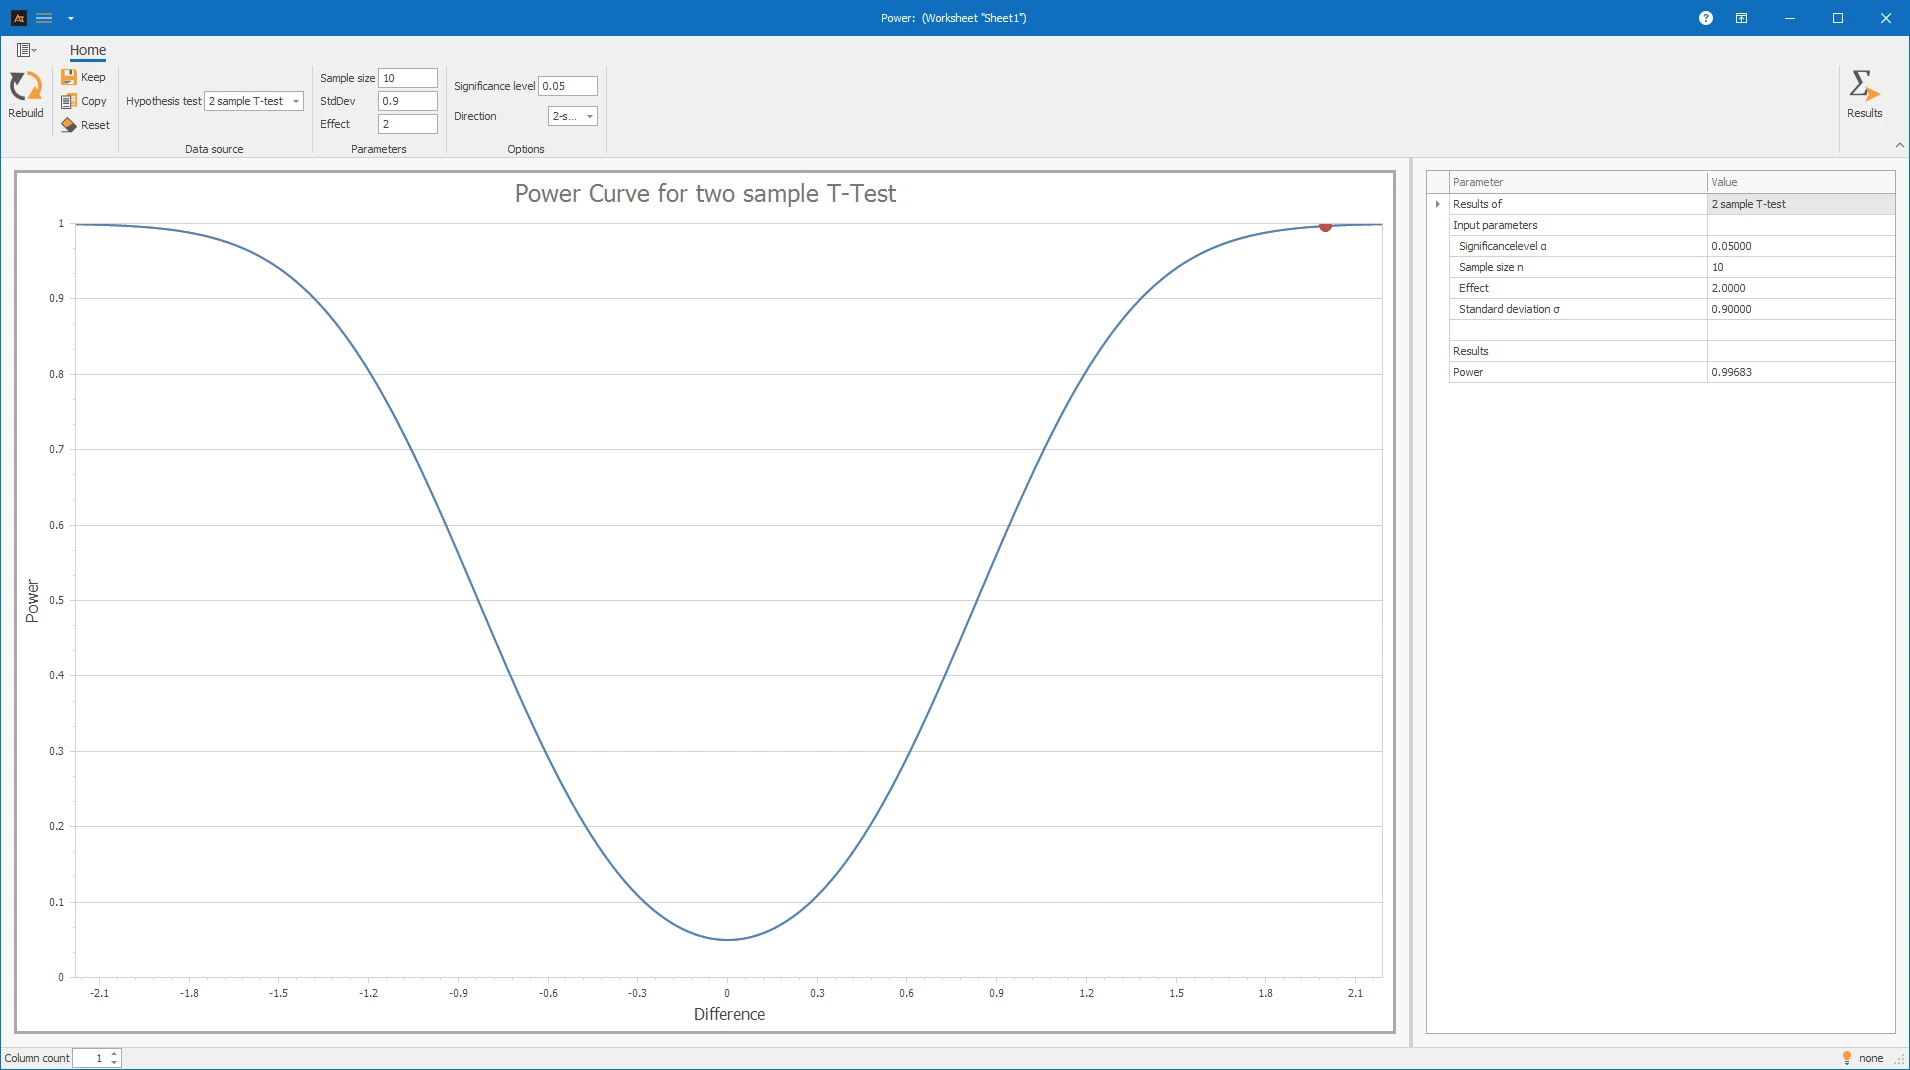
Il convient d'évaluer si l'échantillon existant est suffisant pour détecter les différences entre les horizons de planification à court et à long terme avec un test t. Une différence de 2% devrait être détectée. L'écart type est connu à partir d'analyses précédentes et est de 0,9%. Pour chaque horizon, 10 prévisions devraient être créées et comparées.
Interprétation
Avec le test t, une différence de 2% peut être détectée de manière fiable si l'écart type est de 0,9%. La puissance est de 99,68%. L'erreur β est donc d'environ 0,32%.
Puissance discriminatoire / Puissance : Probabilité avec laquelle un test détecte un effet réellement existant.
Effet : Différence pratiquement pertinente, par exemple, différence de moyenne, rapport de variance ou changement de cotes.
n = Taille de l'échantillon : Nombre d'observations, de parties, d'offres ou d'essais au sein d'un groupe.
α = Niveau de signification : Probabilité d'erreur prédéfinie avec laquelle l'hypothèse nulle est rejetée à tort.
β = Erreur de type II : Probabilité de ne pas détecter un effet réellement existant.
Puissance = 1 - β : Contre-probabilité de l'erreur de type II.
x̄ = Moyenne de l'échantillon : Valeur moyenne des données de mesure collectées.
s = Écart-type de l'échantillon : Mesure de la dispersion des données autour de la moyenne.
p̂ = Proportion de l'échantillon : Proportion d'événements dans un échantillon ; calculée comme événements / nombre d'essais.
Événement : Le cas d'intérêt dans une analyse de proportion, par exemple, fuite, perdu, à l'heure ou réussi.
Facteur : Variable d'influence catégorielle dans l'ANOVA, par exemple, centre logistique, fournisseur ou formulation.
Groupes / Niveaux : Manifestations du facteur, par exemple, Centre A, Centre B et Centre C.
Bilatéral : Il est vérifié si une différence peut être détectée dans les deux directions.
Plus grand : Il est vérifié si un effet peut être détecté dans le sens des valeurs plus grandes.
Plus petit : Il est vérifié si un effet peut être détecté dans le sens des valeurs plus petites.
Les formules suivantes décrivent la logique de calcul du pouvoir de discrimination utilisé dans l'outil. Les fonctions de distribution et de quantile requises ne sont pas implémentées manuellement mais sont évaluées à l'aide des bibliothèques statistiques CenterSpace NMath et – comme spécifié – Numerics.NET.
Principe de base
Le pouvoir de discrimination, également appelé puissance, décrit la probabilité qu'un test statistique détecte un effet réellement existant.
Un pouvoir de discrimination élevé signifie qu'un effet existant est détecté avec une probabilité élevée. Un pouvoir de discrimination faible signifie que l'erreur β est correspondamment plus grande.
Test t pour deux échantillons
Dans le test t pour deux échantillons, la probabilité de détecter une différence supposée entre deux moyennes est calculée. L'outil suppose des échantillons de taille égale.
Le paramètre de non-centralité est :
Les degrés de liberté sont :
Pour le calcul, les quantiles de la distribution t centrale et la fonction de distribution de la distribution t non centrale sont utilisés. Ces fonctions sont évaluées à l'aide de CenterSpace NMath. Ft,v,λ(x) désigne la fonction de distribution de la distribution t non centrale.
Puissance = 1 − Ft,v,λ(t1−α,v)
Puissance = Ft,v,λ(tα,v)
Puissance = Ft,v,λ(tα/2,v) + 1 − Ft,v,λ(t1−α/2,v)
Test F pour deux variances
Dans le test F, le pouvoir de discrimination pour une différence supposée entre les variances de deux groupes est déterminé. L'outil utilise le rapport des écarts-types comme entrée :
Pour le calcul, le rapport des variances est formé :
Pour des échantillons de taille égale, les degrés de liberté suivants s'appliquent :
Les quantiles et les fonctions de distribution requis de la distribution F sont évalués à l'aide de CenterSpace NMath. Fk1,k2(x) désigne la fonction de distribution de la distribution F.
Puissance = 1 − Fk1,k2 (F1−α,k1,k2 / ρ²)
Puissance = Fk1,k2 (Fα,k1,k2 / ρ²)
Puissance = Fk1,k2 (Fα/2,k1,k2 / ρ²) + 1 − Fk1,k2 (F1−α/2,k1,k2 / ρ²)
Test de Levene pour deux variances
Pour le calcul de la puissance du test de Levene, l'outil utilise une approximation basée sur le rapport des écarts-types.
Les degrés de liberté de la distribution t utilisée sont :
La valeur critique t est déterminée à l'aide de la fonction quantile de la distribution t :
De plus, le calcul utilise les quantités auxiliaires suivantes :
c = √(π/2 − 1)
SE = c·√(ρ²/n₁ + 1/n₂)
A partir de cela, les deux valeurs z sont déterminées :
z₂ = −tkrit/θ − (ρ−1)/SE
Le pouvoir est ensuite déterminé à l'aide de la distribution normale standard. Les fonctions de distribution t et normale sont évaluées à l'aide de CenterSpace NMath.
Test de proportions pour deux échantillons
Dans le test de proportions, la probabilité de détecter une différence réelle entre deux proportions est calculée.
La différence de proportions est :
La proportion commune pour le calcul sous l'hypothèse nulle est :
L'erreur standard sous l'hypothèse nulle est :
L'erreur standard sous l'hypothèse alternative est :
Les quantiles et la fonction de distribution de la distribution normale standard sont évalués à l'aide de CenterSpace NMath.
Puissance = Φ((d − z1−α·SE₀) / SE₁)
Puissance = 1 − Φ((d + z1−α·SE₀) / SE₁)
Puissance = 1 − Φ((d + z1−α/2·SE₀) / SE₁) + Φ((d − z1−α/2·SE₀) / SE₁)
ANOVA à un facteur
L'ANOVA à un facteur teste si les moyennes de plusieurs groupes diffèrent.
H₁: Au moins une moyenne de groupe diffère.
Dans l'outil, la différence maximale entre les moyennes de groupe est utilisée comme effet :
Pour le calcul du paramètre de non-centralité, il est supposé que deux groupes forment la distance maximale Δ. Le paramètre de non-centralité utilisé dans l'outil est :
Les degrés de liberté sont :
La quantile critique F est déterminée à l'aide de CenterSpace NMath :
Pour l'évaluation de la distribution F non centrale, l'outil Numerics.NET est utilisé.
Test t à un échantillon
Dans le test t à un échantillon, la puissance est calculée pour un effet donné, une taille d'échantillon et un écart-type supposé.
Le paramètre de non-centralité est :
Les degrés de liberté sont :
Les quantiles requis de la distribution t et la fonction de distribution de la distribution t non centrale sont évalués en utilisant CenterSpace NMath.
Puissance = 1 − Ft,v,λ (t1−α,v)
Puissance = Ft,v,λ (tα,v)
Puissance = Ft,v,λ (tα/2,v) + 1 − Ft,v,λ (t1−α/2,v)
Test de variance à un échantillon
Dans le test de variance à un échantillon, la puissance est déterminée pour un rapport supposé entre l'écart-type réel et l'écart-type hypothétique.
Le rapport au carré est utilisé pour le calcul :
Les degrés de liberté de la distribution du chi carré sont :
Les quantiles requis et les fonctions de distribution de la distribution du chi carré sont évalués en utilisant CenterSpace NMath.
Puissance = 1 − Fχ²,v (χ²1−α,v / r²)
Puissance = Fχ²,v (χ²α,v / r²)
Puissance = Fχ²,v (χ²α/2,v / r²) + 1 − Fχ²,v (χ²1−α/2,v / r²)
Test de proportion à un échantillon
Dans le test de proportion, la puissance est calculée pour une proportion de comparaison réelle p par rapport à une proportion hypothétique p₀.
L'erreur standard sous l'hypothèse nulle est :
L'erreur standard sous l'hypothèse alternative est :
Les quantiles requis et les fonctions de distribution de la distribution normale standard sont évalués en utilisant CenterSpace NMath.
Puissance = Φ((d − z1−α·SE₀) / SE₁)
Puissance = Φ((−d − z1−α·SE₀) / SE₁)
Puissance = Φ((d − z1−α/2·SE₀) / SE₁) + Φ((−d − z1−α/2·SE₀) / SE₁)