


La vérification des variances est utilisée pour déterminer si les dispersions de deux groupes ou plus diffèrent de manière statistiquement significative. Elle ne répond pas à la question de savoir si les moyennes diffèrent, mais si les variances ou les écarts-types sont comparables.
L'outil est particulièrement utile pour évaluer si plusieurs processus, formulations, machines ou groupes fonctionnent de manière similaire et stable ou si un groupe varie significativement plus que les autres.
La décision est prise en comparant la valeur p avec le niveau de signification fixé (généralement α = 0,05) :
- p > α → Conserver H₀; il n'y a pas d'indication significative de variances différentes.
- p ≤ α → Rejeter H₀; il y a une différence significative dans les variances.

Dans le développement de produits, plusieurs formulations de sauce tomate sont testées. Pour les mêmes données de viscosité, il n'est plus vérifié si les moyennes diffèrent, mais si la dispersion de la viscosité entre les formulations est de magnitude différente.
Pour cela, des mesures de viscosité sont effectuées sur des échantillons de la formulation A, de la formulation B et de la formulation C. Les mesures des groupes sont collectées indépendamment et considérées comme des échantillons.
À l'aide du test des variances, il convient de vérifier si les formulations ont une dispersion de processus comparable ou si au moins une formulation est significativement plus variable.
Interprétation des résultats :
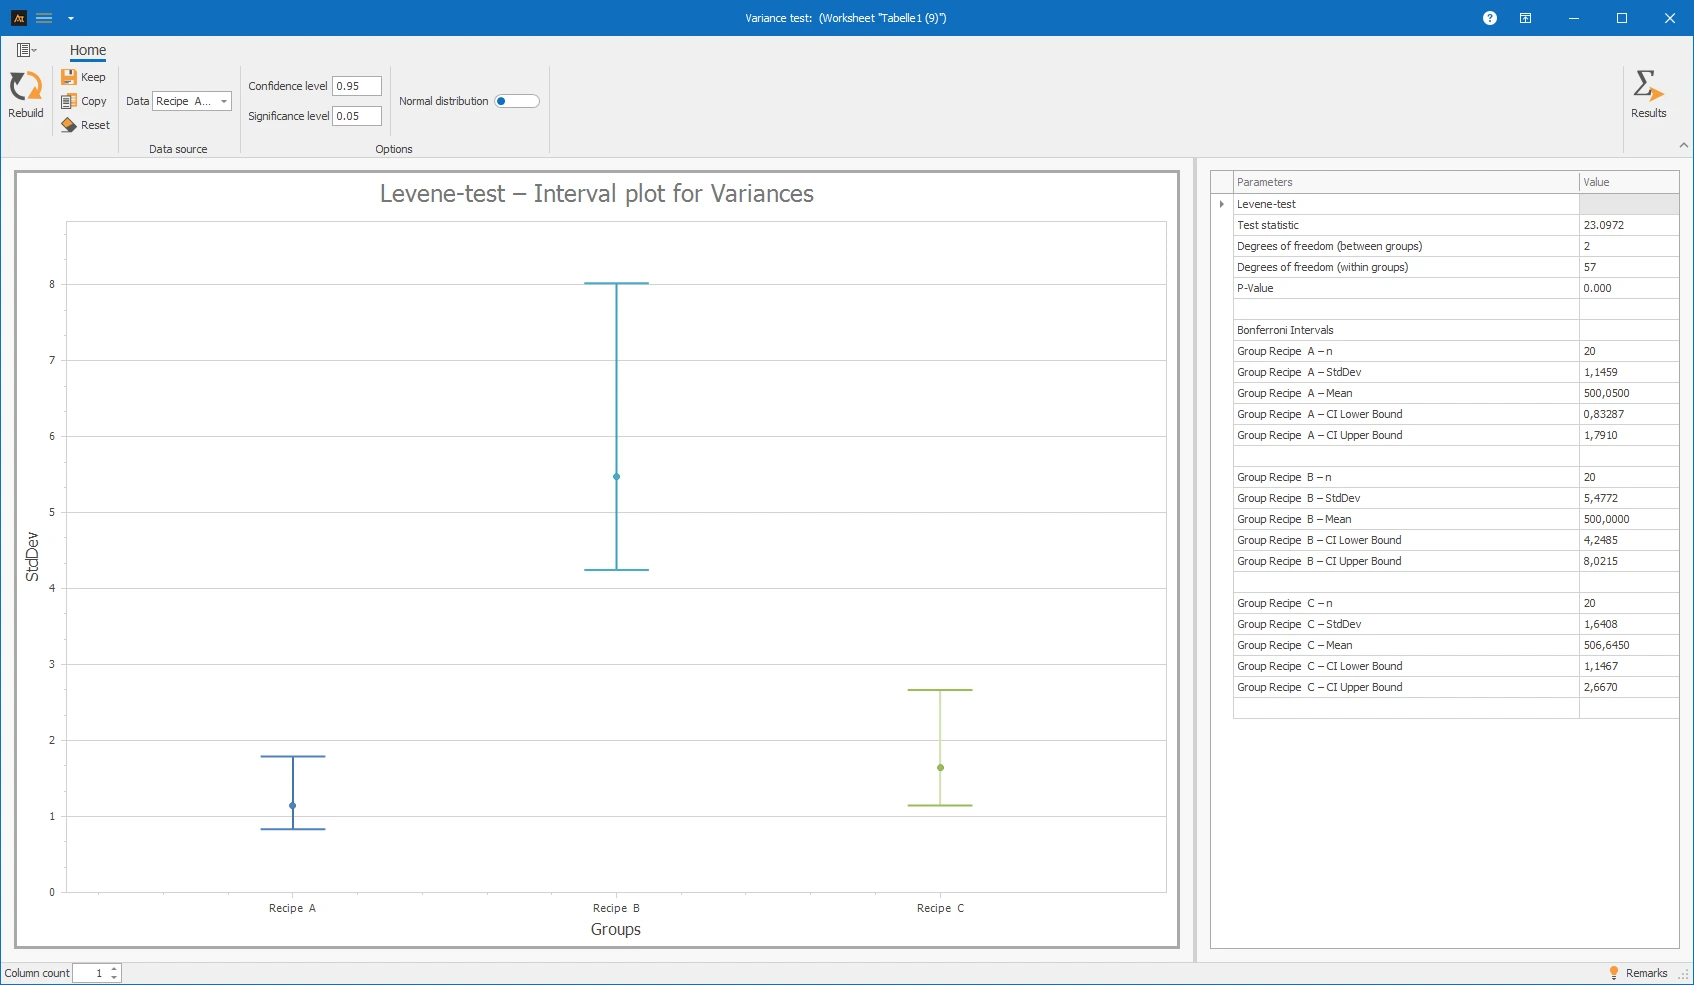
La valeur p est comparée au niveau de signification de 0,05. Comme la valeur p dans cet exemple est affichée comme 0,000, elle est inférieure à 0,05. L'hypothèse nulle d'égalité des variances est donc rejetée.
Cela signifie : Les formulations peuvent non seulement différer par leur viscosité moyenne, mais aussi par la dispersion des valeurs de viscosité. Au moins une formulation montre une dispersion significativement différente des autres formulations.
Pour le développement de produits, cela est important car une formulation avec une forte dispersion est moins stable. Même si la valeur moyenne est généralement dans la plage souhaitée, des lots individuels peuvent s'avérer significativement plus fins ou plus épais. Une formulation avec une dispersion plus faible, en revanche, est plus gérable et offre des propriétés de produit plus cohérentes.
La courbe des barres d'erreur montre les écarts-types des formulations avec les intervalles de confiance de Bonferroni associés. Les formulations avec des écarts-types plus grands présentent de plus grandes fluctuations de viscosité. Cependant, la décision statistique finale est prise en fonction de la valeur p.
Explications du graphique :
- Les points marquent les écarts-types de viscosité pour les formulations individuelles.
- Les barres d'erreur représentent les intervalles de confiance des écarts-types. Lorsque la distribution normale est activée, des intervalles de Bonferroni sont utilisés ; sans distribution normale activée, des intervalles de Bonett sont utilisés.
- Les chevauchements des intervalles fournissent une indication visuelle initiale. La décision finale est prise en fonction de la valeur p.
Les considérations et étapes suivantes sont nécessaires pour effectuer un test de variances pour deux échantillons ou plus.
Préparation
- Sélectionnez une variable de mesure continue (par exemple, viscosité).
- Définissez deux groupes ou plus dont les variances doivent être comparées (par exemple, formulation A, B et C).
- Définissez le niveau de signification (généralement α = 0,05).
- Définissez le niveau de confiance (généralement 95%).
- Vérifiez si les mesures ont été prises indépendamment les unes des autres.
- Décidez si vous devez supposer une distribution normale. Sans distribution normale activée, l'outil utilise le test de Levene ; avec distribution normale activée, le test F est utilisé pour deux groupes et le test de Bartlett pour plus de deux groupes.
 Utilisation dans AlphadiTab
- Dans la Phase d'analyse, sélectionnez l'outil Test de Variances.
- Sous Données, sélectionnez tous les groupes à comparer.
- Définissez le niveau de confiance et le niveau de signification.
- Activez éventuellement la distribution normale si l'hypothèse de distribution normale est justifiée techniquement.
- Effectuez l'analyse en “Créer Nouveau”.
Interprétation
- Vérifiez quel test a été appliqué : test de Levene, test F ou test de Bartlett.
- Vérifiez si la valeur p est inférieure ou égale au niveau de signification.
- p ≤ α → différence statistiquement significative entre au moins deux variances ou écarts-types.
- p > α → aucune différence statistiquement significative entre les variances ou écarts-types.
Important : Le test de variances vérifie d'abord les dispersions. Il ne fait aucune déclaration sur la différence des moyennes des groupes.
Quantité de remplissage sauce tomate – Machine A, Machine B, et Machine C
En production, trois machines de remplissage sont utilisées. Il convient d'examiner si les quantités de remplissage des machines varient de manière significative. Alors qu'une ANOVA compare les quantités de remplissage moyennes, le test des variances examine la dispersion des machines.
Interprétation
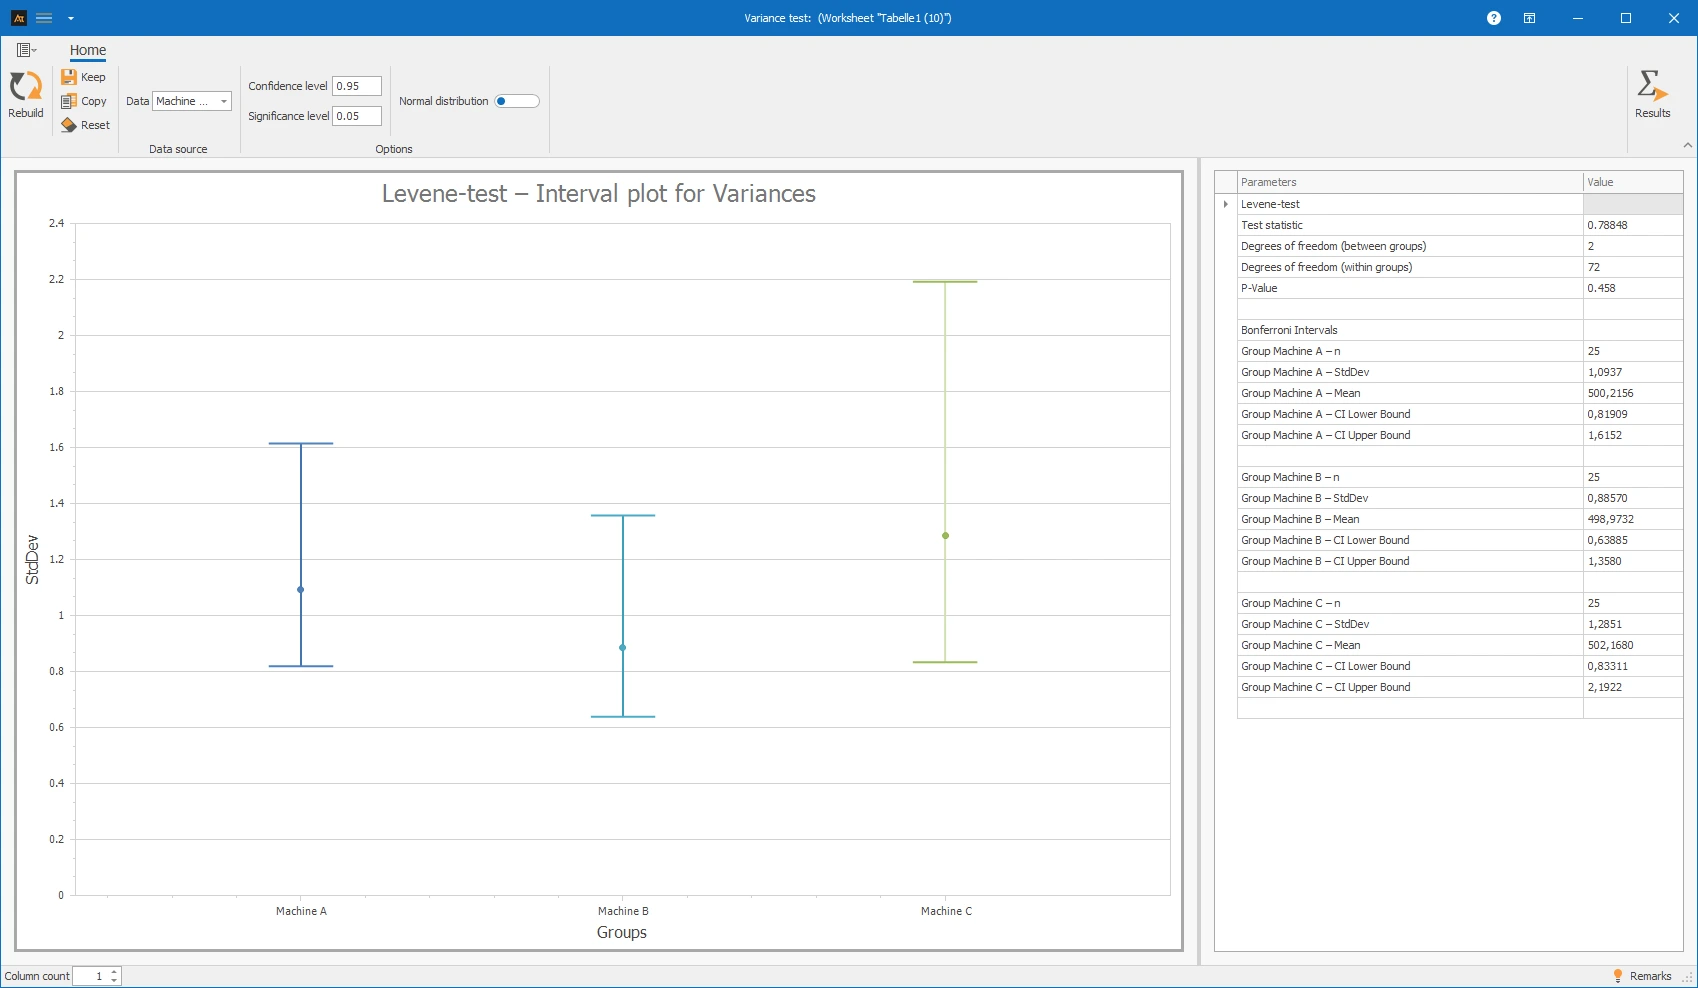
La valeur p est supérieure à 0,05. Par conséquent, l'hypothèse nulle d'égalité des variances n'est pas rejetée.
Les quantités de remplissage des machines ne varient pas de manière statistiquement significative. Les machines fonctionnent de manière comparablement stable en termes de fluctuation. Les différences de moyennes devraient être testées séparément.
Temps de réponse du service d'assistance informatique vs. localisation
Dans le service d'assistance informatique, les tickets sont traités à plusieurs endroits. Il convient de vérifier si les temps de réponse varient de manière significative entre les emplacements. Une grande variabilité peut indiquer des processus de service incohérents ou des charges de travail très fluctuantes.
Interprétation
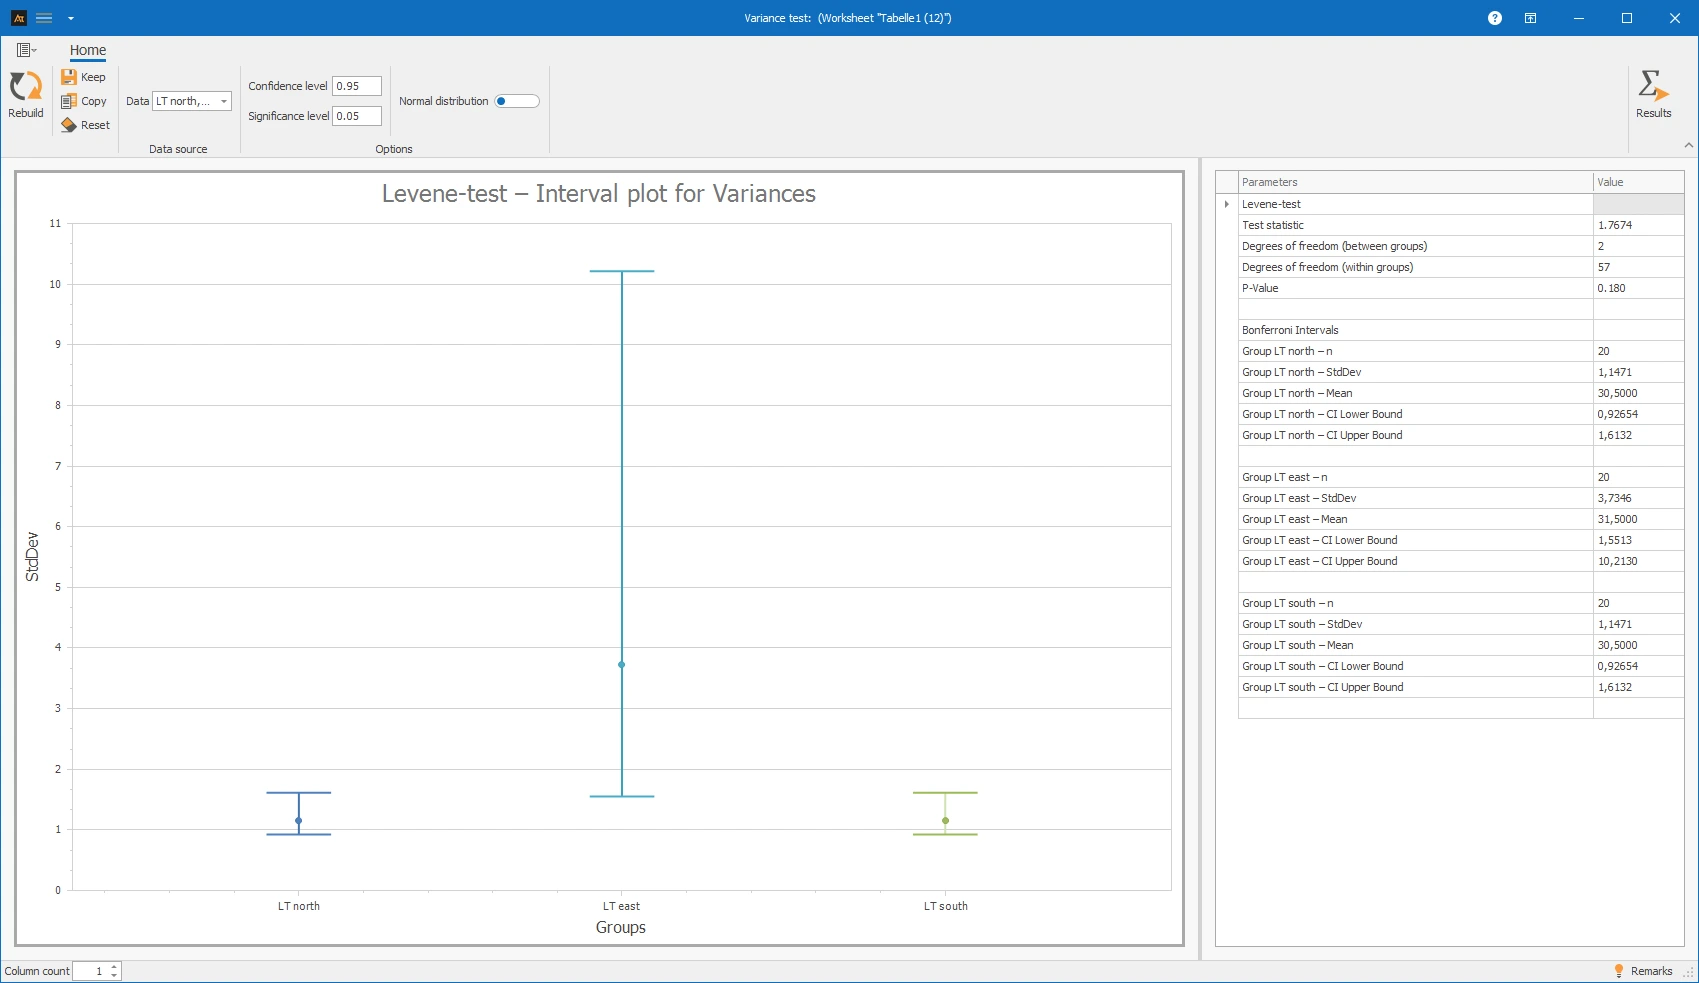
La valeur p est supérieure à 0,05. L'hypothèse nulle d'égalités des variances n'est pas rejetée.
Les temps de réponse des emplacements ne varient pas de manière statistiquement significative. Un intervalle de confiance large dans le diagramme indique plutôt une estimation incertaine, par exemple en raison d'une petite taille d'échantillon ou de valeurs aberrantes individuelles. Une différence nette dans les variances ne peut pas être déduite de cela.
Délai par région
Dans les ventes, les offres clients sont traitées par plusieurs équipes. Outre le délai moyen, il est également intéressant de voir si le temps de traitement est cohérent ou très variable.
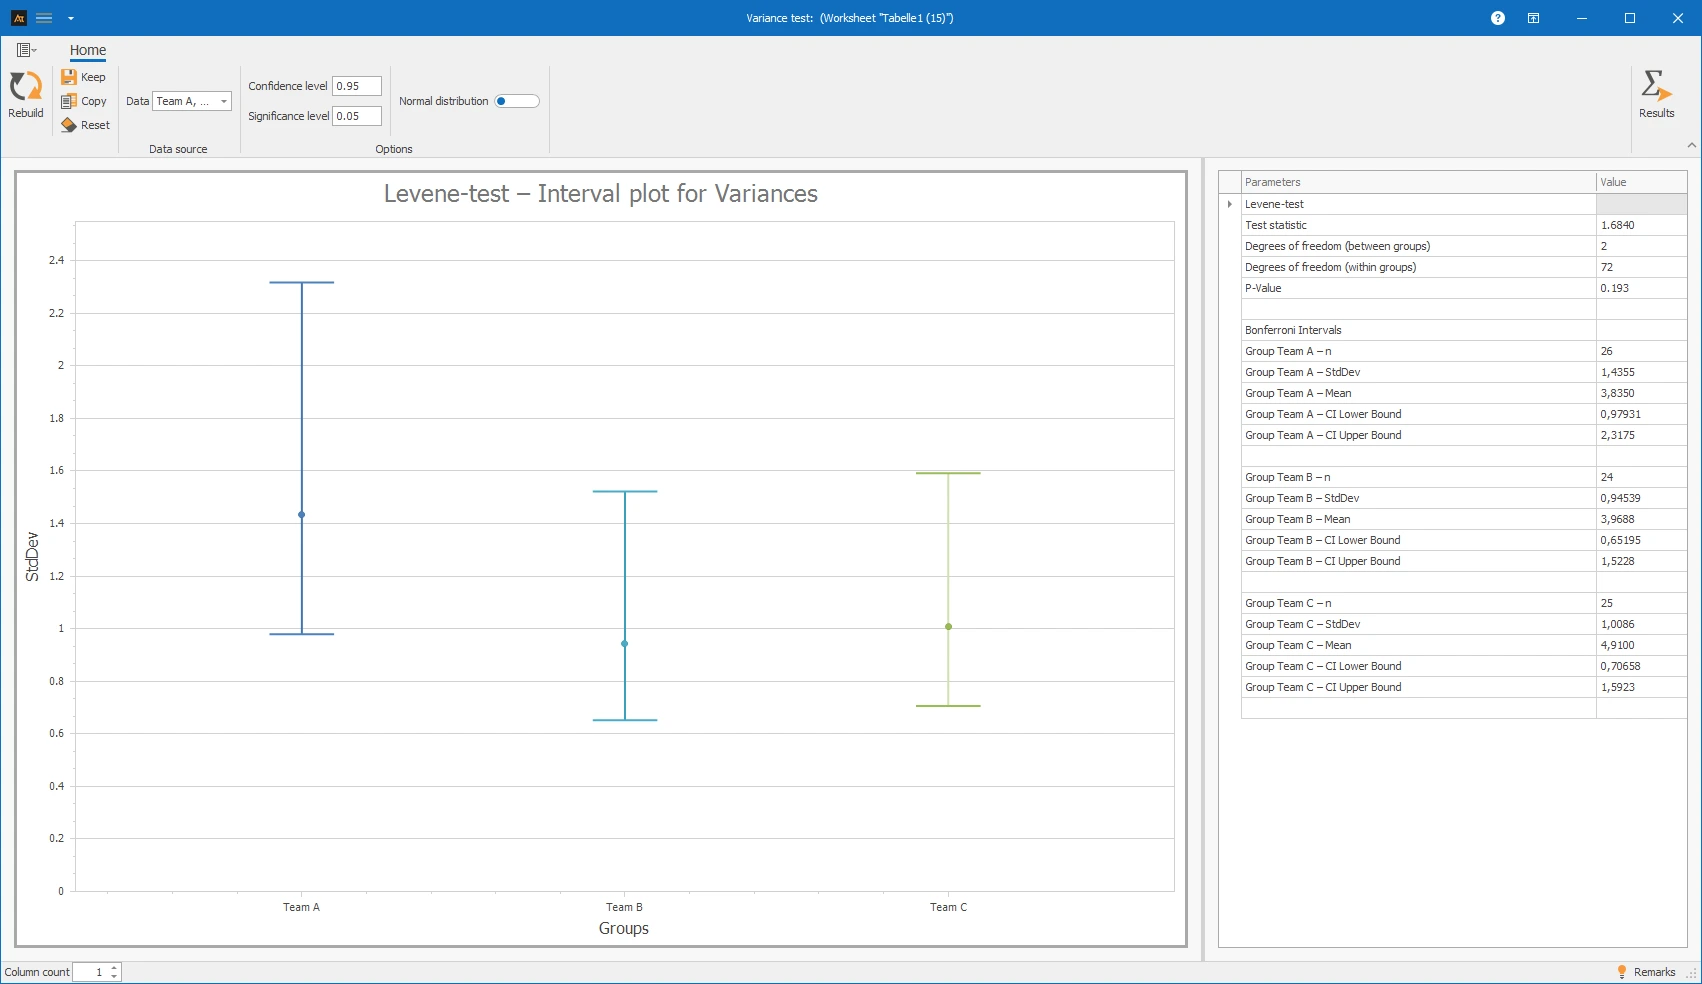
Interprétation
La valeur p est supérieure à 0,05. L'hypothèse nulle d'égalités des variances n'est pas rejetée.
Les délais des équipes ne diffèrent pas de manière statistiquement significative. Ainsi, rien n'indique qu'une équipe travaille de manière significativement plus incohérente ou moins prévisible que les autres.
Délai de livraison après le centre logistique
Dans le département logistique, les commandes des clients sont préparées et expédiées. Il convient d'examiner si les délais de livraison dans les centres logistiques varient de manière significative.
- H₀: σ²_Centre A = σ²_Centre B = σ²_Centre C
- H₁: Au moins une variance diffère.
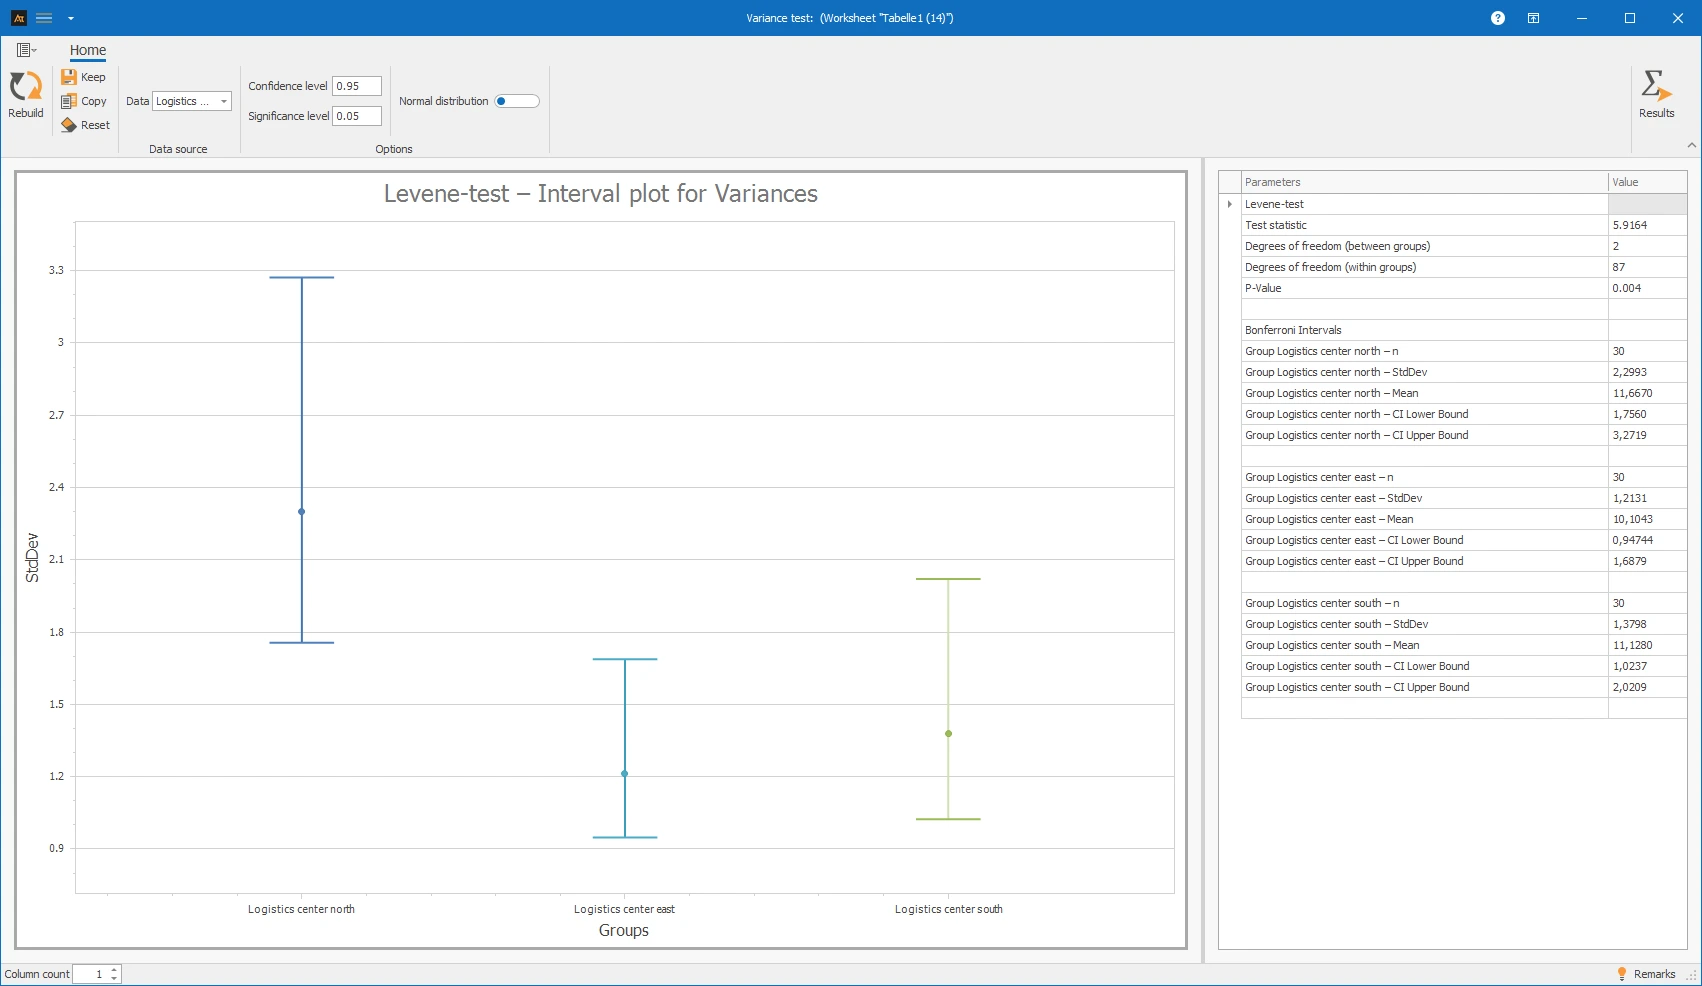
Interprétation
La valeur p est inférieure à 0,05. L'hypothèse nulle d'égalités des variances est rejetée.
Les délais de livraison varient de manière statistiquement significative entre les centres logistiques. Au moins un centre livre de manière moins cohérente. Cela peut indiquer des différences de charge de travail, de processus ou de conditions de transport.
Comparaison des fournisseurs
Dans l'achat, les composants sont sourcés auprès de trois fournisseurs. Il convient d'examiner si les taux de rejet par livraison fluctuent davantage avec certains fournisseurs qu'avec d'autres.
Remarque :
Les valeurs en pourcentage comme le taux de rejet peuvent être discrètes, car elles proviennent de valeurs de comptage. Avec de petites quantités de livraison, seules quelques valeurs en pourcentage possibles apparaissent. Dans de tels cas, l'adéquation du test doit être examinée professionnellement.
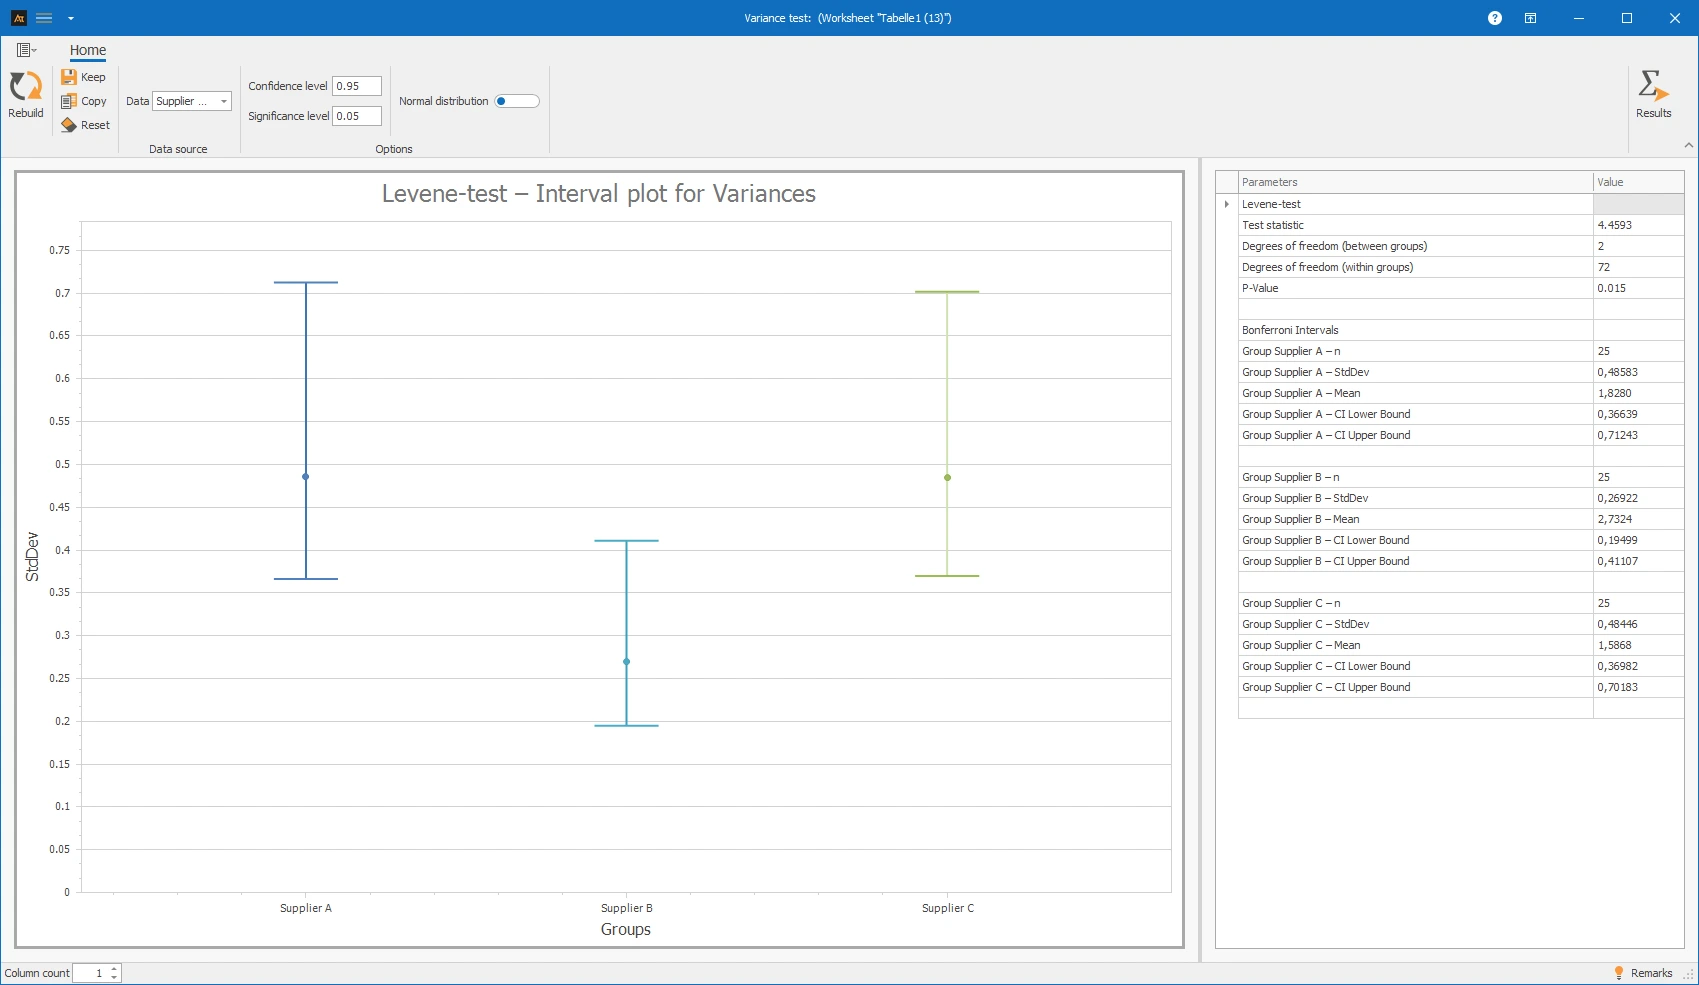
Interprétation
La valeur p est inférieure à 0,05. L'hypothèse nulle d'égalités des variances est rejetée.
Les taux de rejet varient de manière statistiquement significative entre les fournisseurs. Un fournisseur peut être acceptable en moyenne mais livrer de manière moins fiable car la qualité fluctue davantage.
Déviation de prévision
Dans la planification de la production, des prévisions de la demande sont créées pour différentes périodes de planification. Il convient d'examiner si les écarts de prévision varient de manière significative entre les horizons de planification à court, moyen et long terme.
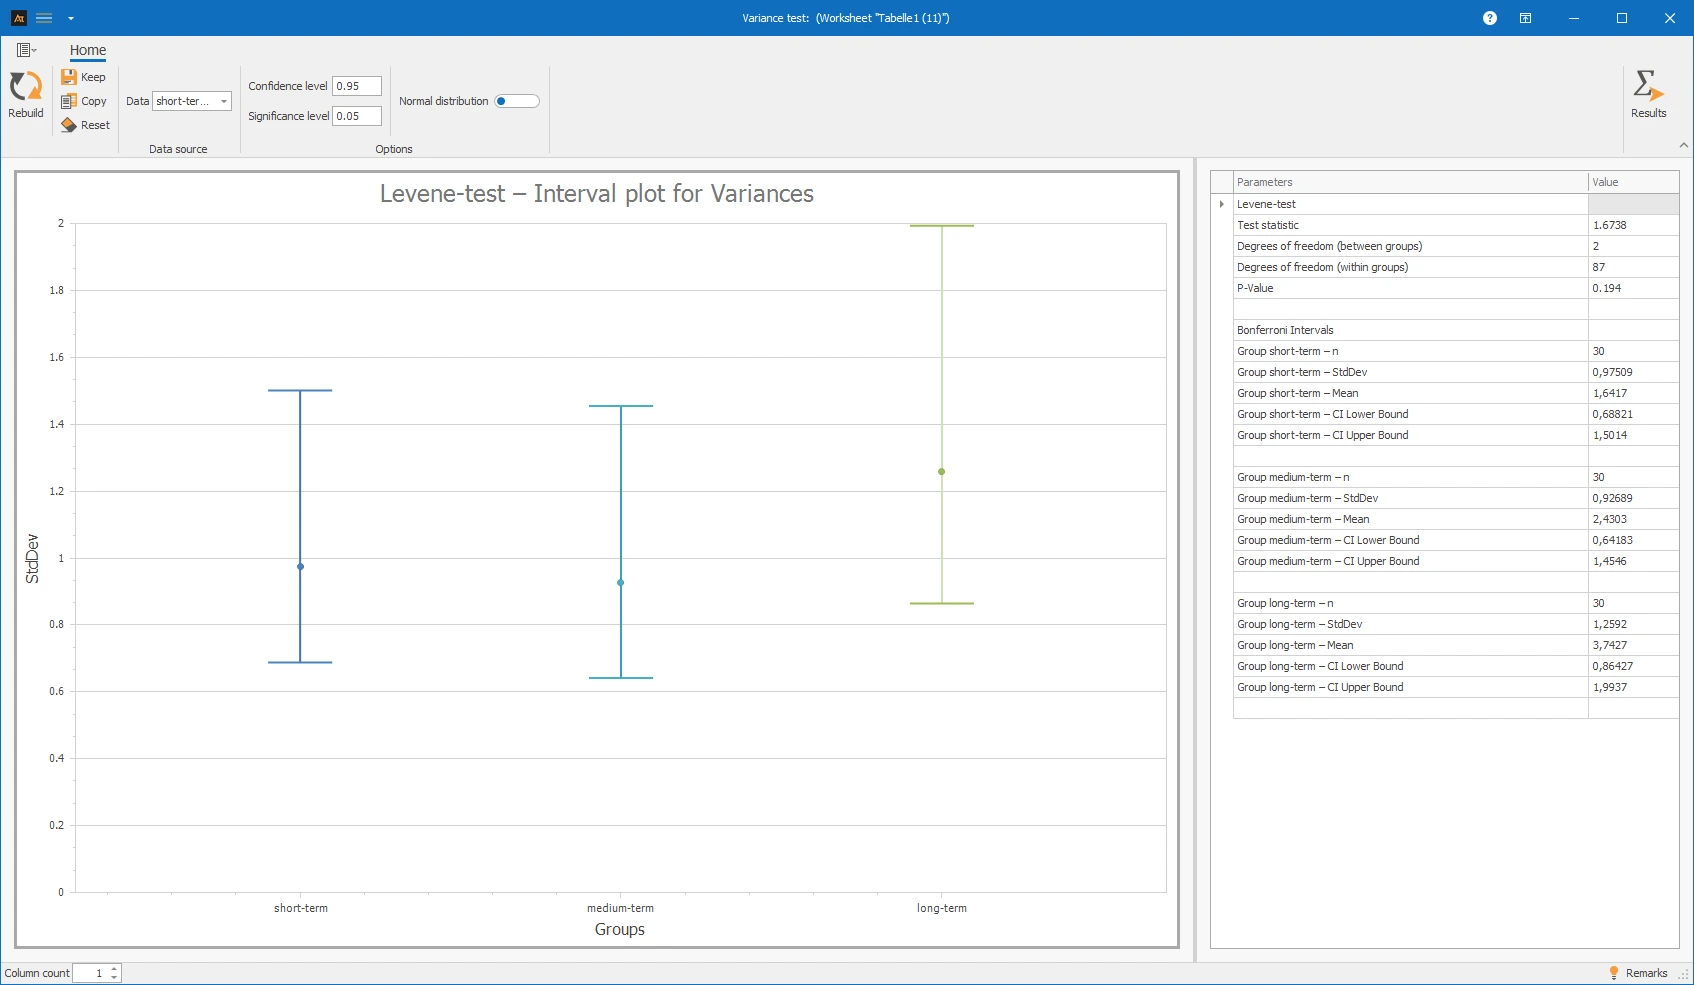
Interprétation
La valeur p de 0,194 est supérieure au niveau de signification de 0,05. Par conséquent, l'hypothèse nulle d'égalités des variances n'est pas rejetée.
Ainsi, il n'y a pas de preuve statistiquement significative que la répartition des écarts de prévision diffère entre les horizons de planification. Des différences dans la plage de variation peuvent être visibles dans l'échantillon, mais elles ne sont pas statistiquement confirmées sur la base de ce test.
Données continues : Données collectées avec un instrument de mesure qui peuvent avoir à la fois des unités et des décimales.
Données normalement distribuées : Données qui peuvent être bien décrites par une distribution normale. Cela peut être vérifié, par exemple, par un test de normalité ou par des diagrammes appropriés.
s : Écart-type de l'échantillon. Il décrit la dispersion des mesures autour de la moyenne.
s² : Variance de l'échantillon. C'est le carré de l'écart-type.
n : Taille de l'échantillon. Nombre d'observations dans un échantillon.
α : Niveau de signification. Probabilité d'erreur prédéfinie avec laquelle l'hypothèse nulle est rejetée à tort.
p-value : Résultat du test d'hypothèse utilisé pour prendre une décision entre l'hypothèse nulle et l'hypothèse alternative.
F-value : Statistique de test dans le test F ou le test de Levene. Dans le test F, il décrit le rapport de deux variances d'échantillon.
Valeur du chi-carré : Statistique de test dans le test de Bartlett pour plus de deux groupes sous l'hypothèse de distribution normale.
df : Degrés de liberté. Valeurs dérivées du nombre de groupes et d'observations qui déterminent la forme de la distribution de test.
Niveau de confiance : Probabilité avec laquelle l'intervalle de confiance calculé couvre la vraie valeur du paramètre (par exemple, 95%).
Intervalle de confiance : Plage de valeurs qui contient la véritable écart-type ou variance avec le niveau de confiance choisi.
Hypothèse nulle : Hypothèse initiale qui suppose des variances égales pour tous les groupes lors du test des variances.
Hypothèse alternative : Contre-hypothèse à l'hypothèse nulle. Elle stipule qu'au moins une variance diffère des autres.
Test de Levene : Test robuste pour l'égalité des variances. Dans l'outil, les écarts absolus par rapport à la médiane du groupe sont utilisés.
Test F : Test pour l'égalité de deux variances sous l'hypothèse de distribution normale.
Test de Bartlett : Test pour l'égalité de plusieurs variances sous l'hypothèse de distribution normale.
Intervalles de Bonferroni : Intervalles de confiance ajustés qui prennent en compte la probabilité d'erreur globale lors de la comparaison de plusieurs groupes simultanément.
La vérification de l'égalité des variances vérifie si les variances de plusieurs groupes diffèrent de manière statistiquement significative.
Avec l'hypothèse de distribution normale activée, l'outil utilise le test F pour exactement deux groupes et le test de Bartlett pour plus de deux groupes. Sans l'hypothèse de distribution normale activée, un test de Levene basé sur la médiane est utilisé.
Les fonctions de distribution et de quantile requises de la distribution F, du Chi-carré et de la distribution normale sont évaluées à l'aide de CenterSpace NMath.
Hypothèses
Test F pour deux groupes normalement distribués
Si exactement deux groupes sont présents et l'option Distribution normale est activée, l'outil utilise un test F bilatéral.
La valeur p est déterminée bilatéralement à partir de la distribution F. La fonction de distribution de la distribution F est évaluée à l'aide de CenterSpace NMath.
F < 1: p = 2 · Fdf1,df2(F)
Test de Bartlett pour plusieurs groupes normalement distribués
Si plus de deux groupes sont présents et l'option Distribution normale est activée, l'outil utilise le test de Bartlett.
Tout d'abord, la variance combinée est calculée :
Le test statistique de Bartlett utilisé dans l'outil est :
Sous l'hypothèse nulle, le test statistique est approximativement évalué avec une distribution du Chi-carré avec k − 1 degrés de liberté. La fonction de distribution du Chi-carré est calculée à l'aide de CenterSpace NMath.
Test de Levene sans hypothèse de distribution normale
Si l'option Distribution normale n'est pas activée, l'outil utilise une variante du test de Levene basée sur la médiane. Tout d'abord, les écarts absolus par rapport à la médiane du groupe respectif sont calculés pour chaque groupe.
Une ANOVA à un facteur est ensuite appliquée aux écarts absolus. Le test statistique est dérivé du rapport des carrés moyens entre et au sein des groupes.
dfintra = N − k
La valeur p est déterminée à partir de la queue droite de la distribution F. La fonction de distribution F est évaluée à l'aide de CenterSpace NMath.
Intervalles de confiance de Bonferroni
En plus du test de variance, l'outil calcule un intervalle de confiance simultané de l'écart type pour chaque groupe. Le niveau d'erreur global est réparti entre les groupes selon Bonferroni.
Intervalles avec hypothèse de distribution normale
Avec l'hypothèse de distribution normale activée, des intervalles de confiance basés sur le Chi-carré pour la variance sont calculés. Les quantiles requis de la distribution du Chi-carré sont déterminés à l'aide de CenterSpace NMath.
Les limites pour l'écart type sont obtenues en prenant la racine carrée :
SDsuperieur = √(Varsuperieur)
Intervalles de Bonett sans hypothèse de distribution normale
Sans l'hypothèse de distribution normale activée, l'outil utilise les intervalles de Bonett. La taille de l'échantillon et la kurtosis du groupe respectif sont pris en compte.
Pour les échantillons plus grands, une moyenne tronquée est d'abord déterminée. Pour les échantillons d'au plus cinq observations, la moyenne ordinaire est utilisée.
Un excès de kurtosis est déterminé à partir des écarts par rapport à la moyenne tronquée :
L'erreur standard est ensuite calculée :
Le quantile requis de la distribution normale standard est déterminé à l'aide de CenterSpace NMath :
Le facteur de correction de Bonett utilisé dans l'outil est :
Les limites de la variance sont ensuite calculées comme suit :
Les limites pour l'écart type sont à nouveau obtenues à partir des racines carrées des limites de la variance.
SDsuperieur = √(Varsuperieur)